Yayınladığınız Her Makaleyi Gerçek Fotoğraflarla, Ölçekli Şekilde Görsellendirme Rehberi
Yayıncılık ekiplerinin neden gerçek fotoğrafçılığa geri döndüğü ve tamamlanmış bir taslağı yaklaşık 150 milisaniyede kaynağı belirtilmiş bir öne çıkan görsele dönüştüren tam iş akışı — istem dahil.
 Marouane Tijani
10 dk okuma

Yayımladığınız her makalenin bir görsele ihtiyacı var. Bu bir lüks değil — hero görsel, sosyal önizlemede gösterilen, okuyucunun ilk cümleden önce gördüğü ve sayfanın özenle hazırlanıp hazırlanmadığını yarım saniyede anlatan unsur. Bunu gönderi başına dört görselle ve çeyrek başına kırk gönderiyle çarptığınızda, “bir fotoğraf bul” bir görev olmaktan çıkıp bir üretim hattı sorununa dönüşür.
İşte bunu nasıl çözdüğümüz: üretilen görseller yerine ne kullanılmalı ve neden, ve Pexafy'ı iş akışına bağlamanın üç yolu — elle, API ile ya da bir yapay zeka aracısı üzerinden — bitmiş bir taslağı gerçekten bir şey bulan bir arama cümlesine dönüştüren istem dahil.
Gerçek fotoğraflar neden hâlâ üretilen görsellerden daha iyi
Bir illüstrasyon üretmek kolay, ve asıl sorun da tam olarak bu. “Yapay zeka görselleri kestirme bir yol” anlayışından bugüne dört şey değişti:
1 · Hacimde arama, üretmekten daha hızlı
Bir üretim; bir istem, bir bekleme, bir inceleme ve — dürüst olmak gerekirse — kullanılabilir bir sonuç elde etmeden önce iki üç deneme daha demek. Semantik bir arama ise yaklaşık 150 milisaniyede on altı aday getiren, her biri zaten lisanslı, zaten kaynak gösterilmiş, zaten boyutlandırılmış ve boyutları yanıtta yer alan tek bir istek. Tek bir görsel için fark bir kahve molası kadar. Çeyrek başına dört yüz görsel için ise bu, bir iş akışı ile bir angarya arasındaki fark.
2 · Fotoğraf doğrudur; üretim ise makul görünür
Makaleniz gerçek bir şeyle ilgili olduğu anda — bir meslek, bir ekipman parçası, bir şehir, bir hareket, bir malzeme — üretilen bir görsel havayı doğru yakalar ama detayları yanlış verir. Altı parmaklı eller esprili versiyonu; asıl maliyetli olan versiyon ise var olmayan bir cerrahi alet, hayali kumandalarla donatılmış bir kokpit ya da Lizbonlu birinin tanımadığı bir “Lizbon sokağı”. Konunuzu bilen okuyucular bunu fark eder ve önce görselde fark eder.
3 · Herkeste aynı görünüm var
Difüzyon modelleri ortak bir stilde birleşiyor ve yumuşak gradyanlı, aşırı aydınlatılmış, şüphe uyandıracak kadar simetrik illüstrasyonlardan oluşan bir duvar artık dolgu malzemesi olarak okunuyor. Bu algı gerçek maliyetin ta kendisi: bir ceza değil, bir sinyal. Gerçek bir fotoğraf — tanecikli doku, garip bir sandalye, cümlenin ortasında yakalanmış biri — haber niteliğinde olarak okunur.
4 · Ve artık üzerlerinde bir etiketle geliyorlar
Bu madde bir argümandan çok bir bağlam ama gidişatın yönünü gösteriyor. 2 Ağustos 2026'dan itibaren AB Yapay Zeka Yasası'nın 50. Maddesi, üretici yapay zeka sistemlerinin sağlayıcılarının sentetik çıktıları makine tarafından okunabilir bir biçimde işaretlemesini ve dağıtıcıların derin sahteleri ifşa etmesini zorunlu kılıyor.1 Tespit tarafında ise Google, Arama, Görseller ve Lens içinde “bu içerik yapay zeka tarafından mı üretildi?” sorusunu yanıtlamak için C2PA İçerik Kimlik Bilgilerini ve kendi SynthID filigranını okuyor.2 Bunların hiçbiri bir blogun hangi görselleri yayımlayabileceğine dair bir kural değil ve hiçbiri sıralamanıza mal olmuyor. Değişen şey daha sonraki aşamada: makalenizin en üstündeki görselin kaynağı artık okuyucunun size hiç sormadan iki tıkla kontrol edebileceği bir şey. Lisanslı bir fotoğrafın beyan edecek hiçbir şeyi yok.
Üretilen görsellerin doğru tercih olduğu durumlar. Kavram diyagramları ve şemalar. Fotoğraflanamayacak bir sahne (henüz var olmayan bir ürün, soyut bir mekanizma, geleceğe ait bir şehir). Sahip olduğunuz ve her gönderide tekrarlamak istediğiniz kurumsal bir illüstrasyon stili. Ve görselin kanıt olarak değil, bilinçli biçimde bir illüstrasyon olarak anlaşıldığı her durum. İkisini de kullanın — sadece “toplantı halindeki insanların bir fotoğrafına ihtiyacım var” için üretimi varsayılan seçenek olarak kullanmayı bırakın.
Hacminize göre görsellendirmenin üç yolu
Aynı motor, aynı katalog — 9 kütüphaneden 9M+ ücretsiz kullanımlık fotoğraf — ve üç giriş noktası. Ne kadar teknik olduğunuza göre değil, kaç makale yayımladığınıza göre seçin.
| Giriş noktası | En uygun olduğu durumkim ve ne kadar | Makale başına | İhtiyacınız olan |
|---|---|---|---|
| Arama arayüzü | Editörler, bir seferde bir gönderi — ayda ~20'ye kadar | ~30 saniye | Bir tarayıcı. Arama yapmak için hesap gerekmez. |
| REST API | Bir CMS, bir statik site derlemesi, bir taslak grubu | ~1 istek, ~150 ms | Bir API anahtarı. Ayda 5.000 ücretsiz istek, dakikada 20. |
| MCP sunucusu | Taslağı yazan ya da düzenleyen yapay zeka aracısı | Aynı konuşma içinde | Bir bağlayıcı URL, OAuth ya da bir anahtar. |
Bu üçü tek bir katalogu ve tek bir sıralamayı paylaşır; bu nedenle bir editörün arayüzde bulduğu bir fotoğraf, API'nin derleme betiğinize döndürdüğü aynı kimliğe sahip aynı fotoğraftır.
Tek makale, 30 saniye: arama arayüzü
Sahneyi bir fotoğrafçıya anlatır gibi, tam bir cümleyle, kendi dilinizde tarif edin.
team meeting değil —
“a small team standing in a semi circle for a short morning stand-up meeting in a bright
open plan office”. Her ek somut ayrıntı sonuç kümesini boşaltmak yerine daraltır, çünkü motor
kelimelerinizi birinin etiketleriyle eşleştirmek yerine anlama göre sıralama yapar.
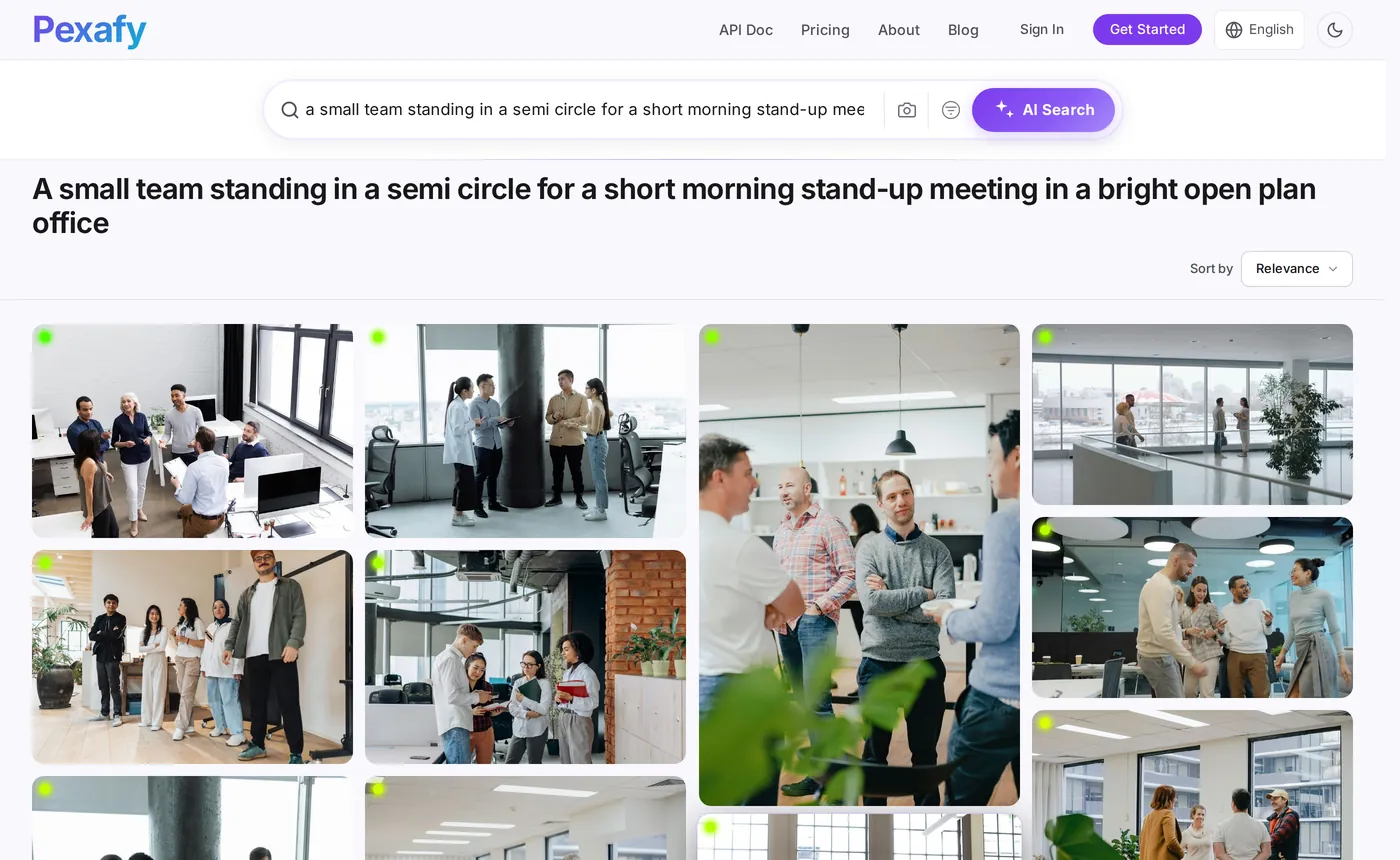
Ardından bir makale düzeni için önemli olan filtrelerle daraltın — ve yalnızca bunlarla:
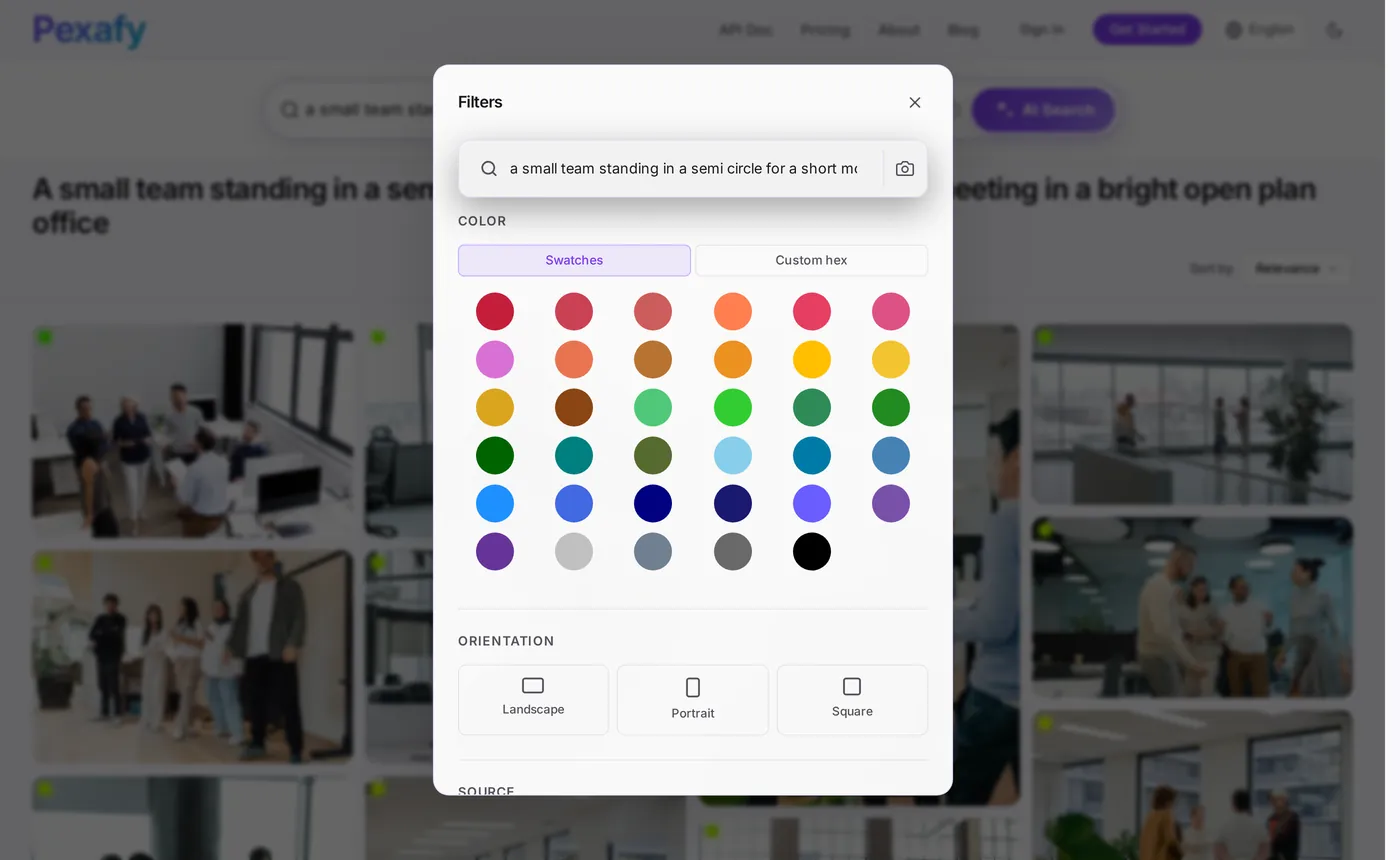
- Anahtar kelimeyi değil, cümleyi yazın. Özne + eylem + yer + ışık. 500 karaktere kadar, 100'den fazla dilin herhangi birinde.
- Hero için yatay yönelimle filtreleyin, ardından makale içi görseller için filtreyi kaldırıp yeniden çalıştırın; dikey görseller genelde orada daha iyi okunur.
- Fotoğrafı açın ve hazır atıf satırını, orijinal kaynak sayfasını ve tam çözünürlüklü dosyayı alın.
- Seçtiğiniz fotoğrafta “benzer fotoğraflar”ı kullanın ve bir sonraki bölümü aynı görsel üslupla — aynı ışık, aynı işleme, farklı sahne — resimlendirin.
İstem: bir taslağı arama cümlesine dönüştürmek
Herkesin otomasyonda hata yaptığı adım bu. Makale başlığını doğrudan arama kutusuna aktarıyorlar; oysa başlık tam olarak yanlış girdi: soyut (“The hidden cost of context switching”) ve dünyada onu tasvir eden hiçbir fotoğraf yok. Modelden istediğiniz şey bir özet değil — bir kamera brifi.
# system prompt
You are a photo editor. Read the article and write ONE search sentence
for a stock-photo engine that ranks by meaning, not by keywords.

Rules:
1. Describe a scene a camera could have taken: someone doing
   something, somewhere. Never name the topic itself ("fintech",
   "productivity", "SEO") — name what would be in the frame.
2. 12 to 25 words. Longer beats shorter: every concrete detail
   (light, place, gesture, time of day) sharpens the match.
3. No text, logos, brands, charts, screenshots or famous people.
   Free photo libraries have almost none of those.
4. No invisible metaphors ("growth", "synergy", "transformation").
5. Match the mood of the article: calm, tense, tired, celebratory.
6. Write the sentence in English even if the article is not.

Return JSON only:
{ "query": "…", "orientation": "landscape", "alt": "…" }
1. kural işin çoğunu yapıyor. Aynı kuralı üç gerçek taslak üzerinde görelim — ortadaki sütun bir insanın acele ettiğinde yazdığı şey, sağdaki sütun ise istemin döndürdüğü şey:
| Makalenin konusu… | Aceleyle yazılan sorgu | Kamera brifi |
|---|---|---|
| Günlük stand-up toplantınız neden işlemiyor | team meeting |
“a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office” |
| İşe alım sürecini 6 haftadan 9 güne indirmek | onboarding |
“a new employee on their first day at a desk, listening while a colleague leans in and points at their screen” |
| Bağlam değiştirmenin gizli maliyeti | productivity |
“a tired developer rubbing their eyes in front of two monitors late in the evening, the office empty behind them” |
team meeting, konunuzdaki herkesin zaten kullandığı genel toplantı odası stok
görselini döndürür. Üçüncü sütundaki cümle ise 155 milisaniye içinde şunu döndürür:

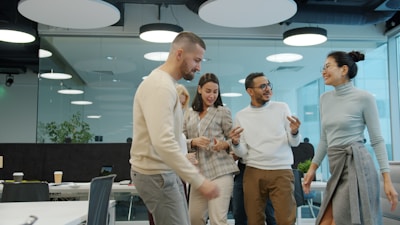
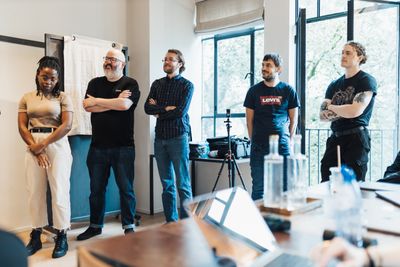
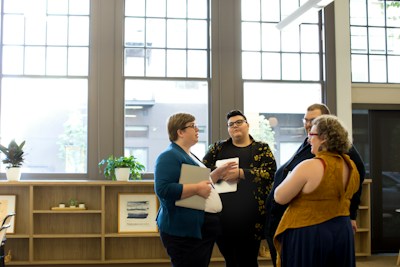
team meeting'in asla garanti etmediği şey.
İş akışı: taslak girer, kaynak gösterilmiş hero görsel çıkar
Kırk satır, iki çağrı: brif için modele bir tanesi, fotoğraf için Pexafy'a bir tanesi. Bunu CMS'inizin kaydetme kancasına, statik site derlemenize ya da bir Markdown dosyaları klasörünü gezen bir betiğe ekleyin.
import json, os, requests
from anthropic import Anthropic

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
llm = Anthropic()  # ortamdaki ANTHROPIC_API_KEY

def camera_brief(article: str) -> dict:
    # PHOTO_EDITOR = yukarıdaki sistem istemi
    msg = llm.messages.create(
        model="claude-sonnet-5",
        max_tokens=300,
        system=PHOTO_EDITOR,
        messages=[{ "role": "user", "content": article[:12000] }],
    )
    return json.loads(msg.content[0].text)

def illustrate(article: str) -> dict | None:
    brief = camera_brief(article)
    r = requests.get(
        SEARCH,
        headers={"X-Api-Key": os.environ["PEXAFY_API_KEY"]},
        params={
            "q": brief["query"],           # tam cümle
            "orientation": brief["orientation"],
            "per_page": 8,
            "score_threshold": 0.55,      # zayıf eşleşmeleri ele
        },
        timeout=10,
    )
    hits = r.json()["data"]
    if not hits:                        # brif çok dar → genişlet, yeniden dene
        return None

    top = hits[0]
    return {
        "src":    top["urls"]["regular"],        # 1080px — hero boyutu
        "alt":    brief["alt"] or top["alt_description"],
        "credit": top["attribution"]["html"],   # doğrudan gösterime hazır
        "width":  top["width"],
        "height": top["height"],
        "id":     top["photo_id"],           # kaydedin: tekrar olmasın
    }
Bir demoyu çalışır durumda bırakabileceğiniz bir şeye dönüştüren üç ayrıntı:
score_threshold— hiçbir şey döndürmemek, kötü bir fotoğraf döndürmekten daha iyidir. Brif çok spesifikse genişletin (son cümleciği kaldırın) ve bir kez yeniden deneyin.photo_id'yi kaydedin — veri tabanınızda tek bir satır ve sitenizdeki hiçbir iki makale asla aynı hero görselini paylaşmaz. Herkesin otuzuncu gönderide karşılaştığı hata bu.- Görsel yuvası başına bir istek — hero artı üç bölüm görseli, makale başına dört istektir; ya da aynı aramadan dört farklı sonuç alırsanız tek bir istektir.
Python bilmiyor musunuz? Aramanın tamamı tek satır ve her sonuç, hangi kütüphaneden geldiğine bakılmaksızın aynı alanları taşır:
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a tired developer rubbing their eyes at two monitors" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "per_page=6"

# → { "success": true, "data": [ … ], "meta": { "took_ms": 147 } }
Yanıt biçimi — urls, width, photographer_full_name,
source, license_type, relevance_score,
attribution — bir Pexels fotoğrafı, bir Pixabay fotoğrafı ve bir Unsplash fotoğrafı
için aynıdır. Bu normalleştirme, aksi takdirde kendinizin yazıp bakımını yapması gereken kısım;
bunu alan alan ele aldığımız yazı
ücretsiz stok fotoğraf API karşılaştırmasında.
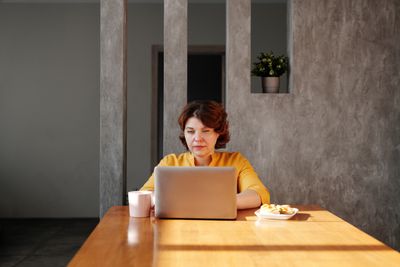
İkinci bölüm, ikinci brif, ikinci arama — buradaki nokta, tek bir makalenin dört kez uzatılmış tek bir fotoğraf yerine birkaç farklı sahne vermesi:
Görseli aracının seçmesine izin verin: MCP
Bir model taslağı zaten yazıyor ya da düzenliyorsa, en temiz iş akışı iş akışı olmamasıdır: arama aracını aracıya verin ve az önce yazdığı şeyi, hâlâ bağlamı elindeyken, aynı konuşma içinde görsellendirmesine izin verin.
Pexafy, mcp.pexafy.com/mcp adresinde barındırılan bir
Model Context Protocol sunucusu çalıştırıyor. Üç araç:
search_photos (bir cümle),
search_photos_by_image (bir referans görsel, isteğe bağlı olarak bir cümleyle
birlikte — “buna benzer, ama gün batımında”), ve get_similar_photos (zaten seçtiğinize
daha çok benzeyenler — bir seriyi tutarlı tutmanın yolu bu).
Settings → Connectors → Add custom connector
Name: Pexafy
URL:  https://mcp.pexafy.com/mcp
# ardından pencere açıldığında Pexafy hesabınızla oturum açın
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# ya da tüm ekibin erişmesi için depoya işleyin — .mcp.json
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
Bu noktadan sonra bir makaleyi görsellendirmek bir görev değil, bir cümledir. Aracı kendi kamera brifini yazar — taslağı az önce okumuştur, dolayısıyla sahneyi tarif etmek için herkesten daha uygun konumdadır:
You  Here's the draft of this week's post. Find a landscape hero
     and one photo for section 2, and give me the credit lines.

Claude  → search_photos(
       q="a small team standing in a semi circle for a short morning
          stand-up meeting in a bright open plan office",
       orientation="landscape")
     ← 16 photos · 155 ms

     Hero    → Photo by Thirdman on Pexels · 6453×4302 · score 0.80
     Section → Photo by Marcus Aurelius on Pexels · 6000×4000
     Both licence-free, attribution lines below, ready to paste.
Unsplash, Pexels, Pixabay ve Openverse'in resmi bir MCP sunucusu yok — var olan şey, kendinizin barındırıp anahtarını yönettiği topluluk sarmalayıcıları. Editoryal iş akışınız zaten bir aracı üzerinden yürüyorsa, bu fark tam olarak entegrasyonun kendisi.
Alt metin, lisans ve sayfa hızı
Fotoğraf seçildi. Dört şey, görselin sayfaya yardımcı mı olacağını yoksa sessizce mi zarar vereceğini belirler:
-
Alt metni bir tarayıcı için değil, bir insan için yazın. Her sonuç bir
alt_descriptioniçerir — bunu taslak olarak kullanın, ardından kendi paragrafınızın bağlamında yeniden yazın. “Sabah toplantısında ayakta duran dört meslektaş”, bir anahtar kelime salatasından daha iyidir ve bir ekran okuyucunun gerçekten okuyacağı metin budur. Yaklaşık 125 karakterin altında tutun; yalnızca görsel tamamen dekoratifse boş bırakın (alt=""). -
Hiçbir şey sizi zorlamasa bile krediyi ekleyin. Atıf, Pexafy API şartları
tarafından zorunlu kılınmaz ve her sonuç hazır bir
attribution.htmldizesi taşır — ama orijinal kütüphane tarafından eklenen lisans, o fotoğrafı kullanımınızı yine de yönetmeye devam eder ve görünür bir kredi satırı, okuyucuya (ve bir yanıt motoruna) bunun gerçek bir yazarı olan gerçek bir fotoğraf olduğunu söyler. -
Doğru boyutu sunun.
urls.regular(1080 px) bir hero'dur;urls.fullise hiçbir makalenin ihtiyaç duymadığı 2400 px'lik bir dosyadır. Tarayıcının alanı ayırması için yanıttan her zamanwidth/heightyayınlayın — bu tek özellik çifti, iyi ve kötü bir düzen kayması puanı arasındaki farktır. Hero'dafetchpriority="high", ekran altındaki her şeydeloading="lazy"kullanın. -
Hero'yu meta verilerinize besleyin. Aynı URL, hem
og:image'iniz hemtwitter:image'ınız hem deArticleyapılandırılmış verinizinimageözelliği olmalı. Tek fotoğraf, üç yer, sıfır ekstra iş — ve artık logonuza düşmeyen bir sosyal önizleme.
Ayda 100 makalenin gerçekte maliyeti ne kadar
Bir hero artı üç makale içi görsel varsayalım, yani gönderi başına dört arama isteği — kasıtlı olarak israfçı versiyon, yani bir aramadan gelen sonuçları yeniden kullanmak yerine her yuva için ayrı bir sorgu çalıştırdığınız durum:
| Hacim | Arama isteği / ay | Plan | Arama maliyeti |
|---|---|---|---|
| 20 makale | 80 | Ücretsiz — ayda 5.000 istek | 0 $ |
| 100 makale | 400 | Ücretsiz — ayda 5.000 istek | 0 $ |
| 1.000 makalebir ajans, ya da bir müşteri portföyünün tamamı | 4.000 | Ücretsiz — hâlâ 5.000 istek/ay sınırının içinde | 0 $ |
Evet — aylık kota, içerik pazarlama hacimlerinde önemsiz bir konu ve size ödeme yapmanız için
bir sebep uydurmaktansa bunu söylemeyi tercih ederiz. Gerçekte karşılaşacağınız sınır,
dakika başına olan sınırdır. Ücretsiz plan dakikada 20 API isteğine izin verir; 100
makaleyi tek seferde yeniden görsellendiren bir derleme betiği, döngünüzün izin verdiği kadar
hızlı 400 istek gönderir, dolayısıyla ya kısıtlanarak yirmi dakika geçirir ya da
429'lar toplamaya başlar. İki çıkış yolu var: çağrıları aralıklandırın (döngüde
bir sleep, ve geceleri çalışan bir işlem bunu hiç fark etmez), ya da hız sınırı
derlemenizle eşleşen bir plana geçin — Starter dakikada 30 istek, Pro ise 60. Hacme göre değil,
ani yüke göre seçin.
Kalan tek satır, brifi üretmek için makale başına kısa bir model çağrısıdır — birkaç yüz token girdi, otuz token çıktı, ki bu sahip olduğunuz herhangi bir içerik iş akışındaki en ucuz kalem olacaktır. Bunu, gönderi başına dört görsel üretmekle, ayda dört yüz görsele ve kabul edilmeyen denemelere kıyaslayın.
Ve maliyet tablosunda görünmeyen kısım: editör beş sekme açmayı bırakır. Asıl tasarruf da bu.
Kaynaklar ve dipnotlar
1 AB Yapay Zeka Yasası, Madde 50 — belirli yapay zeka sistemlerinin sağlayıcıları ve dağıtıcıları için 2 Ağustos 2026'dan itibaren uygulanacak şeffaflık yükümlülükleri. Sentetik ses, görsel, video ya da metin üreten sistemlerin sağlayıcıları, çıktıları makine tarafından okunabilir bir biçimde işaretlemeli ve bunların yapay olarak üretildiğinin tespit edilebilir olmasını sağlamalıdır; dağıtıcılar ise derin sahteleri ve belirli durumlarda kamuoyunu bilgilendirmek amacıyla yayımlanan yapay zeka üretimi metinleri ifşa etmelidir. Dijital Omnibus (Tüzük (AB) 2026/1744, 27 Temmuz 2026'dan bu yana yürürlükte), Madde 50'nin kendisinde değişiklik yapmaz, ancak 2 Ağustos 2026'dan önce zaten piyasada olan sistemlere, Madde 50(2)'nin makine tarafından okunabilir işaretleme gereksinimini karşılamaları için 2 Aralık 2026'ya kadar süre tanır. Tüm bunlar yapay zeka sağlayıcılarını ve dağıtıcılarını bağlar — bir blogun hangi görselleri yayımlayabileceğine dair bir kural değildir.
2 Google, Arama, Görseller ve Lens genelinde Bu görsel hakkında bölümünde kaynak bilgisini göstermek için C2PA İçerik Kimlik Bilgilerini ve kendi SynthID filigranını okur. Bu, medya kaynağıdır, yapay zeka tarafından üretilen içerik üzerinde bir sıralama cezası değildir.
Kaynaklar 15 Ağustos 2026'da kontrol edildi: AI Act Article 50 · European Commission — transparency FAQ · Google — image metadata · Pexafy API & MCP docs. Arama süreleri ve sonuçları, aynı gün alınmış herkese açık API'den gerçek yanıtlardır.
Sıkça sorulan sorular
Blog makaleleri için yapay zeka tarafından üretilmiş görselleri mi yoksa gerçek fotoğrafları mı kullanmalıyım?
Makaleme uyan bir görseli otomatik olarak nasıl bulabilirim?
GET /api/v1/search/photos?q=… ile yapılır, yaklaşık 150 ms sürer ve her sonuç boyutu, lisansı ve hazır bir atıf metniyle birlikte gelir.Bir makaleyi görsel arama sorgusuna dönüştürmek için en iyi istem nedir?
Blog yazılarında kullandığım fotoğrafları kredilendirmem gerekiyor mu?
Claude veya başka bir yapay zeka ajanı makalem için fotoğraf bulabilir mi?
mcp.pexafy.com/mcp adresindeki barındırılan MCP (Model Context Protocol) sunucusu aracılığıyla. Claude.ai veya Claude Desktop'ta özel bir bağlayıcı olarak ekleyip OAuth ile giriş yapabilir, ya da tek bir claude mcp add komutu ve bir API anahtarıyla Claude Code'a ekleyebilirsiniz. Ajan, taslağınız bağlamda kalırken cümleyle, referans görselle veya benzer fotoğraflarla kendi kendine arama yapabilir.Blogumdaki her makalenin aynı fotoğrafı kullanmasını nasıl önlerim?
photo_id'sini saklayın ve bir sonraki çalıştırmada onu hariç tutun — CMS'inizde tek bir sütun yeterli. Bu, otomatik her iş akışının otuzuncu gönderi civarında karşılaştığı bir hata biçimidir ve biri blog dizininizi kaydırana kadar fark edilmez. Makale başlığını yeniden kullanmak yerine her bölüm için taze bir kamera brifi yazmak gerisini halleder.

