Paano Ilustrahan ang Bawat Artikulong Inilalathala Mo — Gamit ang Tunay na Larawan, sa Malaking Sukat
Kung bakit bumabalik ang mga publishing team sa tunay na larawan, at ang eksaktong pipeline — kasama ang prompt — na nagpapalit ng tapos nang draft tungo sa isang hero image na may credit sa loob lamang ng humigit-kumulang 150 milliseconds.
 Marouane Tijani
10 min na pagbabasa

Bawat artikulong inilalathala mo ay nangangailangan ng larawan. Hindi ito isang bagay na "nice-to-have" — ang hero image ang ipinapakita ng social preview, ang unang nakikita ng mambabasa bago ang unang pangungusap, at ang nagsasabi sa kanya sa loob ng kalahating segundo kung ang pahinang ito ay ginawa ng taong may malasakit. I-multiply iyan ng apat na larawan kada post at apatnapung post kada quarter, at ang "maghanap ng litrato" ay hindi na basta gawain kundi isang problema sa pipeline.
Ganito namin ito nilulutas: kung ano ang gagamitin sa halip ng mga generated na larawan at bakit, at ang tatlong paraan para isabak ang Pexafy sa workflow — nang manwal, sa pamamagitan ng API, o sa pamamagitan ng isang AI agent — kasama ang prompt na nagpapalit ng natapos na draft tungo sa isang search sentence na talagang nakakahanap ng resulta.
Bakit mas nananatiling superyor ang tunay na larawan kaysa sa generated
Madali ang gumawa ng illustration, at iyon mismo ang problema. May apat na bagay na nagbago sa pagitan ng "ang AI images ay isang cheat code" at ngayon:
1 · Sa dami, mas mabilis ang paghahanap kaysa sa paggawa
Ang isang generation ay isang prompt, isang paghihintay, isang pagsusuri, at — sa totoo lang — dalawa o tatlo pang pagsubok bago magkaroon ng magagamit. Ang isang semantic search ay iisang request na nagbabalik ng labing-anim na kandidato sa halos 150 milliseconds, bawat isa'y may lisensya na, may kredito na, may sukat na, kasama ang mga dimensyon sa response. Para sa isang larawan, ang pagkakaiba ay isang kape lang. Para sa apat na raang larawan kada quarter, ito ang pagkakaiba sa pagitan ng isang workflow at isang trabaho.
2 · Tumpak ang litrato; katanggap-tanggap lamang ang generation
Sa sandaling ang artikulo mo ay tungkol sa isang bagay na totoo — isang propesyon, isang kagamitan, isang lungsod, isang kilos, isang materyal — ang isang generated na larawan ay tama sa vibe ngunit mali sa detalye. Ang mga kamay na may anim na daliri ang joke version; ang mahal na version ay isang instrumentong pang-kirurhiko na hindi umiiral, isang cockpit na may kathang-isip na kontrol, o isang "kalye sa Lisbon" na walang taga-Lisbon ang makikilala. Napapansin ito ng mga mambabasang nakakaalam ng paksa mo, at ang litrato ang unang napapansin nila.
3 · Pareho ang itsura ng lahat
Ang mga diffusion model ay nagsasama-sama patungo sa iisang house style, at ang isang pader ng soft-gradient, over-lit, kahina-hinalang simetriko na mga illustration ay tinitingnan na ngayon bilang filler. Ang perception na iyon ang tunay na gastos: hindi isang parusa, kundi isang senyales. Ang isang tunay na litrato — may grain, may awkward na upuan, may taong nasa gitna ng pagsasalita — ay tinitingnan bilang reporting.
4 · At ngayon, may nakakabit na label
Ito ay konteksto lamang kaysa sa isang argumento, ngunit ito ang direksyon ng takbo ng mga bagay. Simula noong 2 Agosto 2026, ang Artikulo 50 ng EU AI Act ay nangangailangan sa mga provider ng generative systems na markahan ang mga synthetic output sa isang machine-readable na format, at sa mga deployer na ibunyag ang mga deepfake.1 Sa panig ng detection, binabasa ng Google ang C2PA Content Credentials at ang sarili nitong SynthID watermark upang sagutin ang "AI-generated ba ito?" sa loob ng Search, Images at Lens.2 Wala roon ang isang alituntunin tungkol sa kung anong mga larawan ang maaaring ilathala ng isang blog, at wala roon ang magpapababa sa ranking mo. Ang nagbago ay ang downstream: ang provenance ng litrato sa tuktok ng artikulo mo ay isang bagay na ngayo'y maaaring tsekihin ng isang mambabasa sa dalawang click, nang hindi ka na tinatanong. Ang isang lisensyadong litrato ay walang kailangang ideklara.
Kailan ang generated images ang tamang gamitin. Mga concept diagram at schematic. Isang eksena na hindi maaaring kunan ng litrato (isang produktong hindi pa umiiral, isang abstract na mekanismo, isang lungsod sa hinaharap). Isang house illustration style na pag-aari mo at gustong ulitin sa bawat post. At anumang bagay kung saan ang larawan ay sinasadyang unawain bilang isang illustration sa halip na ebidensya. Gamitin ang dalawa — itigil lang ang paggamit ng generation bilang default para sa "kailangan ko ng litrato ng mga taong nasa isang meeting."
Tatlong paraan para mag-illustrate, depende sa dami mo
Parehong engine, parehong catalogue — 9M+ na libreng gamitin na litrato mula sa 9 na library — at tatlong entry point. Pumili batay sa bilang ng artikulong inilalathala mo, hindi sa antas mo ng teknikal na kaalaman.
| Entry point | Pinakamainam para sakanino at gaano karami | Kada artikulo | Kailangan mo |
|---|---|---|---|
| Search UI | Mga editor, isang post sa isang pagkakataon — hanggang ~20/buwan | ~30 segundo | Isang browser. Walang kailangang account para maghanap. |
| REST API | Isang CMS, isang static-site build, isang batch ng mga draft | ~1 request, ~150 ms | Isang API key. 5,000 req/buwan libre, 20/minuto. |
| MCP server | Ang AI agent na sumusulat o nag-edit ng draft | Sa loob ng parehong usapan | Isang connector URL, OAuth o isang key. |
Nagbabahagi ang tatlo ng iisang catalogue at iisang ranking, kaya't ang litratong nahanap ng isang editor sa UI ay siya ring litrato, na may parehong identifier, na ibinabalik ng API sa iyong build script.
Isang artikulo, 30 segundo: ang search UI
Ilarawan ang eksena sa paraang ilalarawan mo ito sa isang photographer, sa buong pangungusap, sa
sarili mong wika. Hindi team meeting —
"a small team standing in a semi circle for a short morning stand-up meeting in a bright
open plan office". Bawat karagdagang konkretong detalye ay nagpapakitid sa result set sa halip
na ubusin ito, dahil ang engine ay nagra-rank batay sa kahulugan sa halip na itugma ang mga salita
mo sa mga tag ng iba.
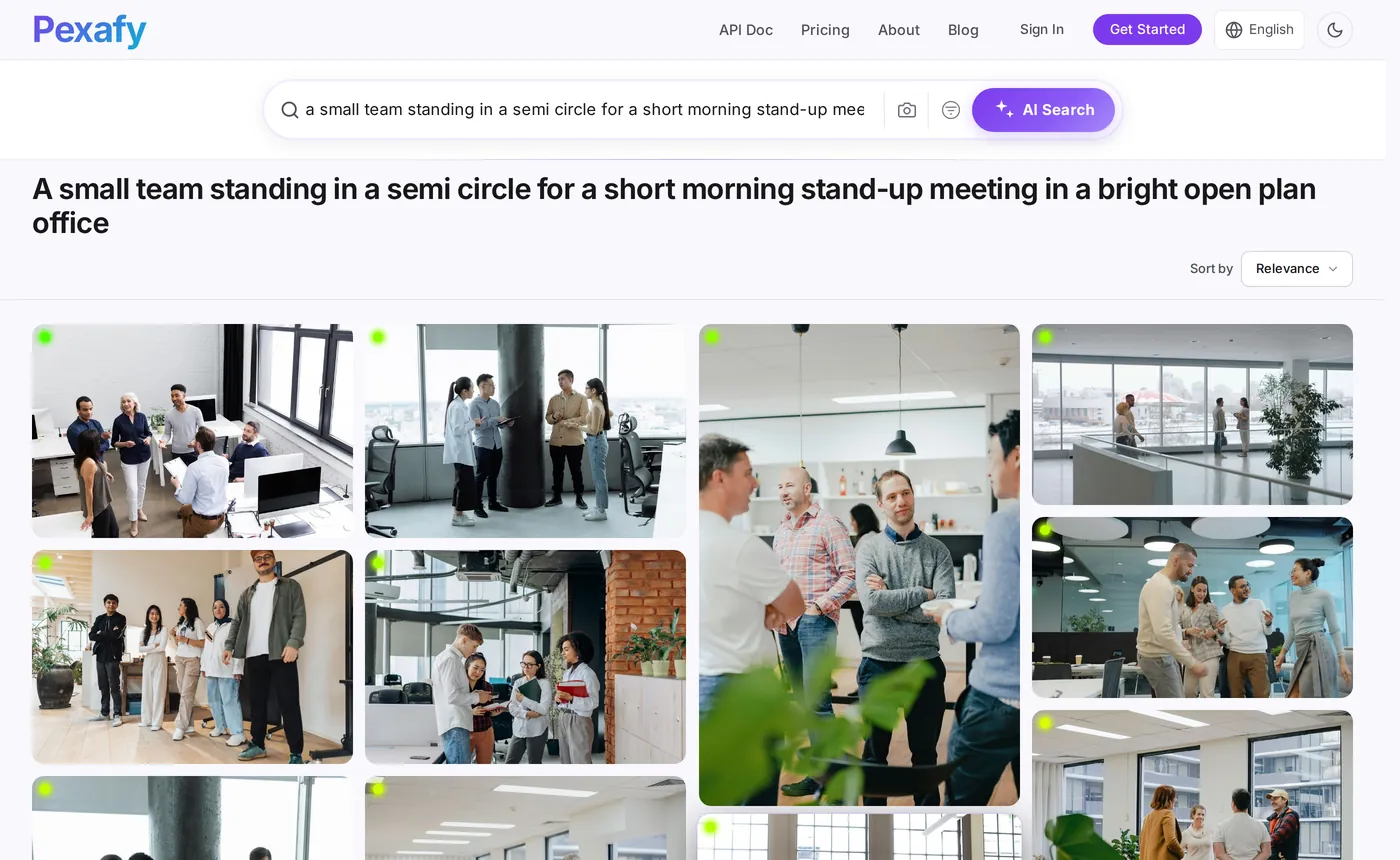
Pagkatapos, paliitin ito gamit ang mga filter na mahalaga para sa layout ng artikulo — at iyon lang:
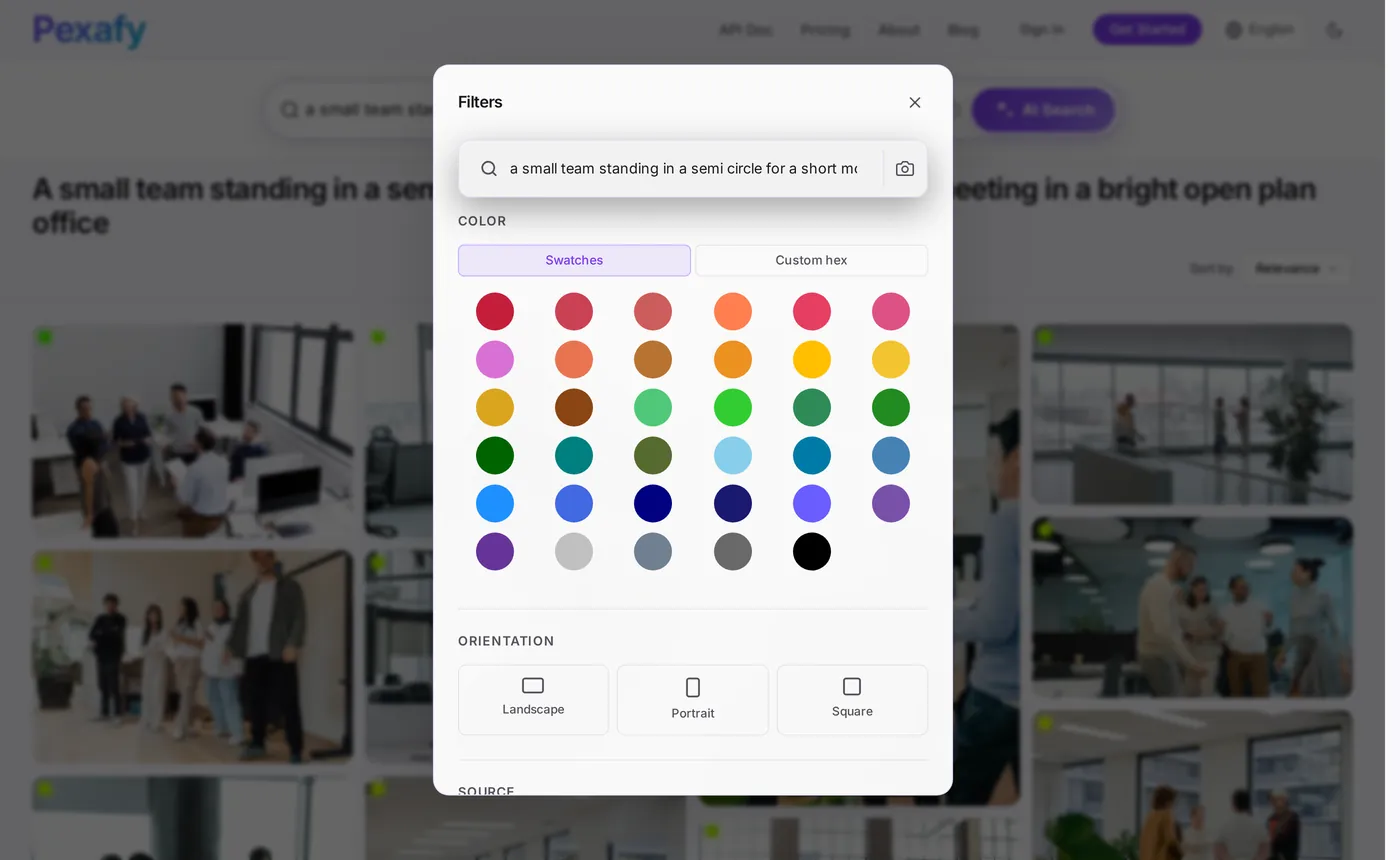
- Isulat ang pangungusap, hindi ang keyword. Paksa + kilos + lugar + liwanag. Hanggang 500 karakter, sa alinman sa 100+ na wika.
- I-filter sa landscape para sa hero, tapos i-run muli nang walang filter para sa mga larawan sa loob ng artikulo, kung saan mas madalas na mas maganda ang portrait.
- Buksan ang litrato para makuha ang handa nang attribution line, ang orihinal na source page, at ang full-resolution na file.
- Gamitin ang "similar photos" sa napili mo para mag-illustrate ng susunod na seksyon sa parehong visual register — parehong liwanag, parehong treatment, ibang eksena.
Ang prompt: gawing search sentence ang isang draft
Ito ang hakbang na palaging mali ang gawa ng lahat kapag nag-automate sila. Ipinapasok nila ang title ng artikulo nang diretso sa search box, at ang title ay eksaktong maling input: ito ay abstract ("The hidden cost of context switching") at wala talagang litrato sa mundo na naglalarawan nito. Ang gusto mo mula sa model ay hindi isang buod — ito ay isang camera brief.
# system prompt
You are a photo editor. Read the article and write ONE search sentence
for a stock-photo engine that ranks by meaning, not by keywords.

Rules:
1. Describe a scene a camera could have taken: someone doing
   something, somewhere. Never name the topic itself ("fintech",
   "productivity", "SEO") — name what would be in the frame.
2. 12 to 25 words. Longer beats shorter: every concrete detail
   (light, place, gesture, time of day) sharpens the match.
3. No text, logos, brands, charts, screenshots or famous people.
   Free photo libraries have almost none of those.
4. No invisible metaphors ("growth", "synergy", "transformation").
5. Match the mood of the article: calm, tense, tired, celebratory.
6. Write the sentence in English even if the article is not.

Return JSON only:
{ "query": "…", "orientation": "landscape", "alt": "…" }
Ang Panuntunan 1 ang gumagawa ng karamihan ng trabaho. Narito ang parehong panuntunan sa tatlong tunay na draft — ang column sa gitna ay ang itinatype ng isang tao kapag nagmamadali, ang column sa kanan ay ang ibinabalik ng prompt:
| Ang artikulo ay tungkol sa… | Ang nagmamadaling query | Ang camera brief |
|---|---|---|
| Bakit sira ang iyong daily stand-up | team meeting |
"a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office" |
| Pagbawas ng onboarding mula 6 na linggo tungong 9 na araw | onboarding |
"a new employee on their first day at a desk, listening while a colleague leans in and points at their screen" |
| Ang nakatagong gastos ng context switching | productivity |
"a tired developer rubbing their eyes in front of two monitors late in the evening, the office empty behind them" |
Ibinabalik ng team meeting ang generic na conference-room stock na ginagamit na rin
ng lahat sa paksa mo. Ang pangungusap sa ikatlong column ay ibinabalik ito, sa loob ng
155 milliseconds:
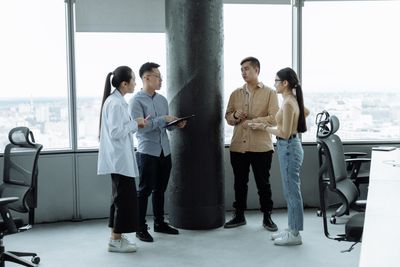

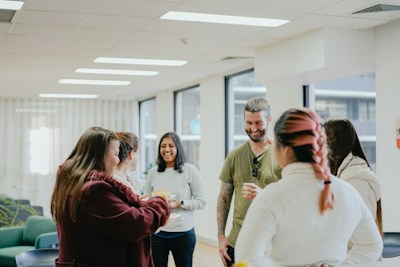
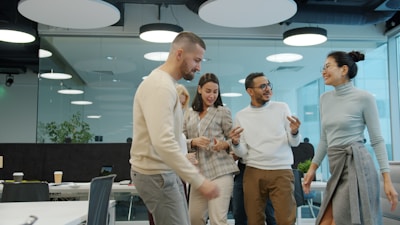
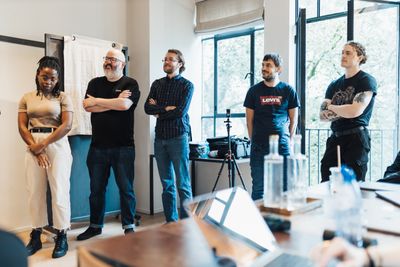
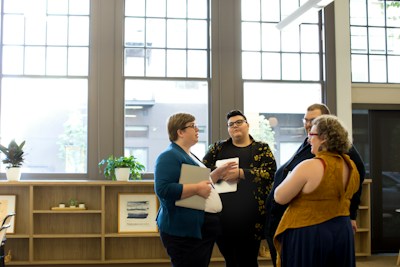
team meeting.
Ang pipeline: draft papasok, credited hero image papalabas
Apatnapung linya, dalawang tawag: isa sa model para sa brief, isa sa Pexafy para sa litrato. Ilagay ito sa save hook ng iyong CMS, sa iyong static-site build, o sa isang script na sumusuri ng isang folder ng mga Markdown file.
import json, os, requests
from anthropic import Anthropic

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
llm = Anthropic()  # ANTHROPIC_API_KEY mula sa environment

def camera_brief(article: str) -> dict:
    # PHOTO_EDITOR = ang system prompt sa itaas
    msg = llm.messages.create(
        model="claude-sonnet-5",
        max_tokens=300,
        system=PHOTO_EDITOR,
        messages=[{ "role": "user", "content": article[:12000] }],
    )
    return json.loads(msg.content[0].text)

def illustrate(article: str) -> dict | None:
    brief = camera_brief(article)
    r = requests.get(
        SEARCH,
        headers={"X-Api-Key": os.environ["PEXAFY_API_KEY"]},
        params={
            "q": brief["query"],           # ang buong pangungusap
            "orientation": brief["orientation"],
            "per_page": 8,
            "score_threshold": 0.55,      # tanggalin ang mahihinang tugma
        },
        timeout=10,
    )
    hits = r.json()["data"]
    if not hits:                        # masyadong makitid ang brief → palawakin, subukang muli
        return None

    top = hits[0]
    return {
        "src":    top["urls"]["regular"],        # 1080px — sukat ng hero
        "alt":    brief["alt"] or top["alt_description"],
        "credit": top["attribution"]["html"],   # handa nang i-render
        "width":  top["width"],
        "height": top["height"],
        "id":     top["photo_id"],           # itago ito: walang paulit-ulit
    }
Tatlong detalye na nagpapalit sa isang demo tungo sa isang bagay na maaari mong iwanang tumatakbo:
score_threshold— mas mainam ang walang ibalik kaysa sa magbalik ng masamang litrato. Kung masyadong specific ang brief, palawakin ito (tanggalin ang huling sugnay) at subukang muli nang isang beses.- Itago ang
photo_id— isang linya sa iyong database, at wala nang dalawang artikulo sa site mo ang magkakapareho ang hero image. Ito ang pagkakamaling natitisod ng lahat sa post number thirty. - Isang request kada image slot — isang hero kasama ng tatlong larawan ng seksyon ay apat na request kada artikulo, o isa lamang kung kukunin mo ang apat na magkaibang resulta mula sa parehong search.
Walang Python? Ang buong kalahati ng search ay isang linya lang, at ang bawat resulta ay may parehong mga field anuman ang library na pinagmulan:
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a tired developer rubbing their eyes at two monitors" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "per_page=6"

# → { "success": true, "data": [ … ], "meta": { "took_ms": 147 } }
Ang hugis ng response — urls, width, photographer_full_name,
source, license_type, relevance_score,
attribution — ay magkatulad para sa isang litrato ng Pexels, isang litrato ng
Pixabay, at isang litrato ng Unsplash. Ang normalisasyong iyon ang bahaging kung hindi man ay
isusulat at pananatilihin mo mismo; sinuri namin ito nang paisa-isa sa
ang paghahambing ng mga libreng stock photo API.
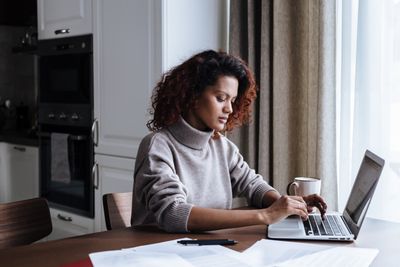
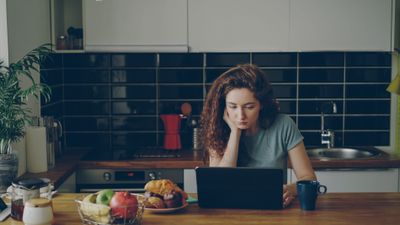
Ikalawang seksyon, ikalawang brief, ikalawang search — ang punto ay isang artikulo ay nagbubunga ng ilang natatanging eksena sa halip na isang litrato na binanat nang apat na beses:
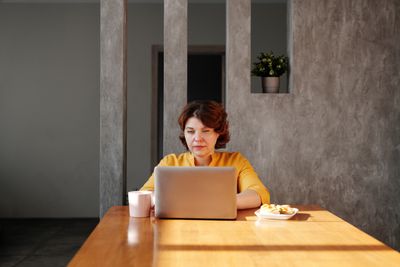
Hayaang piliin ng agent ang litrato: MCP
Kung mayroon nang model na sumusulat o nag-eedit ng draft, ang pinakamalinis na pipeline ay walang pipeline: bigyan ang agent ng search tool at hayaan itong mag-illustrate ng kaka-sulat lang nito, sa parehong usapan, habang taglay pa nito ang konteksto.
Nagpapatakbo ang Pexafy ng isang hosted Model Context Protocol server sa
mcp.pexafy.com/mcp. Tatlong tool:
search_photos (isang pangungusap),
search_photos_by_image (isang reference image, opsyonal na may kasamang pangungusap
— "katulad nito, pero sa oras ng paglubog ng araw"), at get_similar_photos (mas marami pa
na katulad ng napili mo na, na siyang paraan para mapanatiling magkatugma ang isang serye).
Settings → Connectors → Add custom connector
Name: Pexafy
URL:  https://mcp.pexafy.com/mcp
# pagkatapos ay mag-sign in gamit ang Pexafy account mo kapag bumukas ang window
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# o i-commit ito sa repo, para makuha ito ng buong team — .mcp.json
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
Mula roon, ang pag-illustrate ng isang artikulo ay isang pangungusap na lang, hindi isang gawain. Isinusulat ng agent ang sarili nitong camera brief — kababasa lang nito ng draft, kaya't mas nakapwesto ito kaysa sino man para ilarawan ang eksena:
You  Here's the draft of this week's post. Find a landscape hero
     and one photo for section 2, and give me the credit lines.

Claude  → search_photos(
       q="a small team standing in a semi circle for a short morning
          stand-up meeting in a bright open plan office",
       orientation="landscape")
     ← 16 photos · 155 ms

     Hero    → Photo by Thirdman on Pexels · 6453×4302 · score 0.80
     Section → Photo by Marcus Aurelius on Pexels · 6000×4000
     Both licence-free, attribution lines below, ready to paste.
Ang Unsplash, Pexels, Pixabay at Openverse ay walang opisyal na MCP server — ang umiiral ay mga community wrapper na iho-host at ki-key mo mismo. Kung ang editorial workflow mo ay dumadaloy na sa isang agent, ang pagkakaibang iyon ang siyang integration.
Alt text, lisensya, at bilis ng pahina
Napili na ang litrato. Apat na bagay ang magpapasya kung matutulungan nito ang pahina o tahimik na masasaktan ito:
-
Isulat ang alt text para sa isang tao, hindi para sa isang crawler. Bawat
resulta ay may kasamang
alt_description— gamitin ito bilang draft, tapos isulat itong muli sa konteksto ng iyong talata. "Apat na katrabaho na nakatayo sa isang morning meeting" ay mas mainam kaysa sa halo-halong keyword, at ito ang teksto na talagang babasahin ng isang screen reader. Panatilihin itong mas mababa sa ~125 karakter; iwanan itong walang laman (alt="") lamang kung ang larawan ay purong dekorasyon. -
Isama ang kredito kahit walang pumipilit sa iyo. Hindi kinakailangan ang
attribution ng mga tuntunin ng Pexafy API at bawat resulta ay may kasamang handa nang
attribution.htmlstring — ngunit ang lisensyang nakakabit ng orihinal na library ay pinamamahalaan pa rin ang paggamit mo sa litratong iyon, at ang isang nakikitang credit line ang nagsasabi sa isang mambabasa (at sa isang answer engine) na ito ay isang tunay na litrato na may tunay na may-akda. -
Ihatid ang tamang sukat. Ang
urls.regular(1080 px) ay isang hero; angurls.fullay isang 2400 px na file na walang artikulong kailangan. Palaging ilabas angwidth/heightmula sa response para mareserba ng browser ang espasyo — ang isang pares ng attribute na iyon ang pagkakaiba sa pagitan ng isang mahusay at masamang layout-shift score. Gamitin angfetchpriority="high"sa hero,loading="lazy"sa lahat ng nasa ibaba ng fold. -
Ipakain ang hero sa iyong metadata. Ang parehong URL ang dapat maging iyong
og:image, iyongtwitter:image, at angimageproperty ng iyongArticlestructured data. Isang litrato, tatlong lugar, walang karagdagang gawain — at isang social preview na hindi na babalik sa logo mo.
Ang tunay na halaga ng 100 artikulo kada buwan
Ipagpalagay na isang hero at tatlong larawan sa loob ng artikulo, kaya't apat na search request kada post — ang sinasadyang masayang bersyon, kung saan nagpapatakbo ka ng hiwalay na query kada slot sa halip na gamitin muli ang mga resulta mula sa isa:
| Dami | Search requests / buwan | Plano | Gastos sa search |
|---|---|---|---|
| 20 artikulo | 80 | Libre — 5,000 req/buwan | $0 |
| 100 artikulo | 400 | Libre — 5,000 req/buwan | $0 |
| 1,000 artikuloisang ahensya, o isang buong portfolio ng kliyente | 4,000 | Libre — nasa loob pa rin ng 5,000 req/buwan | $0 |
Oo — ang quota kada buwan ay hindi isyu sa antas ng dami ng content marketing, at mas gugustuhin
naming sabihin ito kaysa umimbento ng dahilan para magbayad ka. Ang limitasyong tunay
mong maabot ay ang kada minuto. Pinapayagan ng free plan ang 20 API requests bawat
minuto; ang isang build script na muling nag-i-illustrate ng 100 artikulo sa iisang pass ay
nagpapaputok ng 400 request nang kasimbilis ng loop mo, kaya't magugugol ito ng dalawampung
minuto na naka-throttle o magsisimulang mangolekta ng mga 429. Dalawang paraan para
umiwas: pahalughugin ang mga tawag (isang sleep sa loop, at hindi napapansin ito ng
isang nightly job), o lumipat sa isang plano na tumutugma ang rate limit sa build mo — ang
Starter ay 30 requests/minuto, ang Pro ay 60. Pumili batay sa burst, hindi sa dami.
Ang tanging ibang linya ay isang maikling model call kada artikulo para makagawa ng brief — ilang daang token papasok, tatlumpu papalabas, na siyang magiging pinakamurang item sa anumang content pipeline na pag-aari mo. Ihambing iyan sa paggawa ng apat na larawan kada post, sa apat na raang larawan kada buwan, kasama ang mga pagsubok na hindi nakalusot.
At ang bahaging hindi lumalabas sa isang cost table: hindi na binubuksan ng editor ang limang tab. Iyon ang tunay na ipinon.
Mga Sanggunian & footnote
1 EU AI Act, Artikulo 50 — mga obligasyon sa transparency para sa mga provider at deployer ng ilang AI system, ipinapatupad simula 2 Agosto 2026. Ang mga provider ng mga system na gumagawa ng synthetic audio, imahe, video, o teksto ay dapat markahan ang mga output sa isang machine-readable na format at gawin itong madetect bilang artipisyal na nilikha; ang mga deployer ay dapat ibunyag ang mga deepfake at, sa mga tinukoy na kaso, ang AI-generated na tekstong inilathala upang ipaalam sa publiko. Ang Digital Omnibus (Regulation (EU) 2026/1744, ipinapatupad simula 27 Hulyo 2026) ay hindi binago ang Artikulo 50 mismo, ngunit binigyan ang mga system na nasa merkado na bago ang 2 Agosto 2026 ng hanggang 2 Disyembre 2026 upang matugunan ang kinakailangang machine-readable na pagmamarka ng Artikulo 50(2). Ang lahat ng ito ay nagbubuklod sa mga AI provider at deployer — hindi ito isang alituntunin tungkol sa kung anong mga larawan ang maaaring ilathala ng isang blog.
2 Binabasa ng Google ang C2PA Content Credentials at ang sarili nitong SynthID watermark upang ipakita ang provenance sa About this image sa buong Search, Images, at Lens. Ito ay media provenance, hindi isang parusa sa ranking laban sa AI-generated na content.
Mga sanggunian na na-check noong 15 Agosto 2026: AI Act Article 50 · European Commission — transparency FAQ · Google — image metadata · Pexafy API & MCP docs. Ang mga oras ng search at resulta ay tunay na tugon mula sa pampublikong API, na nakuha sa parehong araw.
Mga madalas na tanong
Dapat ba akong gumamit ng mga larawang gawa ng AI o tunay na larawan para sa mga artikulo sa blog?
Paano ako awtomatikong makakahanap ng larawang tugma sa aking artikulo?
GET /api/v1/search/photos?q=…, humigit-kumulang 150 ms, at bawat resulta ay may kasamang laki, lisensya, at handa nang attribution string.Ano ang pinakamahusay na prompt para gawing image search query ang isang artikulo?
Kailangan ko bang mag-credit sa mga larawang ginagamit ko sa mga blog post?
Maaari bang hanapin ni Claude o ng ibang AI agent ang mga larawan para sa aking artikulo?
mcp.pexafy.com/mcp. Idagdag ito bilang custom connector sa Claude.ai o Claude Desktop at mag-sign in gamit ang OAuth, o idagdag ito sa Claude Code gamit ang isang utos na claude mcp add at isang API key. Ang agent ay maghahanap na ngayon sa pamamagitan ng pangungusap, ng reference image, o ng mga katulad na larawan mismo, habang nasa context pa rin nito ang iyong draft.Paano ko mapipigilan ang bawat artikulo sa aking blog na gumamit ng parehong larawan?
photo_id ng bawat larawang inilathala mo at ibukod ito sa susunod na run — isang column lamang sa iyong CMS. Ito ang failure mode na nararanasan ng bawat automated pipeline sa paligid ng ika-tatlumpung post, at hindi ito napapansin hanggang sa may mag-scroll sa index ng iyong blog. Ang pagsulat ng bagong camera brief bawat seksyon, sa halip na muling gamitin ang pamagat ng artikulo, ang bahala sa nalalabi.

