如何为你发布的每篇文章配图——用真实照片,规模化实现
为什么内容团队正在回归真实摄影,以及那条能把一篇定稿文章在约150毫秒内变成一张署名版头图的完整流程——附提示词。
 Marouane Tijani
10 分钟阅读

你发布的每一篇文章都需要一张图片。这不是可有可无的东西——头图是社交预览显示的内容,是读者在看到第一句话之前看到的内容,也是在半秒钟内告诉他们这个页面是否用心制作的东西。把这一点乘以每篇文章四张图片、每季度四十篇文章,"找一张照片"就不再是一项任务,而变成了一个流水线问题。
我们是这样解决的:用什么来替代生成图像,以及原因,还有把 Pexafy 接入工作流程的三种方式——手动、通过 API,或通过 AI 智能体——包括把一份完成的草稿转化为真正能找到结果的搜索句子的提示词。
为什么真实照片仍然胜过生成图像
生成一张插图很容易,而这恰恰是问题所在。从"AI 图像是一种作弊手段"到今天,有四件事发生了变化:
1 · 在大批量情况下,搜索比生成更快
一次生成需要一个提示词、一段等待、一次检查——说实话——通常还要再尝试两三次才能得到一张可用的图片。一次语义搜索只需一个请求,大约在 150 毫秒内返回十六个候选结果,每一个都已获得授权、已署名、已调整好尺寸,响应中还包含其尺寸信息。对一张图片来说,这个差异不过是一杯咖啡的时间;但对一个季度四百张图片来说,这就是工作流程与苦役之间的区别。
2 · 照片是准确的;生成图像只是看似合理
一旦你的文章涉及某种真实的事物——一种职业、一件设备、一座城市、一个动作、一种材料——生成图像就会把氛围做对,却把细节做错。六根手指是玩笑版本;昂贵的版本是一件不存在的手术器械、一个带有臆造控制装置的驾驶舱,或是一条没有任何里斯本人认得出来的"里斯本街道"。了解你所写主题的读者会注意到这一点,而且他们首先注意到的就是图片。
3 · 每个人的效果都一样
扩散模型会收敛到一种固定的风格,如今满屏柔和渐变、过度打光、诡异对称的插图读起来就像填充物。这种印象才是真正的代价:不是惩罚,而是一种信号。一张真实的照片——颗粒感、一把摆放别扭的椅子、某人说到一半的样子——读起来则像是在报道现实。
4 · 而现在它们自带标签
这一点与其说是论据,不如说是背景信息,但它代表了发展方向。自2026 年 8 月 2 日起,欧盟《人工智能法案》第 50 条要求生成式系统的提供者以机器可读的格式标记合成输出内容,并要求部署者披露深度伪造内容。1在检测方面,谷歌读取 C2PA 内容凭证及其自有的 SynthID 水印,以在搜索、图片和 Lens 中回答"这是不是 AI 生成的?"这个问题。2这些规定都不涉及博客可以发布哪些图片,也不会让你损失排名。真正改变的是下游:你文章顶部图片的来源信息,如今读者只需点击两次就能自行核实,无需询问你。一张获得授权的照片没有什么需要申报的。
什么时候生成图像才是正确的选择。概念图和示意图。无法拍摄的场景(尚不存在的产品、抽象机制、未来城市)。一种你拥有并希望在每篇文章中重复使用的自有插画风格。以及任何图片被有意理解为插图而非实证证据的情况。两者都用——只是不要再把生成默认用于"我需要一张人们开会的照片"这类需求。
根据发布量选择三种配图方式
同样的引擎,同样的图库——来自 9 个图库的 9M+ 张免费可用照片——以及三个入口。按你每月发布的文章数量来选择,而不是按你的技术水平来选择。
| 入口 | 最适合谁,以及多大用量 | 每篇文章 | 需要什么 |
|---|---|---|---|
| 搜索界面 | 编辑,一次处理一篇文章——每月最多约 20 篇 | 约 30 秒 | 一个浏览器。搜索无需账号。 |
| REST API | CMS、静态站点构建,或一批草稿 | 约 1 次请求,约 150 毫秒 | 一个 API 密钥。每月 5,000 次请求免费,每分钟 20 次。 |
| MCP 服务器 | 撰写或编辑草稿的 AI 智能体 | 在同一对话内完成 | 一个连接器 URL,OAuth 或密钥。 |
这三者共用同一个图库和同一套排序机制,因此编辑在界面中找到的照片,与 API 返回给你的构建脚本的照片是同一张,具有相同的标识符。
一篇文章,30 秒:搜索界面
用你向摄影师描述场景的方式来描述它,用完整的句子,用你自己的语言。不要写team meeting,而是写
"a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office"。每一个额外的具体细节都会缩小结果集,而不是让它变空,因为引擎是按含义排序,而不是把你的词与别人的标签逐字匹配。
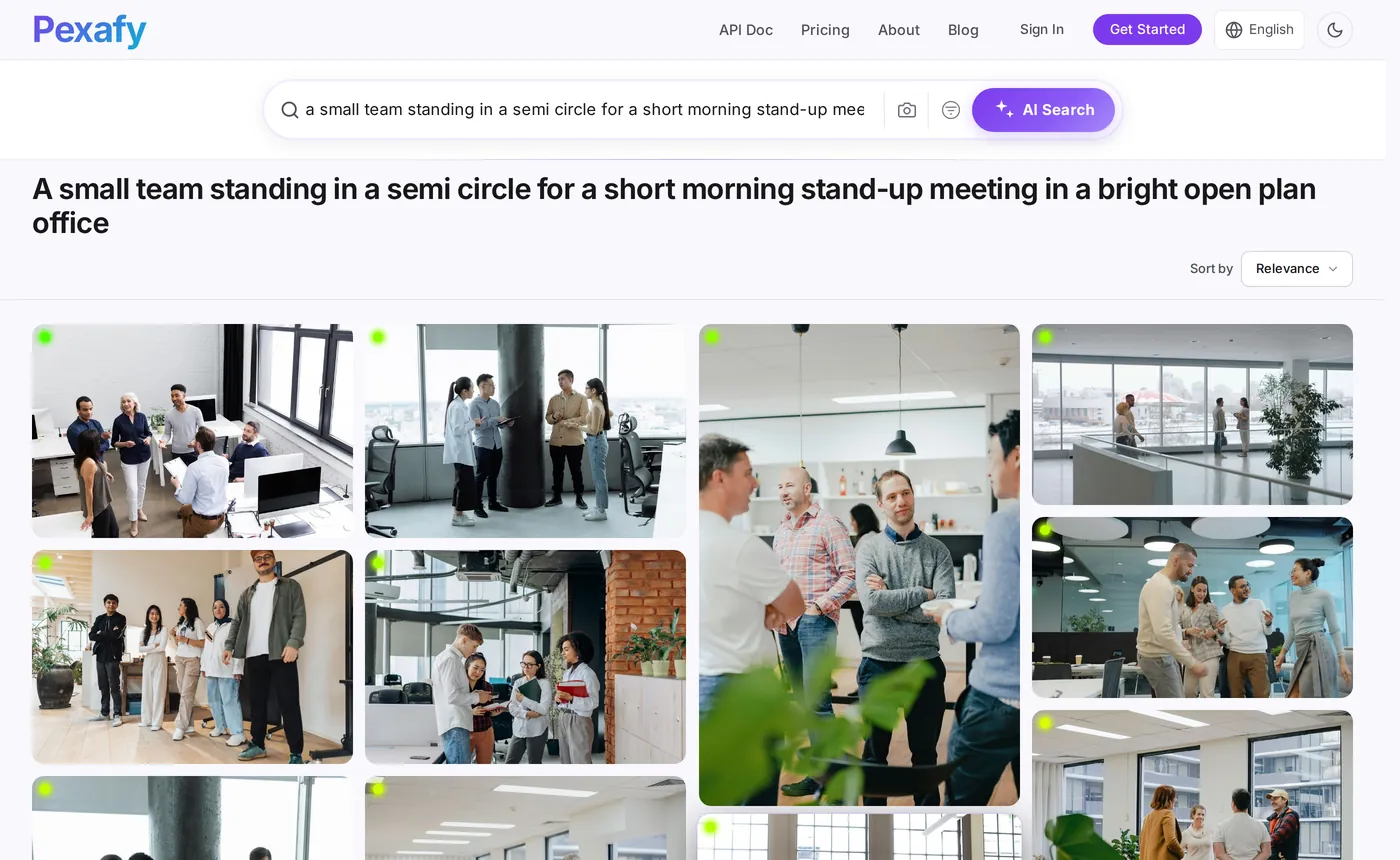
然后用对文章排版真正重要的筛选条件来缩小范围——只用这些:
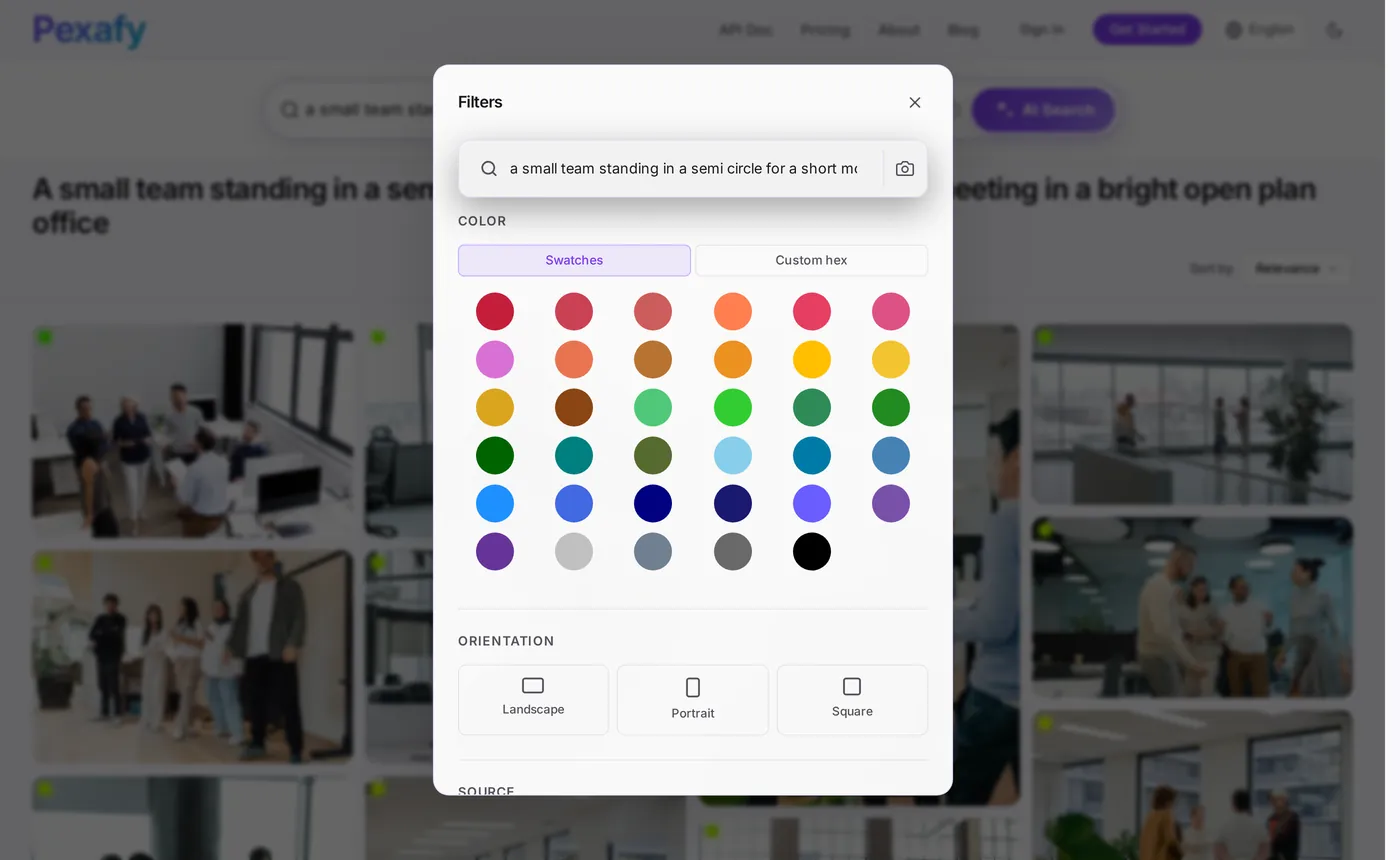
- 写句子,不要写关键词。主体 + 动作 + 地点 + 光线。最多 500 个字符,支持 100 多种语言中的任意一种。
- 筛选为横向用于头图,然后不加筛选重新搜索,用于文章内图片,此时竖版往往效果更好。
- 打开照片获取现成的署名行、原始来源页面和全分辨率文件。
- 在你选中的照片上使用"相似照片",用同样的视觉基调为下一部分配图——同样的光线、同样的处理方式、不同的场景。
这个提示词:把草稿转化为搜索句子
这是每个人自动化时都会做错的一步。他们直接把文章标题输入搜索框,而标题恰恰是最糟糕的输入:它是抽象的 ("The hidden cost of context switching"),世界上没有任何一张照片能描绘它。你想从模型那里得到的不是一份摘要——而是一份拍摄指令。
# system prompt
You are a photo editor. Read the article and write ONE search sentence
for a stock-photo engine that ranks by meaning, not by keywords.

Rules:
1. Describe a scene a camera could have taken: someone doing
   something, somewhere. Never name the topic itself ("fintech",
   "productivity", "SEO") — name what would be in the frame.
2. 12 to 25 words. Longer beats shorter: every concrete detail
   (light, place, gesture, time of day) sharpens the match.
3. No text, logos, brands, charts, screenshots or famous people.
   Free photo libraries have almost none of those.
4. No invisible metaphors ("growth", "synergy", "transformation").
5. Match the mood of the article: calm, tense, tired, celebratory.
6. Write the sentence in English even if the article is not.

Return JSON only:
{ "query": "…", "orientation": "landscape", "alt": "…" }
规则 1 完成了大部分工作。以下是这条规则在三份真实草稿上的应用——中间一列是人在赶时间时会输入的内容,右边一列是提示词返回的结果:
| 文章主题是…… | 仓促输入的查询 | 拍摄指令 |
|---|---|---|
| 为什么你的每日站会形同虚设 | team meeting |
"a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office" |
| 把入职流程从 6 周缩短到 9 天 | onboarding |
"a new employee on their first day at a desk, listening while a colleague leans in and points at their screen" |
| 频繁切换任务背后隐藏的代价 | productivity |
"a tired developer rubbing their eyes in front of two monitors late in the evening, the office empty behind them" |
team meeting 返回的是通用的会议室素材,是你这个主题下其他所有人都已经在用的那种。第三列中的句子在 155 毫秒内返回了这些结果:
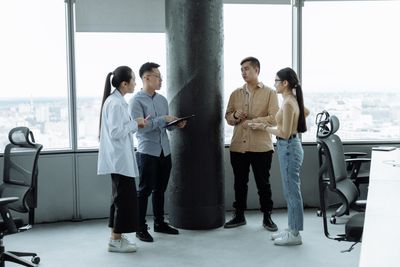

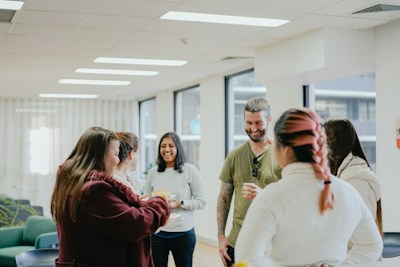
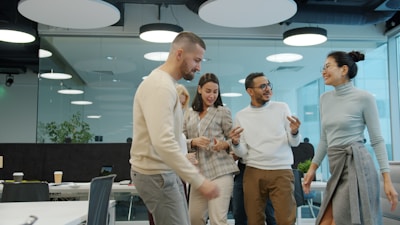
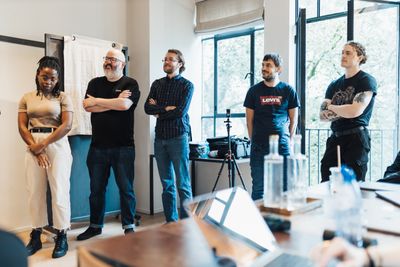
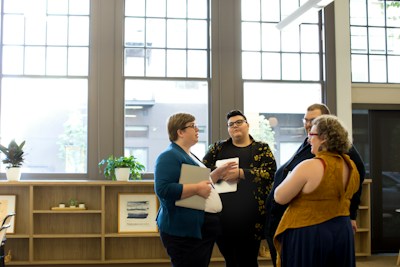
team meeting 从来无法保证这一点。
流水线:草稿输入,署名头图输出
四十行代码,两次调用:一次调用模型获取拍摄指令,一次调用 Pexafy 获取照片。把它放进你的 CMS 保存钩子、静态站点构建,或者一个遍历 Markdown 文件夹的脚本里。
import json, os, requests
from anthropic import Anthropic

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
llm = Anthropic()  # ANTHROPIC_API_KEY 来自环境变量

def camera_brief(article: str) -> dict:
    # PHOTO_EDITOR = 上面的系统提示词
    msg = llm.messages.create(
        model="claude-sonnet-5",
        max_tokens=300,
        system=PHOTO_EDITOR,
        messages=[{ "role": "user", "content": article[:12000] }],
    )
    return json.loads(msg.content[0].text)

def illustrate(article: str) -> dict | None:
    brief = camera_brief(article)
    r = requests.get(
        SEARCH,
        headers={"X-Api-Key": os.environ["PEXAFY_API_KEY"]},
        params={
            "q": brief["query"],           # 完整句子
            "orientation": brief["orientation"],
            "per_page": 8,
            "score_threshold": 0.55,      # 丢弃弱匹配结果
        },
        timeout=10,
    )
    hits = r.json()["data"]
    if not hits:                        # 指令太窄 → 放宽,重试
        return None

    top = hits[0]
    return {
        "src":    top["urls"]["regular"],        # 1080px — 头图尺寸
        "alt":    brief["alt"] or top["alt_description"],
        "credit": top["attribution"]["html"],   # 现成可渲染
        "width":  top["width"],
        "height": top["height"],
        "id":     top["photo_id"],           # 存储它:不重复
    }
三个把演示变成可以持续运行的东西的细节:
score_threshold— 什么都不返回胜过返回一张糟糕的照片。如果指令过于具体,就放宽它(去掉最后一个从句)并重试一次。- 存储
photo_id— 数据库中一行记录,就能让你网站上任何两篇文章都不会共用同一张头图。这是每个人都会在第三十篇文章时撞上的失败情况。 - 每个图片位置一次请求 — 一张头图加三张分区图片,是每篇文章四次请求,或者如果你从同一次搜索中取四个不同结果,就只需一次。
不会 Python?整个搜索部分只需一行命令,无论来自哪个图库,每个结果都带有相同的字段:
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a tired developer rubbing their eyes at two monitors" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "per_page=6"

# → { "success": true, "data": [ … ], "meta": { "took_ms": 147 } }
响应结构——urls、width、photographer_full_name、
source、license_type、relevance_score、
attribution——对于一张 Pexels 照片、一张 Pixabay 照片和一张 Unsplash 照片来说都是相同的。这种规范化本来是你需要自己编写和维护的部分;我们在
免费图库 API 对比一文中逐字段拆解过它。
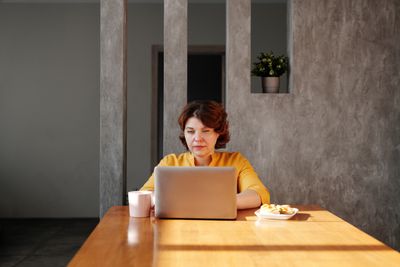
第二部分,第二份指令,第二次搜索——重点是一篇文章能产生几个不同的场景,而不是把一张照片拉伸使用四次:
让智能体挑选图片:MCP
如果模型已经在撰写或编辑草稿,最干净的流水线就是没有流水线:把搜索工具交给智能体,让它在同一个对话中为刚写好的内容配图,此时它仍然掌握着完整的上下文。
Pexafy 在 mcp.pexafy.com/mcp 运行一个托管的 Model Context Protocol 服务器。三种工具:
search_photos(一个句子)、
search_photos_by_image(一张参考图片,可选再加一个句子——"像这样,但在日落时分"),以及 get_similar_photos(更多类似于你已经选中的那张,这也是让一个系列保持视觉一致的方法)。
Settings → Connectors → Add custom connector
Name: Pexafy
URL:  https://mcp.pexafy.com/mcp
# 窗口打开后,用你的 Pexafy 账号登录即可
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# 或将其提交到仓库中,让整个团队都能使用 — .mcp.json
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
从那时起,为一篇文章配图就成了一句话的事,而不再是一项任务。智能体会自己写出拍摄指令——它刚刚读过草稿,因此比任何人都更适合描述这个场景:
You  Here's the draft of this week's post. Find a landscape hero
     and one photo for section 2, and give me the credit lines.

Claude  → search_photos(
       q="a small team standing in a semi circle for a short morning
          stand-up meeting in a bright open plan office",
       orientation="landscape")
     ← 16 photos · 155 ms

     Hero    → Photo by Thirdman on Pexels · 6453×4302 · score 0.80
     Section → Photo by Marcus Aurelius on Pexels · 6000×4000
     Both licence-free, attribution lines below, ready to paste.
Unsplash、Pexels、Pixabay 和 Openverse 没有官方的 MCP 服务器——存在的只是社区维护的封装,需要你自己托管并配置密钥。如果你的编辑工作流程已经通过智能体运行,那么这个差异本身就是集成所在。
Alt 文本、授权与页面速度
图片已经选好了。有四件事决定它是帮助这个页面,还是悄悄拖累它:
-
为人而写 alt 文本,而不是为爬虫而写。每个结果都自带一个
alt_description——把它当作草稿,然后结合你那段文字的语境重写它。"四位同事在晨会上站立交谈"胜过一堆关键词,而且这才是屏幕阅读器实际会读出来的文字。保持在约 125 个字符以内;只有当图片纯属装饰时才留空(alt="")。 -
即使没有强制要求,也要标注署名。Pexafy API 条款并不要求署名,每个结果都自带一个现成的
attribution.html字符串——但原始图库附带的授权方式仍然约束你对该照片的使用,一行可见的署名信息则会告诉读者(以及一个回答引擎)这是一张有真实作者的真实照片。 -
提供合适的尺寸。
urls.regular(1080 px)适合做头图;urls.full是一个 2400 px 的文件,没有任何文章需要它。始终从响应中输出width/height,让浏览器为其预留空间——单单这一对属性,就决定了布局偏移分数是好是坏。头图使用fetchpriority="high",首屏以下的内容使用loading="lazy"。 -
把头图喂给你的元数据。同一个 URL 应该同时是你的
og:image、你的twitter:image,以及你的Article结构化数据中的image属性。一张照片,三个位置,零额外工作——而且社交预览也不再退回到你的 logo。
每月 100 篇文章实际花费多少
假设一张头图加三张文章内图片,即每篇文章四次搜索请求——这是刻意浪费的版本,即为每个位置单独运行一次查询,而不是复用同一次搜索的结果:
| 用量 | 每月搜索请求数 | 套餐 | 搜索费用 |
|---|---|---|---|
| 20 篇文章 | 80 | 免费版 — 每月 5,000 次请求 | $0 |
| 100 篇文章 | 400 | 免费版 — 每月 5,000 次请求 | $0 |
| 1,000 篇文章一家代理机构,或整个客户组合 | 4,000 | 免费版 — 仍在每月 5,000 次请求之内 | $0 |
没错——在内容营销的使用量级下,月度配额根本不是问题,我们宁愿如实说出来,也不愿为了让你付费而编造一个理由。你真正会遇到的限制是每分钟的限制。免费套餐允许每分钟 20 次 API 请求;一个一次性为 100 篇文章重新配图的构建脚本,会以你的循环所允许的最快速度发出 400 次请求,因此它要么花二十分钟被限流,要么开始收到 429 错误。有两种解决办法:把调用分散开(在循环中加一个 sleep,一个夜间任务根本不会注意到),或者换成一个速率限制与你的构建需求相匹配的套餐——入门版是每分钟 30 次请求,专业版是 60 次。按突发量选择,而不是按总量选择。
唯一另外的一项开支是每篇文章一次简短的模型调用,用于生成拍摄指令——输入几百个 token,输出三十个,这将是你拥有的任何内容流水线中最便宜的一项。相比之下,每篇文章生成四张图片,每月四百张图片,再加上那些没能通过筛选的尝试次数。
还有一部分不会出现在成本表里:编辑不再需要打开五个标签页。这才是真正节省下来的东西。
参考资料与脚注
1 欧盟《人工智能法案》第 50 条——针对某些 AI 系统的提供者和部署者的透明度义务,自 2026 年 8 月 2 日起适用。生成合成音频、图像、视频或文本的系统提供者必须以机器可读的格式标记输出内容,并使其能够被检测为人工生成;部署者必须披露深度伪造内容,以及在特定情况下披露为告知公众而发布的 AI 生成文本。数字综合法案(第 (EU) 2026/1744 号条例,自 2026 年 7 月 27 日起生效)并未修改第 50 条本身,但为在 2026 年 8 月 2 日之前已经上市的系统提供了到 2026 年 12 月 2 日为止的宽限期,以满足第 50 条第 2 款的机器可读标记要求。所有这些约束的都是 AI 提供者和部署者——这不是关于博客可以发布哪些图片的规定。
2 谷歌读取 C2PA 内容凭证及其自有的 SynthID 水印,以在搜索、图片和 Lens 中的关于此图片功能里展示来源信息。这是媒体来源信息,而不是对 AI 生成内容的排名惩罚。
资料核实于 2026 年 8 月 15 日: AI 法案第 50 条 · 欧盟委员会 — 透明度常见问题 · 谷歌 — 图片元数据 · Pexafy API 与 MCP 文档。 搜索耗时与结果均为公开 API 的真实响应,于同一天采集。
常见问题
博客文章应该用AI生成的图片还是真实照片?
如何自动找到与我的文章匹配的图片?
GET /api/v1/search/photos?q=…,耗时约150 ms,每个结果都会附带尺寸、许可信息和现成的署名字符串。把文章转换成图像搜索查询的最佳提示词是什么?
我使用的博客图片必须署名吗?
Claude或其他AI代理能为我的文章查找照片吗?
mcp.pexafy.com/mcp即可实现。在Claude.ai或Claude Desktop中将其添加为自定义连接器并通过OAuth登录,或者在Claude Code中用一条claude mcp add命令加上API密钥即可添加。这样,代理在仍保有你文稿上下文的情况下,就能自行按句子、按参考图片或搜索相似照片。如何避免我博客上的每篇文章都用同一张照片?
photo_id,并在下一次运行时将其排除——在CMS里加一列即可。这是几乎每条自动化流程都会在第三十篇文章左右遇到的失败模式,而且在有人翻阅你的博客索引之前,这个问题往往不易察觉。每个段落都撰写全新的取景简报,而不是重复使用文章标题,就能解决剩下的问题。

