Comment illustrer chaque article publié — avec de vraies photos, à grande échelle
Pourquoi les équipes éditoriales reviennent à la photographie réelle, et le pipeline exact — prompt inclus — qui transforme un brouillon terminé en image de couverture créditée en environ 150 millisecondes.
 Marouane Tijani
10 min de lecture

Chaque article que vous publiez a besoin d'une image. Pas un simple plus — l'image principale est ce que l'aperçu social affiche, ce que le lecteur voit avant la première phrase, et ce qui lui indique en une demi-seconde si cette page a été réalisée par quelqu'un qui s'est appliqué. Multipliez cela par quatre images par article et quarante articles par trimestre, et « trouver une photo » cesse d'être une tâche pour devenir un problème de production.
Voici comment nous le résolvons : quoi utiliser à la place des images générées et pourquoi, et les trois façons de intégrer Pexafy au flux de travail — manuellement, par API, ou via un agent IA — y compris le prompt qui transforme un brouillon terminé en une phrase de recherche qui trouve réellement quelque chose.
Pourquoi les vraies photos surpassent toujours les images générées
Générer une illustration est facile, et c'est précisément le problème. Quatre choses ont changé entre « les images IA sont un raccourci » et aujourd'hui :
1 · À grande échelle, chercher est plus rapide que générer
Une génération, c'est un prompt, une attente, une inspection, et — soyons honnêtes — deux ou trois tentatives supplémentaires avant d'obtenir un résultat utilisable. Une recherche sémantique est une simple requête qui renvoie seize candidats en environ 150 millisecondes, chacun déjà sous licence, déjà crédité, déjà dimensionné, avec ses dimensions dans la réponse. Pour une image, la différence tient à une pause café. Pour quatre cents images par trimestre, c'est la différence entre un flux de travail et un travail à temps plein.
2 · Une photographie est exacte ; une génération est plausible
Dès que votre article porte sur quelque chose de réel — une profession, un équipement, une ville, un geste, un matériau — une image générée capture l'ambiance mais se trompe sur les détails. Les mains à six doigts sont la version comique ; la version coûteuse, c'est un instrument chirurgical qui n'existe pas, un cockpit avec des commandes inventées, ou une « rue de Lisbonne » que personne de Lisbonne ne reconnaît. Les lecteurs qui connaissent votre sujet le remarquent, et ils remarquent l'image en premier.
3 · Tout le monde a le même rendu visuel
Les modèles de diffusion convergent vers un style de maison, et un mur d'illustrations aux dégradés doux, sur-éclairées, suspicieusement symétriques se lit désormais comme du remplissage. Cette perception est le vrai coût : non pas une pénalité, un signal. Une vraie photographie — du grain, une chaise maladroite, quelqu'un au milieu d'une phrase — se lit comme un reportage.
4 · Et désormais elles arrivent avec une étiquette
Celui-ci est plutôt un contexte qu'un argument, mais c'est le sens de l'évolution. Depuis le 2 août 2026, l'article 50 du règlement européen sur l'IA (AI Act) exige des fournisseurs de systèmes génératifs qu'ils marquent les sorties synthétiques dans un format lisible par machine, et des déployeurs qu'ils divulguent les deepfakes.1 Côté détection, Google lit les Content Credentials C2PA et son propre filigrane SynthID pour répondre à la question « est-ce généré par l'IA ? » dans Search, Images et Lens.2 Rien de tout cela n'est une règle sur les images qu'un blog peut publier, et rien de tout cela ne vous coûte de positionnement. Ce qui a changé, c'est en aval : la provenance de l'image en tête de votre article est désormais quelque chose qu'un lecteur peut vérifier en deux clics, sans vous le demander. Une photographie sous licence n'a rien à déclarer.
Quand les images générées sont le bon choix. Les diagrammes conceptuels et les schémas. Une scène qui ne peut pas être photographiée (un produit qui n'existe pas encore, un mécanisme abstrait, une ville future). Un style d'illustration maison que vous possédez et souhaitez répéter sur chaque article. Et tout ce où l'image est délibérément comprise comme une illustration plutôt que comme une preuve. Utilisez les deux — cessez simplement d'utiliser la génération par défaut pour « j'ai besoin d'une photo de personnes en réunion ».
Trois façons d'illustrer, selon votre volume
Même moteur, même catalogue — 9M+ photos libres de droits provenant de 9 bibliothèques — et trois points d'entrée. Choisissez selon le nombre d'articles que vous publiez, pas selon votre niveau technique.
| Point d'entrée | Idéal pourqui, et combien | Par article | Ce dont vous avez besoin |
|---|---|---|---|
| Interface de recherche | Éditeurs, un article à la fois — jusqu'à ~20/mois | ~30 secondes | Un navigateur. Aucun compte nécessaire pour chercher. |
| API REST | Un CMS, une build de site statique, un lot de brouillons | ~1 requête, ~150 ms | Une clé API. 5 000 req/mois gratuites, 20/min. |
| Serveur MCP | L'agent IA qui rédige ou modifie le brouillon | Dans la même conversation | Une URL de connecteur, OAuth ou une clé. |
Les trois partagent un catalogue et un classement uniques, si bien qu'une photo trouvée par un éditeur dans l'interface est la même photo, avec le même identifiant, que celle renvoyée par l'API à votre script de build.
Un article, 30 secondes : l'interface de recherche
Décrivez la scène comme vous la décririez à un photographe, en phrase complète, dans votre
propre langue. Pas team meeting —
« une petite équipe debout en demi-cercle pour une courte réunion matinale de type stand-up dans un
bureau lumineux en open space ». Chaque détail concret supplémentaire resserre l'ensemble de résultats au lieu de le vider,
car le moteur classe par sens plutôt qu'en faisant correspondre vos mots aux étiquettes de quelqu'un d'autre.
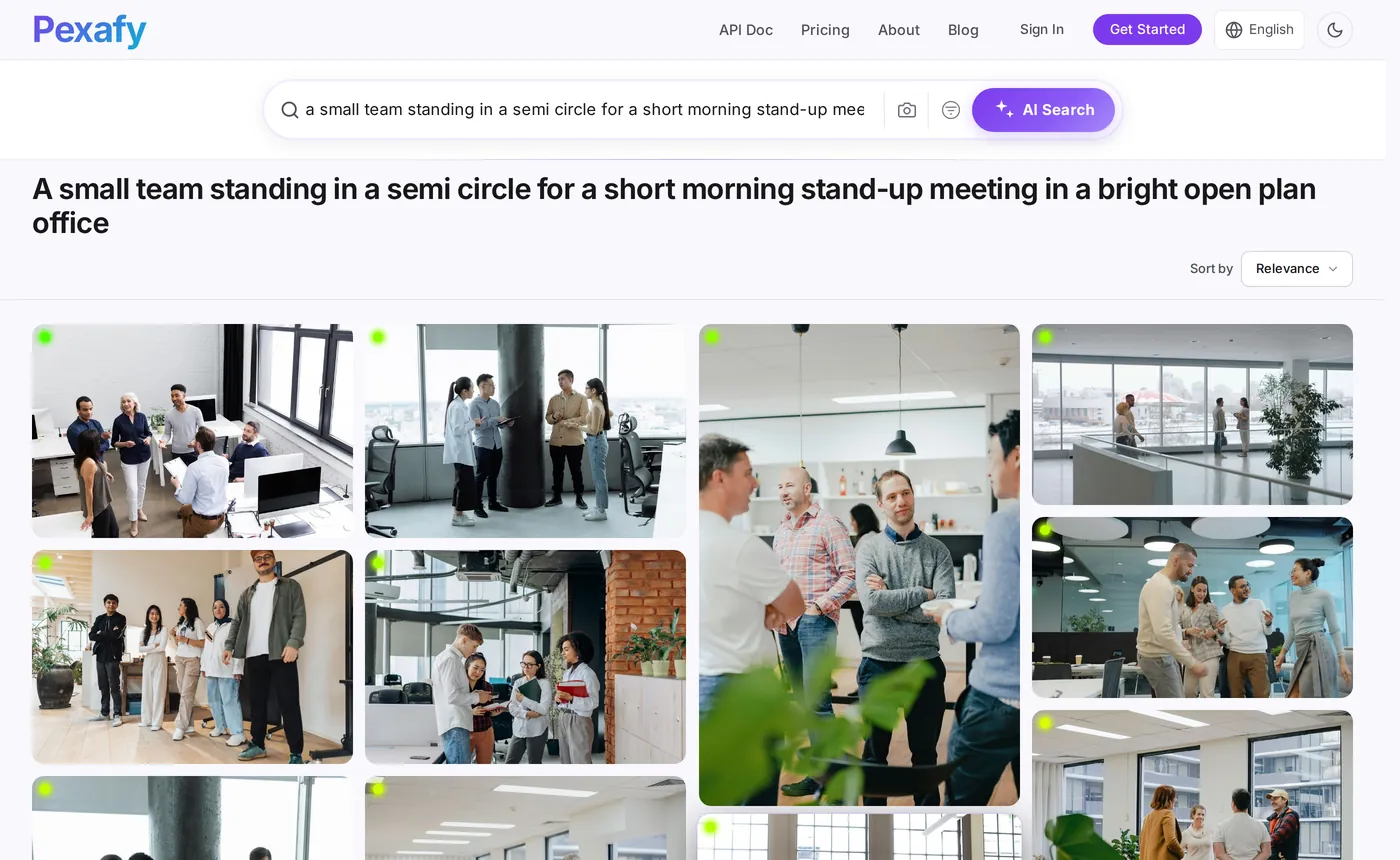
Puis affinez avec les filtres qui comptent pour la mise en page d'un article — et uniquement ceux-ci :
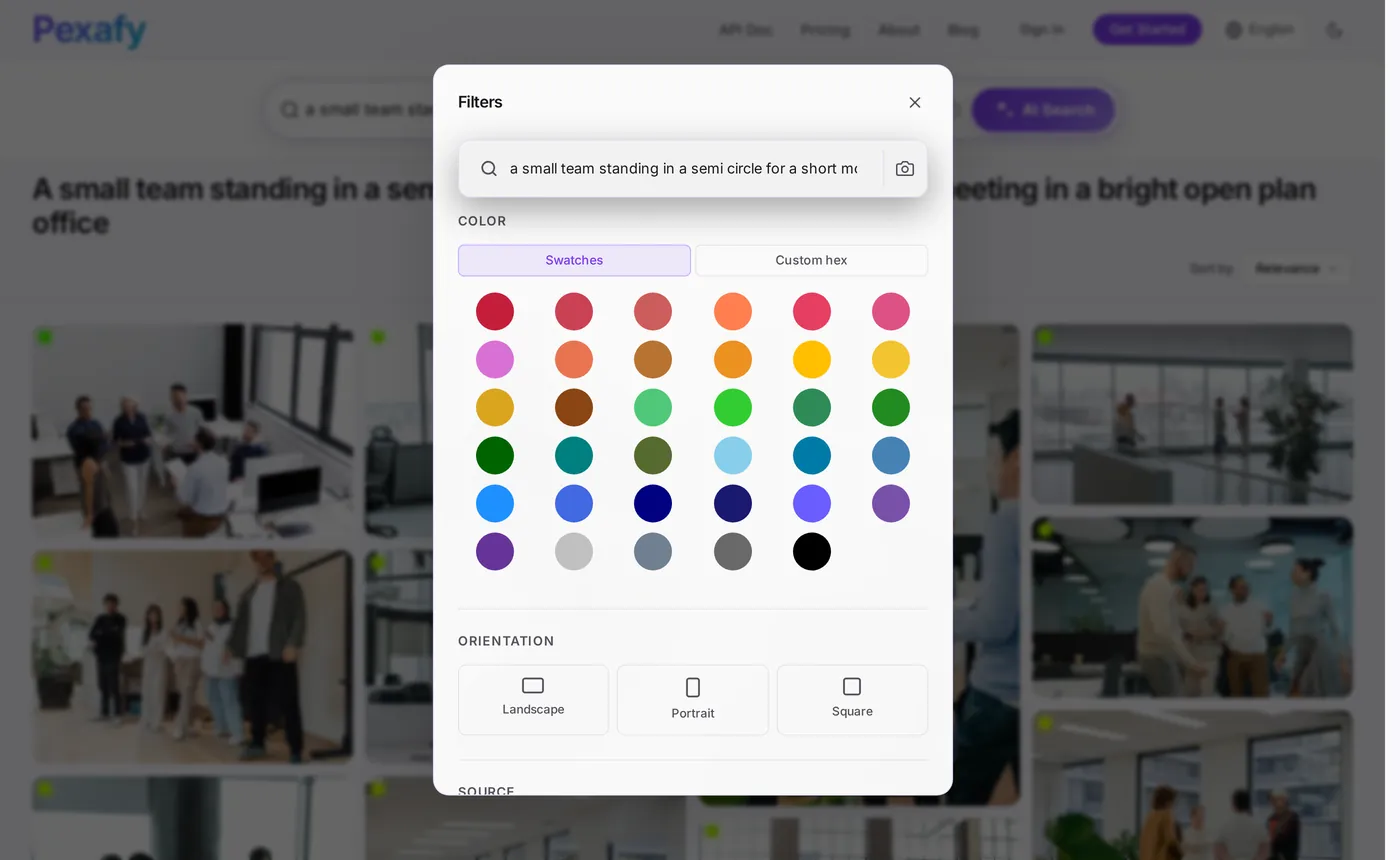
- Écrivez la phrase, pas le mot-clé. Sujet + action + lieu + lumière. Jusqu'à 500 caractères, dans plus de 100 langues.
- Filtrez sur paysage pour l'image principale, puis relancez sans le filtre pour les images à l'intérieur de l'article, où le portrait se lit souvent mieux.
- Ouvrez la photo pour obtenir la ligne d'attribution toute prête, la page source d'origine et le fichier en pleine résolution.
- Utilisez « photos similaires » sur celle que vous avez choisie pour illustrer la section suivante dans le même registre visuel — même lumière, même traitement, scène différente.
Le prompt : transformer un brouillon en phrase de recherche
C'est l'étape que tout le monde rate quand on automatise. On introduit le titre de l'article directement dans le champ de recherche, et le titre est précisément la mauvaise entrée : il est abstrait (« Le coût caché du changement de contexte ») et aucune photographie au monde ne le représente. Ce que vous voulez du modèle n'est pas un résumé — c'est un brief de prise de vue.
# system prompt
You are a photo editor. Read the article and write ONE search sentence
for a stock-photo engine that ranks by meaning, not by keywords.

Rules:
1. Describe a scene a camera could have taken: someone doing
   something, somewhere. Never name the topic itself ("fintech",
   "productivity", "SEO") — name what would be in the frame.
2. 12 to 25 words. Longer beats shorter: every concrete detail
   (light, place, gesture, time of day) sharpens the match.
3. No text, logos, brands, charts, screenshots or famous people.
   Free photo libraries have almost none of those.
4. No invisible metaphors ("growth", "synergy", "transformation").
5. Match the mood of the article: calm, tense, tired, celebratory.
6. Write the sentence in English even if the article is not.

Return JSON only:
{ "query": "…", "orientation": "landscape", "alt": "…" }
La règle 1 fait l'essentiel du travail. Voici cette même règle appliquée à trois brouillons réels — la colonne du milieu est ce qu'une personne tape quand elle est pressée, la colonne de droite est ce que le prompt renvoie :
| L'article parle de… | La requête faite à la hâte | Le brief de prise de vue |
|---|---|---|
| Pourquoi votre stand-up quotidien ne fonctionne pas | team meeting |
« a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office » |
| Réduire l'intégration de 6 semaines à 9 jours | onboarding |
« a new employee on their first day at a desk, listening while a colleague leans in and points at their screen » |
| Le coût caché du changement de contexte | productivity |
« a tired developer rubbing their eyes in front of two monitors late in the evening, the office empty behind them » |
team meeting renvoie le stock générique de salle de conférence que tout le monde sur votre sujet
utilise déjà. La phrase de la troisième colonne renvoie ceci, en 155 millisecondes :

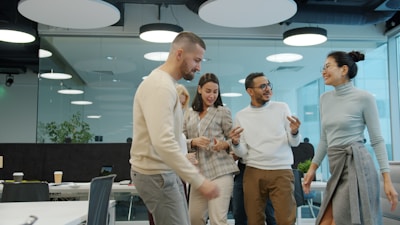
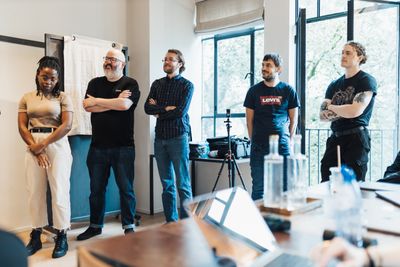
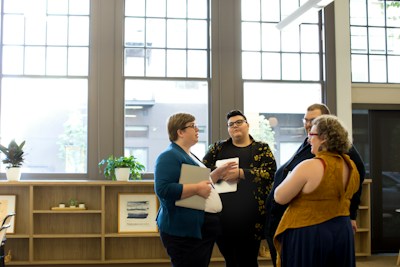
team meeting ne garantit jamais.
Le pipeline : brouillon en entrée, image principale créditée en sortie
Quarante lignes, deux appels : un au modèle pour le brief, un à Pexafy pour la photo. Placez-le dans le hook de sauvegarde de votre CMS, votre build de site statique, ou un script qui parcourt un dossier de fichiers Markdown.
import json, os, requests
from anthropic import Anthropic

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
llm = Anthropic()  # ANTHROPIC_API_KEY provenant de l'environnement

def camera_brief(article: str) -> dict:
    # PHOTO_EDITOR = le system prompt ci-dessus
    msg = llm.messages.create(
        model="claude-sonnet-5",
        max_tokens=300,
        system=PHOTO_EDITOR,
        messages=[{ "role": "user", "content": article[:12000] }],
    )
    return json.loads(msg.content[0].text)

def illustrate(article: str) -> dict | None:
    brief = camera_brief(article)
    r = requests.get(
        SEARCH,
        headers={"X-Api-Key": os.environ["PEXAFY_API_KEY"]},
        params={
            "q": brief["query"],           # la phrase complète
            "orientation": brief["orientation"],
            "per_page": 8,
            "score_threshold": 0.55,      # écarte les correspondances faibles
        },
        timeout=10,
    )
    hits = r.json()["data"]
    if not hits:                        # brief trop restreint → élargir, réessayer
        return None

    top = hits[0]
    return {
        "src":    top["urls"]["regular"],        # 1080px — taille image principale
        "alt":    brief["alt"] or top["alt_description"],
        "credit": top["attribution"]["html"],   # prêt à afficher
        "width":  top["width"],
        "height": top["height"],
        "id":     top["photo_id"],           # à stocker : évite les répétitions
    }
Trois détails qui transforment une démo en quelque chose que vous pouvez laisser tourner :
score_threshold— ne rien renvoyer vaut mieux que renvoyer une mauvaise photo. Si le brief était trop spécifique, élargissez-le (supprimez la dernière clause) et réessayez une fois.- Stockez le
photo_id— une ligne dans votre base de données, et jamais deux articles de votre site ne partagent d'image principale. C'est l'échec que tout le monde rencontre au trentième article. - Une requête par emplacement d'image — une image principale plus trois images de section, c'est quatre requêtes par article, ou une seule si vous prenez quatre résultats différents de la même recherche.
Pas de Python ? Toute la partie recherche tient en une ligne, et chaque résultat porte les mêmes champs quelle que soit la bibliothèque d'origine :
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a tired developer rubbing their eyes at two monitors" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "per_page=6"

# → { "success": true, "data": [ … ], "meta": { "took_ms": 147 } }
La forme de la réponse — urls, width, photographer_full_name,
source, license_type, relevance_score,
attribution — est identique pour une photo Pexels, une photo Pixabay et une photo Unsplash.
Cette normalisation est la partie que vous devriez sinon écrire et maintenir vous-même ; nous l'avons
démontée champ par champ dans
le comparatif des API de photos libres de droits.
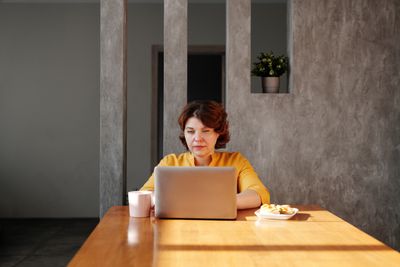
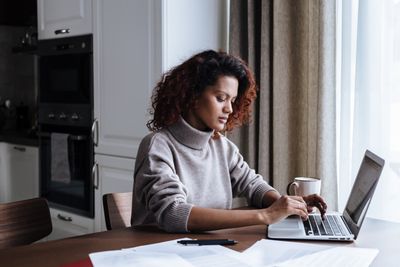
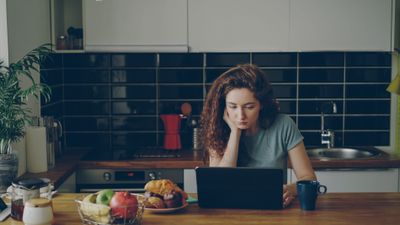
Deuxième section, deuxième brief, deuxième recherche — l'idée étant qu'un seul article produit plusieurs scènes distinctes au lieu d'une seule photo étirée quatre fois :
Laisser l'agent choisir l'image : MCP
Si un modèle rédige ou modifie déjà le brouillon, le pipeline le plus propre, c'est l'absence de pipeline : donnez à l'agent l'outil de recherche et laissez-le illustrer ce qu'il vient d'écrire, dans la même conversation, tant qu'il a encore le contexte en tête.
Pexafy exploite un serveur Model Context Protocol hébergé à l'adresse
mcp.pexafy.com/mcp. Trois outils :
search_photos (une phrase),
search_photos_by_image (une image de référence, éventuellement accompagnée d'une phrase — « comme
ceci, mais au coucher du soleil »), et get_similar_photos (davantage de photos comme celle déjà choisie, ce qui
permet de garder une série cohérente).
Settings → Connectors → Add custom connector
Name: Pexafy
URL:  https://mcp.pexafy.com/mcp
# puis connectez-vous avec votre compte Pexafy quand la fenêtre s'ouvre
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# ou versionnez-le dans le dépôt, pour que toute l'équipe en profite — .mcp.json
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
À partir de là, illustrer un article se résume à une phrase, pas à une tâche. L'agent rédige son propre brief de prise de vue — il vient de lire le brouillon, il est donc mieux placé que quiconque pour décrire la scène :
You  Here's the draft of this week's post. Find a landscape hero
     and one photo for section 2, and give me the credit lines.

Claude  → search_photos(
       q="a small team standing in a semi circle for a short morning
          stand-up meeting in a bright open plan office",
       orientation="landscape")
     ← 16 photos · 155 ms

     Hero    → Photo by Thirdman on Pexels · 6453×4302 · score 0.80
     Section → Photo by Marcus Aurelius on Pexels · 6000×4000
     Both licence-free, attribution lines below, ready to paste.
Unsplash, Pexels, Pixabay et Openverse n'ont pas de serveur MCP officiel — ce qui existe, ce sont des wrappers communautaires que vous hébergez et pour lesquels vous devez gérer vous-même les clés. Si votre flux de travail éditorial passe déjà par un agent, cette différence est l'intégration.
Texte alternatif, licence et vitesse de la page
L'image est choisie. Quatre choses décident si elle aide la page ou la pénalise discrètement :
-
Rédigez le texte alternatif pour une personne, pas pour un robot d'indexation. Chaque résultat fournit un
alt_description— utilisez-le comme brouillon, puis réécrivez-le dans le contexte de votre paragraphe. « Quatre collègues debout lors d'une réunion matinale » vaut mieux qu'une salade de mots-clés, et c'est le texte qu'un lecteur d'écran lira réellement. Restez sous ~125 caractères ; ne le laissez vide (alt="") que si l'image est purement décorative. -
Affichez le crédit même si rien ne vous y oblige. L'attribution n'est pas exigée
par les conditions d'utilisation de l'API Pexafy, et chaque résultat fournit une chaîne
attribution.htmlprête à l'emploi — mais la licence attachée par la bibliothèque d'origine régit toujours votre utilisation de cette photo, et une ligne de crédit visible indique au lecteur (et à un moteur de réponse) qu'il s'agit d'une véritable photographie avec un véritable auteur. -
Servez la bonne taille.
urls.regular(1080 px) convient pour une image principale ;urls.fullest un fichier de 2400 px dont aucun article n'a besoin. Renseignez toujourswidth/heightà partir de la réponse pour que le navigateur réserve l'espace — cette simple paire d'attributs fait la différence entre un bon et un mauvais score de décalage de mise en page. Utilisezfetchpriority="high"sur l'image principale,loading="lazy"sur tout ce qui est sous la ligne de flottaison. -
Alimentez vos métadonnées avec l'image principale. La même URL devrait être votre
og:image, votretwitter:imageet la propriétéimagede vos données structuréesArticle. Une photo, trois emplacements, aucun travail supplémentaire — et un aperçu social qui ne retombe plus sur votre logo.
Ce que 100 articles par mois coûtent réellement
Prenons l'hypothèse d'une image principale plus trois images dans l'article, soit quatre requêtes de recherche par article — la version délibérément la plus coûteuse, où vous lancez une requête distincte par emplacement au lieu de réutiliser les résultats d'une seule :
| Volume | Requêtes de recherche / mois | Forfait | Coût de recherche |
|---|---|---|---|
| 20 articles | 80 | Gratuit — 5 000 req/mois | 0 $ |
| 100 articles | 400 | Gratuit — 5 000 req/mois | 0 $ |
| 1 000 articlesune agence, ou tout un portefeuille de clients | 4 000 | Gratuit — encore sous la limite de 5 000 req/mois | 0 $ |
Oui — le quota mensuel n'est pas un problème aux volumes du content marketing, et nous préférons le dire
plutôt que d'inventer une raison de vous faire payer. La limite que vous rencontrerez réellement est celle
par minute. Le forfait gratuit autorise 20 requêtes API par minute ; un script de build qui réillustre
100 articles en une seule passe déclenche 400 requêtes aussi vite que votre boucle le permet, donc il passe soit
vingt minutes à être limité, soit commence à recevoir des 429. Deux solutions : espacer
les appels (un sleep dans la boucle, et une tâche nocturne ne s'en rend jamais compte), ou passer à un forfait
dont la limite de débit correspond à votre build — Starter est à 30 requêtes/minute, Pro à 60. Choisissez selon la
rafale, pas selon le volume.
Le seul autre poste de coût est un court appel de modèle par article pour produire le brief — quelques centaines de jetons en entrée, trente en sortie, ce qui sera l'élément le moins cher de tout pipeline de contenu que vous possédez. Comparez cela avec la génération de quatre images par article, à quatre cents images par mois, plus les tentatives qui n'ont pas été retenues.
Et la partie qui n'apparaît dans aucun tableau de coûts : l'éditeur cesse d'ouvrir cinq onglets. C'est ça, la véritable économie.
Références et notes de bas de page
1 AI Act de l'UE, article 50 — obligations de transparence pour les fournisseurs et déployeurs de certains systèmes d'IA, applicables à partir du 2 août 2026. Les fournisseurs de systèmes générant de l'audio, des images, des vidéos ou du texte synthétiques doivent marquer les sorties dans un format lisible par machine et les rendre détectables comme générées artificiellement ; les déployeurs doivent divulguer les deepfakes et, dans des cas définis, les textes générés par IA publiés pour informer le public. L'Omnibus numérique (règlement (UE) 2026/1744, en vigueur depuis le 27 juillet 2026) laisse l'article 50 lui-même inchangé, mais accorde aux systèmes déjà présents sur le marché avant le 2 août 2026 jusqu'au 2 décembre 2026 pour se conformer à l'exigence de marquage lisible par machine de l'article 50(2). Tout ceci lie les fournisseurs et déployeurs d'IA — ce n'est pas une règle sur les images qu'un blog peut publier.
2 Google lit les Content Credentials C2PA et son propre filigrane SynthID pour afficher la provenance dans À propos de cette image sur Search, Images et Lens. Il s'agit de provenance des médias, pas d'une pénalité de classement sur le contenu généré par IA.
Sources vérifiées le 15 août 2026 : AI Act, article 50 · Commission européenne — FAQ sur la transparence · Google — métadonnées d'image · Documentation API & MCP de Pexafy. Les temps de recherche et les résultats sont des réponses réelles de l'API publique, capturées le même jour.
Foire aux questions
Faut-il utiliser des images générées par IA ou de vraies photos pour les articles de blog ?
Comment trouver automatiquement une image qui correspond à mon article ?
GET /api/v1/search/photos?q=…, environ 150 ms, et chaque résultat revient avec sa taille, sa licence et une chaîne d'attribution prête à l'emploi.Quel est le meilleur prompt pour transformer un article en requête de recherche d'image ?
Dois-je créditer les photos que j'utilise dans mes articles de blog ?
Claude ou un autre agent IA peut-il trouver les photos de mon article ?
mcp.pexafy.com/mcp. Ajoutez-le comme connecteur personnalisé dans Claude.ai ou Claude Desktop et connectez-vous via OAuth, ou ajoutez-le à Claude Code avec une seule commande claude mcp add et une clé API. L'agent recherche alors par phrase, par image de référence ou pour des photos similaires, tout en gardant votre brouillon dans son contexte.Comment éviter que tous les articles de mon blog utilisent la même photo ?
photo_id de chaque image publiée et excluez-le lors de l'exécution suivante — une simple colonne dans votre CMS. C'est le mode de défaillance que rencontre tout pipeline automatisé aux alentours du trentième article, et il reste invisible jusqu'à ce que quelqu'un fasse défiler l'index de votre blog. Rédiger un nouveau brief caméra par section, plutôt que de réutiliser le titre de l'article, fait le reste.

