Cách minh họa mọi bài viết bạn xuất bản — bằng ảnh thật, ở quy mô lớn
Vì sao các đội ngũ xuất bản đang quay lại với nhiếp ảnh thật, và quy trình chính xác — kèm prompt — biến một bản thảo hoàn chỉnh thành một ảnh đại diện có ghi công chỉ trong khoảng 150 mili giây.
 Marouane Tijani
10 phút đọc

Mỗi bài viết bạn xuất bản đều cần một bức ảnh. Đây không phải là thứ có thì tốt — ảnh đại diện chính là thứ hiển thị trong bản xem trước trên mạng xã hội, là thứ độc giả nhìn thấy trước cả câu đầu tiên, và là thứ cho họ biết chỉ trong nửa giây rằng trang này được thực hiện bởi ai đó thực sự quan tâm. Nhân con số đó lên bốn ảnh mỗi bài và bốn mươi bài mỗi quý, và "tìm một tấm ảnh" không còn là một tác vụ nữa mà trở thành một vấn đề về quy trình xử lý hàng loạt.
Đây là cách chúng tôi giải quyết vấn đề đó: nên dùng gì thay cho ảnh do AI tạo ra và vì sao, cùng ba cách để tích hợp Pexafy vào quy trình làm việc — thủ công, qua API, hoặc thông qua một agent AI — bao gồm cả lời nhắc biến một bản nháp hoàn chỉnh thành một câu tìm kiếm thực sự tìm ra được kết quả.
Vì sao ảnh thật vẫn vượt trội hơn ảnh do AI tạo ra
Tạo ra một hình minh họa thì dễ, và chính điều đó là vấn đề. Có bốn điều đã thay đổi giữa thời điểm "ảnh AI là một mẹo ăn gian" và hiện tại:
1 · Ở quy mô lớn, tìm kiếm nhanh hơn tạo sinh
Một lần tạo sinh là một lời nhắc, một khoảng chờ, một lần kiểm tra, và — nói thật — thêm hai ba lần thử nữa trước khi có được một tấm dùng được. Một lượt tìm kiếm ngữ nghĩa chỉ là một yêu cầu duy nhất, trả về mười sáu ứng viên trong khoảng 150 mili-giây, mỗi ảnh đã có sẵn giấy phép, đã được ghi công, đã có kích thước, với chiều rộng chiều cao ngay trong phản hồi. Với một tấm ảnh, sự khác biệt chỉ bằng một tách cà phê. Với bốn trăm tấm ảnh mỗi quý, đó là sự khác biệt giữa một quy trình làm việc và một công việc thực sự.
2 · Một bức ảnh thì chính xác; một bản tạo sinh thì chỉ có vẻ hợp lý
Ngay khi bài viết của bạn nói về một thứ có thật — một nghề nghiệp, một thiết bị, một thành phố, một cử chỉ, một chất liệu — ảnh do AI tạo ra có thể đúng về không khí nhưng sai ở chi tiết. Bàn tay sáu ngón là phiên bản gây cười; phiên bản đắt giá hơn là một dụng cụ phẫu thuật không hề tồn tại, một buồng lái với các nút điều khiển tưởng tượng, hoặc một "con phố ở Lisbon" mà không ai từng ở Lisbon nhận ra. Độc giả am hiểu chủ đề của bạn sẽ nhận ra điều đó, và họ nhận ra bức ảnh trước tiên.
3 · Ai cũng có cùng một phong cách
Các mô hình khuếch tán (diffusion) hội tụ về một phong cách chung, và một loạt hình minh họa với gradient mềm, ánh sáng quá gắt, đối xứng đến khả nghi giờ đây bị coi là ảnh lấp chỗ trống. Cảm nhận đó chính là cái giá thực sự phải trả: không phải một hình phạt, mà là một tín hiệu. Một bức ảnh thật — có hạt nhiễu, một chiếc ghế hơi vụng về, ai đó đang nói giữa chừng — lại được cảm nhận như một phóng sự thực tế.
4 · Và giờ đây chúng đi kèm với một nhãn
Điều này mang tính bối cảnh hơn là một luận điểm, nhưng đó là chiều hướng đang diễn ra. Kể từ 2 tháng 8 năm 2026, Điều 50 của EU AI Act yêu cầu các nhà cung cấp hệ thống tạo sinh phải đánh dấu các kết quả tổng hợp theo định dạng máy có thể đọc được, và các bên triển khai phải công bố các deepfake.1 Về phía phát hiện, Google đọc C2PA Content Credentials và watermark SynthID của riêng mình để trả lời câu hỏi "đây có phải là ảnh do AI tạo ra không?" bên trong Search, Images và Lens.2 Không có gì trong đó là một quy tắc về việc một blog được phép xuất bản những ảnh nào, và không có gì trong đó khiến bạn tụt hạng tìm kiếm. Điều đã thay đổi nằm ở phía sau: nguồn gốc của bức ảnh ở đầu bài viết của bạn giờ đây là thứ mà độc giả có thể kiểm tra chỉ trong hai cú nhấp chuột, mà không cần hỏi bạn. Một bức ảnh có giấy phép hợp lệ thì không có gì phải khai báo cả.
Khi nào ảnh do AI tạo ra là lựa chọn đúng đắn. Sơ đồ khái niệm và bản vẽ kỹ thuật. Một cảnh không thể chụp được (một sản phẩm chưa tồn tại, một cơ chế trừu tượng, một thành phố tương lai). Một phong cách minh họa riêng của bạn mà bạn muốn lặp lại trên mọi bài viết. Và bất cứ thứ gì mà bức ảnh được hiểu một cách có chủ đích là minh họa chứ không phải bằng chứng. Hãy dùng cả hai — chỉ cần ngừng dùng ảnh tạo sinh làm mặc định cho những trường hợp kiểu "tôi cần một tấm ảnh về người đang họp".
Ba cách để minh họa, tùy theo khối lượng công việc của bạn
Cùng một công cụ, cùng một kho ảnh — 9M+ ảnh miễn phí sử dụng từ 9 thư viện — và ba điểm truy cập. Hãy chọn dựa trên số bài viết bạn xuất bản, không phải dựa trên mức độ am hiểu kỹ thuật của bạn.
| Điểm truy cập | Phù hợp nhất choai và với khối lượng bao nhiêu | Mỗi bài viết | Bạn cần gì |
|---|---|---|---|
| Giao diện tìm kiếm | Biên tập viên, mỗi lần một bài viết — lên đến ~20/tháng | ~30 giây | Một trình duyệt. Không cần tài khoản để tìm kiếm. |
| REST API | Một CMS, một quy trình build cho trang tĩnh, một lô bản nháp | ~1 yêu cầu, ~150 ms | Một API key. 5.000 yêu cầu/tháng miễn phí, 20/phút. |
| Máy chủ MCP | Agent AI đang viết hoặc chỉnh sửa bản nháp | Trong cùng một cuộc hội thoại | Một URL kết nối, OAuth hoặc một key. |
Cả ba cách đều dùng chung một kho ảnh và một hệ thống xếp hạng, nên một tấm ảnh mà biên tập viên tìm thấy trên giao diện chính là tấm ảnh đó, với cùng một mã định danh, mà API trả về cho script build của bạn.
Một bài viết, 30 giây: giao diện tìm kiếm
Hãy mô tả cảnh giống như cách bạn mô tả nó cho một nhiếp ảnh gia, thành một câu hoàn chỉnh, bằng ngôn ngữ của bạn. Không phải team meeting — mà là "a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office". Mỗi chi tiết cụ thể thêm vào sẽ thu hẹp tập kết quả thay vì làm nó trống rỗng, bởi vì công cụ này xếp hạng theo ý nghĩa chứ không phải bằng cách khớp từ ngữ của bạn với thẻ gắn (tags) của ai đó.
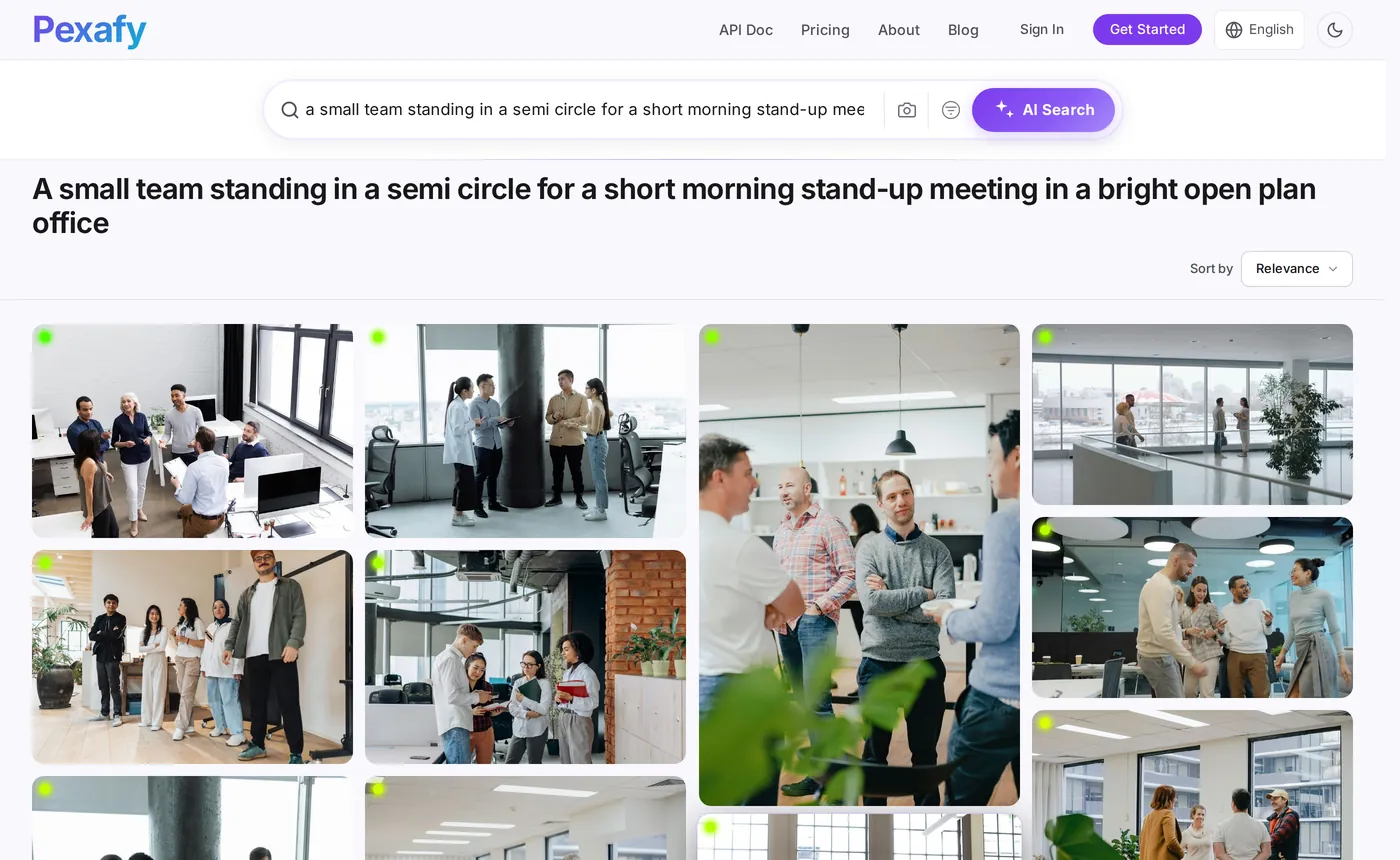
Sau đó, thu hẹp kết quả bằng những bộ lọc quan trọng cho bố cục bài viết — và chỉ những bộ lọc đó thôi:
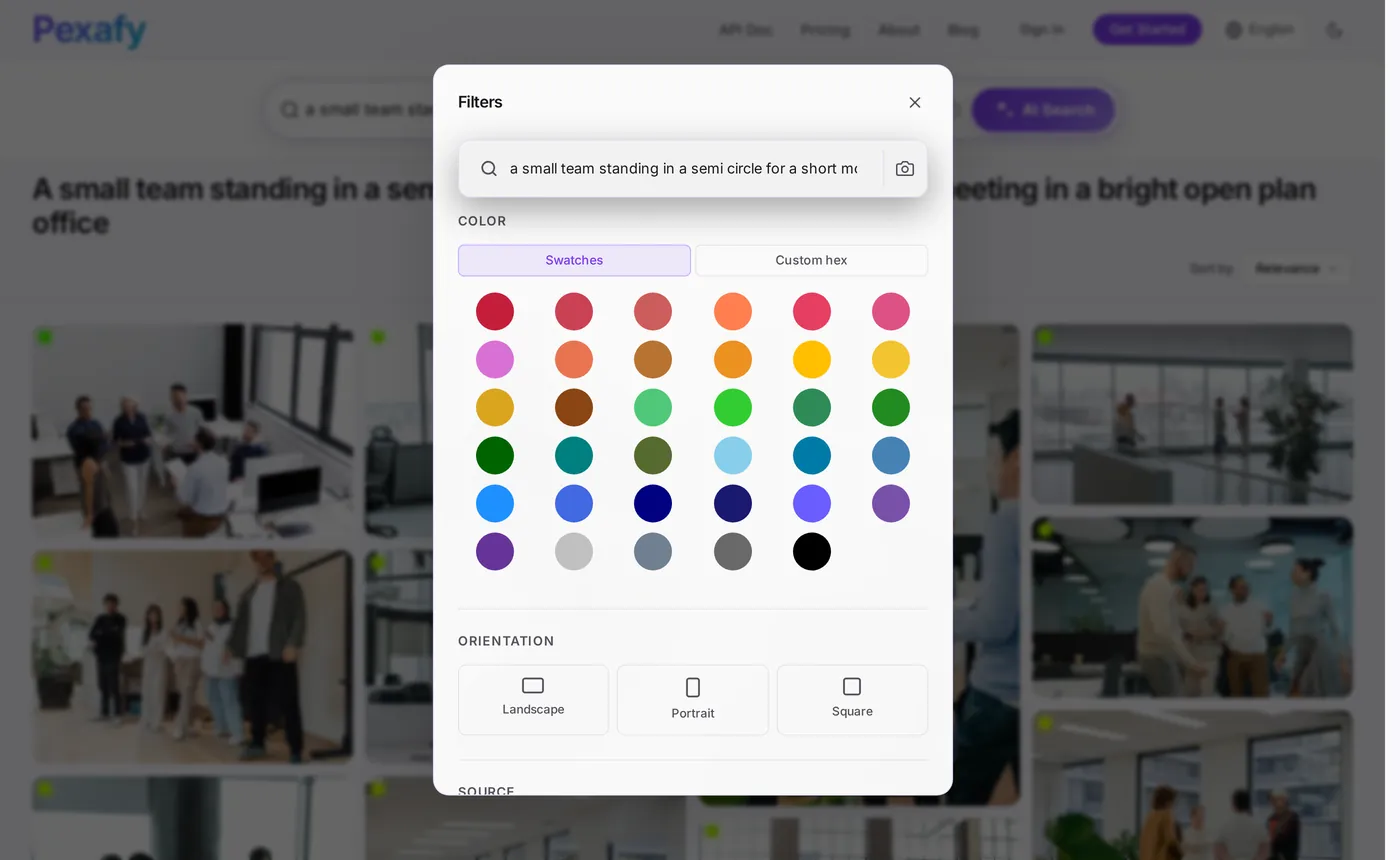
- Viết thành câu, đừng viết thành từ khóa. Chủ thể + hành động + địa điểm + ánh sáng. Tối đa 500 ký tự, bằng bất kỳ ngôn ngữ nào trong hơn 100 ngôn ngữ.
- Lọc theo hướng ngang cho ảnh đại diện, sau đó chạy lại không dùng bộ lọc cho các ảnh trong bài, nơi ảnh dọc thường trông đẹp hơn.
- Mở bức ảnh để lấy dòng ghi công có sẵn, trang nguồn gốc và tệp có độ phân giải đầy đủ.
- Dùng "ảnh tương tự" trên bức ảnh bạn đã chọn để minh họa cho phần tiếp theo theo cùng một sắc thái hình ảnh — cùng ánh sáng, cùng cách xử lý, khác cảnh.
Lời nhắc: biến bản nháp thành câu tìm kiếm
Đây chính là bước mà ai cũng làm sai khi tự động hóa. Họ đưa thẳng tiêu đề bài viết vào ô tìm kiếm, và tiêu đề chính là đầu vào sai lầm nhất: nó trừu tượng ("The hidden cost of context switching") và không có bức ảnh nào trên đời mô tả được nó. Điều bạn cần từ mô hình không phải là một bản tóm tắt — mà là một đề cương chụp ảnh (camera brief).
# system prompt
You are a photo editor. Read the article and write ONE search sentence
for a stock-photo engine that ranks by meaning, not by keywords.

Rules:
1. Describe a scene a camera could have taken: someone doing
   something, somewhere. Never name the topic itself ("fintech",
   "productivity", "SEO") — name what would be in the frame.
2. 12 to 25 words. Longer beats shorter: every concrete detail
   (light, place, gesture, time of day) sharpens the match.
3. No text, logos, brands, charts, screenshots or famous people.
   Free photo libraries have almost none of those.
4. No invisible metaphors ("growth", "synergy", "transformation").
5. Match the mood of the article: calm, tense, tired, celebratory.
6. Write the sentence in English even if the article is not.

Return JSON only:
{ "query": "…", "orientation": "landscape", "alt": "…" }
Quy tắc số 1 làm hầu hết công việc. Đây là cùng một quy tắc áp dụng trên ba bản nháp có thật — cột giữa là những gì một con người gõ vội, cột bên phải là những gì lời nhắc trả về:
| Bài viết nói về… | Truy vấn viết vội | Đề cương chụp ảnh |
|---|---|---|
| Vì sao buổi họp đứng hằng ngày của bạn bị hỏng | team meeting |
"a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office" |
| Rút ngắn quá trình onboarding từ 6 tuần xuống 9 ngày | onboarding |
"a new employee on their first day at a desk, listening while a colleague leans in and points at their screen" |
| Cái giá ẩn giấu của việc chuyển đổi ngữ cảnh liên tục | productivity |
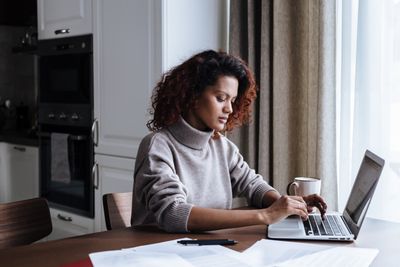
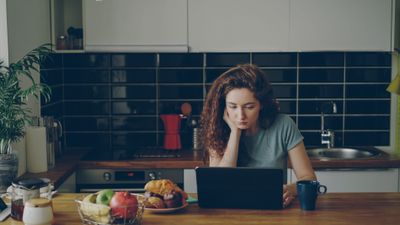
"a tired developer rubbing their eyes in front of two monitors late in the evening, the office empty behind them" |
team meeting trả về đúng loại ảnh phòng họp chung chung mà mọi người khác viết cùng chủ đề với bạn cũng đang dùng. Câu ở cột thứ ba trả về kết quả này, trong 155 mili-giây:
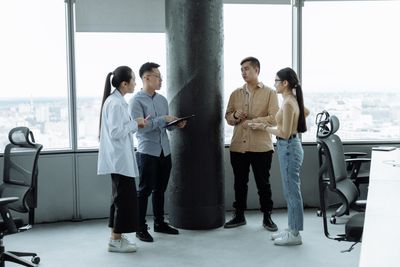

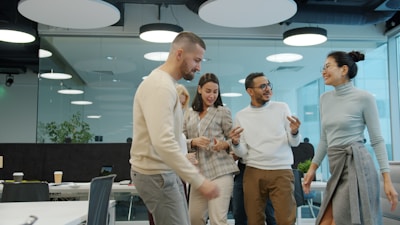
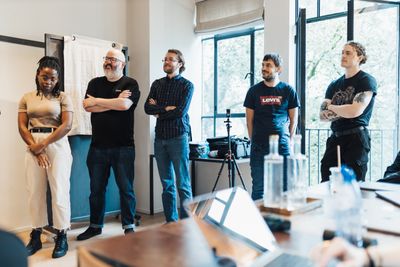
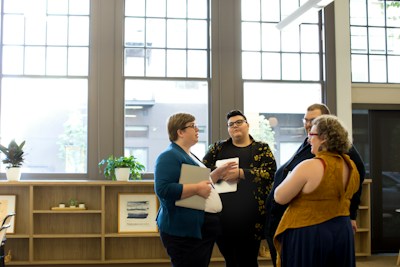
team meeting không bao giờ đảm bảo được.
Quy trình xử lý: đưa bản nháp vào, nhận ảnh đại diện có ghi công ra
Bốn mươi dòng lệnh, hai lượt gọi: một lượt gọi mô hình để lấy đề cương, một lượt gọi Pexafy để lấy ảnh. Đặt nó vào hook lưu bài của CMS, quy trình build trang tĩnh, hoặc một script duyệt qua một thư mục các tệp Markdown.
import json, os, requests
from anthropic import Anthropic

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
llm = Anthropic()  # ANTHROPIC_API_KEY lấy từ biến môi trường

def camera_brief(article: str) -> dict:
    # PHOTO_EDITOR = lời nhắc hệ thống ở trên
    msg = llm.messages.create(
        model="claude-sonnet-5",
        max_tokens=300,
        system=PHOTO_EDITOR,
        messages=[{ "role": "user", "content": article[:12000] }],
    )
    return json.loads(msg.content[0].text)

def illustrate(article: str) -> dict | None:
    brief = camera_brief(article)
    r = requests.get(
        SEARCH,
        headers={"X-Api-Key": os.environ["PEXAFY_API_KEY"]},
        params={
            "q": brief["query"],           # câu đầy đủ
            "orientation": brief["orientation"],
            "per_page": 8,
            "score_threshold": 0.55,      # loại bỏ kết quả khớp yếu
        },
        timeout=10,
    )
    hits = r.json()["data"]
    if not hits:                        # đề cương quá hẹp → nới rộng, thử lại
        return None

    top = hits[0]
    return {
        "src":    top["urls"]["regular"],        # 1080px — kích thước ảnh đại diện
        "alt":    brief["alt"] or top["alt_description"],
        "credit": top["attribution"]["html"],   # sẵn sàng để hiển thị
        "width":  top["width"],
        "height": top["height"],
        "id":     top["photo_id"],           # lưu lại: tránh trùng lặp
    }
Ba chi tiết biến một bản demo thành thứ bạn có thể để chạy liên tục:
score_threshold— không trả về gì còn tốt hơn là trả về một tấm ảnh tệ. Nếu đề cương quá cụ thể, hãy nới rộng nó ra (bỏ mệnh đề cuối cùng) và thử lại một lần.- Lưu lại
photo_id— chỉ một dòng trong cơ sở dữ liệu của bạn, và không có hai bài viết nào trên trang của bạn từng dùng chung một ảnh đại diện. Đây là lỗi mà ai cũng gặp phải ở bài viết thứ ba mươi. - Một yêu cầu cho mỗi vị trí ảnh — một ảnh đại diện cộng ba ảnh trong bài là bốn yêu cầu cho mỗi bài viết, hoặc chỉ một nếu bạn lấy bốn kết quả khác nhau từ cùng một lượt tìm kiếm.
Không dùng Python? Toàn bộ phần tìm kiếm chỉ gói gọn trong một dòng lệnh, và mỗi kết quả đều mang cùng các trường dữ liệu bất kể đến từ thư viện nào:
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a tired developer rubbing their eyes at two monitors" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "per_page=6"

# → { "success": true, "data": [ … ], "meta": { "took_ms": 147 } }
Cấu trúc phản hồi — urls, width, photographer_full_name,
source, license_type, relevance_score,
attribution — hoàn toàn giống nhau cho một ảnh từ Pexels, một ảnh từ Pixabay và một ảnh từ Unsplash. Việc chuẩn hóa đó là phần mà lẽ ra bạn phải tự viết và bảo trì; chúng tôi đã mổ xẻ nó từng trường một trong
bài so sánh các API ảnh miễn phí.
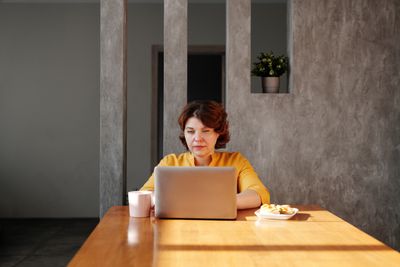
Phần thứ hai, đề cương thứ hai, lượt tìm kiếm thứ hai — ý là một bài viết cho ra nhiều cảnh khác biệt thay vì một tấm ảnh bị kéo giãn dùng bốn lần:
Để agent tự chọn ảnh: MCP
Nếu một mô hình đã đang viết hoặc chỉnh sửa bản nháp, quy trình gọn gàng nhất là không cần quy trình nào cả: hãy đưa cho agent công cụ tìm kiếm và để nó tự minh họa những gì nó vừa viết, trong cùng một cuộc hội thoại, khi nó vẫn còn nắm được ngữ cảnh.
Pexafy vận hành một máy chủ Model Context Protocol được lưu trữ sẵn tại
mcp.pexafy.com/mcp. Ba công cụ:
search_photos (một câu),
search_photos_by_image (một ảnh tham chiếu, tùy chọn kèm thêm một câu — "giống thế này, nhưng vào lúc hoàng hôn"), và get_similar_photos (nhiều ảnh giống với ảnh bạn đã chọn, đây là cách giữ cho một chuỗi bài viết đồng nhất).
Settings → Connectors → Add custom connector
Name: Pexafy
URL:  https://mcp.pexafy.com/mcp
# sau đó đăng nhập bằng tài khoản Pexafy của bạn khi cửa sổ mở ra
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# hoặc commit vào repo, để cả nhóm cùng dùng được — .mcp.json
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
Từ đó, minh họa cho một bài viết chỉ là một câu nói, không phải một tác vụ. Agent tự viết đề cương chụp ảnh của riêng nó — nó vừa đọc xong bản nháp, nên nó có vị trí tốt hơn bất kỳ ai để mô tả cảnh:
You  Here's the draft of this week's post. Find a landscape hero
     and one photo for section 2, and give me the credit lines.

Claude  → search_photos(
       q="a small team standing in a semi circle for a short morning
          stand-up meeting in a bright open plan office",
       orientation="landscape")
     ← 16 photos · 155 ms

     Hero    → Photo by Thirdman on Pexels · 6453×4302 · score 0.80
     Section → Photo by Marcus Aurelius on Pexels · 6000×4000
     Both licence-free, attribution lines below, ready to paste.
Unsplash, Pexels, Pixabay và Openverse không có máy chủ MCP chính thức — thứ tồn tại là các wrapper do cộng đồng làm ra mà bạn phải tự lưu trữ và tự cấu hình key. Nếu quy trình biên tập của bạn đã vận hành qua một agent, sự khác biệt đó chính là phần tích hợp quan trọng.
Văn bản thay thế (alt text), giấy phép và tốc độ trang
Bức ảnh đã được chọn. Có bốn điều quyết định liệu nó có giúp ích cho trang hay âm thầm gây hại:
-
Viết văn bản alt cho một con người, không phải cho một trình thu thập dữ liệu. Mỗi kết quả đều đi kèm một
alt_description— hãy dùng nó làm bản nháp, sau đó viết lại trong ngữ cảnh của đoạn văn của bạn. "Bốn đồng nghiệp đứng trong một buổi họp buổi sáng" tốt hơn nhiều so với một mớ từ khóa lộn xộn, và đó cũng là văn bản mà trình đọc màn hình sẽ thực sự đọc lên. Giữ dưới khoảng 125 ký tự; chỉ để trống (alt="") nếu ảnh hoàn toàn mang tính trang trí. -
Ghi công ngay cả khi không có gì bắt buộc bạn phải làm vậy. Việc ghi công không phải là yêu cầu bắt buộc theo điều khoản API của Pexafy và mỗi kết quả đều mang sẵn chuỗi
attribution.htmlđã dựng sẵn — nhưng giấy phép gắn với thư viện gốc vẫn chi phối việc bạn sử dụng bức ảnh đó, và một dòng ghi công hiển thị là thứ cho độc giả (và cho một công cụ trả lời) biết đây là một bức ảnh thật với một tác giả thật. -
Phục vụ đúng kích thước.
urls.regular(1080 px) là dành cho ảnh đại diện;urls.fulllà một tệp 2400 px mà không bài viết nào cần đến. Luôn xuấtwidth/heighttừ phản hồi để trình duyệt có thể dự trù không gian trước — riêng cặp thuộc tính đó là sự khác biệt giữa một điểm layout-shift tốt và một điểm tệ. Dùngfetchpriority="high"cho ảnh đại diện,loading="lazy"cho mọi thứ nằm bên dưới màn hình đầu tiên. -
Đưa ảnh đại diện vào phần metadata của bạn. Cùng một URL nên là
og:imagecủa bạn,twitter:imagecủa bạn và thuộc tínhimagetrong dữ liệu có cấu trúcArticlecủa bạn. Một bức ảnh, ba nơi, không tốn thêm công sức — và một bản xem trước trên mạng xã hội không còn phải quay về dùng logo của bạn nữa.
100 bài viết một tháng thực sự tốn bao nhiêu
Giả sử một ảnh đại diện cộng ba ảnh trong bài, tức bốn yêu cầu tìm kiếm cho mỗi bài viết — phiên bản cố tình lãng phí nhất, trong đó bạn chạy một truy vấn riêng cho mỗi vị trí thay vì tái sử dụng kết quả từ một lượt tìm kiếm:
| Khối lượng | Yêu cầu tìm kiếm / tháng | Gói | Chi phí tìm kiếm |
|---|---|---|---|
| 20 bài viết | 80 | Miễn phí — 5.000 yêu cầu/tháng | 0 $ |
| 100 bài viết | 400 | Miễn phí — 5.000 yêu cầu/tháng | 0 $ |
| 1.000 bài viếtmột agency, hoặc toàn bộ danh mục khách hàng | 4.000 | Miễn phí — vẫn nằm trong 5.000 yêu cầu/tháng | 0 $ |
Đúng vậy — hạn mức hàng tháng gần như không phải vấn đề ở khối lượng của content marketing thông thường, và chúng tôi thà nói thẳng điều đó còn hơn là bịa ra một lý do để bạn phải trả tiền. Giới hạn mà bạn thực sự có thể gặp phải là giới hạn theo phút. Gói miễn phí cho phép 20 yêu cầu API mỗi phút; một script build minh họa lại 100 bài viết trong một lượt sẽ bắn ra 400 yêu cầu nhanh nhất có thể theo vòng lặp của nó, nên nó sẽ hoặc mất hai mươi phút bị giới hạn tốc độ, hoặc bắt đầu nhận về các mã lỗi 429. Có hai cách để giải quyết: dàn đều các lượt gọi ra (một câu lệnh sleep trong vòng lặp, và một tác vụ chạy ban đêm sẽ không bao giờ để ý), hoặc chuyển sang một gói có giới hạn tốc độ phù hợp với quy trình build của bạn — Starter là 30 yêu cầu/phút, Pro là 60. Hãy chọn dựa trên độ dồn dập, không phải dựa trên tổng khối lượng.
Chi phí duy nhất khác là một lượt gọi mô hình ngắn cho mỗi bài viết để tạo ra đề cương — vài trăm token đầu vào, ba mươi token đầu ra, sẽ là hạng mục rẻ nhất trong bất kỳ quy trình nội dung nào bạn sở hữu. So sánh điều đó với việc tạo sinh bốn ảnh cho mỗi bài viết, tức bốn trăm ảnh mỗi tháng, cộng thêm những lần thử không đạt yêu cầu.
Và phần không xuất hiện trong bảng chi phí: biên tập viên không còn phải mở năm tab trình duyệt nữa. Đó mới là khoản tiết kiệm thực sự.
Nguồn tham khảo & chú thích
1 EU AI Act, Điều 50 — nghĩa vụ minh bạch dành cho các nhà cung cấp và bên triển khai một số hệ thống AI nhất định, có hiệu lực từ ngày 2 tháng 8 năm 2026. Các nhà cung cấp hệ thống tạo sinh âm thanh, hình ảnh, video hoặc văn bản tổng hợp phải đánh dấu kết quả theo định dạng máy có thể đọc được và làm cho chúng có thể phát hiện là do AI tạo ra; bên triển khai phải công bố các deepfake và, trong những trường hợp được xác định, văn bản do AI tạo ra được công bố nhằm thông tin cho công chúng. Digital Omnibus (Quy định (EU) 2026/1744, có hiệu lực từ ngày 27 tháng 7 năm 2026) không sửa đổi chính Điều 50, nhưng cho phép các hệ thống đã có mặt trên thị trường trước ngày 2 tháng 8 năm 2026 có thời hạn đến ngày 2 tháng 12 năm 2026 để đáp ứng yêu cầu đánh dấu có thể đọc được bằng máy theo Điều 50(2). Tất cả những điều này ràng buộc các nhà cung cấp và bên triển khai AI — đây không phải là một quy tắc về việc một blog được phép xuất bản những ảnh nào.
2 Google đọc C2PA Content Credentials và watermark SynthID của riêng mình để hiển thị nguồn gốc trong mục About this image trên khắp Search, Images và Lens. Đây là vấn đề về nguồn gốc phương tiện truyền thông, không phải một hình phạt về thứ hạng đối với nội dung do AI tạo ra.
Nguồn được kiểm tra vào ngày 15 tháng 8 năm 2026: AI Act Điều 50 · Ủy ban Châu Âu — FAQ về minh bạch · Google — metadata ảnh · Tài liệu API & MCP của Pexafy. Thời gian xử lý tìm kiếm và kết quả là các phản hồi thực từ API công khai, được ghi lại trong cùng một ngày.
Câu hỏi thường gặp
Tôi nên dùng ảnh do AI tạo sinh hay ảnh thật cho các bài viết blog?
Làm thế nào để tự động tìm một hình ảnh khớp với bài viết của tôi?
GET /api/v1/search/photos?q=…, khoảng 150 ms, và mỗi kết quả trả về kèm kích thước, giấy phép và một chuỗi ghi công có sẵn.Prompt tốt nhất để biến một bài viết thành truy vấn tìm kiếm hình ảnh là gì?
Tôi có phải ghi công cho các ảnh mình dùng trong bài viết blog không?
Claude hay một AI agent khác có thể tìm ảnh cho bài viết của tôi không?
mcp.pexafy.com/mcp. Thêm nó như một connector tùy chỉnh trong Claude.ai hoặc Claude Desktop và đăng nhập bằng OAuth, hoặc thêm vào Claude Code chỉ bằng một lệnh claude mcp add và một API key. Sau đó agent sẽ tự tìm kiếm theo câu mô tả, theo ảnh tham chiếu hoặc tìm ảnh tương tự, trong khi vẫn giữ bản thảo của bạn trong ngữ cảnh.Làm sao để tránh việc mọi bài viết trên blog của tôi dùng chung một bức ảnh?
photo_id của mỗi ảnh bạn xuất bản và loại trừ nó ở lần chạy tiếp theo — chỉ cần một cột trong CMS của bạn. Đây là lỗi thường gặp mà mọi quy trình tự động hóa đều gặp phải vào khoảng bài viết thứ ba mươi, và nó vô hình cho đến khi ai đó cuộn qua trang mục lục blog của bạn. Việc viết một camera brief mới cho mỗi phần, thay vì tái sử dụng tiêu đề bài viết, sẽ giải quyết phần còn lại.

