วิธีใส่ภาพประกอบทุกบทความที่คุณเผยแพร่ — ด้วยภาพถ่ายจริง แบบขยายสเกล
ทำไมทีมเผยแพร่เนื้อหาถึงหันกลับไปใช้ภาพถ่ายจริง และไปป์ไลน์ที่แน่นอน — พร้อมพรอมต์ — ที่เปลี่ยนบทความฉบับสมบูรณ์ให้กลายเป็นภาพหลักพร้อมเครดิตภายในเวลาประมาณ 150 มิลลิวินาที
 Marouane Tijani
10 นาทีในการอ่าน

ทุกบทความที่คุณเผยแพร่ต้องการภาพประกอบ ไม่ใช่แค่ "มีก็ดี" — ภาพหลักคือสิ่งที่พรีวิวบนโซเชียลแสดงออกมา คือสิ่งที่ผู้อ่านเห็นก่อนประโยคแรก และคือสิ่งที่บอกพวกเขาได้ในเสี้ยววินาทีว่าเพจนี้ทำโดยคนที่ใส่ใจหรือไม่ คูณเข้ากับภาพสี่ภาพต่อโพสต์ และสี่สิบโพสต์ต่อไตรมาส "หาภาพสักภาพ" ก็ไม่ใช่แค่งานเล็ก ๆ อีกต่อไป แต่กลายเป็นปัญหาระดับไปป์ไลน์
นี่คือวิธีที่เราแก้ปัญหานี้: จะใช้อะไรแทนภาพที่สร้างด้วย AI และทำไม รวมถึงสามวิธีในการเชื่อม Pexafy เข้ากับเวิร์กโฟลว์ — ด้วยมือ ผ่าน API หรือผ่านเอเจนต์ AI — พร้อมพรอมต์ที่แปลงร่างบทความที่เสร็จแล้วให้กลายเป็นประโยคค้นหาที่หาเจอจริง ๆ
ทำไมภาพถ่ายจริงยังชนะภาพที่สร้างขึ้น
การสร้างภาพประกอบนั้นง่าย และนั่นคือปัญหาที่แท้จริง มีสี่สิ่งที่เปลี่ยนไประหว่างช่วงที่ "ภาพ AI คือทางลัด" กับวันนี้:
1 · เมื่อทำในปริมาณมาก การค้นหาเร็วกว่าการสร้าง
การสร้างภาพหนึ่งภาพคือหนึ่งพรอมต์ การรอ การตรวจดู และ — พูดตรง ๆ — อีกสองสามครั้งกว่าจะได้ภาพที่ใช้ได้ ในขณะที่การค้นหาเชิงความหมายคือคำขอเดียวที่คืนผลลัพธ์สิบหกรายการภายในเวลาประมาณ 150 มิลลิวินาที แต่ละภาพก็มีลิขสิทธิ์พร้อมใช้ มีเครดิตพร้อม มีขนาดพร้อม และมีขนาดภาพระบุไว้ในผลลัพธ์แล้ว สำหรับหนึ่งภาพ ความต่างนี้แค่กาแฟหนึ่งแก้ว แต่สำหรับสี่ร้อยภาพต่อไตรมาส มันคือความต่างระหว่างเวิร์กโฟลว์กับงานเต็มเวลา
2 · ภาพถ่ายมีความแม่นยำ ส่วนภาพที่สร้างขึ้นแค่ดูสมเหตุสมผล
ทันทีที่บทความของคุณพูดถึงสิ่งที่มีอยู่จริง — อาชีพหนึ่ง อุปกรณ์ชิ้นหนึ่ง เมืองหนึ่ง ท่าทางหนึ่ง วัสดุหนึ่ง — ภาพที่สร้างขึ้นจะได้ บรรยากาศ ถูก แต่รายละเอียดผิด มือหกนิ้วคือเวอร์ชันตลก ส่วนเวอร์ชันที่แพงกว่าคือเครื่องมือผ่าตัดที่ไม่มีอยู่จริง ห้องนักบินที่มีปุ่มควบคุมสมมติ หรือ "ถนนในลิสบอน" ที่ไม่มีใครจากลิสบอนจำได้ ผู้อ่านที่รู้เรื่องเนื้อหาของคุณจะสังเกตเห็น และพวกเขาจะสังเกตภาพก่อนสิ่งอื่นใด
3 · ทุกคนมีลุคเดียวกันหมด
โมเดล diffusion มักลงเอยที่สไตล์เฉพาะตัวหนึ่งแบบ และกำแพงภาพประกอบแนวไล่สีนุ่ม ๆ แสงจ้าเกินไป สมมาตรจนน่าสงสัย ตอนนี้อ่านได้ว่าเป็น ตัวเติมช่องว่าง การรับรู้แบบนั้นคือต้นทุนที่แท้จริง — ไม่ใช่บทลงโทษ แต่เป็นสัญญาณ ภาพถ่ายจริง — เกรนของภาพ เก้าอี้ที่วางเก้ ๆ กัง ๆ คนที่กำลังพูดค้างประโยค — อ่านได้ว่าเป็นรายงานจริง
4 · และตอนนี้ภาพเหล่านั้นมาพร้อมป้ายกำกับ
ข้อนี้เป็นบริบทมากกว่าจะเป็นข้อโต้แย้ง แต่มันคือทิศทางที่กำลังไป ตั้งแต่วันที่ 2 สิงหาคม 2026 มาตรา 50 ของ EU AI Act กำหนดให้ผู้ให้บริการระบบสร้างเนื้อหาต้องทำเครื่องหมายผลลัพธ์สังเคราะห์ในรูปแบบที่เครื่องอ่านได้ และผู้ใช้งานระบบต้องเปิดเผยดีปเฟก1 ในด้านการตรวจจับ Google อ่าน C2PA Content Credentials และลายน้ำ SynthID ของตัวเองเพื่อตอบคำถามว่า "นี่เป็นภาพที่สร้างด้วย AI หรือไม่?" ภายใน Search, Images และ Lens2 ไม่มีข้อใดในนี้เป็นกฎเกี่ยวกับว่าบล็อกควรเผยแพร่ภาพแบบไหน และไม่มีข้อใดในนี้ทำให้อันดับของคุณตกลง สิ่งที่เปลี่ยนไปคือปลายทาง: ที่มาของภาพด้านบนสุดของบทความคุณตอนนี้เป็นสิ่งที่ผู้อ่านตรวจสอบได้ในสองคลิก โดยไม่ต้องถามคุณ ภาพถ่ายที่มีลิขสิทธิ์ถูกต้องไม่มีอะไรต้องแจ้ง
เมื่อไหร่ที่ภาพที่สร้างขึ้น คือ ตัวเลือกที่ถูกต้อง แผนผังแนวคิดและไดอะแกรม ฉากที่ถ่ายภาพจริงไม่ได้ (สินค้าที่ยังไม่มีอยู่จริง กลไกเชิงนามธรรม เมืองในอนาคต) สไตล์ภาพประกอบประจำแบรนด์ที่คุณเป็นเจ้าของและต้องการให้ซ้ำในทุกโพสต์ และอะไรก็ตามที่ตั้งใจให้ภาพถูกเข้าใจว่าเป็นภาพประกอบ ไม่ใช่หลักฐาน ใช้ทั้งสองอย่างควบคู่กัน — แค่เลิกใช้การสร้างภาพเป็นค่าเริ่มต้นสำหรับกรณี "ผมต้องการภาพคนกำลังประชุมกัน"
สามวิธีในการหาภาพประกอบ ขึ้นอยู่กับปริมาณงานของคุณ
เอนจินเดียวกัน คลังเดียวกัน — ภาพถ่ายใช้ได้ฟรี 9M+ ภาพ จาก 9 คลัง — และสามจุดเข้าใช้งาน เลือกตามจำนวนบทความที่คุณเผยแพร่ ไม่ใช่ตามความถนัดด้านเทคนิคของคุณ
| จุดเข้าใช้งาน | เหมาะกับใครและปริมาณเท่าไหร่ | ต่อบทความ | สิ่งที่ต้องมี |
|---|---|---|---|
| หน้าค้นหา | บรรณาธิการ ทำทีละโพสต์ — สูงสุดประมาณ 20 โพสต์/เดือน | ~30 วินาที | เบราว์เซอร์เท่านั้น ไม่ต้องมีบัญชีก็ค้นหาได้ |
| REST API | CMS การ build เว็บไซต์แบบสแตติก หรือชุดร่างบทความจำนวนมาก | ~1 คำขอ, ~150 ms | API key แพ็กเกจฟรี 5,000 คำขอ/เดือน 20 ครั้ง/นาที |
| เซิร์ฟเวอร์ MCP | เอเจนต์ AI ที่เขียนหรือแก้ไขบทความร่าง | ภายในบทสนทนาเดียวกัน | URL คอนเนกเตอร์หนึ่งตัว OAuth หรือคีย์ |
ทั้งสามช่องทางใช้คลังภาพและระบบจัดอันดับเดียวกัน ดังนั้นภาพที่บรรณาธิการค้นเจอในหน้า UI ก็คือภาพเดียวกัน มีรหัสเดียวกัน ที่ API จะส่งกลับให้สคริปต์ build ของคุณ
หนึ่งบทความ 30 วินาที: หน้าค้นหา
บรรยายฉากแบบที่คุณจะบรรยายให้ช่างภาพฟัง เป็นประโยคเต็ม ๆ ในภาษาของคุณเอง ไม่ใช่ team meeting — แต่เป็น "a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office" รายละเอียดที่เป็นรูปธรรมเพิ่มเติมทุกอย่างจะช่วยจำกัดผลลัพธ์แคบลง แทนที่จะทำให้ว่างเปล่า เพราะเอนจินจัดอันดับตามความหมาย ไม่ใช่จับคู่คำของคุณกับแท็กของใครสักคน
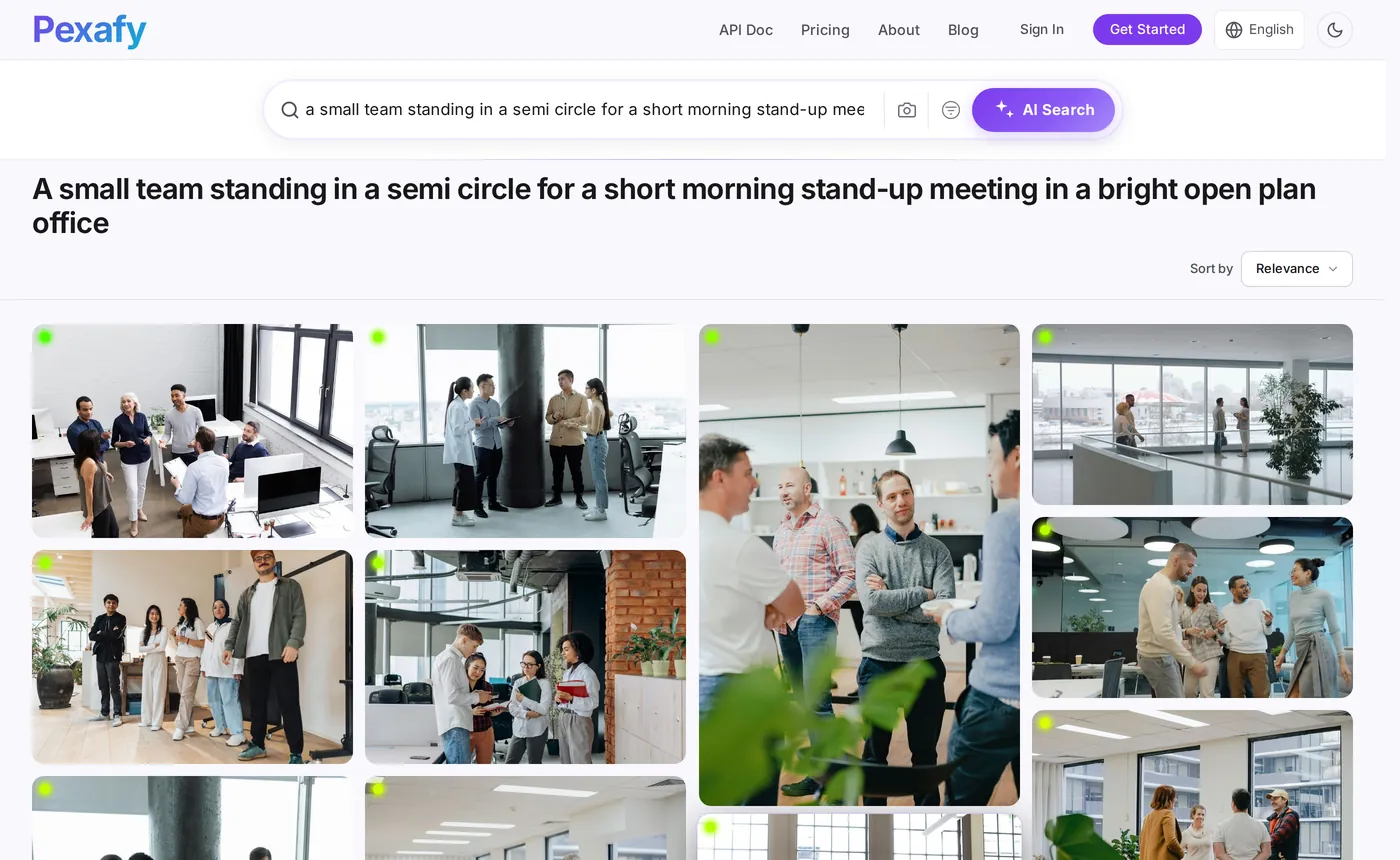
จากนั้นค่อยจำกัดด้วยตัวกรองที่สำคัญสำหรับเลย์เอาต์บทความ — และเฉพาะตัวกรองเหล่านั้น:
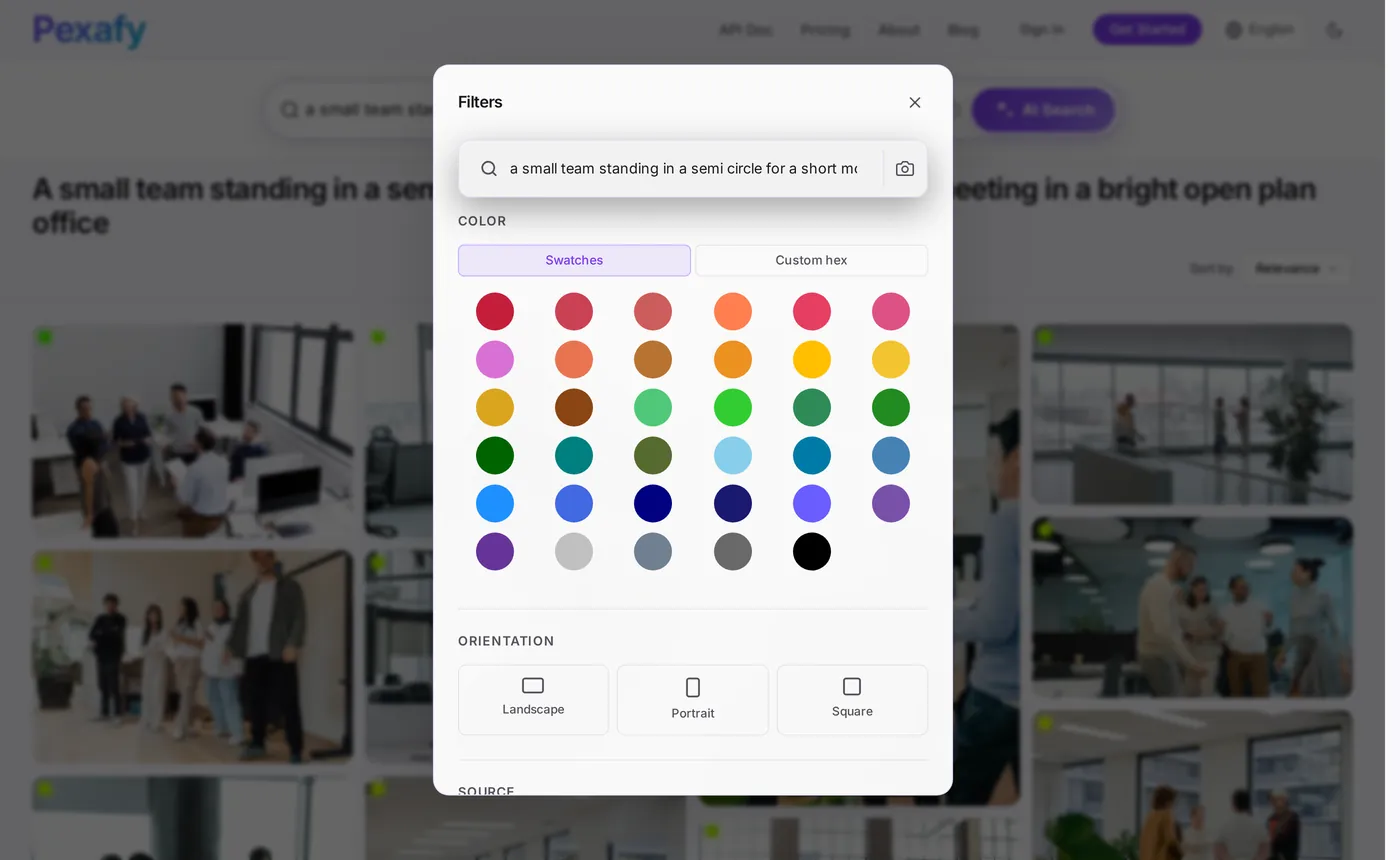
- เขียนเป็นประโยค ไม่ใช่คีย์เวิร์ด ประธาน + การกระทำ + สถานที่ + แสง สูงสุด 500 ตัวอักษร ในภาษาใดก็ได้จากกว่า 100 ภาษา
- กรองเป็นแนวนอน สำหรับภาพหลัก แล้วรันใหม่โดยไม่กรองสำหรับภาพในเนื้อหา ซึ่งภาพแนวตั้งมักดูดีกว่า
- เปิดภาพ เพื่อรับบรรทัดเครดิตที่พร้อมใช้ หน้าแหล่งที่มาต้นฉบับ และไฟล์ความละเอียดเต็ม
- ใช้ "ภาพที่คล้ายกัน" จากภาพที่คุณเลือกเพื่อประกอบส่วนถัดไปในโทนภาพเดียวกัน — แสงแบบเดียวกัน การจัดแบบเดียวกัน ฉากที่ต่างออกไป
พรอมต์: แปลงบทความร่างให้เป็นประโยคค้นหา
นี่คือขั้นตอนที่ทุกคนทำผิดเมื่อทำระบบอัตโนมัติ พวกเขาป้อนชื่อบทความเข้าช่องค้นหาโดยตรง และชื่อบทความคือข้อมูลที่ผิดที่สุด: มันเป็นนามธรรม ("The hidden cost of context switching") และไม่มีภาพถ่ายใดในโลกที่แสดงถึงมันได้ สิ่งที่คุณต้องการจากโมเดลไม่ใช่บทสรุป — แต่เป็น บรีฟสำหรับกล้อง
# system prompt
You are a photo editor. Read the article and write ONE search sentence
for a stock-photo engine that ranks by meaning, not by keywords.

Rules:
1. Describe a scene a camera could have taken: someone doing
   something, somewhere. Never name the topic itself ("fintech",
   "productivity", "SEO") — name what would be in the frame.
2. 12 to 25 words. Longer beats shorter: every concrete detail
   (light, place, gesture, time of day) sharpens the match.
3. No text, logos, brands, charts, screenshots or famous people.
   Free photo libraries have almost none of those.
4. No invisible metaphors ("growth", "synergy", "transformation").
5. Match the mood of the article: calm, tense, tired, celebratory.
6. Write the sentence in English even if the article is not.

Return JSON only:
{ "query": "…", "orientation": "landscape", "alt": "…" }
กฎข้อที่ 1 ทำงานหนักที่สุด นี่คือกฎเดียวกันนี้บนบทความร่างจริงสามชิ้น — คอลัมน์กลางคือสิ่งที่คนพิมพ์เวลารีบ ๆ ส่วนคอลัมน์ขวาคือสิ่งที่พรอมต์คืนกลับมา:
| บทความนี้พูดถึง… | คำค้นหาแบบรีบ ๆ | บรีฟสำหรับกล้อง |
|---|---|---|
| ทำไม stand-up ประจำวันของคุณถึงพัง | team meeting |
"a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office" |
| ลดเวลา onboarding จาก 6 สัปดาห์เหลือ 9 วัน | onboarding |
"a new employee on their first day at a desk, listening while a colleague leans in and points at their screen" |
| ต้นทุนที่ซ่อนอยู่ของการสลับงาน (context switching) | productivity |
"a tired developer rubbing their eyes in front of two monitors late in the evening, the office empty behind them" |
team meeting จะคืนภาพสต็อกห้องประชุมทั่วไปที่ทุกคนที่เขียนเรื่องเดียวกับคุณกำลังใช้อยู่แล้ว ส่วนประโยคในคอลัมน์ที่สามจะคืนภาพเหล่านี้ ภายใน 155 มิลลิวินาที:
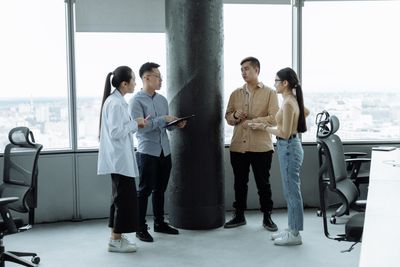

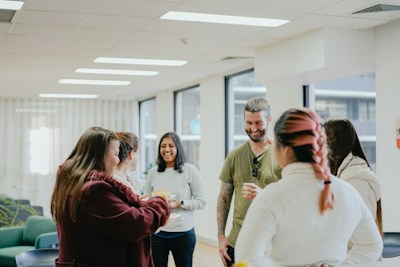
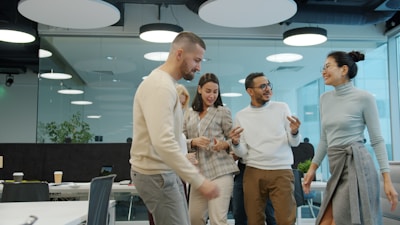
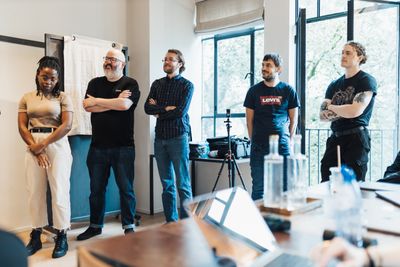
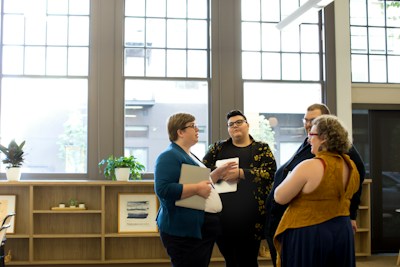
team meeting ไม่เคยรับประกันได้
ไปป์ไลน์: ใส่บทความร่างเข้าไป ได้ภาพหลักพร้อมเครดิตออกมา
สี่สิบบรรทัด สองการเรียก: หนึ่งครั้งไปที่โมเดลเพื่อให้ได้บรีฟ อีกหนึ่งครั้งไปที่ Pexafy เพื่อให้ได้ภาพ วางไว้ใน save hook ของ CMS ของคุณ ในขั้นตอน build เว็บไซต์แบบสแตติก หรือในสคริปต์ที่ไล่อ่านโฟลเดอร์ไฟล์ Markdown
import json, os, requests
from anthropic import Anthropic

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
llm = Anthropic()  # ANTHROPIC_API_KEY จากตัวแปรสภาพแวดล้อม

def camera_brief(article: str) -> dict:
    # PHOTO_EDITOR = system prompt ด้านบน
    msg = llm.messages.create(
        model="claude-sonnet-5",
        max_tokens=300,
        system=PHOTO_EDITOR,
        messages=[{ "role": "user", "content": article[:12000] }],
    )
    return json.loads(msg.content[0].text)

def illustrate(article: str) -> dict | None:
    brief = camera_brief(article)
    r = requests.get(
        SEARCH,
        headers={"X-Api-Key": os.environ["PEXAFY_API_KEY"]},
        params={
            "q": brief["query"],           # ประโยคเต็ม
            "orientation": brief["orientation"],
            "per_page": 8,
            "score_threshold": 0.55,      # ตัดผลลัพธ์ที่ตรงกันน้อยทิ้ง
        },
        timeout=10,
    )
    hits = r.json()["data"]
    if not hits:                        # บรีฟแคบเกินไป → ขยาย แล้วลองใหม่
        return None

    top = hits[0]
    return {
        "src":    top["urls"]["regular"],        # 1080px — ขนาดภาพหลัก
        "alt":    brief["alt"] or top["alt_description"],
        "credit": top["attribution"]["html"],   # พร้อมแสดงผลได้เลย
        "width":  top["width"],
        "height": top["height"],
        "id":     top["photo_id"],           # เก็บไว้: ไม่ใช้ซ้ำ
    }
สามรายละเอียดที่เปลี่ยนสิ่งนี้จากแค่ตัวอย่างสาธิตให้กลายเป็นสิ่งที่คุณปล่อยให้ทำงานต่อเนื่องได้:
score_threshold— ไม่ได้ผลลัพธ์เลยดีกว่าได้ภาพที่ไม่เข้าเรื่อง ถ้าบรีฟเจาะจงเกินไป ให้ขยายมันออก (ตัดวลีสุดท้ายทิ้ง) แล้วลองใหม่หนึ่งครั้ง- เก็บ
photo_idไว้ — บรรทัดเดียวในฐานข้อมูลของคุณ และไม่มีบทความสองบทความในเว็บไซต์คุณที่จะใช้ภาพหลักซ้ำกันเลย นี่คือความล้มเหลวที่ทุกคนเจอเมื่อถึงบทความที่สามสิบ - หนึ่งคำขอต่อหนึ่งช่องภาพ — ภาพหลักบวกกับภาพในเนื้อหาอีกสามภาพ คือสี่คำขอต่อบทความ หรือหนึ่งคำขอถ้าคุณเลือกใช้ผลลัพธ์สี่รายการที่ต่างกันจากการค้นหาเดียวกัน
ไม่มี Python? ครึ่งหนึ่งของการค้นหาทั้งหมดคือบรรทัดเดียว และทุกผลลัพธ์มีฟิลด์เดียวกันไม่ว่าจะมาจากคลังไหน:
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a tired developer rubbing their eyes at two monitors" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "per_page=6"

# → { "success": true, "data": [ … ], "meta": { "took_ms": 147 } }
รูปแบบของการตอบกลับ — urls, width, photographer_full_name,
source, license_type, relevance_score,
attribution — เหมือนกันทุกประการ ไม่ว่าจะเป็นภาพจาก Pexels, Pixabay หรือ Unsplash การปรับให้เป็นมาตรฐานนี้คือส่วนที่คุณคงต้องเขียนและดูแลเองอยู่ดี เราได้แกะมันออกทีละฟิลด์ใน
บทความเปรียบเทียบ API ภาพถ่ายสต็อกฟรี
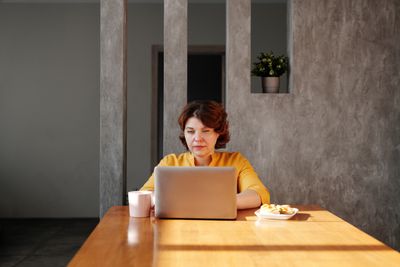
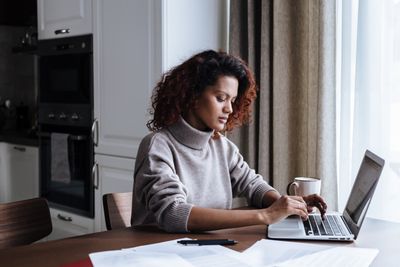
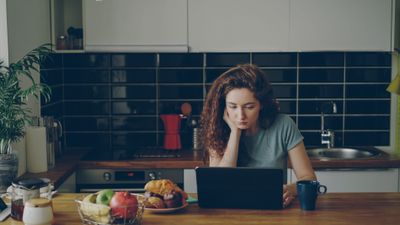
ส่วนที่สอง บรีฟที่สอง การค้นหาครั้งที่สอง — ประเด็นคือบทความหนึ่งบทความให้ฉากที่แตกต่างกันหลายฉาก แทนที่จะเป็นภาพเดียวที่ถูกยืดใช้สี่ครั้ง:
ให้เอเจนต์เลือกภาพเอง: MCP
ถ้าโมเดลกำลังเขียนหรือแก้ไขบทความร่างอยู่แล้ว ไปป์ไลน์ที่สะอาดที่สุดคือไม่มีไปป์ไลน์เลย — ให้เอเจนต์มีเครื่องมือค้นหา แล้วให้มันประกอบภาพให้กับสิ่งที่เพิ่งเขียนไป ในบทสนทนาเดียวกัน ในขณะที่มันยังมีบริบทอยู่ในมือ
Pexafy รันเซิร์ฟเวอร์ Model Context Protocol แบบโฮสต์เองไว้ที่
mcp.pexafy.com/mcp มีเครื่องมือสามอย่าง:
search_photos (หนึ่งประโยค),
search_photos_by_image (ภาพอ้างอิง เสริมด้วยประโยคก็ได้ — "แบบนี้ แต่ตอนพระอาทิตย์ตก") และ get_similar_photos (ภาพที่คล้ายกับที่คุณเลือกไว้แล้ว ซึ่งเป็นวิธีที่คุณคงความสอดคล้องของชุดภาพไว้ได้)
Settings → Connectors → Add custom connector
Name: Pexafy
URL:  https://mcp.pexafy.com/mcp
# จากนั้นล็อกอินด้วยบัญชี Pexafy ของคุณเมื่อหน้าต่างเปิดขึ้นมา
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# หรือคอมมิตลงในรีโป เพื่อให้ทั้งทีมใช้ได้ — .mcp.json
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
จากตรงนั้น การประกอบภาพให้บทความก็เป็นแค่หนึ่งประโยค ไม่ใช่งานทั้งชิ้น เอเจนต์เขียนบรีฟสำหรับกล้องของตัวเอง — มันเพิ่งอ่านบทความร่างมา จึงอยู่ในตำแหน่งที่ดีที่สุดกว่าใครในการบรรยายฉาก:
You  Here's the draft of this week's post. Find a landscape hero
     and one photo for section 2, and give me the credit lines.

Claude  → search_photos(
       q="a small team standing in a semi circle for a short morning
          stand-up meeting in a bright open plan office",
       orientation="landscape")
     ← 16 photos · 155 ms

     Hero    → Photo by Thirdman on Pexels · 6453×4302 · score 0.80
     Section → Photo by Marcus Aurelius on Pexels · 6000×4000
     Both licence-free, attribution lines below, ready to paste.
Unsplash, Pexels, Pixabay และ Openverse ไม่มีเซิร์ฟเวอร์ MCP อย่างเป็นทางการ — สิ่งที่มีอยู่คือ wrapper จากชุมชนที่คุณต้องโฮสต์และจัดการคีย์เอง ถ้าเวิร์กโฟลว์การเขียนของคุณวิ่งผ่านเอเจนต์อยู่แล้ว ความต่างนี้ คือ ตัวการผสานรวม
Alt text ลิขสิทธิ์ และความเร็วของหน้าเว็บ
เลือกภาพเรียบร้อยแล้ว ยังมีสี่เรื่องที่ตัดสินว่าภาพนั้นจะช่วยหน้าเพจหรือทำร้ายมันแบบเงียบ ๆ:
-
เขียน alt text ให้คน ไม่ใช่ให้ crawler ทุกผลลัพธ์มี
alt_descriptionมาให้ — ใช้เป็นฉบับร่าง แล้วเขียนใหม่ให้เข้ากับบริบทของ ย่อหน้า คุณ "เพื่อนร่วมงานสี่คนยืนอยู่ในที่ประชุมตอนเช้า" ดีกว่ากองคำคีย์เวิร์ด และเป็นข้อความที่โปรแกรมอ่านหน้าจอจะอ่านออกมาจริง ๆ ให้อยู่ในระยะไม่เกินประมาณ 125 ตัวอักษร เว้นว่าง (alt="") เฉพาะเมื่อภาพนั้นเป็นแค่ของตกแต่งล้วน ๆ -
ใส่เครดิตแม้ไม่มีอะไรบังคับให้คุณทำ การให้เครดิตไม่ใช่ข้อบังคับตามเงื่อนไขการใช้งาน API ของ Pexafy และทุกผลลัพธ์มีสตริง
attribution.htmlที่พร้อมใช้อยู่แล้ว — แต่ลิขสิทธิ์ที่ผูกมากับคลังต้นฉบับยังคงกำกับการใช้ภาพนั้นของคุณอยู่ดี และบรรทัดเครดิตที่มองเห็นได้คือสิ่งที่บอกผู้อ่าน (และเอนจินให้คำตอบ) ว่านี่คือภาพถ่ายจริงที่มีผู้ถ่ายจริง -
ให้บริการขนาดที่เหมาะสม
urls.regular(1080 px) เหมาะสำหรับภาพหลัก ส่วนurls.fullเป็นไฟล์ขนาด 2400 px ที่ไม่มีบทความไหนต้องการ ให้ระบุwidth/heightจากผลลัพธ์เสมอ เพื่อให้เบราว์เซอร์จองพื้นที่ไว้ล่วงหน้า — คู่แอตทริบิวต์นี้เพียงคู่เดียวคือความต่างระหว่างคะแนน layout-shift ที่ดีกับที่แย่ ใช้fetchpriority="high"กับภาพหลัก และloading="lazy"กับทุกอย่างที่อยู่นอกจอแรก -
ป้อนภาพหลักเข้าไปในเมทาดาต้าของคุณด้วย URL เดียวกันนี้ควรเป็นทั้ง
og:image,twitter:imageและคุณสมบัติimageในข้อมูลโครงสร้างของArticleภาพเดียว สามที่ ไม่ต้องทำงานเพิ่มเลย — และพรีวิวบนโซเชียลก็ไม่ต้องตกกลับไปใช้โลโก้ของคุณอีกต่อไป
100 บทความต่อเดือนมีต้นทุนเท่าไหร่กันแน่
สมมติว่ามีภาพหลักบวกกับภาพในเนื้อหาอีกสามภาพ นั่นคือสี่คำขอค้นหาต่อโพสต์ — เวอร์ชันที่ตั้งใจให้สิ้นเปลืองที่สุด คือรันคำค้นหาแยกต่างหากสำหรับแต่ละช่องภาพ แทนที่จะใช้ผลลัพธ์เดียวกันซ้ำ:
| ปริมาณ | คำขอค้นหา / เดือน | แพ็กเกจ | ต้นทุนค้นหา |
|---|---|---|---|
| 20 บทความ | 80 | ฟรี — 5,000 คำขอ/เดือน | $0 |
| 100 บทความ | 400 | ฟรี — 5,000 คำขอ/เดือน | $0 |
| 1,000 บทความเอเจนซี หรือพอร์ตงานลูกค้าทั้งหมด | 4,000 | ฟรี — ยังอยู่ในโควตา 5,000 คำขอ/เดือน | $0 |
ใช่ — โควตารายเดือนไม่ใช่ปัญหาเลยในระดับปริมาณของการทำคอนเทนต์มาร์เก็ตติ้ง และเราขอพูดตรง ๆ แบบนี้ดีกว่าไปสร้างเหตุผลให้คุณต้องจ่ายเงิน ขีดจำกัดที่คุณจะเจอจริง ๆ คือขีดจำกัดต่อนาที แพ็กเกจฟรีอนุญาตให้เรียก API ได้ 20 ครั้งต่อนาที สคริปต์ build ที่ประกอบภาพใหม่ให้ 100 บทความในรอบเดียวจะยิงคำขอ 400 ครั้งเร็วเท่าที่ลูปของคุณจะทำได้ ดังนั้นมันจะใช้เวลายี่สิบนาทีถูกจำกัดความเร็ว หรือไม่ก็เริ่มเจอ 429 สองทางออก: เว้นจังหวะการเรียก (แค่ sleep หนึ่งบรรทัดในลูป งาน nightly job จะไม่รู้สึกอะไรเลย) หรือย้ายไปแพ็กเกจที่มีอัตราจำกัดตรงกับการ build ของคุณ — Starter คือ 30 คำขอ/นาที Pro คือ 60 เลือกตาม burst ไม่ใช่ตามปริมาณรวม
ค่าใช้จ่ายอีกรายการเดียวคือการเรียกโมเดลสั้น ๆ หนึ่งครั้งต่อบทความเพื่อสร้างบรีฟ — ไม่กี่ร้อยโทเคนเข้า สามสิบโทเคนออก ซึ่งจะเป็นรายการที่ถูกที่สุดในไปป์ไลน์คอนเทนต์ใดก็ตามที่คุณมี เทียบกับการสร้างภาพสี่ภาพต่อโพสต์ ที่สี่ร้อยภาพต่อเดือน บวกกับความพยายามที่ไม่ผ่านการคัดเลือกด้วย
และส่วนที่ไม่ปรากฏในตารางต้นทุน: บรรณาธิการเลิกเปิดห้าแท็บพร้อมกัน นั่นคือการประหยัดที่แท้จริง
อ้างอิงและเชิงอรรถ
1 EU AI Act มาตรา 50 — ข้อบังคับด้านความโปร่งใสสำหรับผู้ให้บริการและผู้ใช้งานระบบ AI บางประเภท มีผลบังคับใช้ตั้งแต่วันที่ 2 สิงหาคม 2026 ผู้ให้บริการระบบที่สร้างเสียง ภาพ วิดีโอ หรือข้อความสังเคราะห์ต้องทำเครื่องหมายผลลัพธ์ในรูปแบบที่เครื่องอ่านได้ และทำให้ตรวจจับได้ว่าสร้างขึ้นโดยเทียม ผู้ใช้งานระบบต้องเปิดเผยดีปเฟก และในกรณีที่กำหนดไว้ ต้องเปิดเผยข้อความที่สร้างด้วย AI ซึ่งเผยแพร่เพื่อให้ข้อมูลแก่สาธารณะ Digital Omnibus (Regulation (EU) 2026/1744 มีผลบังคับใช้ตั้งแต่วันที่ 27 กรกฎาคม 2026) ไม่ได้แก้ไขมาตรา 50 เอง แต่ให้เวลาระบบที่วางจำหน่ายอยู่ก่อนวันที่ 2 สิงหาคม 2026 จนถึงวันที่ 2 ธันวาคม 2026 เพื่อให้เป็นไปตามข้อกำหนดการทำเครื่องหมายแบบเครื่องอ่านได้ของมาตรา 50(2) ทั้งหมดนี้ผูกพันผู้ให้บริการและผู้ใช้งาน AI — ไม่ใช่กฎเกี่ยวกับว่าบล็อกควรเผยแพร่ภาพแบบไหน
2 Google อ่าน C2PA Content Credentials และลายน้ำ SynthID ของตัวเองเพื่อแสดงที่มาของภาพในส่วน About this image ทั่วทั้ง Search, Images และ Lens นี่คือการระบุที่มาของสื่อ ไม่ใช่บทลงโทษด้านการจัดอันดับสำหรับเนื้อหาที่สร้างด้วย AI
ตรวจสอบแหล่งข้อมูลเมื่อวันที่ 15 สิงหาคม 2026: AI Act Article 50 · European Commission — transparency FAQ · Google — image metadata · Pexafy API & MCP docs เวลาในการค้นหาและผลลัพธ์เป็นการตอบกลับจริงจาก API สาธารณะ บันทึกไว้ในวันเดียวกัน
คำถามที่พบบ่อย
ควรใช้ภาพที่สร้างด้วย AI หรือภาพถ่ายจริงสำหรับบทความบล็อก?
จะค้นหาภาพที่ตรงกับบทความของฉันโดยอัตโนมัติได้อย่างไร?
GET /api/v1/search/photos?q=… ใช้เวลาประมาณ 150 มิลลิวินาที และทุกผลลัพธ์จะมาพร้อมขนาด สัญญาอนุญาต และข้อความเครดิตที่พร้อมใช้งานพรอมต์ที่ดีที่สุดสำหรับแปลงบทความให้เป็นคำค้นหาภาพคืออะไร?
ต้องให้เครดิตภาพที่ใช้ในบล็อกโพสต์หรือไม่?
Claude หรือ AI agent อื่นสามารถหาภาพให้บทความของฉันได้หรือไม่?
mcp.pexafy.com/mcp เพิ่มเป็น custom connector ใน Claude.ai หรือ Claude Desktop แล้วเข้าสู่ระบบด้วย OAuth หรือเพิ่มเข้า Claude Code ด้วยคำสั่ง claude mcp add เพียงคำสั่งเดียวพร้อม API key จากนั้น agent จะค้นหาได้เองด้วยประโยค ด้วยภาพอ้างอิง หรือค้นหาภาพที่คล้ายกัน ในขณะที่ยังมีฉบับร่างของคุณอยู่ใน contextจะหยุดไม่ให้ทุกบทความในบล็อกใช้ภาพเดิมซ้ำได้อย่างไร?
photo_id ของทุกภาพที่คุณเผยแพร่ไว้แล้วกันภาพนั้นออกในรอบถัดไป — เพิ่มเพียงหนึ่งคอลัมน์ใน CMS ของคุณ นี่คือรูปแบบความล้มเหลวที่ไปป์ไลน์อัตโนมัติทุกตัวมักเจอราวๆ บทความที่สามสิบ และมันจะมองไม่เห็นจนกว่าจะมีใครเลื่อนดูหน้าสารบัญบล็อกของคุณ การเขียน camera brief ใหม่สำหรับแต่ละส่วน แทนที่จะใช้ชื่อบทความซ้ำ จะช่วยจัดการส่วนที่เหลือ

