Как иллюстрировать каждую публикуемую статью — реальными фото, в масштабе
Почему издательские команды возвращаются к реальной фотографии, и точный пайплайн — с промптом внутри, — который превращает готовый черновик в подписанное главное изображение примерно за 150 миллисекунд.
 Marouane Tijani
10 мин чтения

Каждой статье, которую вы публикуете, нужна картинка. Это не приятное дополнение — именно заглавное изображение показывается в превью в соцсетях, именно его читатель видит раньше первого предложения, и именно оно за полсекунды сообщает, сделана ли страница тем, кому не всё равно. Умножьте это на четыре изображения на пост и сорок постов в квартал — и «найти фото» перестаёт быть задачей, становясь проблемой конвейера.
Вот как мы это решаем: что использовать вместо сгенерированных изображений и почему, и три способа встроить Pexafy в рабочий процесс — вручную, через API или через ИИ-агента, — включая промпт, который превращает готовый черновик в поисковое предложение, которое действительно что-то находит.
Почему настоящие фото всё ещё превосходят сгенерированные
Сгенерировать иллюстрацию легко, и именно в этом проблема. Между «ИИ-изображения — это чит-код» и сегодняшним днём изменились четыре вещи:
1 · При больших объёмах поиск быстрее генерации
Генерация — это один промпт, ожидание, проверка и, честно говоря, ещё две-три попытки, прежде чем получится что-то пригодное. Семантический поиск — это один запрос, который возвращается с шестнадцатью кандидатами примерно за 150 миллисекунд, причём каждый уже лицензирован, уже имеет указание авторства, уже приведён к нужному размеру, а его размеры есть в ответе. Для одного изображения разница — это время на чашку кофе. Для четырёхсот изображений в квартал это разница между рабочим процессом и работой.
2 · Фотография точна; генерация правдоподобна
В тот момент, когда ваша статья касается чего-то реального — профессии, оборудования, города, жеста, материала, — сгенерированное изображение передаёт ощущение верно, а детали неверно. Шестипалые руки — это шуточный вариант; дорогостоящий вариант — это хирургический инструмент, которого не существует, кабина с выдуманными органами управления или «улица Лиссабона», которую не узнает ни один лиссабонец. Читатели, разбирающиеся в теме, замечают это, и замечают в первую очередь картинку.
3 · У всех одинаковый вид
Диффузионные модели сходятся к единому фирменному стилю, и стена иллюстраций с мягкими градиентами, избыточным светом и подозрительной симметрией теперь читается как заполнитель места. Это восприятие и есть настоящая цена: не штраф, а сигнал. Настоящая фотография — зерно, неудобный стул, кто-то на полуслове — читается как репортаж.
4 · И теперь они приходят с этикеткой
Это скорее контекст, чем аргумент, но это направление движения. С 2 августа 2026 года статья 50 Закона ЕС об ИИ (AI Act) требует от поставщиков генеративных систем маркировать синтетические результаты в машиночитаемом формате, а от операторов — раскрывать дипфейки.1 Со стороны обнаружения Google считывает метаданные C2PA Content Credentials и собственный водяной знак SynthID, чтобы отвечать на вопрос «это изображение сгенерировано ИИ?» в Поиске, Картинках и Lens.2 Ничего из этого не является правилом о том, какие изображения может публиковать блог, и ничего из этого не стоит вам позиций в выдаче. Изменилось то, что происходит дальше: происхождение картинки в шапке вашей статьи теперь можно проверить в два клика, не спрашивая вас. Лицензионной фотографии нечего декларировать.
Когда сгенерированные изображения — правильный выбор. Концептуальные диаграммы и схемы. Сцена, которую нельзя сфотографировать (продукт, которого ещё не существует, абстрактный механизм, город будущего). Фирменный иллюстративный стиль, которым вы владеете и хотите повторять в каждом посте. И всё, где картинка сознательно воспринимается как иллюстрация, а не как свидетельство. Используйте и то, и другое — просто перестаньте применять генерацию по умолчанию для случая «мне нужно фото людей на встрече».
Три способа иллюстрировать статьи в зависимости от объёма
Один и тот же движок, один и тот же каталог — 9M+ бесплатных для использования фото из 9 библиотек — и три точки входа. Выбирайте по тому, сколько статей вы публикуете, а не по тому, насколько вы технически подкованы.
| Точка входа | Лучше всего подходиткому и в каком объёме | На статью | Что нужно |
|---|---|---|---|
| Поисковый интерфейс | Редакторам, по одному посту за раз — до ~20/месяц | ~30 секунд | Браузер. Для поиска аккаунт не нужен. |
| REST API | CMS, сборка статического сайта, пакет черновиков | ~1 запрос, ~150 мс | API-ключ. 5 000 запросов/месяц бесплатно, 20/мин. |
| MCP-сервер | ИИ-агент, который пишет или редактирует черновик | В рамках того же диалога | Один URL коннектора, OAuth или ключ. |
У этих трёх способов один каталог и один рейтинг, поэтому фото, найденное редактором в интерфейсе, — это то же фото с тем же идентификатором, которое API вернёт вашему скрипту сборки.
Одна статья, 30 секунд: поисковый интерфейс
Опишите сцену так, как описали бы её фотографу, полным предложением, на своём языке. Не
team meeting — а «a small team standing in a semi circle for a short morning
stand-up meeting in a bright open plan office». Каждая дополнительная конкретная деталь
сужает выдачу, а не опустошает её, потому что движок ранжирует по смыслу, а не сопоставляет ваши
слова с чужими тегами.
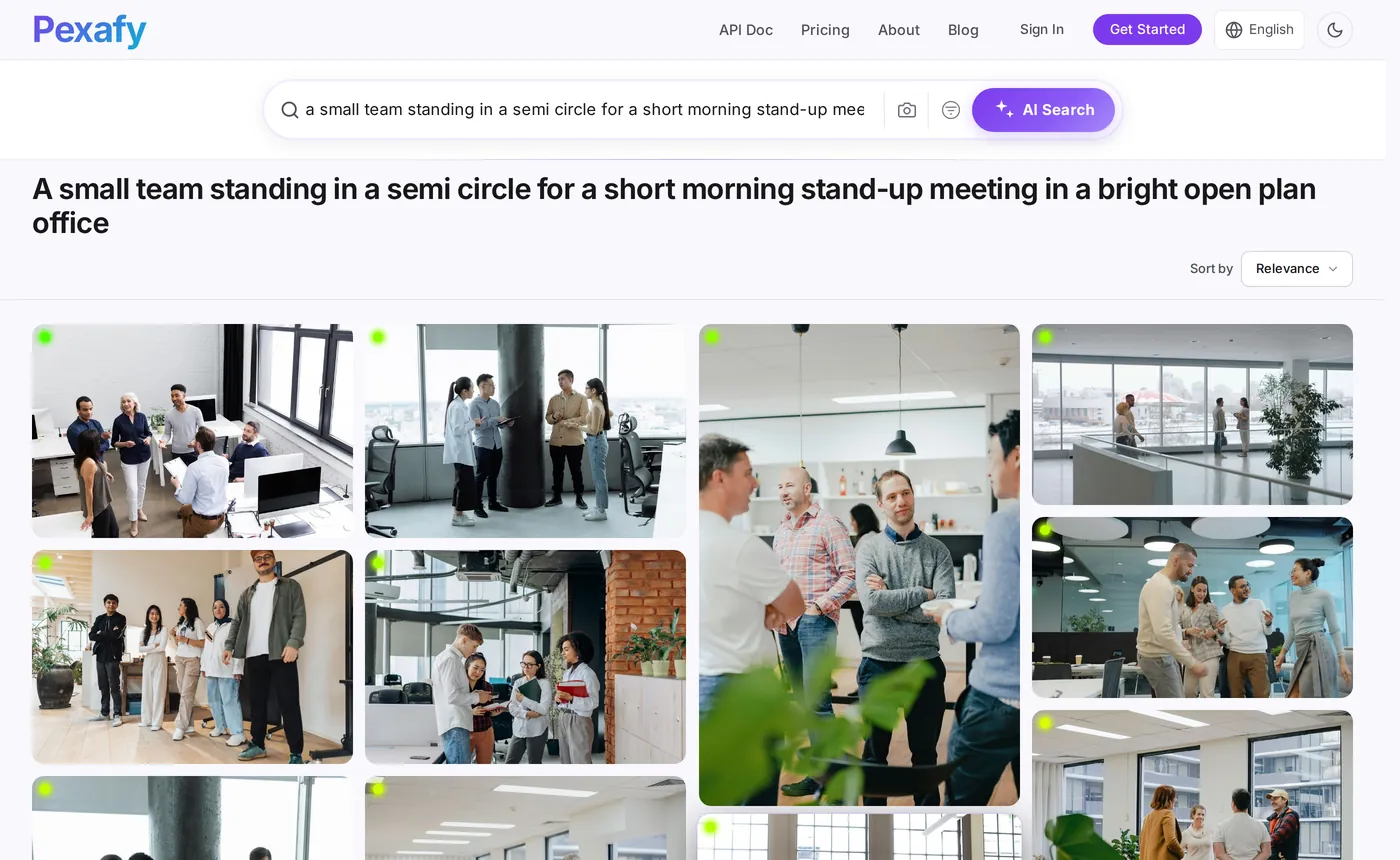
Затем сузьте выдачу с помощью фильтров, которые действительно важны для вёрстки статьи — и только их:
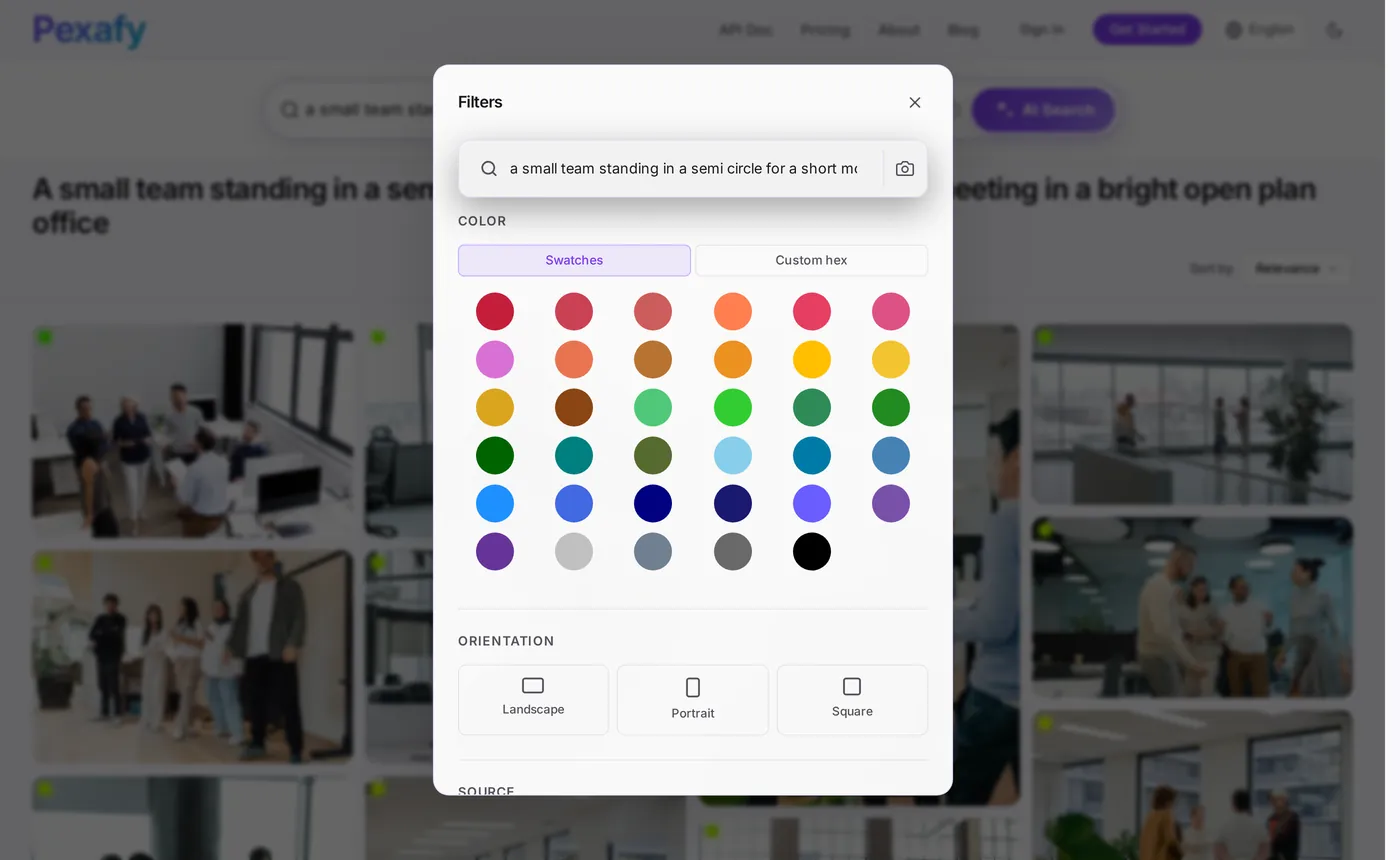
- Пишите предложение, а не ключевое слово. Субъект + действие + место + свет. До 500 символов на любом из более чем 100 языков.
- Отфильтруйте по альбомной ориентации для заглавного изображения, затем повторите поиск без фильтра для изображений внутри статьи, где портретная ориентация часто смотрится лучше.
- Откройте фото, чтобы получить готовую строку атрибуции, страницу оригинального источника и файл в полном разрешении.
- Используйте «похожие фото» на выбранном снимке, чтобы проиллюстрировать следующий раздел в том же визуальном регистре — тот же свет, та же обработка, другая сцена.
Промпт: превращаем черновик в поисковое предложение
Это шаг, который все делают неправильно, когда автоматизируют процесс. Название статьи подают прямо в строку поиска, а название — это как раз худший вход: оно абстрактно («The hidden cost of context switching»), и ни одна фотография на свете его не изображает. От модели вам нужен не пересказ — а операторское задание.
# system prompt
You are a photo editor. Read the article and write ONE search sentence
for a stock-photo engine that ranks by meaning, not by keywords.

Rules:
1. Describe a scene a camera could have taken: someone doing
   something, somewhere. Never name the topic itself ("fintech",
   "productivity", "SEO") — name what would be in the frame.
2. 12 to 25 words. Longer beats shorter: every concrete detail
   (light, place, gesture, time of day) sharpens the match.
3. No text, logos, brands, charts, screenshots or famous people.
   Free photo libraries have almost none of those.
4. No invisible metaphors ("growth", "synergy", "transformation").
5. Match the mood of the article: calm, tense, tired, celebratory.
6. Write the sentence in English even if the article is not.

Return JSON only:
{ "query": "…", "orientation": "landscape", "alt": "…" }
Правило 1 делает большую часть работы. Вот это же правило на трёх реальных черновиках — средний столбец — это то, что человек печатает второпях, правый столбец — то, что возвращает промпт:
| Статья о… | Поспешный запрос | Операторское задание |
|---|---|---|
| Почему ваш ежедневный стендап не работает | team meeting |
«a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office» |
| Сокращение онбординга с 6 недель до 9 дней | onboarding |
«a new employee on their first day at a desk, listening while a colleague leans in and points at their screen» |
| Скрытая цена переключения контекста | productivity |
«a tired developer rubbing their eyes in front of two monitors late in the evening, the office empty behind them» |
team meeting возвращает типовой сток с переговорной, который уже используют все
остальные авторы по вашей теме. Предложение из третьего столбца возвращает вот это за
155 миллисекунд:
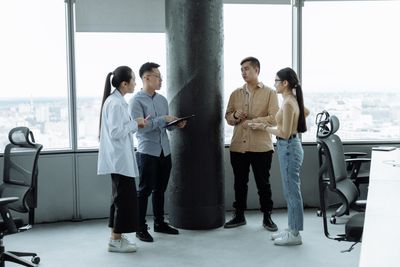

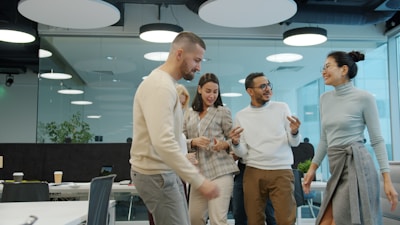
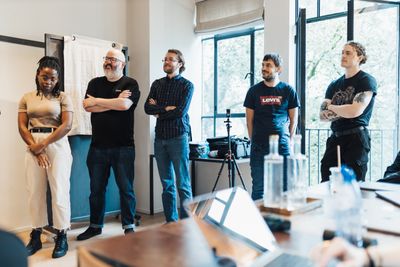
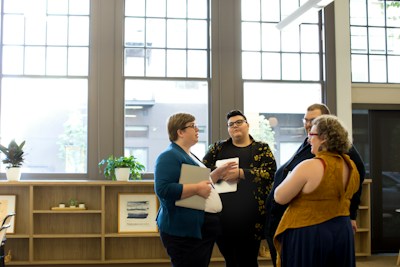
team meeting никогда не гарантирует.
Конвейер: черновик на входе, заглавное изображение с указанием авторства на выходе
Сорок строк, два вызова: один к модели за заданием, один к Pexafy за фото. Подключите это к хуку сохранения в вашей CMS, к сборке статического сайта или к скрипту, который обходит папку с файлами Markdown.
import json, os, requests
from anthropic import Anthropic

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
llm = Anthropic()  # ANTHROPIC_API_KEY берётся из окружения

def camera_brief(article: str) -> dict:
    # PHOTO_EDITOR = системный промпт выше
    msg = llm.messages.create(
        model="claude-sonnet-5",
        max_tokens=300,
        system=PHOTO_EDITOR,
        messages=[{ "role": "user", "content": article[:12000] }],
    )
    return json.loads(msg.content[0].text)

def illustrate(article: str) -> dict | None:
    brief = camera_brief(article)
    r = requests.get(
        SEARCH,
        headers={"X-Api-Key": os.environ["PEXAFY_API_KEY"]},
        params={
            "q": brief["query"],           # полное предложение
            "orientation": brief["orientation"],
            "per_page": 8,
            "score_threshold": 0.55,      # отбросить слабые совпадения
        },
        timeout=10,
    )
    hits = r.json()["data"]
    if not hits:                        # задание слишком узкое → расширить и повторить
        return None

    top = hits[0]
    return {
        "src":    top["urls"]["regular"],        # 1080px — размер для заглавного изображения
        "alt":    brief["alt"] or top["alt_description"],
        "credit": top["attribution"]["html"],   # готово к рендеру
        "width":  top["width"],
        "height": top["height"],
        "id":     top["photo_id"],           # сохранить: без повторов
    }
Три детали, которые превращают демо в то, что можно оставить работать без присмотра:
score_threshold— вернуть ничего лучше, чем вернуть плохое фото. Если задание оказалось слишком конкретным, расширьте его (уберите последнее уточнение) и повторите попытку один раз.- Сохраняйте
photo_id— одна строка в вашей базе данных, и ни у каких двух статей на вашем сайте никогда не будет одинакового заглавного изображения. Это ошибка, с которой все сталкиваются к тридцатому посту. - Один запрос на слот изображения — заглавное плюс три изображения в тексте — это четыре запроса на статью, или один, если брать четыре разных результата из одного и того же поиска.
Нет Python? Половина, отвечающая за поиск, — это одна строка, и каждый результат содержит одни и те же поля вне зависимости от библиотеки-источника:
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a tired developer rubbing their eyes at two monitors" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "per_page=6"

# → { "success": true, "data": [ … ], "meta": { "took_ms": 147 } }
Форма ответа — urls, width, photographer_full_name,
source, license_type, relevance_score,
attribution — одинакова для фото Pexels, фото Pixabay и фото Unsplash. Эту
нормализацию вам иначе пришлось бы писать и поддерживать самим; мы разобрали её поле за полем в
сравнении API бесплатных фотостоков.
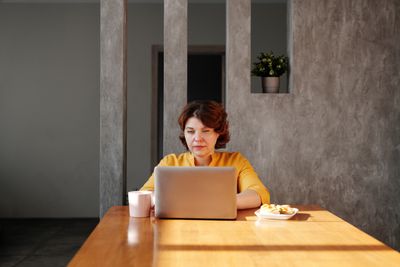
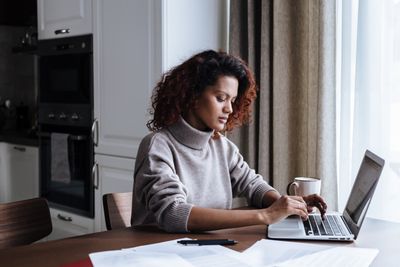
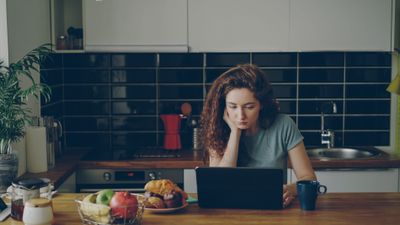
Второй раздел, второе задание, второй поиск — суть в том, что одна статья даёт несколько разных сцен вместо одного растянутого на четыре места фото:
Пусть агент сам выбирает картинку: MCP
Если модель уже пишет или редактирует черновик, самый чистый конвейер — это отсутствие конвейера: дайте агенту инструмент поиска и позвольте ему проиллюстрировать только что написанное в том же диалоге, пока контекст ещё под рукой.
Pexafy предоставляет размещённый сервер Model Context Protocol по адресу
mcp.pexafy.com/mcp. Три инструмента:
search_photos (предложение),
search_photos_by_image (референсное изображение, при желании вместе с
предложением — «как это, но на закате»), и get_similar_photos (ещё похожее на то,
что вы уже выбрали, — так вы сохраняете согласованность серии).
Настройки → Коннекторы → Добавить пользовательский коннектор
Name: Pexafy
URL:  https://mcp.pexafy.com/mcp
# затем войдите в свой аккаунт Pexafy, когда откроется окно
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# или закоммитьте это в репозиторий, чтобы получила вся команда — .mcp.json
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
С этого момента проиллюстрировать статью — это просьба, а не задача. Агент сам пишет операторское задание — он только что прочитал черновик, поэтому лучше кого бы то ни было способен описать сцену:
You  Вот черновик поста на этой неделе. Найди альбомное заглавное
     изображение и одно фото для раздела 2, и дай мне строки атрибуции.

Claude  → search_photos(
       q="a small team standing in a semi circle for a short morning
          stand-up meeting in a bright open plan office",
       orientation="landscape")
     ← 16 фото · 155 мс

     Заглавное  → Фото от Thirdman, Pexels · 6453×4302 · оценка 0.80
     Раздел     → Фото от Marcus Aurelius, Pexels · 6000×4000
     Оба без лицензионных отчислений, строки атрибуции ниже, готовы к вставке.
У Unsplash, Pexels, Pixabay и Openverse нет официального MCP-сервера — есть только созданные сообществом обёртки, которые нужно размещать и настраивать самостоятельно. Если ваш редакционный процесс уже выстроен вокруг агента, эта разница и есть интеграция.
Alt-текст, лицензия и скорость страницы
Картинка выбрана. Четыре вещи определяют, поможет ли она странице или незаметно навредит ей:
-
Пишите alt-текст для человека, а не для краулера. В каждом результате есть
alt_description— используйте его как черновик, а затем перепишите с учётом контекста вашего абзаца. «Четыре коллеги стоят на утренней встрече» лучше, чем набор ключевых слов, и это текст, который действительно прочитает вслух программа экранного доступа. Держите его в пределах ~125 символов; оставляйте пустым (alt="") только если изображение чисто декоративное. -
Указывайте авторство, даже когда никто этого не требует. Условия API Pexafy
не требуют указания атрибуции, и в каждом результате уже есть готовая строка
attribution.html— но лицензия исходной библиотеки всё равно регулирует использование этого фото, а видимая строка авторства сообщает читателю (и поисковой системе), что это настоящая фотография с настоящим автором. -
Отдавайте нужный размер.
urls.regular(1080 пикселей) — для заглавного изображения;urls.full— это файл на 2400 пикселей, который не нужен ни одной статье. Всегда указывайтеwidth/heightиз ответа, чтобы браузер зарезервировал место, — именно эта пара атрибутов отличает хороший показатель сдвига макета от плохого. Используйтеfetchpriority="high"для заглавного изображения иloading="lazy"для всего, что ниже первого экрана. -
Передавайте заглавное изображение в метаданные. Один и тот же URL должен
быть вашим
og:image, вашимtwitter:imageи свойствомimageструктурированных данныхArticle. Одно фото, три места, ноль дополнительной работы — и превью в соцсетях, которое больше не откатывается к вашему логотипу.
Сколько на самом деле стоят 100 статей в месяц
Предположим заглавное изображение плюс три изображения внутри статьи, то есть четыре поисковых запроса на пост — намеренно расточительный вариант, при котором для каждого места выполняется отдельный запрос вместо повторного использования результатов одного:
| Объём | Поисковых запросов в месяц | Тариф | Стоимость поиска |
|---|---|---|---|
| 20 статей | 80 | Бесплатный — 5 000 запросов/месяц | $0 |
| 100 статей | 400 | Бесплатный — 5 000 запросов/месяц | $0 |
| 1 000 статейагентство или целый портфель клиентов | 4 000 | Бесплатный — всё ещё в пределах 5 000 запросов/месяц | $0 |
Да — при объёмах контент-маркетинга месячная квота вообще не проблема, и мы предпочитаем прямо
об этом сказать, а не выдумывать повод заставить вас платить. Ограничение, с которым вы
реально столкнётесь, — это лимит в минуту. Бесплатный тариф допускает 20 запросов к
API в минуту; скрипт сборки, переиллюстрирующий 100 статей за один проход, отправляет 400
запросов так быстро, как позволяет цикл, — так что он либо проведёт двадцать минут под
троттлингом, либо начнёт собирать ошибки 429. Есть два выхода: распределить вызовы
во времени (одна команда sleep в цикле — и ночная задача этого даже не заметит) или
перейти на тариф, чей лимит скорости соответствует вашей сборке — Starter даёт 30 запросов в
минуту, Pro — 60. Выбирайте по пиковой нагрузке, а не по объёму.
Единственная другая статья расходов — один короткий вызов модели на статью для получения задания: несколько сотен токенов на входе, тридцать на выходе — это будет самая дешёвая позиция в любом контент-конвейере, который у вас есть. Сравните это с генерацией четырёх изображений на пост при четырёхстах изображениях в месяц, плюс попытки, которые не прошли отбор.
И то, что не отражается ни в одной таблице расходов: редактор перестаёт открывать пять вкладок. Вот в чём реальная экономия.
Источники и примечания
1 Статья 50 Закона ЕС об ИИ (AI Act) — обязательства по прозрачности для поставщиков и операторов определённых систем ИИ, применимые с 2 августа 2026 года. Поставщики систем, генерирующих синтетические аудио, изображения, видео или текст, обязаны маркировать результаты в машиночитаемом формате и делать их распознаваемыми как искусственно созданные; операторы обязаны раскрывать дипфейки и, в определённых случаях, — текст, сгенерированный ИИ и опубликованный для информирования общественности. «Digital Omnibus» (Регламент (ЕС) 2026/1744, действующий с 27 июля 2026 года) оставляет саму статью 50 без изменений, но даёт системам, уже присутствовавшим на рынке до 2 августа 2026 года, время до 2 декабря 2026 года на соответствие требованию машиночитаемой маркировки из статьи 50(2). Всё это обязывает поставщиков и операторов ИИ-систем — это не правило о том, какие изображения может публиковать блог.
2 Google считывает метаданные C2PA Content Credentials и собственный водяной знак SynthID, чтобы показывать происхождение изображения в разделе «Об этом изображении» в Поиске, Картинках и Lens. Это информация о происхождении медиа, а не штраф в ранжировании за контент, сгенерированный ИИ.
Источники проверены 15 августа 2026 года: Статья 50 AI Act · Европейская комиссия — FAQ по прозрачности · Google — метаданные изображений · Документация Pexafy API и MCP. Время поиска и результаты — это реальные ответы публичного API, зафиксированные в тот же день.
Часто задаваемые вопросы
Использовать ли сгенерированные ИИ изображения или реальные фото для статей блога?
Как автоматически найти изображение, соответствующее моей статье?
GET /api/v1/search/photos?q=…, примерно 150 мс, и каждый результат возвращается с размером, лицензией и готовой строкой атрибуции.Какой лучший промпт для превращения статьи в поисковый запрос по изображениям?
Нужно ли указывать авторство фото, используемых в статьях блога?
Может ли Claude или другой AI-агент находить фото для моей статьи?
mcp.pexafy.com/mcp. Добавьте его как пользовательский коннектор в Claude.ai или Claude Desktop и войдите через OAuth, либо добавьте его в Claude Code одной командой claude mcp add и API-ключом. Затем агент сам ищет по предложению, по референсному изображению или по похожим фото, пока черновик статьи остаётся в контексте.Как избежать того, чтобы во всех статьях блога использовалось одно и то же фото?
photo_id каждого опубликованного изображения и исключайте его при следующем запуске — достаточно одного столбца в вашей CMS. Это тот сбой, с которым сталкивается любой автоматизированный пайплайн примерно на тридцатой статье, и он незаметен, пока кто-то не пролистает ленту блога. Написание нового сценария для камеры для каждого раздела, вместо повторного использования заголовка статьи, довершает дело.

