Jak ilustrować każdy publikowany artykuł prawdziwymi zdjęciami, na dużą skalę
Dlaczego zespoły redakcyjne wracają do prawdziwej fotografii oraz dokładny pipeline — wraz z promptem — który zamienia gotowy szkic w podpisane zdjęcie główne w około 150 milisekund.
 Marouane Tijani
10 min czytania

Każdy publikowany przez Ciebie artykuł potrzebuje zdjęcia. To nie jest miły dodatek — obraz główny to to, co pokazuje podgląd społecznościowy, to, co czytelnik widzi przed pierwszym zdaniem, i to, co w pół sekundy mówi mu, czy tę stronę zrobił ktoś, komu zależało. Pomnóż to przez cztery zdjęcia na wpis i czterdzieści wpisów na kwartał, a „znajdź zdjęcie” przestaje być zadaniem i staje się problemem produkcyjnym.
Oto jak to rozwiązujemy: czego używać zamiast obrazów generowanych i dlaczego, oraz trzy sposoby włączenia Pexafy do przepływu pracy — ręcznie, przez API albo przez agenta AI — łącznie z promptem, który zamienia gotowy szkic w zdanie wyszukiwania, które rzeczywiście coś znajduje.
Dlaczego prawdziwe zdjęcia wciąż wygrywają z generowanymi
Wygenerowanie ilustracji jest łatwe i to jest właśnie problem. Cztery rzeczy zmieniły się między „obrazy AI to cheat kod” a dziś:
1 · Przy dużej skali wyszukiwanie jest szybsze niż generowanie
Generowanie to jeden prompt, oczekiwanie, sprawdzenie i — bądźmy szczerzy — jeszcze dwie lub trzy próby, zanim coś nada się do użytku. Wyszukiwanie semantyczne to jedno zapytanie, które wraca z szesnastoma kandydatami w około 150 milisekund, każdy już objęty licencją, już z podpisem, już we właściwym rozmiarze, z wymiarami zawartymi w odpowiedzi. Dla jednego zdjęcia różnica to kawa. Dla czterystu zdjęć na kwartał to różnica między przepływem pracy a etatem.
2 · Fotografia jest dokładna; generacja jest wiarygodna
Gdy tylko Twój artykuł dotyczy czegoś realnego — zawodu, sprzętu, miasta, gestu, materiału — wygenerowany obraz trafia w klimat, ale gubi szczegóły. Dłonie z sześcioma palcami to wersja żartobliwa; wersja kosztowna to nieistniejące narzędzie chirurgiczne, kokpit z wymyślonymi przyciskami albo „ulica w Lizbonie”, której nikt z Lizbony nie rozpozna. Czytelnicy, którzy znają temat, to zauważają — i zauważają to najpierw na zdjęciu.
3 · Wszyscy mają ten sam wygląd
Modele dyfuzyjne zbiegają do jednego stylu, a ściana ilustracji z miękkimi gradientami, przesadnym oświetleniem i podejrzaną symetrią czyta się dziś jako wypełniacz. To postrzeganie jest realnym kosztem: nie karą, tylko sygnałem. Prawdziwa fotografia — ziarno, niewygodne krzesło, ktoś w połowie zdania — czyta się jako reportaż.
4 · A teraz przychodzą z etykietą
To bardziej kontekst niż argument, ale taki jest kierunek zmian. Od 2 sierpnia 2026 artykuł 50 unijnego AI Act wymaga od dostawców systemów generatywnych oznaczania syntetycznych wyników w formacie odczytywalnym maszynowo, a od podmiotów wdrażających — ujawniania deepfake’ów.1 Po stronie wykrywania Google odczytuje poświadczenia treści C2PA i własny znak wodny SynthID, by odpowiedzieć na pytanie „czy to wygenerowała AI?” w Search, Images i Lens.2 Nic z tego nie jest zasadą dotyczącą tego, jakie obrazy wolno publikować blogowi, i nic z tego nie kosztuje Cię pozycji w rankingu. To, co się zmieniło, dzieje się na dalszym etapie: pochodzenie zdjęcia na szczycie Twojego artykułu to teraz coś, co czytelnik może sprawdzić w dwóch kliknięciach, bez pytania Ciebie. Licencjonowana fotografia nie ma nic do zadeklarowania.
Kiedy obrazy generowane są właściwym wyborem. Diagramy koncepcyjne i schematy. Scena, której nie da się sfotografować (produkt, który jeszcze nie istnieje, abstrakcyjny mechanizm, przyszłe miasto). Własny styl ilustracji marki, który chcesz powtarzać w każdym wpisie. I wszystko, gdzie obraz jest celowo rozumiany jako ilustracja, a nie jako dowód. Używaj obu — przestań tylko traktować generowanie jako domyślną odpowiedź na „potrzebuję zdjęcia ludzi na spotkaniu”.
Trzy sposoby ilustrowania, w zależności od wolumenu
Ten sam silnik, ten sam katalog — 9M+ darmowych zdjęć z 9 bibliotek — i trzy punkty wejścia. Wybieraj według liczby publikowanych artykułów, nie według poziomu technicznego.
| Punkt wejścia | Najlepsze dlakogo i ile | Na artykuł | Czego potrzebujesz |
|---|---|---|---|
| Interfejs wyszukiwania | Redaktorzy, jeden wpis naraz — do ~20/miesiąc | ~30 sekund | Przeglądarka. Do wyszukiwania konto nie jest potrzebne. |
| REST API | CMS, build strony statycznej, partia szkiców | ~1 zapytanie, ~150 ms | Klucz API. 5000 zapytań/miesiąc za darmo, 20/min. |
| Serwer MCP | Agent AI, który pisze lub edytuje szkic | W tej samej rozmowie | Jeden adres URL łącznika, OAuth albo klucz. |
Wszystkie trzy dzielą jeden katalog i jedno rankingowanie, więc zdjęcie znalezione przez redaktora w interfejsie to to samo zdjęcie, z tym samym identyfikatorem, które API zwraca Twojemu skryptowi budującemu.
Jeden artykuł, 30 sekund: interfejs wyszukiwania
Opisz scenę tak, jak opisałbyś ją fotografowi, pełnym zdaniem, we własnym języku. Nie
team meeting —
„a small team standing in a semi circle for a short morning stand-up meeting in a bright
open plan office”. Każdy dodatkowy konkretny szczegół zawęża zbiór wyników zamiast go
opróżniać, ponieważ silnik ranguje według znaczenia, a nie dopasowując Twoje słowa do czyichś
tagów.
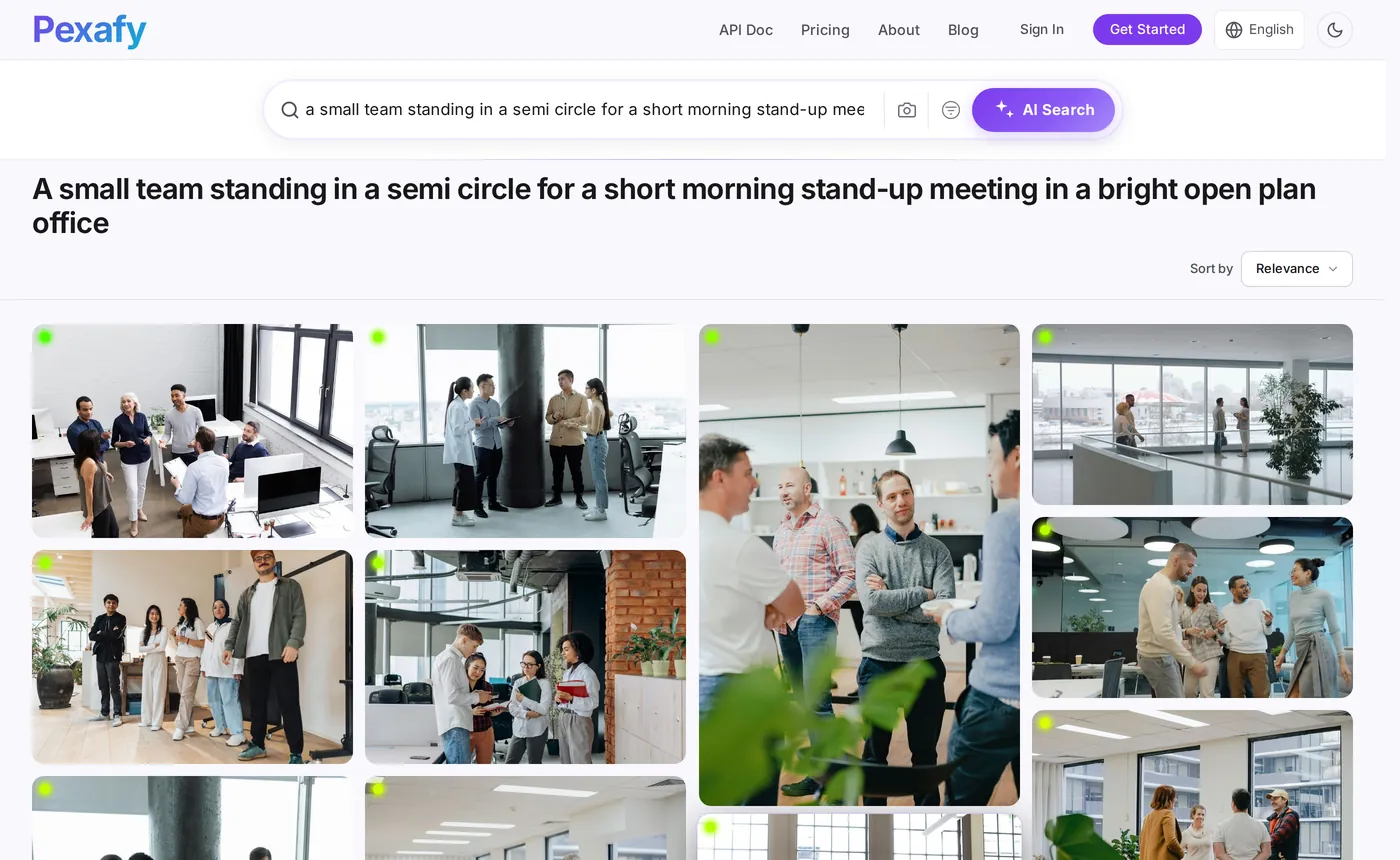
Następnie zawęź je filtrami, które mają znaczenie dla układu artykułu — i tylko nimi:
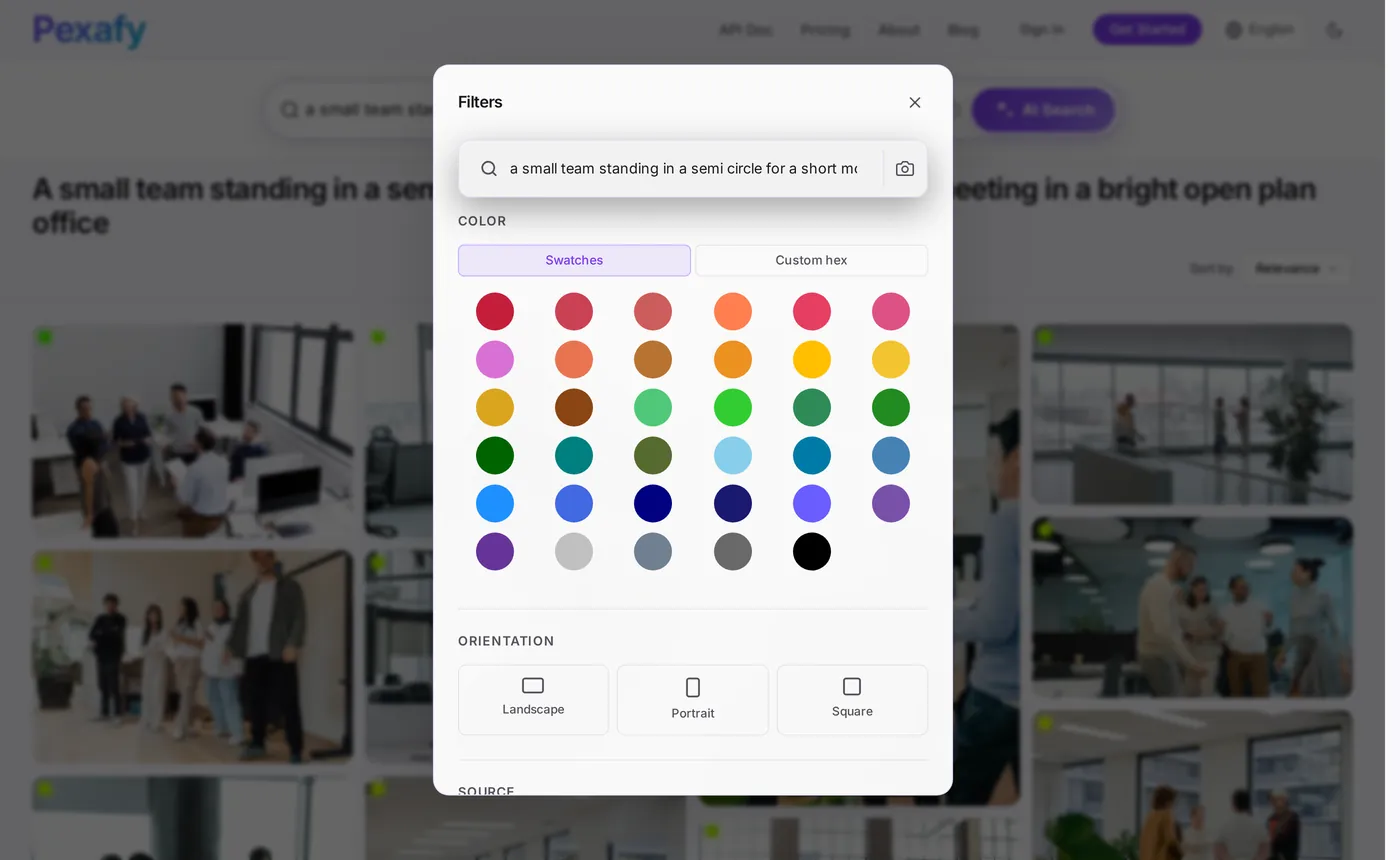
- Napisz zdanie, nie słowo kluczowe. Podmiot + czynność + miejsce + światło. Do 500 znaków, w dowolnym ze 100+ języków.
- Filtruj do orientacji poziomej dla obrazu głównego, potem uruchom ponownie bez filtra dla zdjęć w treści artykułu, gdzie orientacja pionowa często sprawdza się lepiej.
- Otwórz zdjęcie, by uzyskać gotową linię atrybucji, oryginalną stronę źródłową i plik w pełnej rozdzielczości.
- Skorzystaj z „podobnych zdjęć” przy wybranym obrazie, by zilustrować kolejną sekcję w tym samym rejestrze wizualnym — to samo światło, ta sama tonacja, inna scena.
Prompt: zamień szkic w zdanie wyszukiwania
To krok, w którym wszyscy się mylą przy automatyzacji. Wrzucają tytuł artykułu wprost do pola wyszukiwania, a tytuł jest dokładnie złym wejściem: jest abstrakcyjny („The hidden cost of context switching”) i żadna fotografia na świecie tego nie przedstawia. To, czego chcesz od modelu, to nie streszczenie — to brief dla fotografa.
# system prompt
You are a photo editor. Read the article and write ONE search sentence
for a stock-photo engine that ranks by meaning, not by keywords.

Rules:
1. Describe a scene a camera could have taken: someone doing
   something, somewhere. Never name the topic itself ("fintech",
   "productivity", "SEO") — name what would be in the frame.
2. 12 to 25 words. Longer beats shorter: every concrete detail
   (light, place, gesture, time of day) sharpens the match.
3. No text, logos, brands, charts, screenshots or famous people.
   Free photo libraries have almost none of those.
4. No invisible metaphors ("growth", "synergy", "transformation").
5. Match the mood of the article: calm, tense, tired, celebratory.
6. Write the sentence in English even if the article is not.

Return JSON only:
{ "query": "…", "orientation": "landscape", "alt": "…" }
Zasada 1 wykonuje większość pracy. Oto ta sama zasada zastosowana do trzech prawdziwych szkiców — środkowa kolumna to to, co człowiek wpisuje w pośpiechu, prawa kolumna to to, co zwraca prompt:
| Artykuł dotyczy… | Zapytanie w pośpiechu | Brief dla fotografa |
|---|---|---|
| Dlaczego Twój codzienny stand-up jest zepsuty | team meeting |
„a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office” |
| Skrócenie onboardingu z 6 tygodni do 9 dni | onboarding |
„a new employee on their first day at a desk, listening while a colleague leans in and points at their screen” |
| Ukryty koszt przełączania kontekstu | productivity |
„a tired developer rubbing their eyes in front of two monitors late in the evening, the office empty behind them” |
team meeting zwraca ogólne zdjęcie sali konferencyjnej, którego na Twój temat już
używa każdy inny. Zdanie z trzeciej kolumny zwraca to, w 155 milisekund:
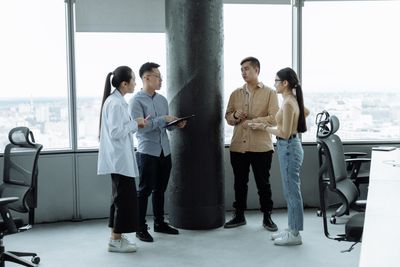

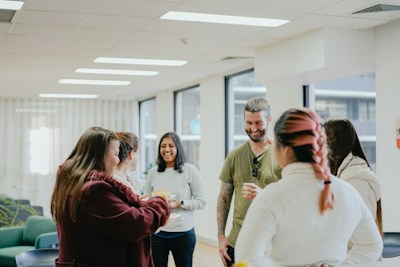
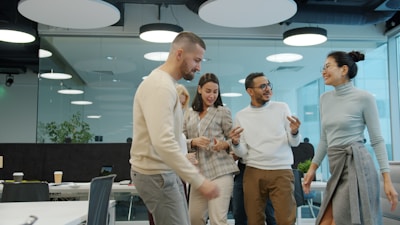
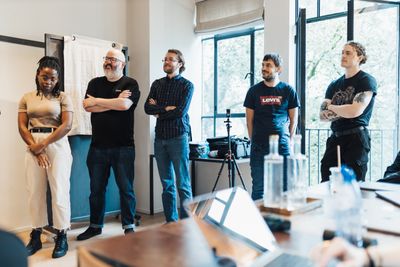
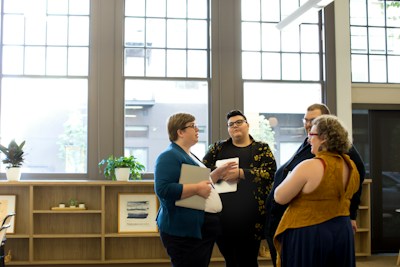
team meeting nigdy nie gwarantuje.
Pipeline: szkic na wejściu, podpisane zdjęcie główne na wyjściu
Czterdzieści linii, dwa wywołania: jedno do modelu po brief, jedno do Pexafy po zdjęcie. Umieść to w hooku zapisu swojego CMS-a, w builda strony statycznej, albo w skrypcie przechodzącym przez folder plików Markdown.
import json, os, requests
from anthropic import Anthropic

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
llm = Anthropic()  # ANTHROPIC_API_KEY ze zmiennych środowiskowych

def camera_brief(article: str) -> dict:
    # PHOTO_EDITOR = powyższy system prompt
    msg = llm.messages.create(
        model="claude-sonnet-5",
        max_tokens=300,
        system=PHOTO_EDITOR,
        messages=[{ "role": "user", "content": article[:12000] }],
    )
    return json.loads(msg.content[0].text)

def illustrate(article: str) -> dict | None:
    brief = camera_brief(article)
    r = requests.get(
        SEARCH,
        headers={"X-Api-Key": os.environ["PEXAFY_API_KEY"]},
        params={
            "q": brief["query"],           # pełne zdanie
            "orientation": brief["orientation"],
            "per_page": 8,
            "score_threshold": 0.55,      # odrzuć słabe dopasowania
        },
        timeout=10,
    )
    hits = r.json()["data"]
    if not hits:                        # brief zbyt wąski → rozszerz, spróbuj ponownie
        return None

    top = hits[0]
    return {
        "src":    top["urls"]["regular"],        # 1080px — rozmiar obrazu głównego
        "alt":    brief["alt"] or top["alt_description"],
        "credit": top["attribution"]["html"],   # gotowe do renderowania
        "width":  top["width"],
        "height": top["height"],
        "id":     top["photo_id"],           # zapisz to: bez powtórek
    }
Trzy szczegóły, które zamieniają demo w coś, co można zostawić działające:
score_threshold— nie zwrócić nic jest lepsze niż zwrócić złe zdjęcie. Jeśli brief był zbyt konkretny, rozszerz go (usuń ostatnią klauzulę) i spróbuj ponownie raz.- Zapisz
photo_id— jedna linia w Twojej bazie danych, i żadne dwa artykuły na Twojej stronie nigdy nie dzielą tego samego zdjęcia głównego. To jest błąd, na który wpada każdy przy wpisie numer trzydzieści. - Jedno zapytanie na miejsce dla zdjęcia — obraz główny plus trzy zdjęcia sekcji to cztery zapytania na artykuł, albo jedno, jeśli weźmiesz cztery różne wyniki z tego samego wyszukiwania.
Bez Pythona? Cała część związana z wyszukiwaniem to jedna linia, a każdy wynik niesie te same pola, niezależnie z jakiej biblioteki pochodzi:
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a tired developer rubbing their eyes at two monitors" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "per_page=6"

# → { "success": true, "data": [ … ], "meta": { "took_ms": 147 } }
Kształt odpowiedzi — urls, width, photographer_full_name,
source, license_type, relevance_score,
attribution — jest identyczny dla zdjęcia z Pexels, zdjęcia z Pixabay i zdjęcia z
Unsplash. Ta normalizacja to część, którą musiałbyś inaczej napisać i utrzymywać samodzielnie;
rozłożyliśmy ją pole po polu w
porównaniu darmowych API zdjęć stockowych.
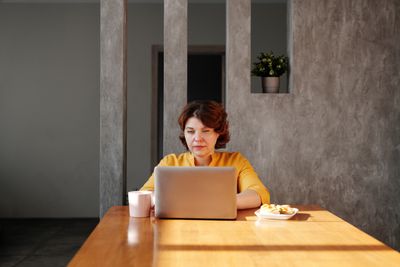
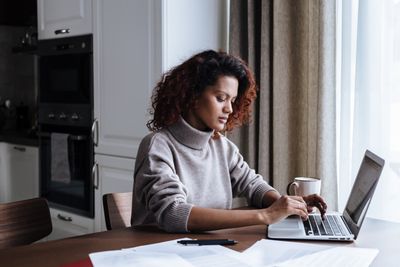
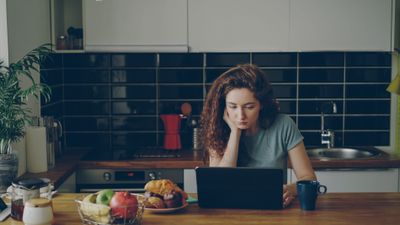
Druga sekcja, drugi brief, drugie wyszukiwanie — chodzi o to, że jeden artykuł daje kilka odrębnych scen zamiast jednego zdjęcia rozciągniętego cztery razy:
Niech agent wybierze zdjęcie: MCP
Jeśli model już pisze lub edytuje szkic, najczystszy pipeline to brak pipeline’u: daj agentowi narzędzie wyszukiwania i pozwól mu zilustrować to, co właśnie napisał, w tej samej rozmowie, póki wciąż ma kontekst.
Pexafy udostępnia hostowany serwer Model Context Protocol pod adresem
mcp.pexafy.com/mcp. Trzy narzędzia:
search_photos (zdanie),
search_photos_by_image (obraz referencyjny, opcjonalnie plus zdanie — „jak to, ale
o zachodzie słońca”) oraz get_similar_photos (więcej podobnych do już wybranego zdjęcia,
co pozwala utrzymać spójność serii).
Settings → Connectors → Add custom connector
Name: Pexafy
URL:  https://mcp.pexafy.com/mcp
# następnie zaloguj się na swoje konto Pexafy, gdy otworzy się okno
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# albo dodaj to do repozytorium, żeby dostał to cały zespół — .mcp.json
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
Od tego momentu zilustrowanie artykułu to zdanie, nie zadanie. Agent sam pisze swój brief dla fotografa — właśnie przeczytał szkic, więc jest lepiej przygotowany niż ktokolwiek inny, by opisać scenę:
Ty  Oto szkic wpisu na ten tydzień. Znajdź poziomy obraz główny
     i jedno zdjęcie do sekcji 2, i podaj mi linie z podpisami.

Claude  → search_photos(
       q="a small team standing in a semi circle for a short morning
          stand-up meeting in a bright open plan office",
       orientation="landscape")
     ← 16 zdjęć · 155 ms

     Obraz główny → Zdjęcie Thirdman na Pexels · 6453×4302 · wynik 0.80
     Sekcja       → Zdjęcie Marcus Aurelius na Pexels · 6000×4000
     Oba na darmowej licencji, linie atrybucji poniżej, gotowe do wklejenia.
Unsplash, Pexels, Pixabay i Openverse nie mają oficjalnego serwera MCP — istnieją jedynie wrappery społecznościowe, które musisz sam hostować i kluczować. Jeśli Twój przepływ pracy redakcyjnej już działa przez agenta, ta różnica jest integracją.
Tekst alternatywny, licencja i szybkość strony
Zdjęcie zostało wybrane. Cztery rzeczy decydują o tym, czy pomaga stronie, czy ją po cichu szkodzi:
-
Napisz tekst alternatywny dla osoby, nie dla crawlera. Każdy wynik zawiera
alt_description— użyj go jako szkicu, a potem przepisz w kontekście Twojego akapitu. „Czterech współpracowników stojących na porannym spotkaniu” bije sałatkę ze słów kluczowych, i to jest tekst, który czytnik ekranu faktycznie odczyta. Trzymaj się poniżej ~125 znaków; zostaw pusty (alt="") tylko gdy obraz jest czysto dekoracyjny. -
Zamieszczaj podpis, nawet gdy nic Cię do tego nie zmusza. Atrybucja nie jest
wymagana przez warunki API Pexafy, a każdy wynik niesie gotowy ciąg
attribution.html— ale licencja dołączona przez oryginalną bibliotekę wciąż reguluje Twoje użycie tego zdjęcia, a widoczna linia z podpisem to coś, co mówi czytelnikowi (i wyszukiwarce odpowiedzi), że to prawdziwa fotografia z prawdziwym autorem. -
Serwuj właściwy rozmiar.
urls.regular(1080 px) to obraz główny;urls.fullto plik 2400 px, którego żaden artykuł nie potrzebuje. Zawsze przesyłajwidth/heightz odpowiedzi, aby przeglądarka zarezerwowała miejsce — ta jedna para atrybutów to różnica między dobrym a złym wynikiem przesunięcia układu. Użyjfetchpriority="high"na obrazie głównym,loading="lazy"na wszystkim poniżej pierwszego ekranu. -
Nakarm tym zdjęciem swoje metadane. Ten sam adres URL powinien być Twoim
og:image, Twoimtwitter:imagei właściwościąimageTwoich danych strukturalnychArticle. Jedno zdjęcie, trzy miejsca, zero dodatkowej pracy — i podgląd społecznościowy, który przestaje przełączać się na Twoje logo.
Ile faktycznie kosztuje 100 artykułów miesięcznie
Załóżmy obraz główny plus trzy zdjęcia w treści, czyli cztery zapytania wyszukiwania na wpis — wersja celowo rozrzutna, w której uruchamiasz osobne zapytanie na każde miejsce, zamiast ponownie wykorzystywać wyniki z jednego:
| Wolumen | Zapytania wyszukiwania / miesiąc | Plan | Koszt wyszukiwania |
|---|---|---|---|
| 20 artykułów | 80 | Darmowy — 5000 zapytań/miesiąc | $0 |
| 100 artykułów | 400 | Darmowy — 5000 zapytań/miesiąc | $0 |
| 1000 artykułówagencja albo całe portfolio klientów | 4000 | Darmowy — wciąż w granicach 5000 zapytań/miesiąc | $0 |
Tak — miesięczny limit nie jest problemem przy wolumenach typowych dla marketingu treści, i
wolimy to powiedzieć wprost, niż wymyślać powód, żebyś płacił. Limit, na który
faktycznie natrafisz, to limit na minutę. Darmowy plan pozwala na 20 zapytań API na
minutę; skrypt budujący, który ponownie ilustruje 100 artykułów w jednym przebiegu, wystrzeliwuje
400 zapytań tak szybko, jak pozwala na to Twoja pętla, więc albo spędza dwadzieścia minut
zdławiony, albo zaczyna zbierać błędy 429. Dwa wyjścia: rozłóż wywołania w czasie
(jeden sleep w pętli, a zadanie nocne niczego nie zauważy) albo przejdź na plan,
którego limit prędkości pasuje do Twojego builda — Starter to 30 zapytań/minutę, Pro — 60. Wybieraj
według szczytu, nie według wolumenu.
Jedyna dodatkowa pozycja to jedno krótkie wywołanie modelu na artykuł, by wygenerować brief — kilkaset tokenów na wejściu, trzydzieści na wyjściu, co będzie najtańszą pozycją w każdym pipeline’ie treści, jaki posiadasz. Porównaj to z generowaniem czterech obrazów na wpis, przy czterystu obrazach miesięcznie, plus próbami, które się nie udały.
A część, która nie pojawia się w tabeli kosztów: redaktor przestaje otwierać pięć zakładek. To jest faktyczna oszczędność.
Źródła i przypisy
1 Unijny AI Act, artykuł 50 — obowiązki przejrzystości dla dostawców i podmiotów wdrażających określone systemy AI, obowiązujące od 2 sierpnia 2026. Dostawcy systemów generujących syntetyczne audio, obraz, wideo lub tekst muszą oznaczać wyniki w formacie odczytywalnym maszynowo i sprawiać, by były wykrywalne jako sztucznie wygenerowane; podmioty wdrażające muszą ujawniać deepfake’i oraz, w określonych przypadkach, tekst wygenerowany przez AI publikowany w celu informowania społeczeństwa. Digital Omnibus (rozporządzenie (UE) 2026/1744, obowiązujące od 27 lipca 2026) nie zmienia samego artykułu 50, ale daje systemom obecnym na rynku przed 2 sierpnia 2026 czas do 2 grudnia 2026 na spełnienie wymogu oznaczania odczytywalnego maszynowo z artykułu 50(2). Wszystko to wiąże dostawców i podmioty wdrażające AI — nie jest to zasada dotycząca tego, jakie obrazy wolno publikować blogowi.
2 Google odczytuje poświadczenia treści C2PA i własny znak wodny SynthID, by pokazać pochodzenie w sekcji O tym obrazie w Search, Images i Lens. To kwestia pochodzenia treści, nie kara rankingowa za treści generowane przez AI.
Źródła sprawdzone 15 sierpnia 2026: AI Act, artykuł 50 · Komisja Europejska — FAQ o przejrzystości · Google — metadane obrazów · Dokumentacja API i MCP Pexafy. Czasy wyszukiwania i wyniki to prawdziwe odpowiedzi z publicznego API, zarejestrowane tego samego dnia.
Najczęściej zadawane pytania
Czy do artykułów na blogu powinienem używać obrazów generowanych przez AI, czy prawdziwych zdjęć?
Jak automatycznie znaleźć obraz pasujący do mojego artykułu?
GET /api/v1/search/photos?q=…, około 150 ms, a każdy wynik zawiera rozmiar, licencję oraz gotowy ciąg do atrybucji.Jaki jest najlepszy prompt do zamiany artykułu w zapytanie wyszukiwania obrazów?
Czy muszę podpisywać zdjęcia, których używam we wpisach na blogu?
Czy Claude lub inny agent AI może znaleźć zdjęcia do mojego artykułu?
mcp.pexafy.com/mcp. Dodaj go jako niestandardowy konektor w Claude.ai lub Claude Desktop i zaloguj się przez OAuth, albo dodaj go do Claude Code jedną komendą claude mcp add wraz z kluczem API. Agent może następnie wyszukiwać po zdaniu, po zdjęciu referencyjnym lub sam znajdować podobne zdjęcia, mając wciąż Twój szkic w kontekście.Jak sprawić, by na moim blogu nie każdy artykuł używał tego samego zdjęcia?
photo_id każdego publikowanego zdjęcia i wykluczaj je przy kolejnym uruchomieniu — wystarczy jedna kolumna w CMS. To błąd, na który natrafia każdy zautomatyzowany pipeline mniej więcej przy trzydziestym wpisie, i jest niewidoczny, dopóki ktoś nie przewinie indeksu Twojego bloga. Resztę załatwia tworzenie nowego camera briefu dla każdej sekcji, zamiast ponownego wykorzystywania tytułu artykułu.

