Cómo Ilustrar Cada Artículo Que Publicas — Con Fotos Reales, a Escala
Por qué los equipos editoriales están volviendo a la fotografía real, y el flujo exacto — prompt incluido — que convierte un borrador terminado en una imagen de portada acreditada en unos 150 milisegundos.
 Marouane Tijani
10 min de lectura

Cada artículo que publicas necesita una imagen. No es un extra opcional — la imagen principal es lo que muestra la vista previa social, lo que ve el lector antes de la primera frase, y lo que le dice en medio segundo si esta página la hizo alguien a quien le importaba. Multiplica eso por cuatro imágenes por entrada y cuarenta entradas al trimestre, y «buscar una foto» deja de ser una tarea y se convierte en un problema de flujo de trabajo.
Así es como lo resolvemos: qué usar en lugar de imágenes generadas y por qué, y las tres formas de integrar Pexafy en el flujo de trabajo — a mano, por API, o mediante un agente de IA — incluyendo el prompt que convierte un borrador terminado en una frase de búsqueda que realmente encuentra algo.
Por qué las fotos reales siguen ganando a las generadas
Generar una ilustración es fácil, y ese es precisamente el problema. Cuatro cosas cambiaron entre «las imágenes de IA son un truco» y hoy:
1 · A gran volumen, buscar es más rápido que generar
Una generación es un prompt, una espera, una inspección y —seamos sinceros— dos o tres intentos más antes de que uno sea utilizable. Una búsqueda semántica es una única solicitud que devuelve dieciséis candidatos en unos 150 milisegundos, cada uno ya licenciado, ya con crédito, ya dimensionado, con sus medidas en la respuesta. Para una imagen, la diferencia es un café. Para cuatrocientas imágenes al trimestre, es la diferencia entre un flujo de trabajo y un trabajo.
2 · Una fotografía es precisa; una generación es verosímil
En el momento en que tu artículo trata sobre algo real —una profesión, un equipo, una ciudad, un gesto, un material—, una imagen generada acierta la sensación y falla en los detalles. Las manos con seis dedos son la versión broma; la versión cara es un instrumento quirúrgico que no existe, una cabina con mandos inventados, o una «calle de Lisboa» que nadie de Lisboa reconoce. Los lectores que conocen tu tema se dan cuenta, y se fijan primero en la imagen.
3 · Todos tienen el mismo aspecto
Los modelos de difusión convergen en un estilo de casa, y un muro de ilustraciones de degradado suave, sobreiluminadas y sospechosamente simétricas ahora se lee como relleno. Esa percepción es el coste real: no una penalización, una señal. Una fotografía real —con grano, una silla incómoda, alguien a mitad de frase— se lee como reportaje.
4 · Y ahora llegan con una etiqueta pegada
Este punto es más bien contexto que argumento, pero marca la dirección de los acontecimientos. Desde el 2 de agosto de 2026, el artículo 50 de la Ley de IA de la UE exige a los proveedores de sistemas generativos marcar las salidas sintéticas en un formato legible por máquina, y a los desplegadores revelar los deepfakes.1 Por el lado de la detección, Google lee las Credenciales de Contenido C2PA y su propia marca de agua SynthID para responder a «¿es esto generado por IA?» dentro de Search, Images y Lens.2 Nada de esto es una norma sobre qué imágenes puede publicar un blog, y nada de esto te cuesta posiciones en el ranking. Lo que ha cambiado está aguas abajo: la procedencia de la imagen que encabeza tu artículo es ahora algo que un lector puede comprobar en dos clics, sin preguntarte. Una fotografía licenciada no tiene nada que declarar.
Cuándo las imágenes generadas sí son la opción correcta. Diagramas conceptuales y esquemas. Una escena que no se puede fotografiar (un producto que aún no existe, un mecanismo abstracto, una ciudad futura). Un estilo de ilustración propio que quieres repetir en cada entrada. Y cualquier caso en que la imagen se entienda deliberadamente como ilustración y no como evidencia. Usa ambas cosas — solo deja de usar la generación por defecto para «necesito una foto de gente en una reunión».
Tres formas de ilustrar, según tu volumen
Mismo motor, mismo catálogo — 9M+ fotos de uso libre de 9 bibliotecas— y tres puntos de entrada. Elige según cuántos artículos publicas, no según lo técnico que seas.
| Punto de entrada | Ideal paraquién y cuánto | Por artículo | Qué necesitas |
|---|---|---|---|
| Interfaz de búsqueda | Editores, una entrada a la vez — hasta ~20/mes | ~30 segundos | Un navegador. No hace falta cuenta para buscar. |
| API REST | Un CMS, una compilación de sitio estático, un lote de borradores | ~1 solicitud, ~150 ms | Una clave de API. 5000 solicitudes/mes gratis, 20/min. |
| Servidor MCP | El agente de IA que redacta o edita el borrador | Dentro de la misma conversación | Una URL de conector, OAuth o una clave. |
Los tres comparten un catálogo y un ranking, de modo que una foto encontrada por un editor en la interfaz es la misma foto, con el mismo identificador, que la API devuelve a tu script de compilación.
Un artículo, 30 segundos: la interfaz de búsqueda
Describe la escena como se la describirías a un fotógrafo, en una frase completa, en tu propio
idioma. No team meeting —
«a small team standing in a semi circle for a short morning stand-up meeting in a bright
open plan office». Cada detalle concreto adicional acota el conjunto de resultados en lugar
de vaciarlo, porque el motor ordena por significado en lugar de comparar tus palabras con las
etiquetas de otra persona.
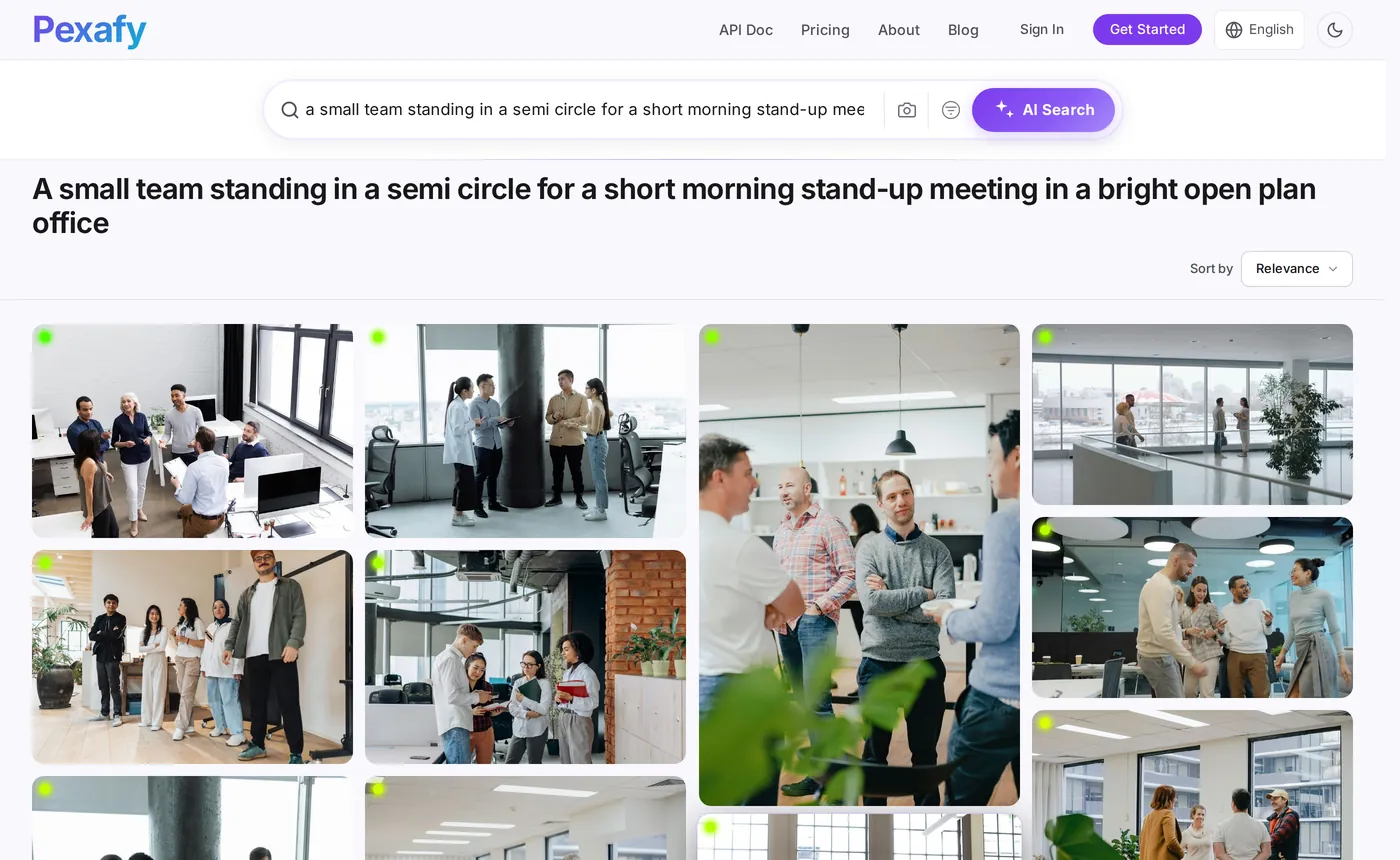
Luego acótala con los filtros que importan para el diseño de un artículo — y solo esos:
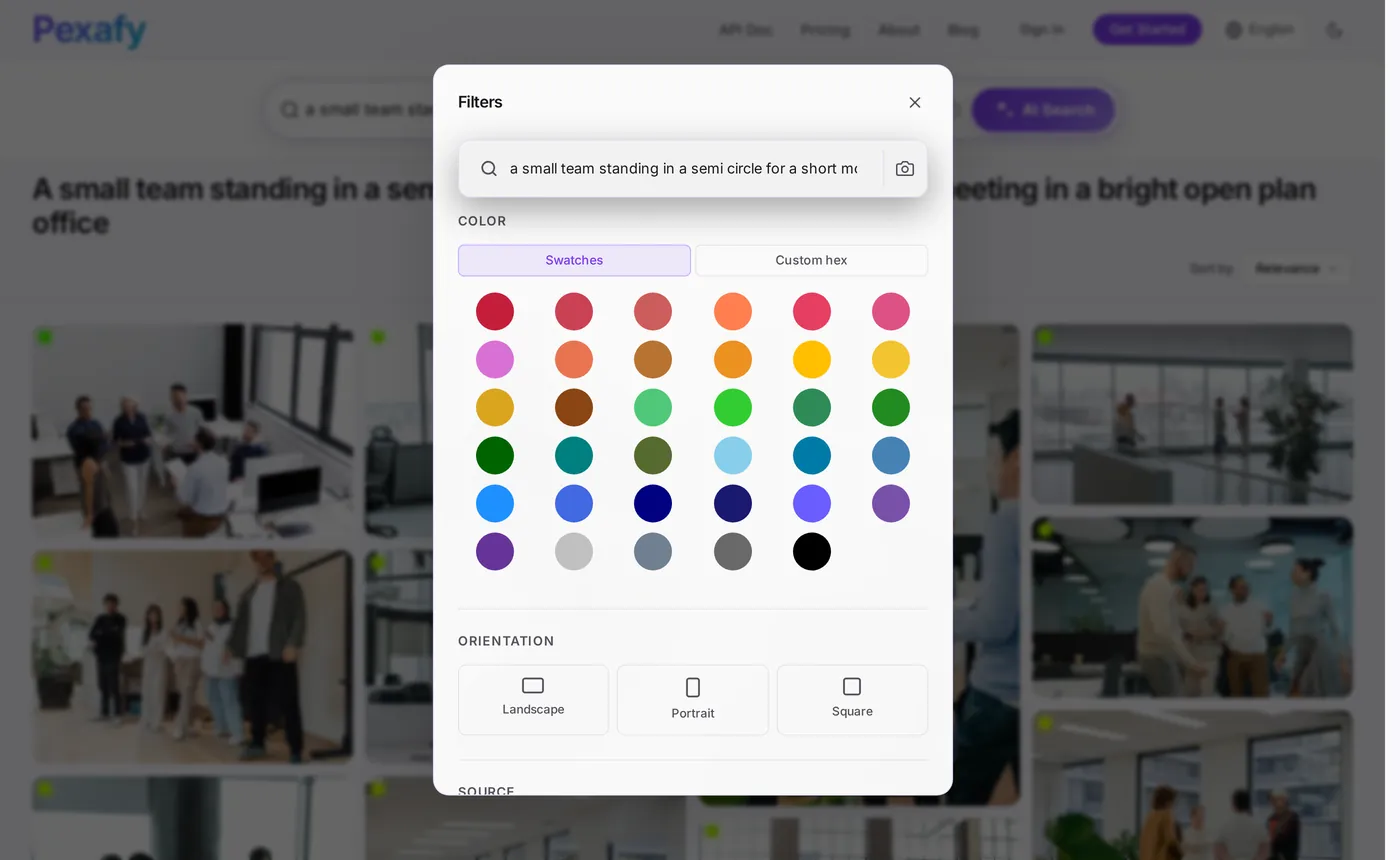
- Escribe la frase, no la palabra clave. Sujeto + acción + lugar + luz. Hasta 500 caracteres, en cualquiera de más de 100 idiomas.
- Filtra por horizontal para la imagen principal, y luego vuelve a ejecutar sin el filtro para las imágenes dentro del artículo, donde la vertical a menudo se lee mejor.
- Abre la foto para obtener la línea de atribución ya lista, la página de origen original y el archivo a resolución completa.
- Usa «fotos similares» en la que elegiste para ilustrar la siguiente sección en el mismo registro visual — misma luz, mismo tratamiento, escena distinta.
El prompt: convertir un borrador en una frase de búsqueda
Este es el paso en el que todo el mundo se equivoca al automatizar. Meten el título del artículo directamente en el cuadro de búsqueda, y el título es exactamente la entrada equivocada: es abstracto («El coste oculto del cambio de contexto») y ninguna fotografía sobre la faz de la tierra lo representa. Lo que quieres del modelo no es un resumen — es un brief de cámara.
# system prompt
You are a photo editor. Read the article and write ONE search sentence
for a stock-photo engine that ranks by meaning, not by keywords.

Rules:
1. Describe a scene a camera could have taken: someone doing
   something, somewhere. Never name the topic itself ("fintech",
   "productivity", "SEO") — name what would be in the frame.
2. 12 to 25 words. Longer beats shorter: every concrete detail
   (light, place, gesture, time of day) sharpens the match.
3. No text, logos, brands, charts, screenshots or famous people.
   Free photo libraries have almost none of those.
4. No invisible metaphors ("growth", "synergy", "transformation").
5. Match the mood of the article: calm, tense, tired, celebratory.
6. Write the sentence in English even if the article is not.

Return JSON only:
{ "query": "…", "orientation": "landscape", "alt": "…" }
La regla 1 hace la mayor parte del trabajo. Aquí está la misma regla aplicada a tres borradores reales — la columna del medio es lo que escribe una persona cuando tiene prisa, la columna de la derecha es lo que devuelve el prompt:
| El artículo trata sobre… | La consulta apresurada | El brief de cámara |
|---|---|---|
| Por qué tu stand-up diario no funciona | team meeting |
«a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office» |
| Reducir la incorporación de 6 semanas a 9 días | onboarding |
«a new employee on their first day at a desk, listening while a colleague leans in and points at their screen» |
| El coste oculto del cambio de contexto | productivity |
«a tired developer rubbing their eyes in front of two monitors late in the evening, the office empty behind them» |
team meeting devuelve el genérico material de sala de conferencias que ya está usando
todo el mundo en tu tema. La frase de la tercera columna devuelve esto, en 155 milisegundos:
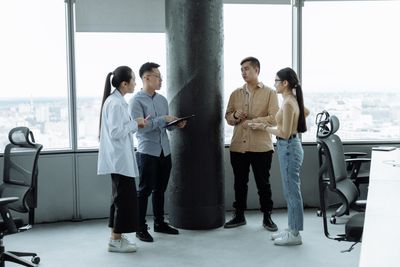

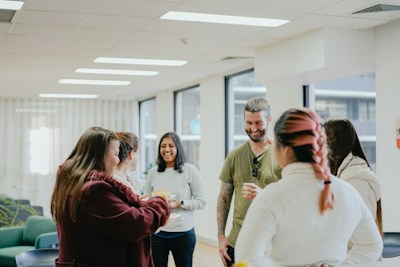
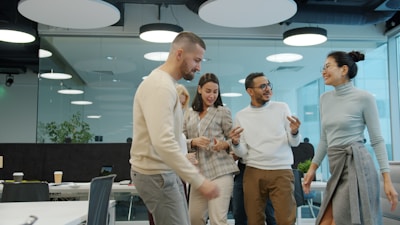
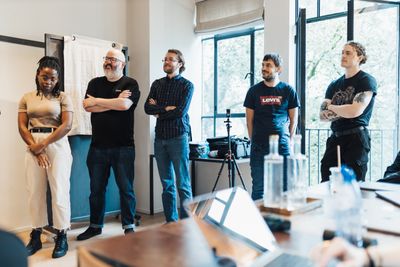
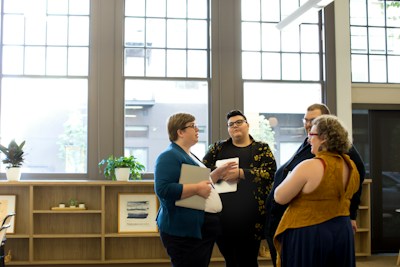
team meeting nunca garantiza.
El pipeline: borrador dentro, imagen principal con crédito fuera
Cuarenta líneas, dos llamadas: una al modelo para el brief, otra a Pexafy para la foto. Colócalo en tu hook de guardado del CMS, en la compilación de tu sitio estático, o en un script que recorra una carpeta de archivos Markdown.
import json, os, requests
from anthropic import Anthropic

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
llm = Anthropic()  # ANTHROPIC_API_KEY tomada del entorno

def camera_brief(article: str) -> dict:
    # PHOTO_EDITOR = el system prompt de arriba
    msg = llm.messages.create(
        model="claude-sonnet-5",
        max_tokens=300,
        system=PHOTO_EDITOR,
        messages=[{ "role": "user", "content": article[:12000] }],
    )
    return json.loads(msg.content[0].text)

def illustrate(article: str) -> dict | None:
    brief = camera_brief(article)
    r = requests.get(
        SEARCH,
        headers={"X-Api-Key": os.environ["PEXAFY_API_KEY"]},
        params={
            "q": brief["query"],           # la frase completa
            "orientation": brief["orientation"],
            "per_page": 8,
            "score_threshold": 0.55,      # descarta coincidencias débiles
        },
        timeout=10,
    )
    hits = r.json()["data"]
    if not hits:                        # brief demasiado estrecho → ampliar, reintentar
        return None

    top = hits[0]
    return {
        "src":    top["urls"]["regular"],        # 1080px — tamaño de imagen principal
        "alt":    brief["alt"] or top["alt_description"],
        "credit": top["attribution"]["html"],   # lista para renderizar
        "width":  top["width"],
        "height": top["height"],
        "id":     top["photo_id"],           # guárdalo: sin repeticiones
    }
Tres detalles que convierten una demo en algo que puedes dejar funcionando:
score_threshold— no devolver nada es mejor que devolver una mala foto. Si el brief era demasiado específico, amplíalo (elimina la última cláusula) y reintenta una vez.- Guarda el
photo_id— una línea en tu base de datos, y ningún par de artículos en tu sitio compartirá nunca una imagen principal. Este es el fallo con el que todo el mundo se topa en la entrada número treinta. - Una solicitud por cada espacio de imagen — una imagen principal más tres imágenes de sección son cuatro solicitudes por artículo, o solo una si tomas cuatro resultados distintos de la misma búsqueda.
¿Sin Python? Toda la parte de búsqueda es una sola línea, y cada resultado lleva los mismos campos sea cual sea la biblioteca de origen:
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a tired developer rubbing their eyes at two monitors" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "per_page=6"

# → { "success": true, "data": [ … ], "meta": { "took_ms": 147 } }
La forma de la respuesta —urls, width, photographer_full_name,
source, license_type, relevance_score,
attribution— es idéntica para una foto de Pexels, una foto de Pixabay y una foto de
Unsplash. Esa normalización es la parte que de otro modo tendrías que escribir y mantener tú
mismo; la desarmamos campo por campo en
la comparativa de API de fotos de stock gratuitas.
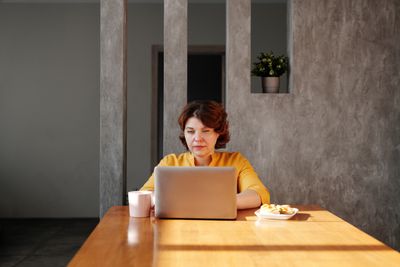
Segunda sección, segundo brief, segunda búsqueda — la idea es que un artículo produzca varias escenas distintas en lugar de una sola foto estirada cuatro veces:
Deja que el agente elija la imagen: MCP
Si un modelo ya está redactando o editando el borrador, el pipeline más limpio es no tener pipeline: dale al agente la herramienta de búsqueda y deja que ilustre lo que acaba de escribir, en la misma conversación, mientras todavía tiene el contexto.
Pexafy ejecuta un servidor Model Context Protocol alojado en
mcp.pexafy.com/mcp. Tres herramientas:
search_photos (una frase),
search_photos_by_image (una imagen de referencia, opcionalmente junto con una
frase — «como esta, pero al atardecer»), y get_similar_photos (más como la que ya
elegiste, que es como se mantiene una serie coherente).
Settings → Connectors → Add custom connector
Name: Pexafy
URL:  https://mcp.pexafy.com/mcp
# luego inicia sesión con tu cuenta de Pexafy cuando se abra la ventana
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# o súbelo al repositorio, para que todo el equipo lo tenga — .mcp.json
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
A partir de ahí, ilustrar un artículo es una frase, no una tarea. El agente escribe su propio brief de cámara — acaba de leer el borrador, así que está mejor situado que nadie para describir la escena:
Tú  Aquí está el borrador de la entrada de esta semana. Busca una
     imagen principal en horizontal y una foto para la sección 2, y
     dame las líneas de crédito.

Claude  → search_photos(
       q="a small team standing in a semi circle for a short morning
          stand-up meeting in a bright open plan office",
       orientation="landscape")
     ← 16 fotos · 155 ms

     Principal → Foto de Thirdman en Pexels · 6453×4302 · puntuación 0.80
     Sección   → Foto de Marcus Aurelius en Pexels · 6000×4000
     Ambas libres de licencia, líneas de atribución abajo, listas para pegar.
Unsplash, Pexels, Pixabay y Openverse no tienen servidor MCP oficial — lo que existe son envoltorios de la comunidad que tú alojas y proteges con tu propia clave. Si tu flujo de trabajo editorial ya pasa por un agente, esa diferencia es la integración.
Texto alternativo, licencia y velocidad de página
La imagen está elegida. Cuatro cosas deciden si ayuda a la página o si silenciosamente la perjudica:
-
Escribe el texto alternativo para una persona, no para un rastreador. Cada
resultado incluye un
alt_description— úsalo como borrador y luego reescríbelo en el contexto de tu párrafo. «Cuatro colegas de pie en una reunión matutina» supera a una ensalada de palabras clave, y es el texto que realmente leerá un lector de pantalla. Mantenlo por debajo de ~125 caracteres; déjalo vacío (alt="") solo si la imagen es puramente decorativa. -
Incluye el crédito aunque nada te obligue a hacerlo. La atribución no la
exigen los términos de la API de Pexafy y cada resultado lleva ya una cadena
attribution.htmllista — pero la licencia asociada por la biblioteca original sigue rigiendo tu uso de esa foto, y una línea de crédito visible es lo que le dice a un lector (y a un motor de respuestas) que se trata de una fotografía real con un autor real. -
Sirve el tamaño correcto.
urls.regular(1080 px) es para una imagen principal;urls.fulles un archivo de 2400 px que ningún artículo necesita. Emite siemprewidth/heighta partir de la respuesta para que el navegador reserve el espacio — ese único par de atributos es la diferencia entre una buena y una mala puntuación de layout-shift. Usafetchpriority="high"en la imagen principal,loading="lazy"en todo lo que quede debajo del pliegue. -
Reutiliza la imagen principal en tus metadatos. La misma URL debería ser tu
og:image, tutwitter:imagey la propiedadimagede tus datos estructuradosArticle. Una foto, tres lugares, cero trabajo extra — y una vista previa social que ya no recae en tu logotipo.
Lo que realmente cuesta publicar 100 artículos al mes
Supón una imagen principal más tres imágenes dentro del artículo, es decir, cuatro solicitudes de búsqueda por entrada — la versión deliberadamente derrochadora, donde ejecutas una consulta distinta por cada espacio en lugar de reutilizar resultados de una sola:
| Volumen | Solicitudes de búsqueda / mes | Plan | Coste de búsqueda |
|---|---|---|---|
| 20 artículos | 80 | Gratis — 5000 solicitudes/mes | 0 $ |
| 100 artículos | 400 | Gratis — 5000 solicitudes/mes | 0 $ |
| 1000 artículosuna agencia, o toda la cartera de un cliente | 4000 | Gratis — sigue dentro de las 5000 solicitudes/mes | 0 $ |
Sí — la cuota mensual no supone ningún problema a los volúmenes propios del marketing de
contenidos, y preferimos decirlo así antes que inventar una razón para que pagues.
El límite con el que realmente te vas a topar es el de por minuto. El plan
gratuito permite 20 solicitudes de API por minuto; un script de compilación que reilustra
100 artículos en una sola pasada dispara 400 solicitudes tan rápido como tu bucle lo permita, así
que o bien pasa veinte minutos siendo limitado, o empieza a acumular 429. Dos
salidas: espaciar las llamadas (un sleep en el bucle, y un trabajo nocturno ni lo
nota), o pasar a un plan cuyo límite de tasa se ajuste a tu compilación — Starter son
30 solicitudes/minuto, Pro 60. Elige según la ráfaga, no según el volumen.
La única otra línea es una breve llamada al modelo por artículo para producir el brief — unos cientos de tokens de entrada, treinta de salida, lo que será el elemento más barato de cualquier pipeline de contenido que gestiones. Compara eso con generar cuatro imágenes por entrada, con cuatrocientas imágenes al mes, más los intentos que no llegaron a usarse.
Y la parte que no aparece en una tabla de costes: el editor deja de abrir cinco pestañas. Ese es el verdadero ahorro.
Referencias y notas al pie
1 Ley de IA de la UE, artículo 50 — obligaciones de transparencia para proveedores y desplegadores de determinados sistemas de IA, aplicable desde el 2 de agosto de 2026. Los proveedores de sistemas que generan audio, imagen, vídeo o texto sintéticos deben marcar las salidas en un formato legible por máquina y hacer que se puedan detectar como generadas artificialmente; los desplegadores deben revelar los deepfakes y, en casos definidos, el texto generado por IA publicado para informar al público. El Digital Omnibus (Reglamento (UE) 2026/1744, en vigor desde el 27 de julio de 2026) deja sin modificar el propio artículo 50, pero concede a los sistemas ya en el mercado antes del 2 de agosto de 2026 hasta el 2 de diciembre de 2026 para cumplir el requisito de marcado legible por máquina del artículo 50(2). Todo esto vincula a los proveedores y desplegadores de IA — no es una norma sobre qué imágenes puede publicar un blog.
2 Google lee las Credenciales de Contenido C2PA y su propia marca de agua SynthID para mostrar la procedencia en Acerca de esta imagen en Search, Images y Lens. Esto es procedencia de medios, no una penalización de ranking sobre contenido generado por IA.
Fuentes verificadas el 15 de agosto de 2026: Artículo 50 de la Ley de IA · Comisión Europea — preguntas frecuentes sobre transparencia · Google — metadatos de imagen · Documentación de la API y MCP de Pexafy. Los tiempos de búsqueda y los resultados son respuestas reales de la API pública, capturadas el mismo día.
Preguntas frecuentes
¿Debo usar imágenes generadas por IA o fotos reales para los artículos del blog?
¿Cómo encuentro automáticamente una imagen que coincida con mi artículo?
GET /api/v1/search/photos?q=…, aproximadamente 150 ms, y cada resultado llega con su tamaño, licencia y una cadena de atribución ya lista.¿Cuál es el mejor prompt para convertir un artículo en una consulta de búsqueda de imágenes?
¿Tengo que acreditar las fotos que uso en las publicaciones del blog?
¿Puede Claude u otro agente de IA encontrar las fotos para mi artículo?
mcp.pexafy.com/mcp. Añádelo como conector personalizado en Claude.ai o Claude Desktop e inicia sesión con OAuth, o agrégalo a Claude Code con un solo comando claude mcp add y una clave de API. El agente entonces busca por frase, por imagen de referencia o por fotos similares por sí mismo, mientras aún tiene tu borrador en contexto.¿Cómo evito que todos los artículos de mi blog usen la misma foto?
photo_id de cada imagen que publiques y exclúyelo en la siguiente ejecución — una sola columna en tu CMS. Es el fallo típico que sufre todo pipeline automatizado alrededor del artículo número treinta, y es invisible hasta que alguien recorre el índice de tu blog. Escribir un camera brief nuevo por sección, en lugar de reutilizar el título del artículo, hace el resto.

