Cara Mengilustrasikan Setiap Artikel yang Anda Terbitkan — Dengan Foto Asli, dalam Skala Besar
Mengapa tim penerbit kembali beralih ke fotografi asli, dan alur kerja tepat — lengkap dengan prompt-nya — yang mengubah draf jadi selesai menjadi gambar utama berkredit dalam waktu sekitar 150 milidetik.
 Marouane Tijani
10 menit baca

Setiap artikel yang Anda terbitkan butuh gambar. Ini bukan sekadar pemanis — gambar hero adalah yang ditampilkan pratinjau media sosial, yang dilihat pembaca sebelum kalimat pertama, dan yang memberi tahu mereka dalam setengah detik apakah halaman ini dibuat oleh seseorang yang peduli. Kalikan itu dengan empat gambar per tulisan dan empat puluh tulisan per kuartal, dan "mencari foto" berhenti menjadi tugas sederhana dan berubah menjadi masalah pipeline.
Begini cara kami menyelesaikannya: apa yang digunakan sebagai pengganti gambar hasil generate dan alasannya, serta tiga cara menghubungkan Pexafy ke alur kerja — secara manual, lewat API, atau lewat agen AI — termasuk prompt yang mengubah draf jadi kalimat pencarian yang benar-benar menemukan sesuatu.
Kenapa foto asli masih mengalahkan foto hasil generate
Menghasilkan ilustrasi itu mudah, dan justru itulah masalahnya. Empat hal berubah antara "gambar AI adalah jalan pintas curang" dan hari ini:
1 · Dalam volume besar, mencari lebih cepat daripada menghasilkan
Satu proses generate berarti satu prompt, menunggu, memeriksa hasilnya, dan — jujur saja — dua atau tiga percobaan lagi sebelum satu hasil bisa dipakai. Pencarian semantik adalah satu permintaan tunggal yang kembali dengan enam belas kandidat dalam sekitar 150 milidetik, masing-masing sudah berlisensi, sudah berkredit, sudah ada ukurannya, dengan dimensinya tercantum di respons. Untuk satu gambar, bedanya cuma secangkir kopi. Untuk empat ratus gambar per kuartal, bedanya adalah antara sebuah alur kerja dan sebuah beban pekerjaan.
2 · Foto itu akurat; hasil generate itu masuk akal saja
Begitu artikel Anda membahas sesuatu yang nyata — sebuah profesi, sebuah alat, sebuah kota, sebuah gestur, sebuah material — gambar hasil generate akan mendapatkan suasananya benar tapi detailnya salah. Tangan berjari enam adalah versi leluconnya; versi mahalnya adalah alat bedah yang tidak nyata, kokpit dengan kontrol yang direka-reka, atau "jalanan Lisbon" yang tidak dikenali siapa pun yang benar-benar dari Lisbon. Pembaca yang paham subjek Anda akan menyadarinya, dan mereka menyadarinya lewat gambar itu lebih dulu.
3 · Semua orang punya tampilan yang sama
Model difusi cenderung mengarah ke satu gaya rumahan, dan deretan ilustrasi bergradasi lembut, terlalu terang, dan simetris secara mencurigakan kini dibaca sebagai pengisi ruang. Persepsi itulah biaya sesungguhnya: bukan sebuah hukuman, melainkan sebuah sinyal. Foto asli — butiran gambar, kursi yang canggung, seseorang di tengah kalimat — dibaca sebagai laporan jurnalistik.
4 · Dan sekarang gambar itu datang dengan label menempel
Poin ini lebih sebagai konteks daripada argumen, tapi inilah arah perkembangannya. Sejak 2 August 2026, Pasal 50 EU AI Act mewajibkan penyedia sistem generatif untuk menandai keluaran sintetis dalam format yang bisa dibaca mesin, dan mewajibkan pihak yang menerapkannya untuk mengungkapkan deepfake.1 Di sisi deteksi, Google membaca C2PA Content Credentials dan watermark SynthID miliknya sendiri untuk menjawab "apakah ini dihasilkan AI?" di dalam Search, Images, dan Lens.2 Tidak ada di sana yang mengatur gambar mana yang boleh diterbitkan sebuah blog, dan tidak ada di sana yang merugikan peringkat Anda. Yang berubah ada di hilir: asal-usul gambar di bagian atas artikel Anda kini bisa diperiksa pembaca hanya dengan dua klik, tanpa bertanya kepada Anda. Sebuah foto berlisensi tidak punya apa-apa untuk disembunyikan.
Kapan gambar hasil generate memang pilihan yang tepat. Diagram konsep dan skema. Sebuah adegan yang memang tidak bisa difoto (produk yang belum ada, mekanisme abstrak, kota masa depan). Sebuah gaya ilustrasi rumahan yang Anda miliki dan ingin diulang di setiap tulisan. Dan apa pun yang gambarnya memang sengaja dipahami sebagai ilustrasi, bukan sebagai bukti. Pakai keduanya — cukup berhenti menjadikan gambar hasil generate sebagai default untuk "saya butuh foto orang sedang rapat."
Tiga cara mengilustrasikan tulisan, tergantung volume Anda
Mesin yang sama, katalog yang sama — 9M+ foto gratis pakai dari 9 pustaka — dan tiga titik akses. Pilih berdasarkan berapa banyak artikel yang Anda terbitkan, bukan berdasarkan seberapa teknis Anda.
| Titik akses | Paling cocok untuksiapa dan berapa banyak | Per artikel | Yang Anda butuhkan |
|---|---|---|---|
| Antarmuka pencarian | Editor, satu tulisan pada satu waktu — hingga ~20/bulan | ~30 detik | Sebuah browser. Tidak perlu akun untuk mencari. |
| REST API | Sebuah CMS, proses build situs statis, sekumpulan draf | ~1 permintaan, ~150 ms | Sebuah kunci API. 5,000 req/month gratis, 20/min. |
| Server MCP | Agen AI yang menulis atau menyunting draf | Di dalam percakapan yang sama | Satu URL konektor, OAuth atau sebuah kunci. |
Ketiganya berbagi satu katalog dan satu peringkat, jadi foto yang ditemukan editor di antarmuka adalah foto yang sama, dengan identifier yang sama, yang dikembalikan API ke skrip build Anda.
Satu artikel, 30 detik: antarmuka pencarian
Deskripsikan adegannya seperti Anda mendeskripsikannya ke seorang fotografer, dalam kalimat
lengkap, dalam bahasa Anda sendiri. Bukan team meeting —
“a small team standing in a semi circle for a short morning stand-up meeting in a bright
open plan office”. Setiap detail konkret tambahan mempersempit hasil alih-alih
mengosongkannya, karena mesinnya melakukan peringkat berdasarkan makna, bukan mencocokkan
kata-kata Anda dengan tag milik orang lain.
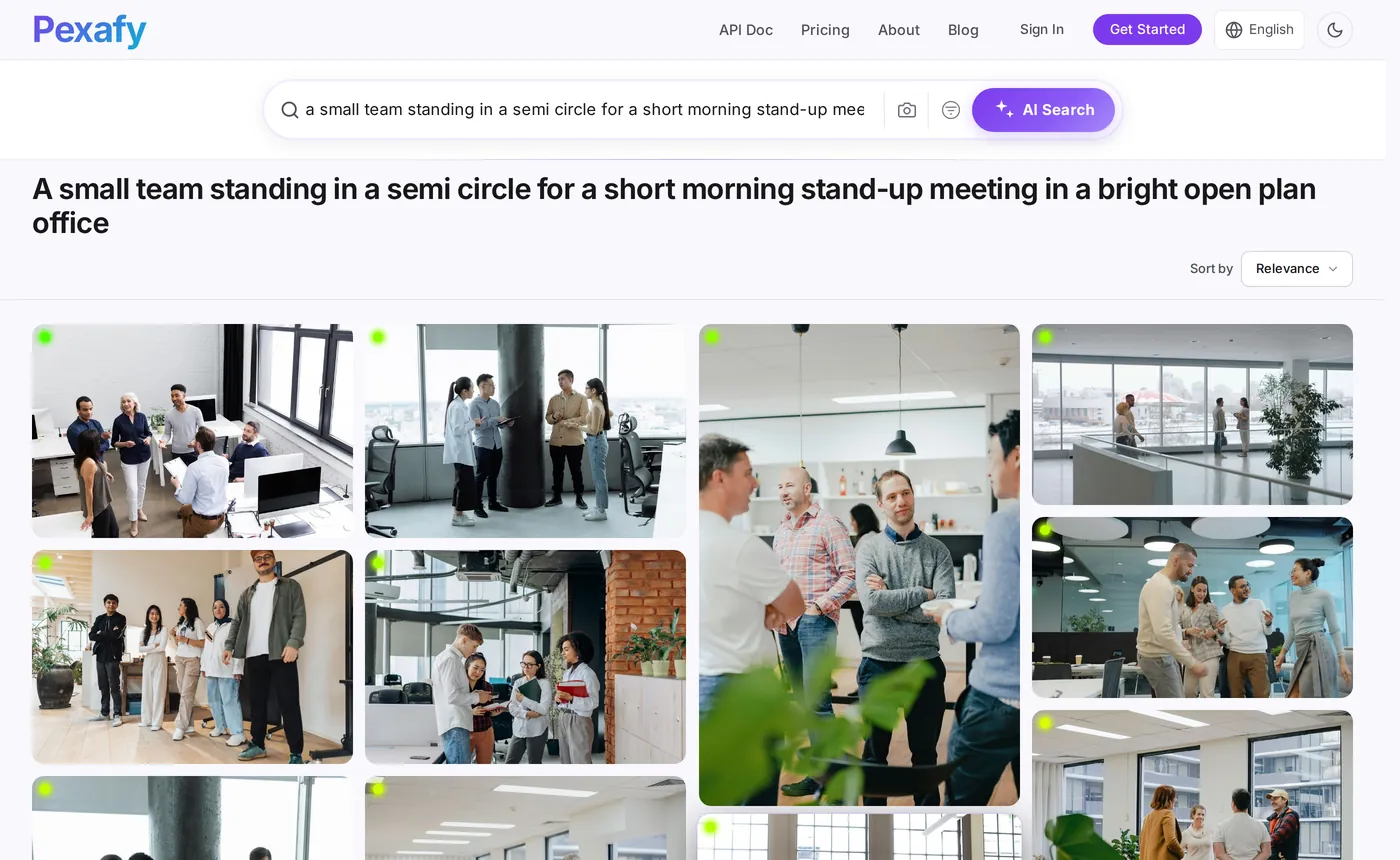
Lalu persempit dengan filter yang relevan untuk tata letak artikel — dan hanya itu saja:
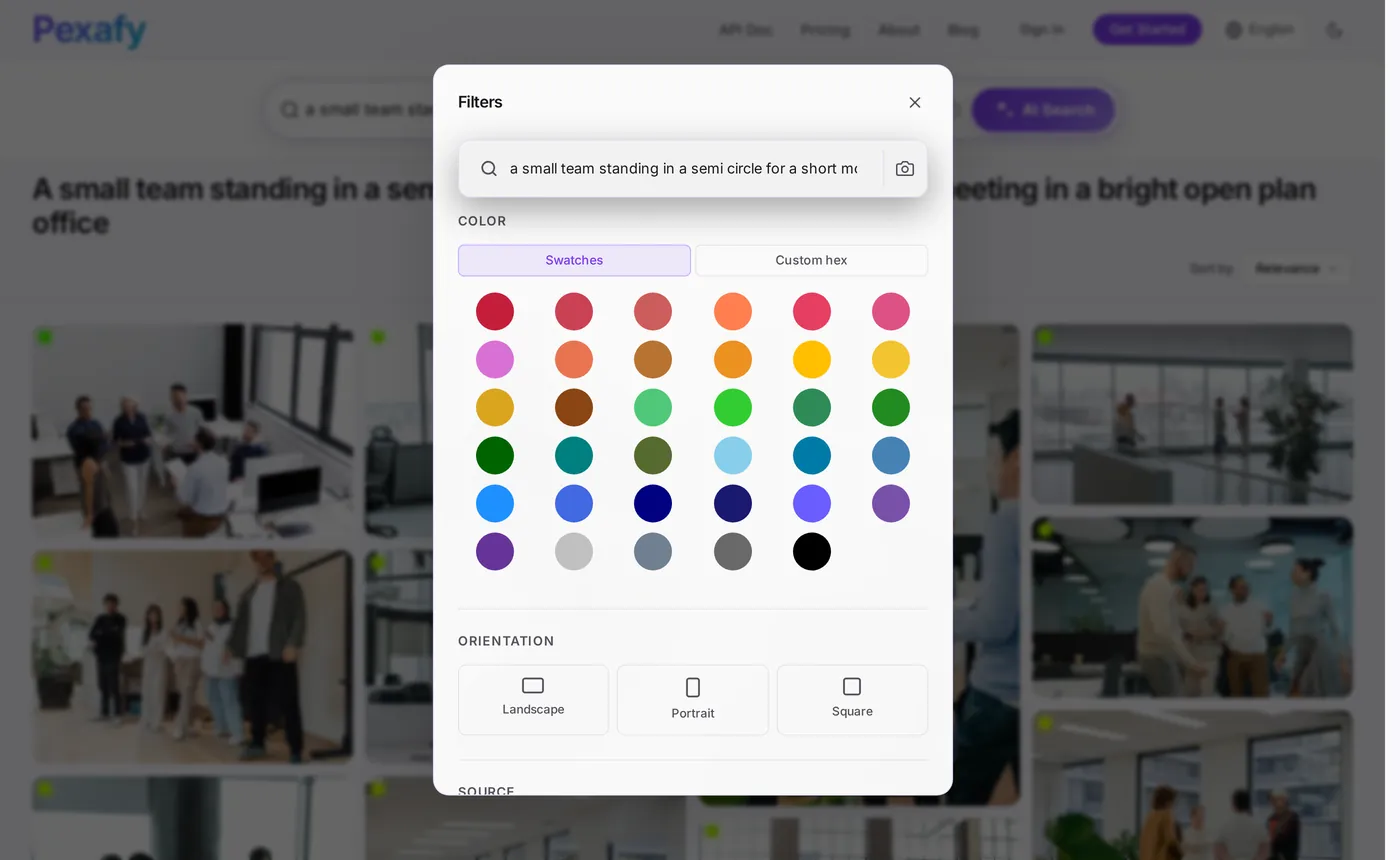
- Tulis kalimatnya, bukan kata kuncinya. Subjek + aksi + tempat + cahaya. Hingga 500 karakter, dalam salah satu dari lebih dari 100 bahasa.
- Filter ke landscape untuk gambar hero, lalu jalankan ulang tanpa filter untuk gambar dalam artikel, di mana potret sering kali terlihat lebih baik.
- Buka fotonya untuk mendapatkan baris atribusi siap pakai, halaman sumber asli, dan berkas resolusi penuh.
- Gunakan "foto serupa" pada foto yang Anda pilih untuk mengilustrasikan bagian berikutnya dalam register visual yang sama — cahaya yang sama, treatment yang sama, adegan yang berbeda.
Prompt-nya: mengubah draf jadi kalimat pencarian
Ini adalah langkah yang selalu salah dilakukan orang saat mengotomatiskannya. Mereka memasukkan judul artikel langsung ke kotak pencarian, dan judul justru masukan yang paling salah: judul itu abstrak (“The hidden cost of context switching”) dan tidak ada foto di dunia ini yang menggambarkannya. Yang Anda inginkan dari model bukanlah ringkasan — itu adalah sebuah brief kamera.
# system prompt
You are a photo editor. Read the article and write ONE search sentence
for a stock-photo engine that ranks by meaning, not by keywords.

Rules:
1. Describe a scene a camera could have taken: someone doing
   something, somewhere. Never name the topic itself ("fintech",
   "productivity", "SEO") — name what would be in the frame.
2. 12 to 25 words. Longer beats shorter: every concrete detail
   (light, place, gesture, time of day) sharpens the match.
3. No text, logos, brands, charts, screenshots or famous people.
   Free photo libraries have almost none of those.
4. No invisible metaphors ("growth", "synergy", "transformation").
5. Match the mood of the article: calm, tense, tired, celebratory.
6. Write the sentence in English even if the article is not.

Return JSON only:
{ "query": "…", "orientation": "landscape", "alt": "…" }
Aturan 1 melakukan sebagian besar pekerjaannya. Berikut aturan yang sama diterapkan pada tiga draf nyata — kolom tengah adalah apa yang diketik manusia saat sedang buru-buru, kolom kanan adalah apa yang dikembalikan prompt-nya:
| Artikelnya membahas… | Kueri yang tergesa-gesa | Brief kamera |
|---|---|---|
| Kenapa rapat stand-up harian Anda tidak berjalan baik | team meeting |
“a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office” |
| Memangkas onboarding dari 6 minggu menjadi 9 hari | onboarding |
“a new employee on their first day at a desk, listening while a colleague leans in and points at their screen” |
| Biaya tersembunyi dari context switching | productivity |
“a tired developer rubbing their eyes in front of two monitors late in the evening, the office empty behind them” |
team meeting mengembalikan stok ruang rapat generik yang sudah dipakai semua
orang lain di topik Anda. Kalimat di kolom ketiga mengembalikan ini, dalam 155 milidetik:
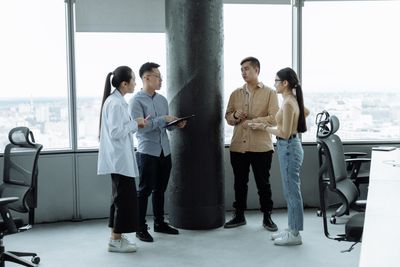

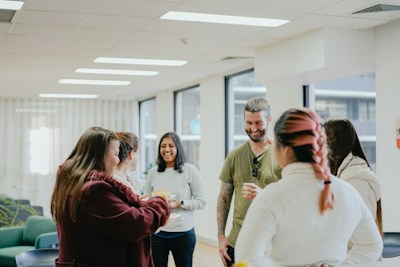
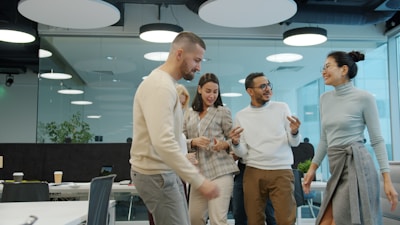
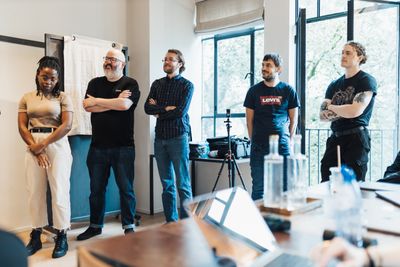
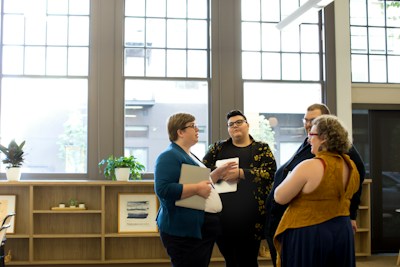
team meeting.
Pipeline-nya: draf masuk, gambar hero berkredit keluar
Empat puluh baris, dua panggilan: satu ke model untuk brief-nya, satu ke Pexafy untuk fotonya. Pasang di save hook CMS Anda, proses build situs statis Anda, atau sebuah skrip yang menyusuri folder berkas Markdown.
import json, os, requests
from anthropic import Anthropic

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
llm = Anthropic()  # ANTHROPIC_API_KEY dari environment

def camera_brief(article: str) -> dict:
    # PHOTO_EDITOR = system prompt di atas
    msg = llm.messages.create(
        model="claude-sonnet-5",
        max_tokens=300,
        system=PHOTO_EDITOR,
        messages=[{ "role": "user", "content": article[:12000] }],
    )
    return json.loads(msg.content[0].text)

def illustrate(article: str) -> dict | None:
    brief = camera_brief(article)
    r = requests.get(
        SEARCH,
        headers={"X-Api-Key": os.environ["PEXAFY_API_KEY"]},
        params={
            "q": brief["query"],           # kalimat lengkapnya
            "orientation": brief["orientation"],
            "per_page": 8,
            "score_threshold": 0.55,      # buang hasil yang cocoknya lemah
        },
        timeout=10,
    )
    hits = r.json()["data"]
    if not hits:                        # brief terlalu sempit → perlebar, coba lagi
        return None

    top = hits[0]
    return {
        "src":    top["urls"]["regular"],        # 1080px — ukuran hero
        "alt":    brief["alt"] or top["alt_description"],
        "credit": top["attribution"]["html"],   # siap dirender
        "width":  top["width"],
        "height": top["height"],
        "id":     top["photo_id"],           # simpan ini: agar tidak berulang
    }
Tiga detail yang mengubah sebuah demo jadi sesuatu yang bisa Anda biarkan berjalan sendiri:
score_threshold— tidak mengembalikan apa pun lebih baik daripada mengembalikan foto yang buruk. Jika brief-nya terlalu spesifik, lebarkan (buang klausa terakhir) dan coba lagi sekali.- Simpan
photo_id— satu baris di database Anda, dan tidak ada dua artikel di situs Anda yang pernah berbagi gambar hero yang sama. Ini adalah kegagalan yang selalu dialami semua orang di artikel ketiga puluh. - Satu permintaan per slot gambar — satu hero ditambah tiga gambar bagian berarti empat permintaan per artikel, atau satu saja jika Anda mengambil empat hasil berbeda dari pencarian yang sama.
Tidak pakai Python? Separuh bagian pencarian hanya satu baris, dan setiap hasil membawa field yang sama apa pun pustaka asalnya:
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a tired developer rubbing their eyes at two monitors" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "per_page=6"

# → { "success": true, "data": [ … ], "meta": { "took_ms": 147 } }
Bentuk responsnya — urls, width, photographer_full_name,
source, license_type, relevance_score,
attribution — identik untuk foto Pexels, foto Pixabay, dan foto Unsplash.
Normalisasi itulah bagian yang seharusnya Anda tulis dan pelihara sendiri; kami membedahnya
field demi field di
perbandingan API foto stok gratis.
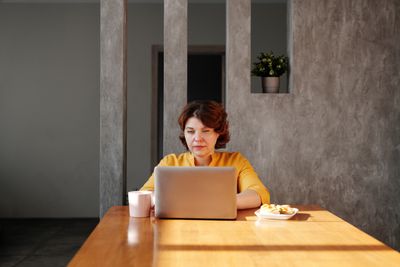
Bagian kedua, brief kedua, pencarian kedua — intinya, satu artikel menghasilkan beberapa adegan berbeda alih-alih satu foto yang diregangkan empat kali:
Biarkan agen yang memilih gambarnya: MCP
Jika sebuah model sudah menulis atau menyunting drafnya, pipeline yang paling bersih adalah tanpa pipeline sama sekali: beri agen alat pencariannya dan biarkan ia mengilustrasikan apa yang baru saja ia tulis, dalam percakapan yang sama, selagi ia masih memiliki konteksnya.
Pexafy menjalankan server Model Context Protocol yang di-hosting di
mcp.pexafy.com/mcp. Tiga alat:
search_photos (sebuah kalimat),
search_photos_by_image (sebuah gambar referensi, opsional ditambah sebuah kalimat
— "seperti ini, tapi saat matahari terbenam"), dan
get_similar_photos (lebih banyak seperti yang sudah Anda pilih, cara Anda menjaga
sebuah rangkaian tetap koheren).
Settings → Connectors → Add custom connector
Name: Pexafy
URL:  https://mcp.pexafy.com/mcp
# lalu masuk dengan akun Pexafy Anda saat jendelanya terbuka
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# atau commit ke repo, agar seluruh tim mendapatkannya — .mcp.json
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
Dari sana, mengilustrasikan sebuah artikel jadi sekadar sebuah kalimat, bukan sebuah tugas. Agennya menulis brief kameranya sendiri — ia baru saja membaca drafnya, jadi ia lebih mampu daripada siapa pun untuk mendeskripsikan adegannya:
Anda  Ini draf tulisan minggu ini. Carikan gambar hero berorientasi
     landscape dan satu foto untuk bagian 2, lalu berikan saya baris
     kreditnya.

Claude  → search_photos(
       q="a small team standing in a semi circle for a short morning
          stand-up meeting in a bright open plan office",
       orientation="landscape")
     ← 16 foto · 155 ms

     Hero    → Photo by Thirdman on Pexels · 6453×4302 · score 0.80
     Bagian  → Photo by Marcus Aurelius on Pexels · 6000×4000
     Keduanya bebas lisensi, baris atribusi ada di bawah, siap ditempel.
Unsplash, Pexels, Pixabay, dan Openverse tidak punya server MCP resmi — yang ada hanyalah wrapper komunitas yang harus Anda host dan beri kunci sendiri. Jika alur kerja editorial Anda sudah berjalan lewat sebuah agen, perbedaan itu adalah integrasinya.
Teks alt, lisensi, dan kecepatan halaman
Gambarnya sudah dipilih. Empat hal yang menentukan apakah gambar itu membantu halaman atau diam-diam merugikannya:
-
Tulis teks alt untuk manusia, bukan untuk crawler. Setiap hasil membawa
alt_description— gunakan itu sebagai draf, lalu tulis ulang sesuai konteks paragraf Anda. "Empat rekan kerja berdiri dalam rapat pagi" lebih baik daripada kumpulan kata kunci, dan itulah teks yang benar-benar akan dibacakan pembaca layar. Jaga di bawah ~125 karakter; biarkan kosong (alt="") hanya jika gambarnya murni dekoratif. -
Sertakan kreditnya bahkan saat tidak ada yang memaksa Anda. Atribusi tidak
diwajibkan oleh ketentuan API Pexafy dan setiap hasil membawa string
attribution.htmlsiap pakai — tapi lisensi yang melekat dari pustaka aslinya tetap mengatur penggunaan Anda atas foto itu, dan baris kredit yang terlihat memberi tahu pembaca (dan mesin jawaban) bahwa ini adalah foto asli dengan penulis yang nyata. -
Sajikan ukuran yang tepat.
urls.regular(1080 px) cocok untuk gambar hero;urls.fulladalah berkas 2400 px yang tidak dibutuhkan artikel mana pun. Selalu keluarkanwidth/heightdari respons agar browser mencadangkan ruangnya — sepasang atribut itu saja adalah bedanya antara skor layout-shift yang baik dan yang buruk. Gunakanfetchpriority="high"pada gambar hero,loading="lazy"pada semua yang di bawah lipatan layar. -
Masukkan gambar hero ke metadata Anda. URL yang sama seharusnya menjadi
og:imageAnda,twitter:imageAnda, dan propertiimagepada data terstrukturArticleAnda. Satu foto, tiga tempat, tanpa kerja tambahan — dan pratinjau media sosial yang tidak lagi jatuh kembali ke logo Anda.
Biaya sebenarnya untuk 100 artikel sebulan
Asumsikan satu gambar hero ditambah tiga gambar dalam artikel, jadi empat permintaan pencarian per tulisan — versi yang sengaja boros, di mana Anda menjalankan kueri terpisah per slot alih-alih memakai ulang hasil dari satu kueri:
| Volume | Permintaan pencarian / bulan | Paket | Biaya pencarian |
|---|---|---|---|
| 20 artikel | 80 | Gratis — 5,000 req/month | $0 |
| 100 artikel | 400 | Gratis — 5,000 req/month | $0 |
| 1,000 artikelsebuah agensi, atau seluruh portofolio klien | 4,000 | Gratis — masih di dalam 5,000 req/month | $0 |
Ya — kuota bulanan bukan masalah di volume content marketing, dan kami lebih memilih
mengatakannya daripada mengarang alasan agar Anda membayar. Batas yang akan benar-benar
Anda temui adalah batas per menit. Paket gratis mengizinkan 20 permintaan API per
menit; sebuah skrip build yang mengilustrasikan ulang 100 artikel dalam satu proses menembakkan
400 permintaan secepat perulangan Anda mengizinkan, jadi ia akan menghabiskan dua puluh menit
ditahan (throttled) atau mulai mengumpulkan 429. Ada dua jalan keluar: beri jeda
antar-panggilan (satu sleep di dalam perulangan, dan sebuah job malam hari tidak
akan pernah menyadarinya), atau pindah ke paket yang batas kecepatannya sesuai dengan build
Anda — Starter adalah 30 permintaan/menit, Pro 60. Pilih berdasarkan lonjakan-nya,
bukan berdasarkan volumenya.
Satu-satunya baris biaya lain adalah satu panggilan model singkat per artikel untuk menghasilkan brief-nya — beberapa ratus token masuk, tiga puluh keluar, yang akan menjadi item paling murah di pipeline konten mana pun yang Anda miliki. Bandingkan itu dengan menghasilkan empat gambar per tulisan, di empat ratus gambar sebulan, ditambah percobaan-percobaan yang tidak lolos seleksi.
Dan bagian yang tidak muncul di tabel biaya: editornya berhenti membuka lima tab. Itulah penghematan sesungguhnya.
Referensi & catatan kaki
1 EU AI Act, Pasal 50 — kewajiban transparansi bagi penyedia dan pihak penerap sistem AI tertentu, berlaku sejak 2 August 2026. Penyedia sistem yang menghasilkan audio, gambar, video, atau teks sintetis harus menandai keluarannya dalam format yang bisa dibaca mesin dan membuatnya terdeteksi sebagai hasil buatan AI; pihak penerap harus mengungkapkan deepfake dan, dalam kasus tertentu, teks hasil AI yang diterbitkan untuk menginformasikan publik. Digital Omnibus (Regulation (EU) 2026/1744, berlaku sejak 27 July 2026) tidak mengubah Pasal 50 itu sendiri, tapi memberi sistem yang sudah beredar di pasar sebelum 2 August 2026 waktu hingga 2 December 2026 untuk memenuhi persyaratan penandaan yang bisa dibaca mesin pada Pasal 50(2). Semua ini mengikat penyedia dan pihak penerap AI — bukan aturan tentang gambar mana yang boleh diterbitkan sebuah blog.
2 Google membaca C2PA Content Credentials dan watermark SynthID miliknya sendiri untuk menampilkan asal-usul gambar di About this image di seluruh Search, Images, dan Lens. Ini adalah asal-usul media, bukan hukuman peringkat pada konten hasil AI.
Sumber diperiksa pada 15 August 2026: AI Act Article 50 · European Commission — FAQ transparansi · Google — metadata gambar · Dokumentasi API & MCP Pexafy. Waktu pencarian dan hasilnya adalah respons nyata dari API publik, diambil pada hari yang sama.
Pertanyaan yang sering diajukan
Sebaiknya saya menggunakan gambar hasil AI atau foto asli untuk artikel blog?
Bagaimana cara otomatis menemukan gambar yang cocok dengan artikel saya?
GET /api/v1/search/photos?q=…, sekitar 150 ms, dan setiap hasil disertai ukuran, lisensi, dan string atribusi siap pakai.Apa prompt terbaik untuk mengubah artikel menjadi kueri pencarian gambar?
Apakah saya harus mencantumkan kredit untuk foto yang saya gunakan di postingan blog?
Bisakah Claude atau agen AI lain menemukan foto untuk artikel saya?
mcp.pexafy.com/mcp. Tambahkan sebagai konektor kustom di Claude.ai atau Claude Desktop lalu masuk dengan OAuth, atau tambahkan ke Claude Code dengan satu perintah claude mcp add dan sebuah API key. Agen kemudian dapat mencari berdasarkan kalimat, gambar referensi, atau foto serupa dengan sendirinya, sementara draf Anda masih ada dalam konteksnya.Bagaimana cara mencegah setiap artikel di blog saya memakai foto yang sama?
photo_id dari setiap gambar yang Anda terbitkan dan kecualikan pada proses berikutnya — cukup satu kolom di CMS Anda. Ini adalah mode kegagalan yang dialami setiap alur kerja otomatis sekitar artikel ketiga puluh, dan tidak terlihat sampai seseorang menggulir indeks blog Anda. Menulis camera brief baru untuk setiap bagian, alih-alih menggunakan ulang judul artikel, akan menyelesaikan sisanya.

