Ayda 10.000 Sayfayı 500 API Çağrısında Gerçek Fotoğraflarla Görsellendirin
Her görsel için değil, her konu kümesi için bir kez arama yapın; böylece 40.000 API çağrısı 500'e iner. Havuzla-ve-ata deseni, rate limit'lere dayanıklı worker ve fotoğrafların düzeltemeyeceği şeyler hakkında dürüst bir bölüm.
 Marouane Tijani
12 dk okuma

İçerik görselleştirme probleminin öyle bir versiyonu var ki, hiçbir iyi zevk miktarı onu çözemez: bir fotoğraf seçmiyorsunuz, 800 konu kümesi, 9 yerel dil ve 14 müşteri sitesi genelinde ayda 40.000 görsel yuvasını dolduruyorsunuz ve bunların her biri lisanslanmalı, kredilendirilmeli, boyutlandırılmalı ve yanındakinden farklı olmalı. Bu hacimde soru artık "hangi fotoğraf?" olmaktan çıkıp "mimari nedir?" haline gelir.
Bu makale API cevabıdır: çağrı sayısını iki büyüklük mertebesi kadar düşüren istek deseni, hız limitlerinde ayakta kalan işçi (worker), 10.000 sayfalık bir sitenin aynı stok fotoğraf duvarı gibi görünmesini engelleyen tekrar önleme — ve görsellerin sizin için yapamayacaklarına dair dürüst bir bölüm.
10.000 makalede gerçek darboğaz
Hacimli yayın yapan ekipler — programatik SEO varlıkları, pazar yeri kategori sayfaları, agregatörler, bağlı kuruluş ağları, bir müşteri portföyü için içerik yürüten ajanslar, bir makaleyi 20'ye çeviren yerelleştirme hatları — hepsi aynı üç duvara, aynı sırayla çarpar:
- Çağrı sayısı. Görsel yuvası başına bir arama, 10.000 dört-görselli makale için 40.000 API çağrısı demektir. Her sağlayıcı sizi bu sayı üzerinden fiyatlandırır, kısıtlar ve inceler.
- Tekrar. Otuzuncu sayfa civarında aynı fotoğraf yeniden belirmeye başlar. Üç bininci sayfada sitenizin bir görsel imzası vardır: toplu üretilmiş.
- Koordinasyon. Bir kümedeki yüz makale bir seri gibi görünmeli, yüz alakasız Pinterest panosu gibi değil — ve aynı makalenin bir sonraki yerel sürümü aynı görseli yeniden kullanmalı, başka bir dilde tekrar arama yapmamalı.
Bu listede olmayan şeye dikkat edin: iyi bir fotoğraf bulmak. Anlamsal bir motor, yaklaşık 130 milisaniyede kullanılabilir adaylardan oluşan bir sayfa döndürür. Getirme (retrieval) sorunu çözüldü; dağıtım çözülmedi. Aşağıdaki her şey dağıtımla ilgilidir.
Neden gerçek fotoğraflar, özellikle bu hacimde
Üretimin üzerine fotoğrafçılık tercih etme argümanı, hacim arttıkça güçlenir; bunun nedenleri çoğunlukla estetik değil, operasyoneldir.
| Ayda 40.000 görselde | Onları üretmek | Onları aramak |
|---|---|---|
| Görsel başına süre | Saniyelerden dakikalara, üstüne reddedilen denemeler | Tek bir istek (~130 ms) tüm bir kümeyi kapsar |
| Maliyet etkeni | Görsel başına, sonsuza dek | İstek başına — ve tek bir istek ~25 makaleye hizmet eder |
| Aldığınız meta veri | Hiçbiri. Alt metni ve boyutları kendiniz yazarsınız | Boyutlar, baskın renk, blur hash, taslak açıklama, kredi satırı |
| Kaynak bilgisi (provenance) | 2 Ağustos 2026'dan beri AB Yapay Zeka Yasası kapsamında sentetik olarak makine işaretli1 | Adı belirtilen bir fotoğrafçı, bir tarih, okuyucunun açabileceği bir kaynak URL'si |
| Hata modu | Makul ama yanlış detaylar, tekdüze bir ev stili | Hiçbiri brief ile eşleşmedi — sıfır sonuç alırsınız, bunu yönetebilirsiniz |
Meta veri satırı, hatları belirleyen satırdır. Her arama sonucu zaten width,
height, blur_hash, color_hex,
alt_description ve hazır bir attribution.html dizesi taşır — bu tam
olarak bir şablonlama motorunun, yer tutucu ve kredi içeren, düzen kaymasız (layout-shift-free)
bir <img> yayınlamak için ihtiyaç duyduğu veridir. Üretilen görseller size
yalnızca bir dosya verir ve diğer altı alanı sizin icat etmenize bırakır.
Üretimin ölçekte hâlâ kazandığı yer. Soyut taksonomiler için kategori düzeyinde görselleştirme ("bulut geçişi", "endeks fonları"), diyagramlar ve marka nedenleriyle tüm bir varlık genelinde tekrar edilmesini istediğiniz bir ev stili. Çoğu büyük yayıncının vardığı ayrım: dünyada var olan her şey için fotoğraflar, yalnızca bir argümanda var olan şeyler için üretilmiş sanat. Bu ayrımın tüm gerekçesini yayımladığınız her makaleyi nasıl görselleştirirsiniz makalesinde sunduk.
Bir istek, yüz fotoğraf
Aritmetiği yeniden şekillendiren tek değişiklik budur. Arama uç noktası per_page
parametresini 100'e kadar kabul eder ve imleç (cursor) sayfalama, aynı sıralanmış
sonuç kümesini gezmeye devam etmenizi sağlar. Yani iş birimi bir görsel değil, bir
havuzdur.
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a woman signing paperwork with an insurance agent at a kitchen table in her home" \
  --data-urlencode "per_page=100" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "score_threshold=0.5" \
  --data-urlencode "fields=photo_id,urls,width,height,blur_hash,alt_description,attribution"

# → { "success": true, "data": [ …100'e kadar fotoğraf… ],
#     "pagination": { "per_page": 100, "has_more": true, "next_cursor": "eyJyc…" },
#     "meta": { "took_ms": 122.33, "request_id": "7ff1fb9b-…" } }
Buradaki üç parametre ölçekte sessizce iş görüyor:
fields— seyrek bir alan kümesi (sparse fieldset). Şablonunuzun render ettiği yedi alanı isteyin ve yanıt, her fotoğrafın uzun yapay zeka açıklamasını göndermeyi bırakır. 40.000 fotoğraf genelinde bu, akan bir derleme ile takas eden bir derleme arasındaki farktır.score_threshold— 100 sonuçluk bir sayfanın kuyruğu, tanım gereği baş kısmından daha az alakalıdır. Bir alt sınır belirlemek, zayıf bir kümenin 100 vasat fotoğraf yerine 34 fotoğraf döndürmesi anlamına gelir ve hattınız bunları yayımlamak yerine buna tepki verebilir.next_cursor— bir küme gerçekten 300 fotoğrafa ihtiyaç duyduğunda, birbiriyle çakışan üç farklı sorgu göndermek yerine aynı sıralanmış kümeyi sayfalayın.
Ve işte, her biri dört görsel içeren ayda 10.000 sayfa yayımlayan bir site için aritmetik:
| Strateji | İstek / ay | Ücretsiz planın hız limitinde tek geçiş20 istek/dk | Ücretsiz aylık kotaya sığar mı? |
|---|---|---|---|
| Görsel yuvası başına bir arama | 40.000 | 33 hours | Hayır — ücretli bir plan |
| Makale başına bir arama | 10.000 | 8 hours | Hayır — ücretli bir plan |
| ~20 makalelik bir küme başına bir aramabu makaledeki desen | 500 | 25 minutes | Evet |
Her üç satırda da aynı 40.000 yayımlanan görsel. Değişen tek şey döngünün nerede oturduğu.
Havuzla ve ata: ölçeklenen desen
Mimarinin tamamı, aralarında bir tablo olan, farklı sıklıklarda çalışan iki aşamadan oluşur:
                     ┌─────────── haftalık çalışır, ~500 istek ──────────┐
  konu kümeleri ──▶ HAVUZLA  küme başına bir kez ara, per_page=100
                     │       └─▶ küme başına 100 fotoğraf satırı sakla
                     └──────────────────┬───────────────────────────────┘
                                        ▼
                              image_pool tablosu
                        (cluster, photo_id, urls, blur_hash,
                         alt, credit, used_by_page, used_at)
                                        │
                     ┌──────────────────┴──── yayın başına çalışır, 0 istek ─┐
  makale ─────────▶ ATA  bu küme için kullanılmamış en iyi
                     │        satırı seç, kullanıldı olarak işaretle, render et
                     └────────────────────────────────────────────────────────┘
Bunun size, hacimde önemi sırasına göre kazandırdıkları:
- Yayınlama asla bir API'de takılmaz. Atama bir veritabanı okumasıdır. CMS'inizin kaydetme kancası, statik derlemeniz ve sabah 3'teki toplu içe aktarımınızın hepsi yerel hızda, çevrimdışı, yolda hiçbir hız limiti olmadan çalışır.
- Tekrar önleme bedavadır ve kesindir.
used_by_page IS NULLözelliğin tamamıdır. İki sayfa aynı fotoğrafı çekemez, çünkü atama bir sıralama sezgiseli değil, bir işlemdir (transaction). - Yeniden çalıştırmalar ucuz ve idempotenttir. Bir kümenin havuzu azaldığında
veya daha yeni fotoğraf istediğinizde (
after_dateya dasort_by=newest) yenileyin — bir istek, ve zaten yayımlanmış hiçbir şey yer değiştirmez. - Yerel diller bedavaya gelir. Bir makalenin 20 çevirisi, sizin modelinizde 20
render'lı tek bir sayfadır; atanmış
photo_id'yi paylaşırlar ve asla iki kez arama yapmazsınız. Gerçekten yerel çekimli bir görünüm istediğinizde, o küme için havuz sorgusunu hedef dilde çalıştırın — motor, 100'den fazla dilde bir cümleyi kabul eder.
İşçi (worker), kod olarak
Kabaca altmış satır. Havuz doldurucu, ağla konuşan tek parçadır, dolayısıyla dikkatli olması
gereken tek parça budur — eşzamanlılık sınırlı, 429 saygı görüyor, sonuçlar tek bir
işlemde yazılıyor.
import asyncio, os, time, httpx

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
KEY    = os.environ["PEXAFY_API_KEY"]
FIELDS = "photo_id,urls,width,height,blur_hash,alt_description,attribution"

# Free = dakikada 20 istek. Bir altında kal. Hızlandırıcı GLOBAL'dir: eşzamanlılık
# kapısı içinde görev başına uyku, N işçinin oranı N katına çıkarmasına izin verir.
PER_MIN = 19
gate    = asyncio.Semaphore(4)         # eş zamanlı bağlantılar
_lock   = asyncio.Lock()
_slot   = 0.0                          # paylaşılan zaman çizelgesindeki bir sonraki boş an

async def pace():
    """Filo genelinde her 60/PER_MIN saniyede bir istek slotu ver."""
    global _slot
    async with _lock:
        now  = time.monotonic()
        _slot = max(now, _slot) + 60 / PER_MIN
        wait  = _slot - now
    if wait > 0:
        await asyncio.sleep(wait)

class QuotaExhausted(Exception): ...   # aylık: yeniden denemek yardımcı olamaz

async def fill_pool(client, cluster) -> list[dict]:
    """Bir istek → bir konu kümesi için 100'e kadar kredili fotoğraf."""
    for attempt in range(4):
        await pace()
        async with gate:
            r = await client.get(
                SEARCH,
                headers={"X-Api-Key": KEY},
                params={
                    "q": cluster["camera_brief"],   # bir sahne, bir anahtar kelime değil
                    "per_page": 100,
                    "orientation": "landscape",
                    "score_threshold": 0.5,
                    "fields": FIELDS,
                },
                timeout=15,
            )
        if r.status_code == 429:
            retry_after = r.headers.get("Retry-After")
            if retry_after is None:            # Retry-After yok ⇒ aylık kota,
                raise QuotaExhausted(cluster["id"])   # tüm çalıştırmayı durdur
            await asyncio.sleep(int(retry_after))   # dakikalık: kendini temizler
            continue
        r.raise_for_status()
        return r.json()["data"]
    return []                                  # kaydet; havuz eski satırlarını korur

async def refill(clusters):
    async with httpx.AsyncClient(http2=True) as client:
        pools = await asyncio.gather(*(fill_pool(client, c) for c in clusters))
    for cluster, photos in zip(clusters, pools):
        db.upsert_pool(cluster["id"], photos)     # photo_id üzerinde ON CONFLICT DO NOTHING
Buradaki iki detay, gözetimsiz çalışan bir işçi ile sizi gece yarısı uyandıran bir işçi arasındaki
farktır. Hızlandırıcı görev başına değil, globaldir: uykuyu eşzamanlılık kapısının
içine koymak klasik hatadır — kendi isteklerinden sonra 3 saniye duraklayan dört işçi, her
3 saniyede dört istek üretir, yaklaşık dakikada 75, ve ücretsiz plan derhal 429
döndürmeye başlar. Ve iki 429 aynı canavar değildir: dakikalık olanı
Retry-After taşır ve kendini temizler; aylık kota olanı bunu taşımaz ve asla
taşımayacaktır — onu yeniden denemek bir duvara karşı döngüdür.
Her yayınlamada çalışan atama kısmı, ağa asla dokunmaz:
# Benzersizlik, dikkatli bir sorgu ile değil, şema ile zorunlu kılınır.
# Bir fotoğraf birden fazla küme havuzunda yer alabilir; ancak yalnızca BİR kez YAYIMLANABİLİR.
# CREATE UNIQUE INDEX one_use_per_photo ON image_pool (photo_id)
#        WHERE used_by_page IS NOT NULL;

def assign_hero(page_id: str, cluster_id: str) -> dict | None:
    for _ in range(5):                # kaybedilen bir yarış sadece bir sonraki fotoğrafı alır
        try:
            return db.query_one("""
                UPDATE image_pool p SET used_by_page = %s, used_at = NOW()
                WHERE p.id = (
                    SELECT c.id FROM image_pool c
                    WHERE c.cluster_id = %s AND c.used_by_page IS NULL
                      AND NOT EXISTS (              -- başka BİR küme tarafından kullanıldı mı?
                          SELECT 1 FROM image_pool u
                          WHERE u.photo_id = c.photo_id
                            AND u.used_by_page IS NOT NULL
                      )
                    ORDER BY c.rank ASC
                    LIMIT 1 FOR UPDATE SKIP LOCKED  -- paralel işçilerle güvenli
                )
                RETURNING photo_id, urls, width, height, blur_hash, alt, credit
            """, [page_id, cluster_id])
        except UniqueViolation:      # iki küme aynı milisaniyede talep etti
            continue
    return None                     # havuz kurudu → briefi genişlet, yeniden doldur

# Render: her nitelik satırdan gelir — düzen kayması yok, tahmin yok.
# <img src="{urls[regular]}" width="{width}" height="{height}"
#      alt="{alt}" loading="lazy" style="background:{blur_placeholder}">
# <figcaption>{credit}</figcaption>
İki hata modu, iki mekanizma ve her ikisine de ihtiyaç var. FOR UPDATE SKIP LOCKED,
bir küme içindeki eşzamanlılığı yönetir: sayfaları paralel üretin — ve bu hacimde
üreteceksiniz — ve iki işçi aynı milisaniyede en üst sıralı fotoğrafa uzanır.
Kısmi benzersiz indeks, herkesin unuttuğu şeyi yönetir: aynı fotoğraf, meşru bir şekilde
birkaç kümenin havuzunda görünür, çünkü komşu kümeler ("kiracılar için ev sigortası",
"…ev sahipleri için") çakışan sonuçlar döndürür. Küme başına used_by_page IS NULL
kontrolü buna karşı kördür — her küme fotoğrafın serbest olduğuna inanır. NOT EXISTS
sorguyu dürüst tutar ve indeks, eşzamanlılık altında bunu yanlış yapmayı imkânsız kılar: yarışı
kaybeden bir ihlal alır, yeniden dener ve bir sonraki fotoğrafı alır. Bu olmadan "hiçbir iki sayfa
ana görseli paylaşmaz" bir garanti değil, bir iddiadır.
Bir havuz derleme sırasında kuruduğunda, en iyi davranan yedek yöntem tekrarlamak yerine genişletmektir: kamera briefinin son cümlesini bırakın, havuz sorgusunu bir kez daha çalıştırın ve ancak o zaman en eski atanmış fotoğrafı yeniden kullanın — bunun aynı kümedeki bir sayfaya asla düşmeyeceğine dair katı bir kuralla.
Bir küme, bir havuz: gerçek bir sorgu
Bir karşılaştırma varlığını ele alalım: ev sigortası, yirmi sayfa — "kiracılar için ev sigortası", "…ev sahipleri için", "bir poliçe gerçekte neyi kapsar", on iki şehir sayfası, üç hasar rehberi. Küme için tek bir kamera briefi, tek bir istek, ve işte havuzun başı, 122 msde döndürülmüş:
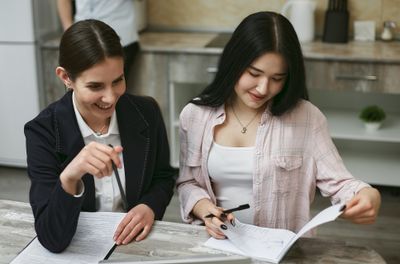
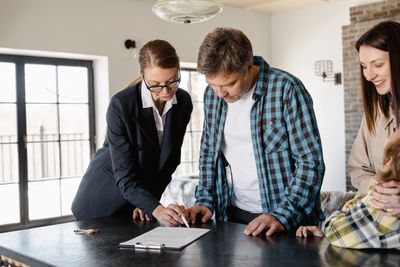
per_page=100 ister ve gerisini saklar.
Bu tam aramayı çalıştırın →
Briefler koddan daha önemlidir. Gerçek bir kümeler varlığıyla temas ettikten sonra hâlâ ayakta
kalan iki kural: brief'i sayfa için değil, küme için yazın (sayfa başlıkları
programatik kümeler genelinde neredeyse aynıdır, dolayısıyla sayfa başına brief'ler neredeyse
aynı fotoğrafları döndürür) ve konu yerine bir kameranın çekebileceği bir sahneyi tarif edin —
ev sigortası belge yakın çekimlerinden başka bir şey döndürmez. Bu briefleri
üreten kopyala-yapıştır komutunu
her makaleyi görselleştirme makalesinde
yayımladık.
200 sayfalık bir seriyi görsel olarak tutarlı tutmak
Tekrarın tersi bir hata da tutarsızlıktır: bir kümede yirmi sayfa, her birinin teknik olarak
doğru bir fotoğrafı var, ama yirmi farklı görsel kayıtta. Çözüm tek bir uç noktadır —
GET /photos/{id}/similar — sütun sayfası için onayladığınız fotoğrafta bir kez
çalıştırın:
Marka tutarlılığı bir gereksinim olduğunda havuz sorgusuna kablolanmaya değer iki lever daha var:
color_tolerance ile color_hex, tüm bir varlığı bir paletin içinde tutar
ve photographer bir kümeyi tek bir fotoğrafçının çalışmalarına sabitler. İkisi de
sıradan sorgu parametreleridir — arama filtrelerinde plan kısıtlaması yoktur.
Hız limitleri, kotalar ve gerçek maliyet
Planı hacme göre değil, ani yüke (burst) göre seçin. Havuzlama yaptığınızda, aylık kota neredeyse herkes için kısıt olmaktan çıkar; planınızı belirleyen şey, tam bir yenilemenin ne kadar hızlı bitmesi gerektiğidir.
| Plan | İstek / ay= yenilenebilir küme sayısı | Hız limiti | API anahtarları | 1.000 kümeyi yenilegerçek zaman, tek geçiş |
|---|---|---|---|---|
| Free — $0 | 5,000 | 20 / dk | 1 | 50 min |
| Starter — $5 | 25,000 | 30 / dk | 3 | 34 min |
| Pro — $19 | 100,000 | 60 / dk | 5 | 17 min |
| Team — $99ajanslar: müşteri başına bir anahtar | 500,000 | 200 / dk | 25 | 5 min |
| Business — $249 | 1,000,000 | 300 / dk | unlimited | 4 min |
| Enterprise — $599 | 2,000,000 | 500 / dk | unlimited | 2 min |
İlk sütunu küme olarak okuyun: bir havuzlama isteği bir kümeyi doldurur, dolayısıyla aylık kota yenileyebileceğiniz küme sayısıdır ve son sütun, 1.000 kümelik bir varlığın tam bir geçişinin o planın hız limitinde ne kadar sürdüğüdür. İkisi de fiyatlandırma kataloğundan gerçek değerlerdir — fiyatlandırma sayfası aynı hız limitlerini dakika başına değil saat başına belirtir.
Yani havuzlanmış desende ayda 10.000 sayfalık bir varlık ~500 istek harcar ve hiçbir şey ödemez. Ekipleri tabloda yukarı iten şey nadiren hacimdir — bu üç şeyden biridir: mevcut bir varlığın bir gecede tam bir yeniden görselleştirmesi, müşteri başına anahtar izolasyonu (bir ajans, paylaşılan gizli anahtar cambazlıkları olmadan kullanımın ilişkilendirilebilir olması için müşteri başına bir anahtar ister) veya saatler yerine dakikalarla ölçülen bir derleme penceresi.
Bir gece hata ayıklamayı kurtaran iki operasyonel detay. Her yanıt X-RateLimit-Limit
ve X-RateLimit-Remaining taşır, böylece bir işçi tahmin etmek yerine kendi hızını
ayarlayabilir. Ve gerçek bir dakikalık hız limiti olan bir 429,
Retry-After taşır; aylık kota bloğu ise bilinçli olarak taşımaz — yeniden
denemek onu temizlemez ve ikisini ayırt eden bir işçi, artık verecek hiçbir şeyi olmayan bir uç
noktayı dövmeyi bırakır.
Yayınlamayı ajan yaptığında
İçeriğiniz bir ajan tarafından üretiliyorsa — ve bu hacimlerde giderek daha fazla üretiliyor —
havuzlama katmanı ortadan kalkmaz, yer değiştirir. Ajana arama araçlarını verin ve küme
brief'ini hâlâ bağlamında tutarken havuzu doldursun, mcp.pexafy.com/mcp'deki
Model Context Protocol sunucusunu kullanarak: üç araç,
search_photos (bir cümle), search_photos_by_image (bir referans
görsel, isteğe bağlı bir cümleyle birlikte) ve get_similar_photos (yukarıdaki seri
tutarlılığı aracı).
# Claude Code / CI çalıştırıcı
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# veya .mcp.json'ı commit edin, böylece filodaki her işçi bunu miras alır
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
Ölçekte işe yarayan talimat, makale başına değil, toplu bir talimattır — ve yukarıdaki iki aşamaya bire bir karşılık gelir:
You  İşte içerik takviminden 12 konu kümesi. Her biri için bir
     kamera briefi yaz, 100 yatay fotoğraf çek ve havuzu
     Postgres'e yaz. 0,5 üzerinde 40'ın altında sonuç döndüren
     herhangi bir kümeyi işaretle — o brieflerin yeniden yazılması gerekiyor.

Agent  → search_photos(q="a woman signing paperwork with an insurance
           agent at a kitchen table in her home", orientation="landscape")
      ← 100 fotoğraf · 122 ms · eşiğin üzerinde 87 tane
      … 11 küme daha …

      ✓ 11 havuz yazıldı (1.043 fotoğraf, hepsi kredili)
      ⚠ "index fund rebalancing" → 12 sonuç. Brief soyut;
        önerilen: "a person at a kitchen table checking figures on a
        laptop with a notebook and coffee beside them"
O son satır, ajanı bir betik yerine bu döngüye koymanın nedenidir: programatik görselleştirmenin hata modu kötü bir brieftir ve kötü bir brief, tam olarak bir dil modelinin fark edip yeniden yazabileceği bir şeydir. Betikler, determinizmin önemli olduğu ve yaratıcılığın önemli olmadığı atama işini üstlenmeye devam eder.
Fotoğrafların düzeltemeyeceği şeyler
Dürüst bir bölüm, çünkü anlattığı hata maliyetlidir. Gerçek, kredili fotoğrafçılık bir sayfayı iyileştirir. Zayıf içeriği iyi içeriğe dönüştürmez ve hiçbir görsel hattı, arama motorlarının yardımcı olmak yerine sıralamada yükselmek için var olan, kitlesel üretilmiş sayfalara nasıl davrandığını değiştiremez. Google'ın spam politikaları bunu doğrudan adlandırır: ölçekli içerik istismarı, otomasyon dahil olsun ya da olmasın, az değer sunan çok sayıda sayfa üretmeyi kapsar ve o sayfalardaki görseller bu yargıyla ilgisizdir.2
Yani faydalı çerçeveleme dar ve doğrudur: fotoğrafçılık, zaten var olmayı hak eden sayfalarda kontrol ettiğiniz bir kalite sinyalidir. Kanıtlanabilir şekilde işe yaradığı yerler:
- Okuyucunun doğrulayabileceği kaynak bilgisi. Bir fotoğrafçının adı ve bir kaynak URL'si içeren bir kredi satırı, kontrol edilebilir bir iddiadır — atıfsız bir yazara sahip bir sayfadaki atıfsız bir görselin tam tersi.
- Erişilebilirlik ve Core Web Vitals. Yanıttan gelen
width/heightdüzen kaymasını ortadan kaldırır,blur_hashgerçek bir yer tutucu verir vealt_description, şablonunuzun icat etmek yerine iyileştirebileceği bir alt metin taslağıdır. 40.000 yuvayla çarpın, sitenin tüm görsel kalitesi hikâyesi budur. - Kitlesel üretilmiş görünmemek. Tekrar önleme ve seri tutarlılığı, bir varlığın görsel bir imzaya sahip olmasını engelleyen şeylerdir. Bu gerçek sonuçları olan gerçek bir algı maliyetidir ve tamamen sizin kontrolünüzdedir.
Ve lisans, görseli yönetmeye devam eder. Atıf, Pexafy API şartlarınca zorunlu değildir — her
sonuç, render edilmeye hazır attribution.html ve attribution.plain
ile gelir — ama orijinal kütüphane tarafından eklenen lisans, o fotoğrafı kullanımınıza uygulanır
ve ayda 40.000 görselde, krediyi otomatik olarak render etmek, sonradan denetlemekten daha
ucuzdur.
Pazartesi nereden başlanır
- Birikimi kümelere ayırın, makul bir fotoğraf çekimini paylaşabilecek 15–30 sayfalık kümeler halinde. Bu, gerçekten manuel olan tek adımdır ve bir proje değil, bir çizelgedir.
- Küme başına tek bir kamera briefi yazın — bir sahne, 12 ila 25 kelime. Bir modelle üretin, sonra okuyun; konuyu adlandıran, sahneyi değil, briefler bir bakışta fark edilebilir.
- Tek bir
per_page=100istekle bir havuzu doldurun ve başını göz ile kontrol edin. En üstteki on kullanılabilir değilse, sorun brief'tedir — motor değil. - Herhangi bir şey yayımlamadan önce
used_by_pagesütununu ekleyin. Şimdi beş dakika sürer, sonradan 3.000 canlı sayfada bir geçiş (migration) sürer. - Bir derleme penceresi sizi yukarı zorlayana kadar tüm bunu ücretsiz planda çalıştırın. Ayda 500 istekte, bir süre alacaktır.
Kaynaklar ve dipnotlar
1 AB Yapay Zeka Yasası, Madde 50 — 2 Ağustos 2026'dan itibaren geçerli şeffaflık yükümlülükleri: sentetik görsel, ses, video veya metin üreten sistemlerin sağlayıcıları, çıktıları makine tarafından okunabilir bir biçimde işaretlemeli ve yapay olarak üretildiklerini tespit edilebilir kılmalıdır. Bu, yapay zeka sağlayıcılarını ve kullanıma sunanları bağlar; bir web sitesinin hangi görselleri yayımlayabileceğine dair bir kural değildir.
2 Google Arama spam politikaları — ölçekli içerik istismarı: otomasyon, insan çabası veya bir kombinasyonuyla oluşturulmuş olsun olmasın, öncelikle sıralamaları manipüle etmek amacıyla çok sayıda sayfa üretmek ve kullanıcılara az değer sunmak. Görselleştirme kalitesi bu değerlendirmede bir faktör değildir, bu tam olarak bu makalenin ikisini neden ayırdığıdır.
17 Ağustos 2026'da kontrol edilen kaynaklar: Google Arama spam politikaları · AI Act Madde 50 · Pexafy API & MCP belgeleri. Plan limitleri, Pexafy fiyatlandırma tablosundaki gerçek değerlerdir; arama süreleri (122 ms, 48 ms) ve gösterilen her fotoğraf, aynı gün yakalanan gerçek API yanıtlarıdır.
Sıkça sorulan sorular
Binlerce programatik SEO sayfası için görselleri nasıl elde ederim?
per_page=100 parametresiyle tek bir GET /api/v1/search/photos isteği bir küme için 100'e kadar kredili fotoğraf döndürür; bunları bir havuz tablosunda saklar ve yayınlama anında her sayfaya bir tane atarsınız. Sayfa başına dört görsel içeren, ayda 10.000 sayfalık bir varlık, 40.000 yerine yaklaşık 500 istek gerektirir ve bu da ücretsiz plana (ayda 5.000 istek) sığar.Yüksek hacimli içerik üretimi için en iyi stok fotoğraf API'si hangisidir?
Aynı stok fotoğrafın birden fazla sayfada görünmesini nasıl engellerim?
photo_id'sini saklayın ve fotoğrafları havuzdan transaction içinde talep edin — SQL'de bu, UPDATE … WHERE used_by_page IS NULL … FOR UPDATE SKIP LOCKED şeklinde olur. Böylece tekrar önleme olasılıksal değil kesin hale gelir ve paralel build worker'ları en üst sırada yer alan aynı fotoğraf için yarışamaz. Bu tek bir sütundur ve binlerce canlı sayfaya sonradan eklemek, ilk günden itibaren eklemekten çok daha maliyetlidir.Tek bir API isteği kaç fotoğraf döndürebilir?
per_page=100 ile 100'e kadar, ayrıca cursor sayfalama sayesinde daha derin havuzlar için aynı sıralı sonuç kümesinde ilerlemeye devam edebilirsiniz. Bunu score_threshold ile birleştirin ki zayıf bir küme 100 gevşek eşleşme yerine 40 güçlü eşleşme döndürsün; ayrıca fields ile şablonunuzun render ettiği özellikleri döndürün, bu da hacimde yanıtları küçük tutar.Gerçek fotoğraflar, ölçekte üretilen sayfaların daha iyi sıralanmasına yardımcı olur mu?
Bir AI ajanı bir görsel havuzunu otomatik olarak doldurabilir mi?
mcp.pexafy.com/mcp adresindeki Pexafy'nin barındırılan MCP (Model Context Protocol) sunucusu üzerinden; bu sunucu search_photos, search_photos_by_image ve photo_similar araçlarını sunar. Ajana bir küme listesi verin; her biri için bir kamera brifi yazar, havuzları çeker ve yeterince güçlü eşleşme döndürmeyen brifleri işaretler — bu da programatik görsellendirmenin gerçek başarısızlık modudur. Atama, determinizmin yaratıcılıktan daha önemli olduğu scriptlerinizde kalır.

