আপনি যে প্রতিটি আর্টিকেল প্রকাশ করেন তা কীভাবে ইলাস্ট্রেট করবেন — আসল ছবি দিয়ে, বড় পরিসরে
কেন প্রকাশনা দলগুলো আবার আসল ফটোগ্রাফির দিকে ফিরে যাচ্ছে, এবং সেই সঠিক পাইপলাইন — প্রম্পটসহ — যা একটি সম্পূর্ণ খসড়াকে প্রায় ১৫০ মিলিসেকেন্ডে একটি ক্রেডিটযুক্ত হিরো ইমেজে রূপান্তরিত করে।
 Marouane Tijani
10 মিনিট পড়া

আপনার প্রকাশিত প্রতিটি নিবন্ধের জন্য একটি ছবি দরকার। এটি নিছক একটি বাড়তি সুবিধা নয় — হিরো ইমেজই হলো সেই জিনিস যা সোশ্যাল প্রিভিউতে দেখা যায়, প্রথম বাক্যের আগেই পাঠক যা দেখেন, এবং আধা সেকেন্ডে যা তাদের বলে দেয় এই পাতাটি এমন কেউ তৈরি করেছে কিনা যে বিষয়টি নিয়ে যত্নশীল ছিল। প্রতি পোস্টে চারটি ছবি এবং প্রতি ত্রৈমাসিকে চল্লিশটি পোস্ট গুণ করলে, “একটি ছবি খুঁজে বের করা” আর একটি কাজ থাকে না — তা হয়ে ওঠে একটি পাইপলাইন সমস্যা।
আমরা এভাবে এটি সমাধান করি: জেনারেট করা ছবির বদলে কী ব্যবহার করা উচিত এবং কেন, এবং কর্মপ্রবাহে Pexafy যুক্ত করার তিনটি উপায় — হাতে, এপিআই দিয়ে, অথবা একটি এআই এজেন্টের মাধ্যমে — সেই প্রম্পটসহ যা একটি সম্পন্ন খসড়াকে এমন একটি অনুসন্ধান বাক্যে রূপান্তরিত করে যা সত্যিই কিছু খুঁজে পায়।
কেন আসল ছবি এখনও জেনারেট করা ছবির চেয়ে ভালো
একটি ইলাস্ট্রেশন জেনারেট করা সহজ, এবং সেটাই সমস্যা। “এআই ছবি একটি সহজ শর্টকাট” থেকে আজকের অবস্থানে আসার মাঝে চারটি জিনিস বদলে গেছে:
১ · বেশি পরিমাণে, খোঁজা জেনারেট করার চেয়ে দ্রুত
একটি জেনারেশনে থাকে একটি প্রম্পট, একটি অপেক্ষা, একটি পরিদর্শন, এবং — সত্যি বলতে — ব্যবহারযোগ্য একটি পাওয়ার আগে আরও দুই-তিনটি চেষ্টা। একটি সিমান্টিক সার্চ হলো একটিমাত্র অনুরোধ যা প্রায় ১৫০ মিলিসেকেন্ডে ষোলোটি প্রার্থী নিয়ে ফিরে আসে, প্রতিটিই ইতিমধ্যে লাইসেন্সপ্রাপ্ত, ইতিমধ্যে ক্রেডিটেড, ইতিমধ্যে আকার-নির্ধারিত, প্রতিক্রিয়ায় এর মাত্রাসহ। একটি ছবির জন্য এই পার্থক্য একটি কফির সমান। ত্রৈমাসিকে চারশো ছবির জন্য এটাই কর্মপ্রবাহ আর একটি কাজের মধ্যেকার পার্থক্য।
২ · একটি আলোকচিত্র সঠিক; একটি জেনারেশন সম্ভাব্য
যে মুহূর্তে আপনার নিবন্ধ কোনো বাস্তব বিষয় নিয়ে হয় — একটি পেশা, একটি সরঞ্জাম, একটি শহর, একটি ভঙ্গি, একটি উপাদান — একটি জেনারেট করা ছবি ভাব ঠিক ধরে কিন্তু বিবরণে ভুল করে। ছয় আঙুলের হাত হলো রসিকতার সংস্করণ; ব্যয়বহুল সংস্করণ হলো এমন একটি অস্ত্রোপচার যন্ত্র যা বাস্তবে নেই, উদ্ভাবিত নিয়ন্ত্রণসহ একটি ককপিট, বা এমন এক “লিসবনের রাস্তা” যা লিসবনের কেউ চেনেন না। যেসব পাঠক আপনার বিষয় জানেন তারা লক্ষ্য করেন, এবং প্রথমে ছবিটাই লক্ষ্য করেন।
৩ · সবার একই লুক
ডিফিউশন মডেলগুলো একটি নির্দিষ্ট ঘরানার দিকে অভিসৃত হয়, এবং নরম-গ্রেডিয়েন্ট, অতিরিক্ত-আলোকিত, সন্দেহজনকভাবে প্রতিসম ইলাস্ট্রেশনের একটি দেয়াল এখন ভরাট উপকরণ হিসেবে পড়া হয়। এই ধারণাই আসল খরচ: শাস্তি নয়, একটি সংকেত। একটি প্রকৃত আলোকচিত্র — দানা, একটি অস্বস্তিকর চেয়ার, কেউ বাক্যের মাঝপথে — প্রতিবেদন হিসেবে পড়া হয়।
৪ · আর এখন সেগুলো একটি লেবেল সহ আসে
এটি যুক্তির চেয়ে বেশি প্রসঙ্গ, তবে এটাই এখনকার প্রবণতা। ২ আগস্ট ২০২৬ থেকে, ইইউ এআই অ্যাক্টের অনুচ্ছেদ ৫০ জেনারেটিভ সিস্টেম প্রদানকারীদের সিন্থেটিক আউটপুট মেশিন-পাঠযোগ্য ফরম্যাটে চিহ্নিত করতে এবং ডেপ্লয়ারদের ডিপফেক প্রকাশ করতে বাধ্য করে।1 শনাক্তকরণের দিক থেকে, Google, C2PA কন্টেন্ট ক্রেডেনশিয়াল এবং নিজস্ব SynthID ওয়াটারমার্ক পড়ে Search, Images এবং Lens-এর মধ্যে “এটি কি এআই-জেনারেটেড?” প্রশ্নের উত্তর দিতে।2 এর মধ্যে কোনোটিই কোনো ব্লগ কোন ছবি প্রকাশ করতে পারবে তার নিয়ম নয়, এবং এর কোনোটিই আপনার র্যাঙ্কিংয়ের খরচ নয়। যা বদলেছে তা হলো নিচের দিকে: আপনার নিবন্ধের শীর্ষে থাকা ছবির উৎস এখন এমন কিছু যা একজন পাঠক দুই ক্লিকে যাচাই করতে পারেন, আপনাকে জিজ্ঞাসা না করেই। একটি লাইসেন্সপ্রাপ্ত আলোকচিত্রের ঘোষণা করার মতো কিছু নেই।
যখন জেনারেট করা ছবি সঠিক পছন্দ। ধারণাগত চিত্র ও স্কিমাটিক। এমন একটি দৃশ্য যা ছবি তোলা সম্ভব নয় (এমন একটি পণ্য যা এখনও নেই, একটি বিমূর্ত প্রক্রিয়া, একটি ভবিষ্যতের শহর)। একটি নিজস্ব ইলাস্ট্রেশন ধরন যা আপনার মালিকানাধীন এবং প্রতিটি পোস্টে পুনরাবৃত্তি করতে চান। এবং এমন যেকোনো কিছু যেখানে ছবিটিকে ইচ্ছাকৃতভাবে প্রমাণ হিসেবে না দেখে ইলাস্ট্রেশন হিসেবে বোঝা হয়। উভয়ই ব্যবহার করুন — শুধু “আমার একটি মিটিংয়ে থাকা মানুষদের ছবি দরকার”-এর জন্য জেনারেশনকে ডিফল্ট হিসেবে ব্যবহার করা বন্ধ করুন।
আপনার পরিমাণ অনুযায়ী চিত্রিত করার তিনটি উপায়
একই ইঞ্জিন, একই ক্যাটালগ — 9টি লাইব্রেরি থেকে 9M+ বিনামূল্যে-ব্যবহারযোগ্য ছবি — এবং তিনটি প্রবেশ পথ। আপনার প্রযুক্তিগত দক্ষতা অনুযায়ী নয়, বরং আপনি কতগুলো নিবন্ধ প্রকাশ করেন তার ভিত্তিতে বেছে নিন।
| প্রবেশ পথ | উপযুক্তকার জন্য ও কতটুকু | প্রতি নিবন্ধে | যা লাগবে |
|---|---|---|---|
| সার্চ ইউআই | সম্পাদকরা, একবারে একটি পোস্ট — মাসে প্রায় ২০ পর্যন্ত | ~৩০ সেকেন্ড | একটি ব্রাউজার। খোঁজার জন্য অ্যাকাউন্ট লাগে না। |
| REST API | একটি সিএমএস, একটি স্ট্যাটিক-সাইট বিল্ড, খসড়ার একটি ব্যাচ | ~১ অনুরোধ, ~১৫০ মিলিসেকেন্ড | একটি এপিআই কী। মাসে ৫,০০০ অনুরোধ বিনামূল্যে, প্রতি মিনিটে ২০। |
| MCP সার্ভার | যে এআই এজেন্ট খসড়া লেখে বা সম্পাদনা করে | একই কথোপকথনের মধ্যে | একটি কানেক্টর ইউআরএল, OAuth বা একটি কী। |
তিনটিই একটি ক্যাটালগ ও একটি র্যাঙ্কিং ভাগ করে, তাই ইউআই-তে একজন সম্পাদক খুঁজে পাওয়া একটি ছবি এবং একই আইডেন্টিফায়ারসহ এপিআই আপনার বিল্ড স্ক্রিপ্টে যে ছবি ফেরত দেয়, তা একই ছবি।
একটি নিবন্ধ, ৩০ সেকেন্ড: সার্চ ইউআই
দৃশ্যটি বর্ণনা করুন যেভাবে আপনি একজন আলোকচিত্রীর কাছে বর্ণনা করতেন, একটি পূর্ণ বাক্যে, নিজের ভাষায়। team meeting নয় —
“a small team standing in a semi circle for a short morning stand-up meeting in a bright
open plan office”। প্রতিটি অতিরিক্ত সুনির্দিষ্ট বিবরণ ফলাফলের সেটকে খালি না করে বরং সংকীর্ণ করে, কারণ ইঞ্জিন অর্থ অনুযায়ী র্যাঙ্ক করে, আপনার শব্দগুলোকে কারও ট্যাগের সাথে মেলানোর মাধ্যমে নয়।
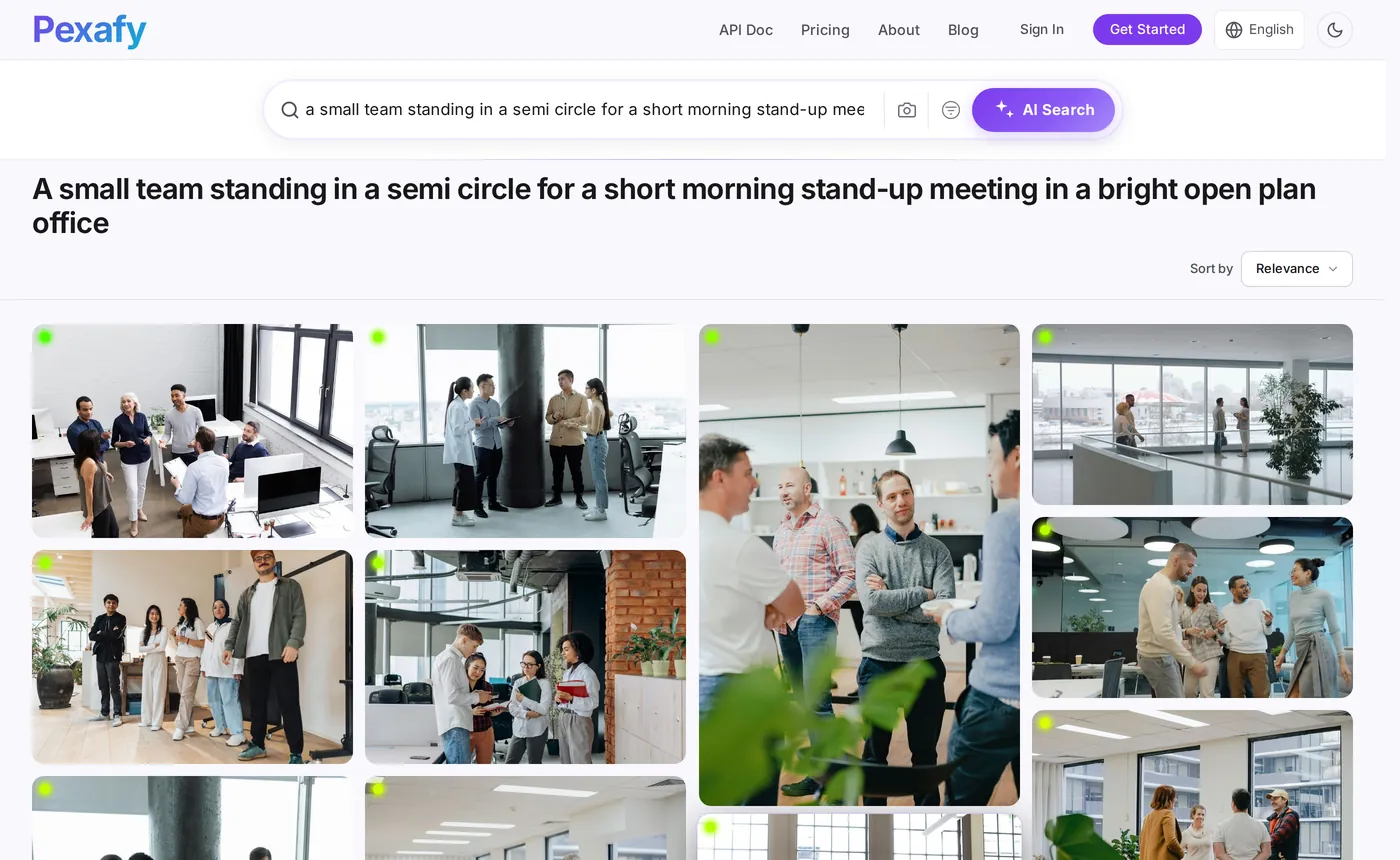
এরপর একটি নিবন্ধের বিন্যাসের জন্য গুরুত্বপূর্ণ ফিল্টার দিয়ে এটি সংকীর্ণ করুন — এবং শুধু সেগুলোই:
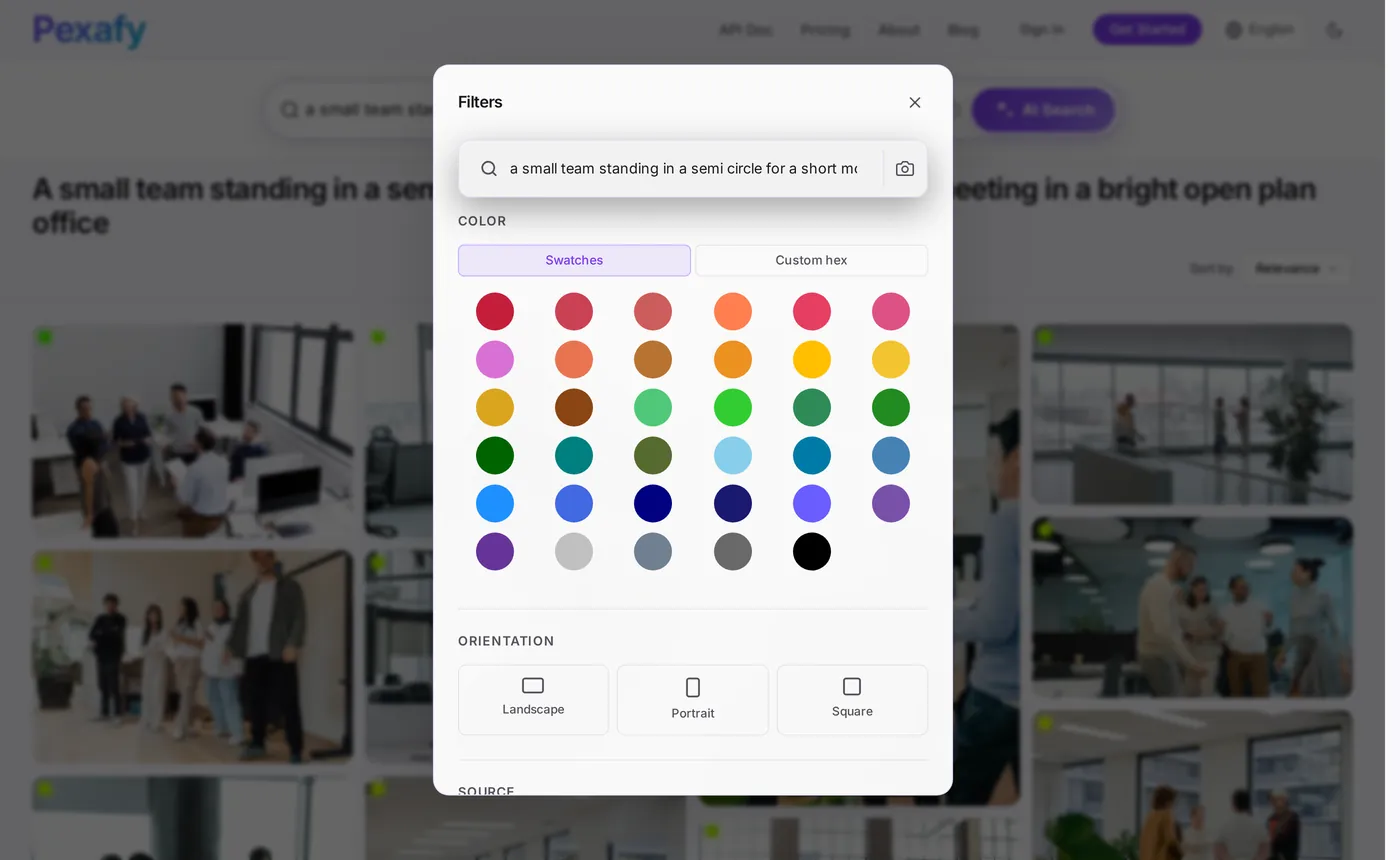
- কিওয়ার্ড নয়, বাক্য লিখুন। বিষয় + কাজ + স্থান + আলো। ১০০+ ভাষার যেকোনো একটিতে ৫০০ অক্ষর পর্যন্ত।
- হিরোর জন্য ল্যান্ডস্কেপে ফিল্টার করুন, তারপর নিবন্ধের ভেতরের ছবির জন্য ফিল্টার ছাড়াই আবার চালান, যেখানে পোর্ট্রেট প্রায়ই বেশি ভালো দেখায়।
- প্রস্তুত অ্যাট্রিবিউশন লাইন, মূল উৎস পাতা এবং সম্পূর্ণ-রেজোলিউশনের ফাইল পেতে ছবিটি খুলুন।
- একই দৃশ্য-ব্যবস্থায় পরের বিভাগ চিত্রিত করতে যে ছবিটি বেছে নিয়েছেন তাতে “অনুরূপ ছবি” ব্যবহার করুন — একই আলো, একই ট্রিটমেন্ট, ভিন্ন দৃশ্য।
প্রম্পট: একটি খসড়াকে একটি অনুসন্ধান বাক্যে রূপান্তরিত করা
স্বয়ংক্রিয় করার সময় সবাই এই ধাপেই ভুল করে। তারা নিবন্ধের শিরোনাম সরাসরি সার্চ বক্সে দেয়, এবং শিরোনামটিই ঠিক ভুল ইনপুট: এটি বিমূর্ত (“The hidden cost of context switching”) এবং পৃথিবীর কোনো আলোকচিত্র তা চিত্রিত করে না। মডেল থেকে আপনি যা চান তা কোনো সারাংশ নয় — এটি একটি ক্যামেরা ব্রিফ।
# system prompt
You are a photo editor. Read the article and write ONE search sentence
for a stock-photo engine that ranks by meaning, not by keywords.

Rules:
1. Describe a scene a camera could have taken: someone doing
   something, somewhere. Never name the topic itself ("fintech",
   "productivity", "SEO") — name what would be in the frame.
2. 12 to 25 words. Longer beats shorter: every concrete detail
   (light, place, gesture, time of day) sharpens the match.
3. No text, logos, brands, charts, screenshots or famous people.
   Free photo libraries have almost none of those.
4. No invisible metaphors ("growth", "synergy", "transformation").
5. Match the mood of the article: calm, tense, tired, celebratory.
6. Write the sentence in English even if the article is not.

Return JSON only:
{ "query": "…", "orientation": "landscape", "alt": "…" }
নিয়ম ১ বেশিরভাগ কাজ করে। এখানে তিনটি আসল খসড়ায় একই নিয়ম — মাঝের কলামটি হলো একজন মানুষ তাড়াহুড়োয় যা টাইপ করে, ডান কলামটি হলো প্রম্পট যা ফেরত দেয়:
| নিবন্ধটি যে বিষয়ে… | তাড়াহুড়োর প্রশ্ন | ক্যামেরা ব্রিফ |
|---|---|---|
| কেন আপনার দৈনিক স্ট্যান্ড-আপ ভেঙে পড়েছে | team meeting |
“a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office” |
| অনবোর্ডিং ৬ সপ্তাহ থেকে ৯ দিনে কমানো | onboarding |
“a new employee on their first day at a desk, listening while a colleague leans in and points at their screen” |
| প্রসঙ্গ পরিবর্তনের লুকানো খরচ | productivity |
“a tired developer rubbing their eyes in front of two monitors late in the evening, the office empty behind them” |
team meeting সেই সাধারণ কনফারেন্স-রুম স্টক ফিরিয়ে দেয় যা আপনার বিষয়ে থাকা প্রত্যেকে ইতিমধ্যে ব্যবহার করছে। তৃতীয় কলামের বাক্যটি ১৫৫ মিলিসেকেন্ডে এটি ফেরত দেয়:
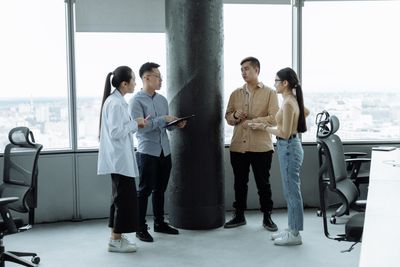

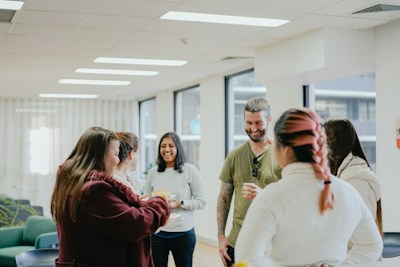
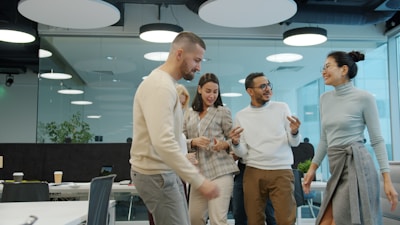
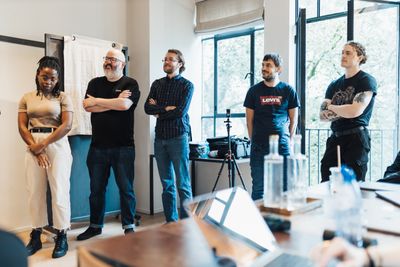
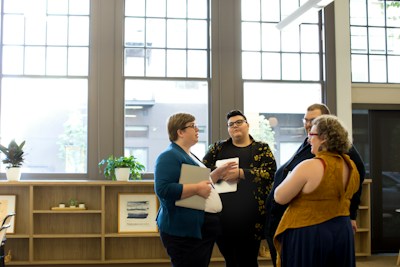
team meeting কখনোই নিশ্চিত করে না।
পাইপলাইন: খসড়া ঢুকবে, ক্রেডিটেড হিরো ইমেজ বের হবে
চল্লিশ লাইন, দুটি কল: একটি মডেলকে ব্রিফের জন্য, একটি Pexafy-কে ছবির জন্য। এটি আপনার সিএমএস সেভ হুক, স্ট্যাটিক-সাইট বিল্ড, বা মার্কডাউন ফাইলের একটি ফোল্ডার ধরে চলা একটি স্ক্রিপ্টে বসিয়ে দিন।
import json, os, requests
from anthropic import Anthropic

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
llm = Anthropic()  # ANTHROPIC_API_KEY from the environment

def camera_brief(article: str) -> dict:
    # PHOTO_EDITOR = the system prompt above
    msg = llm.messages.create(
        model="claude-sonnet-5",
        max_tokens=300,
        system=PHOTO_EDITOR,
        messages=[{ "role": "user", "content": article[:12000] }],
    )
    return json.loads(msg.content[0].text)

def illustrate(article: str) -> dict | None:
    brief = camera_brief(article)
    r = requests.get(
        SEARCH,
        headers={"X-Api-Key": os.environ["PEXAFY_API_KEY"]},
        params={
            "q": brief["query"],           # the full sentence
            "orientation": brief["orientation"],
            "per_page": 8,
            "score_threshold": 0.55,      # drop weak matches
        },
        timeout=10,
    )
    hits = r.json()["data"]
    if not hits:                        # brief too narrow → widen, retry
        return None

    top = hits[0]
    return {
        "src":    top["urls"]["regular"],        # 1080px — hero size
        "alt":    brief["alt"] or top["alt_description"],
        "credit": top["attribution"]["html"],   # ready to render
        "width":  top["width"],
        "height": top["height"],
        "id":     top["photo_id"],           # store it: no repeats
    }
তিনটি বিষয় যা একটি ডেমোকে চালিয়ে যাওয়ার মতো কিছুতে পরিণত করে:
score_threshold— কিছুই ফেরত না দেওয়া একটি খারাপ ছবি ফেরত দেওয়ার চেয়ে ভালো। ব্রিফটি যদি খুব নির্দিষ্ট হয়, তাহলে এটি প্রশস্ত করুন (শেষ ধারাটি বাদ দিন) এবং একবার আবার চেষ্টা করুন।photo_idসংরক্ষণ করুন — আপনার ডেটাবেসে একটি লাইন, এবং আপনার সাইটের কোনো দুটি নিবন্ধ কখনো একই হিরো ইমেজ ভাগ করবে না। এটাই সেই ব্যর্থতা যা ত্রিশতম পোস্টে সবাই ঘটায়।- প্রতি ইমেজ স্লটে একটি অনুরোধ — একটি হিরো ও তিনটি বিভাগের ছবি মানে প্রতি নিবন্ধে চারটি অনুরোধ, অথবা যদি একই সার্চ থেকে চারটি ভিন্ন ফলাফল নেন তাহলে একটি মাত্র।
পাইথন নেই? সার্চের পুরো অর্ধেকটাই একটি লাইন, এবং প্রতিটি ফলাফল যে লাইব্রেরি থেকেই আসুক না কেন একই ফিল্ড বহন করে:
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a tired developer rubbing their eyes at two monitors" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "per_page=6"

# → { "success": true, "data": [ … ], "meta": { "took_ms": 147 } }
প্রতিক্রিয়ার আকার — urls, width, photographer_full_name,
source, license_type, relevance_score,
attribution — একটি Pexels ছবি, একটি Pixabay ছবি এবং একটি Unsplash ছবির জন্য অভিন্ন। এই স্বাভাবিকীকরণটিই সেই অংশ যা আপনাকে অন্যথায় নিজে লিখতে ও রক্ষণাবেক্ষণ করতে হতো; আমরা এটি ফিল্ড বাই ফিল্ড ভেঙে দেখিয়েছি
ফ্রি স্টক ফটো এপিআই তুলনায়।
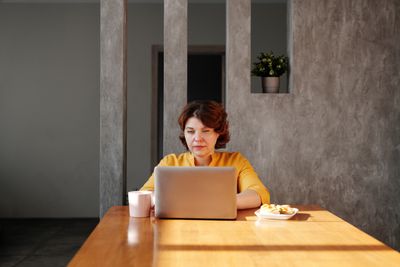
দ্বিতীয় বিভাগ, দ্বিতীয় ব্রিফ, দ্বিতীয় সার্চ — মূল কথা হলো একটি নিবন্ধ থেকে একটি ছবি চারবার প্রসারিত করার বদলে বেশ কয়েকটি স্বতন্ত্র দৃশ্য পাওয়া যায়:
এজেন্টকে ছবি বেছে নিতে দিন: MCP
যদি একটি মডেল ইতিমধ্যে খসড়া লিখছে বা সম্পাদনা করছে, তাহলে সবচেয়ে পরিচ্ছন্ন পাইপলাইন হলো কোনো পাইপলাইন না থাকা: এজেন্টকে সার্চ টুলটি দিন এবং একই কথোপকথনে সে যা লিখেছে তা চিত্রিত করতে দিন, যতক্ষণ তার কাছে প্রসঙ্গটি আছে।
Pexafy mcp.pexafy.com/mcp-এ একটি হোস্টেড Model Context Protocol সার্ভার চালায়। তিনটি টুল:
search_photos (একটি বাক্য),
search_photos_by_image (একটি রেফারেন্স ছবি, ঐচ্ছিকভাবে একটি বাক্যসহ — “এটির মতো, তবে সূর্যাস্তে”), এবং get_similar_photos (আপনি ইতিমধ্যে বেছে নেওয়া ছবির মতো আরও, যা দিয়ে আপনি একটি সিরিজকে সামঞ্জস্যপূর্ণ রাখেন)।
Settings → Connectors → Add custom connector
Name: Pexafy
URL:  https://mcp.pexafy.com/mcp
# then sign in with your Pexafy account when the window opens
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# or commit it to the repo, so the whole team gets it — .mcp.json
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
এখান থেকে, একটি নিবন্ধ চিত্রিত করা একটি কাজ নয়, একটি বাক্য। এজেন্ট নিজের ক্যামেরা ব্রিফ লেখে — সে সবেমাত্র খসড়াটি পড়েছে, তাই দৃশ্যটি বর্ণনা করার জন্য সে যে কারো চেয়ে ভালো অবস্থানে আছে:
You  Here's the draft of this week's post. Find a landscape hero
     and one photo for section 2, and give me the credit lines.

Claude  → search_photos(
       q="a small team standing in a semi circle for a short morning
          stand-up meeting in a bright open plan office",
       orientation="landscape")
     ← 16 photos · 155 ms

     Hero    → Photo by Thirdman on Pexels · 6453×4302 · score 0.80
     Section → Photo by Marcus Aurelius on Pexels · 6000×4000
     Both licence-free, attribution lines below, ready to paste.
Unsplash, Pexels, Pixabay এবং Openverse-এর কোনো অফিসিয়াল MCP সার্ভার নেই — যা আছে তা হলো কমিউনিটির তৈরি র্যাপার যা আপনাকে নিজে হোস্ট ও কী দিয়ে চালাতে হয়। যদি আপনার সম্পাদকীয় কর্মপ্রবাহ ইতিমধ্যে একটি এজেন্টের মাধ্যমে চলে, তাহলে এই পার্থক্যই হলো সংযোজন।
Alt টেক্সট, লাইসেন্স এবং পাতার গতি
ছবি নির্বাচিত হয়ে গেছে। চারটি বিষয় নির্ধারণ করে এটি পাতার সহায়ক হবে নাকি নীরবে ক্ষতি করবে:
-
alt টেক্সট একজন মানুষের জন্য লিখুন, ক্রলারের জন্য নয়। প্রতিটি ফলাফলে একটি
alt_descriptionথাকে — এটিকে খসড়া হিসেবে ব্যবহার করুন, তারপর আপনার অনুচ্ছেদের প্রসঙ্গে এটি পুনরায় লিখুন। “সকালের মিটিংয়ে দাঁড়িয়ে থাকা চারজন সহকর্মী” একটি কিওয়ার্ডের ঝাঁকির চেয়ে ভালো, এবং এটাই সেই টেক্সট যা একটি স্ক্রিন রিডার আসলে পড়বে। এটি ~১২৫ অক্ষরের নিচে রাখুন; শুধুমাত্র ছবিটি সম্পূর্ণ সজ্জামূলক হলে এটি খালি (alt="") রাখুন। -
কিছু বাধ্য না করলেও ক্রেডিট পাঠান। Pexafy এপিআই শর্তাবলীতে অ্যাট্রিবিউশন বাধ্যতামূলক নয় এবং প্রতিটি ফলাফলে একটি প্রস্তুত
attribution.htmlস্ট্রিং থাকে — কিন্তু মূল লাইব্রেরির সংযুক্ত লাইসেন্স এখনো সেই ছবির ব্যবহার নিয়ন্ত্রণ করে, এবং একটি দৃশ্যমান ক্রেডিট লাইনই একজন পাঠককে (এবং একটি উত্তর ইঞ্জিনকে) বলে দেয় যে এটি একজন প্রকৃত লেখকের একটি বাস্তব আলোকচিত্র। -
সঠিক আকার সরবরাহ করুন।
urls.regular(১০৮০ পিক্সেল) একটি হিরো;urls.fullএকটি ২৪০০ পিক্সেল ফাইল যা কোনো নিবন্ধেরই প্রয়োজন নেই। ব্রাউজার যাতে জায়গা সংরক্ষণ করে তার জন্য সবসময় প্রতিক্রিয়া থেকেwidth/heightনির্গত করুন — সেই একক অ্যাট্রিবিউট জোড়াটিই একটি ভালো ও খারাপ লেআউট-শিফট স্কোরের মধ্যে পার্থক্য। হিরোতেfetchpriority="high"এবং ভাঁজের নিচের সবকিছুতেloading="lazy"ব্যবহার করুন। -
আপনার মেটাডেটাকে হিরো সরবরাহ করুন। একই ইউআরএল আপনার
og:image, আপনারtwitter:imageএবং আপনারArticleস্ট্রাকচার্ড ডেটারimageপ্রপার্টি হওয়া উচিত। একটি ছবি, তিনটি জায়গা, কোনো অতিরিক্ত কাজ নেই — এবং একটি সোশ্যাল প্রিভিউ যা আর আপনার লোগোতে ফিরে যায় না।
মাসে ১০০টি নিবন্ধের প্রকৃত খরচ কত
ধরে নিন একটি হিরো ও তিনটি নিবন্ধের ভেতরের ছবি, তাই প্রতি পোস্টে চারটি সার্চ অনুরোধ — ইচ্ছাকৃতভাবে অপচয়মূলক সংস্করণ, যেখানে আপনি একটি থেকে ফলাফল পুনর্ব্যবহার না করে প্রতিটি স্লটের জন্য আলাদা কোয়েরি চালান:
| পরিমাণ | সার্চ অনুরোধ / মাস | পরিকল্পনা | সার্চ খরচ |
|---|---|---|---|
| ২০টি নিবন্ধ | ৮০ | ফ্রি — মাসে ৫,০০০ অনুরোধ | $0 |
| ১০০টি নিবন্ধ | ৪০০ | ফ্রি — মাসে ৫,০০০ অনুরোধ | $0 |
| ১,০০০টি নিবন্ধএকটি এজেন্সি, বা একটি সম্পূর্ণ ক্লায়েন্ট পোর্টফোলিও | ৪,০০০ | ফ্রি — এখনো মাসে ৫,০০০ অনুরোধের মধ্যে | $0 |
হ্যাঁ — কনটেন্ট-মার্কেটিং পরিমাণে মাসিক কোটা একটি অ-বিষয়, এবং আপনাকে টাকা দেওয়ার একটি কারণ উদ্ভাবন করার চেয়ে আমরা এটাই বলতে চাই। আপনি আসলে যে সীমার মুখোমুখি হবেন তা হলো প্রতি-মিনিটেরটি। ফ্রি পরিকল্পনায় প্রতি মিনিটে ২০টি এপিআই অনুরোধের অনুমতি আছে; একটি বিল্ড স্ক্রিপ্ট যা একবারে ১০০টি নিবন্ধ পুনরায় চিত্রিত করে তা আপনার লুপ যত দ্রুত পারে ততগুলো, অর্থাৎ ৪০০টি অনুরোধ পাঠায়, তাই এটি হয় বিশ মিনিট ধরে থ্রটল হয় অথবা 429 সংগ্রহ করতে শুরু করে। বেরোনোর দুটি উপায়: কলগুলো ছড়িয়ে দিন (লুপে একটি sleep, এবং একটি রাতের কাজ কখনো লক্ষ্য করবে না), অথবা এমন একটি পরিকল্পনায় যান যার রেট লিমিট আপনার বিল্ডের সাথে মেলে — Starter হলো মিনিটে ৩০টি অনুরোধ, Pro ৬০টি। বার্স্ট অনুযায়ী বেছে নিন, পরিমাণ অনুযায়ী নয়।
একমাত্র অন্য লাইনটি হলো প্রতি নিবন্ধে ব্রিফ তৈরির জন্য একটি ছোট মডেল কল — কয়েকশো টোকেন ঢুকবে, ত্রিশটি বের হবে, যা আপনার মালিকানাধীন যেকোনো কনটেন্ট পাইপলাইনের সবচেয়ে সস্তা আইটেম হবে। মাসে চারশো ছবিতে, প্রতি পোস্টে চারটি ছবি জেনারেট করার সাথে এটি তুলনা করুন, প্লাস সেই চেষ্টাগুলো যা কাটে খেল না।
এবং যে অংশটি খরচের টেবিলে দেখা যায় না: সম্পাদক পাঁচটি ট্যাব খোলা বন্ধ করে দেন। সেটাই আসল সাশ্রয়।
তথ্যসূত্র ও পাদটীকা
1 ইইউ এআই অ্যাক্ট, অনুচ্ছেদ ৫০ — নির্দিষ্ট কিছু এআই সিস্টেমের প্রদানকারী ও ডেপ্লয়ারদের জন্য স্বচ্ছতার বাধ্যবাধকতা, ২ আগস্ট ২০২৬ থেকে প্রযোজ্য। সিন্থেটিক অডিও, ছবি, ভিডিও বা টেক্সট জেনারেট করা সিস্টেমের প্রদানকারীদের অবশ্যই আউটপুট মেশিন-পাঠযোগ্য ফরম্যাটে চিহ্নিত করতে হবে এবং সেগুলোকে কৃত্রিমভাবে জেনারেটেড হিসেবে শনাক্তযোগ্য করতে হবে; ডেপ্লয়ারদের অবশ্যই ডিপফেক এবং, নির্দিষ্ট কিছু ক্ষেত্রে, জনসাধারণকে জানাতে প্রকাশিত এআই-জেনারেটেড টেক্সট প্রকাশ করতে হবে। ডিজিটাল অমনিবাস (রেগুলেশন (ইইউ) ২০২৬/১৭৪৪, ২৭ জুলাই ২০২৬ থেকে কার্যকর) অনুচ্ছেদ ৫০ নিজে অপরিবর্তিত রাখে, কিন্তু ২ আগস্ট ২০২৬-এর আগে বাজারে ইতিমধ্যে থাকা সিস্টেমগুলোকে অনুচ্ছেদ ৫০(২)-এর মেশিন-পাঠযোগ্য চিহ্নিতকরণ প্রয়োজনীয়তা পূরণ করতে ২ ডিসেম্বর ২০২৬ পর্যন্ত সময় দেয়। এই সবকিছুই এআই প্রদানকারী ও ডেপ্লয়ারদের বাঁধে — এটি কোনো ব্লগ কোন ছবি প্রকাশ করতে পারবে তার নিয়ম নয়।
2 Google, Search, Images এবং Lens জুড়ে এই ছবি সম্পর্কে-তে উৎস প্রদর্শনের জন্য C2PA কন্টেন্ট ক্রেডেনশিয়াল এবং নিজস্ব SynthID ওয়াটারমার্ক পড়ে। এটি মিডিয়া উৎসনির্ণয়, এআই-জেনারেটেড কন্টেন্টের ওপর কোনো র্যাঙ্কিং শাস্তি নয়।
১৫ আগস্ট ২০২৬-এ যাচাই করা উৎস: AI Act Article 50 · European Commission — transparency FAQ · Google — image metadata · Pexafy API & MCP docs। সার্চের সময় ও ফলাফল হলো পাবলিক এপিআই থেকে পাওয়া প্রকৃত প্রতিক্রিয়া, একই দিনে ধারণ করা।
প্রায়শই জিজ্ঞাসিত প্রশ্ন
ব্লগ আর্টিকেলের জন্য আমার কি AI-জেনারেটেড ইমেজ নাকি আসল ছবি ব্যবহার করা উচিত?
আমার আর্টিকেলের সাথে মিলে যায় এমন একটি ছবি কীভাবে স্বয়ংক্রিয়ভাবে খুঁজে পাব?
GET /api/v1/search/photos?q=…, প্রায় ১৫০ ms সময় নেয়, এবং প্রতিটি ফলাফল তার আকার, লাইসেন্স এবং একটি প্রস্তুত অ্যাট্রিবিউশন স্ট্রিং সহ ফিরে আসে।একটি আর্টিকেলকে ইমেজ সার্চ কোয়েরিতে রূপান্তর করার সেরা প্রম্পট কী?
ব্লগ পোস্টে ব্যবহৃত ছবির ক্রেডিট দেওয়া কি বাধ্যতামূলক?
Claude বা অন্য কোনো AI এজেন্ট কি আমার আর্টিকেলের জন্য ছবি খুঁজে দিতে পারে?
mcp.pexafy.com/mcp-এর মাধ্যমে। এটিকে Claude.ai বা Claude Desktop-এ একটি কাস্টম কানেক্টর হিসেবে যোগ করুন এবং OAuth দিয়ে সাইন ইন করুন, অথবা একটি claude mcp add কমান্ড এবং একটি API কী দিয়ে Claude Code-এ যোগ করুন। এরপর এজেন্টটি বাক্য দিয়ে, রেফারেন্স ইমেজ দিয়ে, অথবা নিজে থেকেই একই রকম ছবির জন্য সার্চ করতে পারে, যখন আপনার খসড়াটি এখনও তার কনটেক্সটে থাকে।আমার ব্লগের প্রতিটি আর্টিকেলে একই ছবি ব্যবহার হওয়া কীভাবে বন্ধ করব?
photo_id সংরক্ষণ করুন এবং পরবর্তী রানে সেটি বাদ দিন — আপনার CMS-এ একটি কলামই যথেষ্ট। প্রতিটি স্বয়ংক্রিয় পাইপলাইন প্রায় ত্রিশতম পোস্টের কাছাকাছি এই ব্যর্থতার মুখে পড়ে, এবং কেউ আপনার ব্লগ ইনডেক্স স্ক্রল না করা পর্যন্ত এটি অদৃশ্য থেকে যায়। আর্টিকেলের শিরোনাম পুনরায় ব্যবহার না করে প্রতিটি সেকশনের জন্য একটি নতুন ক্যামেরা ব্রিফ লেখাই বাকি কাজ সম্পন্ন করে।

