Come illustrare ogni articolo che pubblichi — con foto reali, su larga scala
Perché i team editoriali stanno tornando alla fotografia reale, e la pipeline esatta — prompt incluso — che trasforma una bozza finita in un'immagine di copertina con credito in circa 150 millisecondi.
 Marouane Tijani
10 min di lettura

Ogni articolo che pubblichi ha bisogno di un'immagine. Non è un accessorio: l'immagine principale è ciò che mostra l'anteprima social, ciò che il lettore vede prima della prima frase, e ciò che gli dice in mezzo secondo se questa pagina è stata realizzata da qualcuno a cui importava. Moltiplica per quattro immagini per post e quaranta post a trimestre, e “trovare una foto” smette di essere un compito e diventa un problema di flusso di lavoro.
Ecco come lo risolviamo: cosa usare al posto delle immagini generate e perché, e i tre modi per integrare Pexafy nel flusso di lavoro — manualmente, via API o tramite un agente AI — incluso il prompt che trasforma una bozza finita in una frase di ricerca che effettivamente trova qualcosa.
Perché le foto reali battono ancora quelle generate
Generare un'illustrazione è facile, ed è proprio questo il problema. Quattro cose sono cambiate tra “le immagini AI sono una scorciatoia” e oggi:
1 · Su grandi volumi, cercare è più veloce che generare
Una generazione è un prompt, un'attesa, un controllo e — onestamente — altri due o tre tentativi prima che uno sia utilizzabile. Una ricerca semantica è un'unica richiesta che restituisce sedici candidati in circa 150 millisecondi, ciascuno già concesso in licenza, già accreditato, già dimensionato, con le sue dimensioni nella risposta. Per un'immagine la differenza è un caffè. Per quattrocento immagini a trimestre è la differenza tra un flusso di lavoro e un lavoro a tempo pieno.
2 · Una fotografia è accurata; una generazione è plausibile
Nel momento in cui il tuo articolo parla di qualcosa di reale — una professione, un'attrezzatura, una città, un gesto, un materiale — un'immagine generata coglie l'atmosfera giusta ma sbaglia i dettagli. Le mani con sei dita sono la versione scherzosa; la versione costosa è uno strumento chirurgico che non esiste, una cabina di pilotaggio con comandi inventati, o una “strada di Lisbona” che nessun lisboeta riconosce. I lettori che conoscono il tuo argomento se ne accorgono, e se ne accorgono guardando prima l'immagine.
3 · Tutti hanno lo stesso look
I modelli di diffusione convergono su uno stile di casa, e un muro di illustrazioni dal gradiente morbido, sovrailluminate e sospettosamente simmetriche viene ormai letto come riempitivo. Quella percezione è il vero costo: non una penalizzazione, un segnale. Una fotografia reale — grana, una sedia scomoda, qualcuno a metà frase — viene letta come reportage.
4 · E ora arrivano con un'etichetta attaccata
Questo è più un elemento di contesto che un argomento, ma è la direzione in cui si va. Dal 2 agosto 2026, l'articolo 50 dell'EU AI Act richiede ai fornitori di sistemi generativi di contrassegnare gli output sintetici in un formato leggibile da macchina, e ai deployer di dichiarare i deepfake.1 Sul fronte del rilevamento, Google legge le C2PA Content Credentials e il proprio watermark SynthID per rispondere alla domanda “è generato dall'AI?” all'interno di Search, Images e Lens.2 Nulla di tutto ciò è una regola su quali immagini un blog possa pubblicare, e nulla di tutto ciò ti costa posizionamento. Ciò che è cambiato è a valle: la provenienza dell'immagine in cima al tuo articolo è ora qualcosa che un lettore può verificare in due clic, senza doverlo chiedere a te. Una fotografia con licenza non ha nulla da dichiarare.
Quando le immagini generate sono la scelta giusta. Diagrammi concettuali e schemi. Una scena che non può essere fotografata (un prodotto che non esiste ancora, un meccanismo astratto, una città futura). Uno stile illustrativo di casa che possiedi e che vuoi ripetere su ogni post. E qualsiasi caso in cui l'immagine è deliberatamente intesa come illustrazione piuttosto che come prova. Usa entrambe — semplicemente smetti di usare la generazione come opzione predefinita per “mi serve una foto di persone in riunione”.
Tre modi per illustrare, in base al tuo volume
Stesso motore, stesso catalogo — 9M+ foto gratuite da 9 librerie — e tre punti di accesso. Scegli in base a quanti articoli pubblichi, non a quanto sei tecnico.
| Punto di accesso | Adatto achi e quanto | Per articolo | Cosa ti serve |
|---|---|---|---|
| Interfaccia di ricerca | Editor, un post alla volta — fino a ~20/mese | ~30 secondi | Un browser. Non serve un account per cercare. |
| API REST | Un CMS, una build di sito statico, un lotto di bozze | ~1 richiesta, ~150 ms | Una chiave API. 5.000 richieste/mese gratis, 20/min. |
| Server MCP | L'agente AI che scrive o modifica la bozza | All'interno della stessa conversazione | Un URL del connettore, OAuth o una chiave. |
I tre condividono un unico catalogo e un unico ranking, quindi una foto trovata da un editor nell'interfaccia è la stessa foto, con lo stesso identificatore, che l'API restituisce al tuo script di build.
Un articolo, 30 secondi: l'interfaccia di ricerca
Descrivi la scena come la descriveresti a un fotografo, in una frase completa, nella tua
lingua. Non team meeting —
“a small team standing in a semi circle for a short morning stand-up meeting in a bright
open plan office”. Ogni dettaglio concreto in più restringe l'insieme dei risultati invece
di svuotarlo, perché il motore classifica in base al significato anziché confrontare le tue
parole con i tag di qualcun altro.
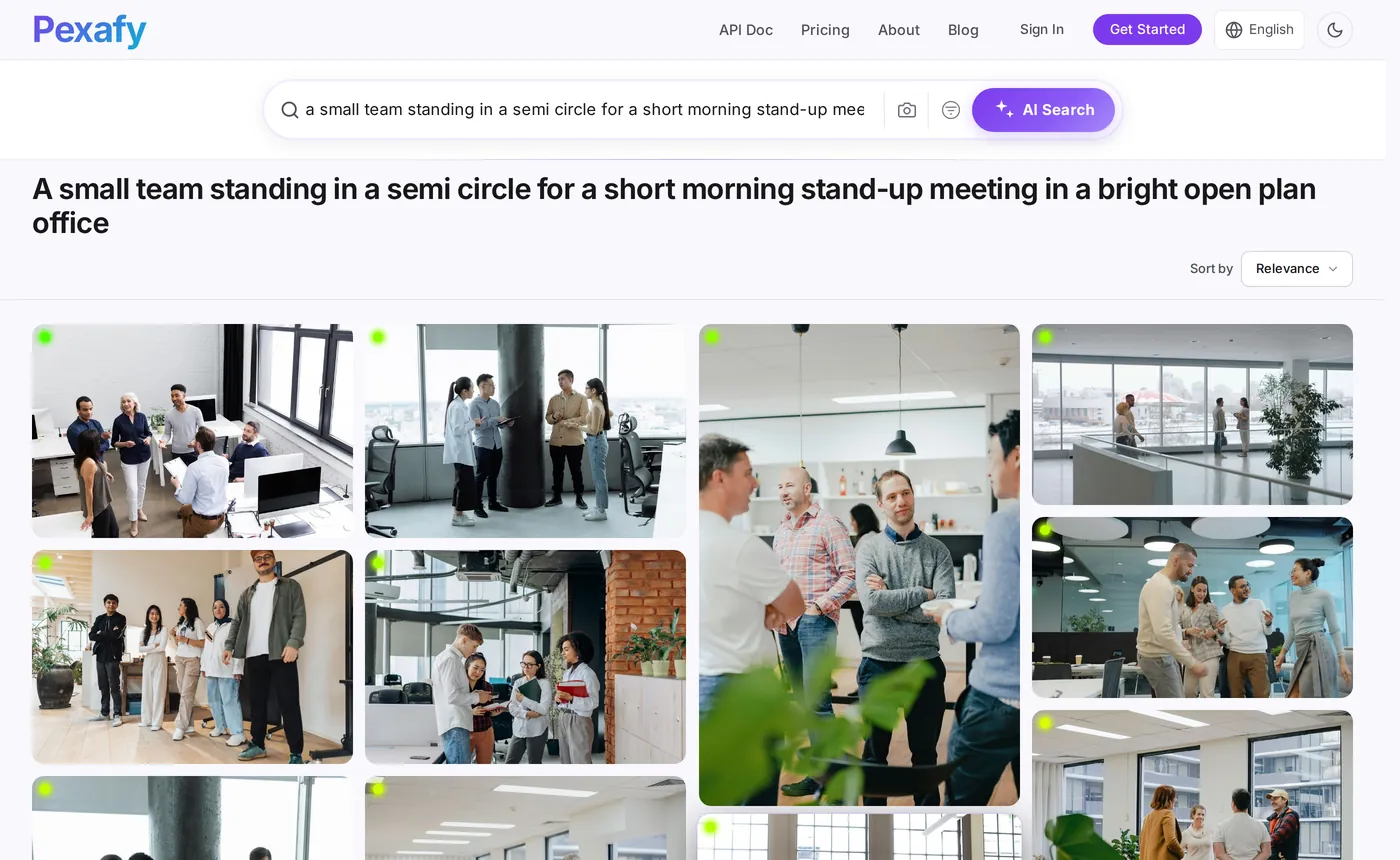
Poi restringi con i filtri che contano per l'impaginazione di un articolo — e solo quelli:
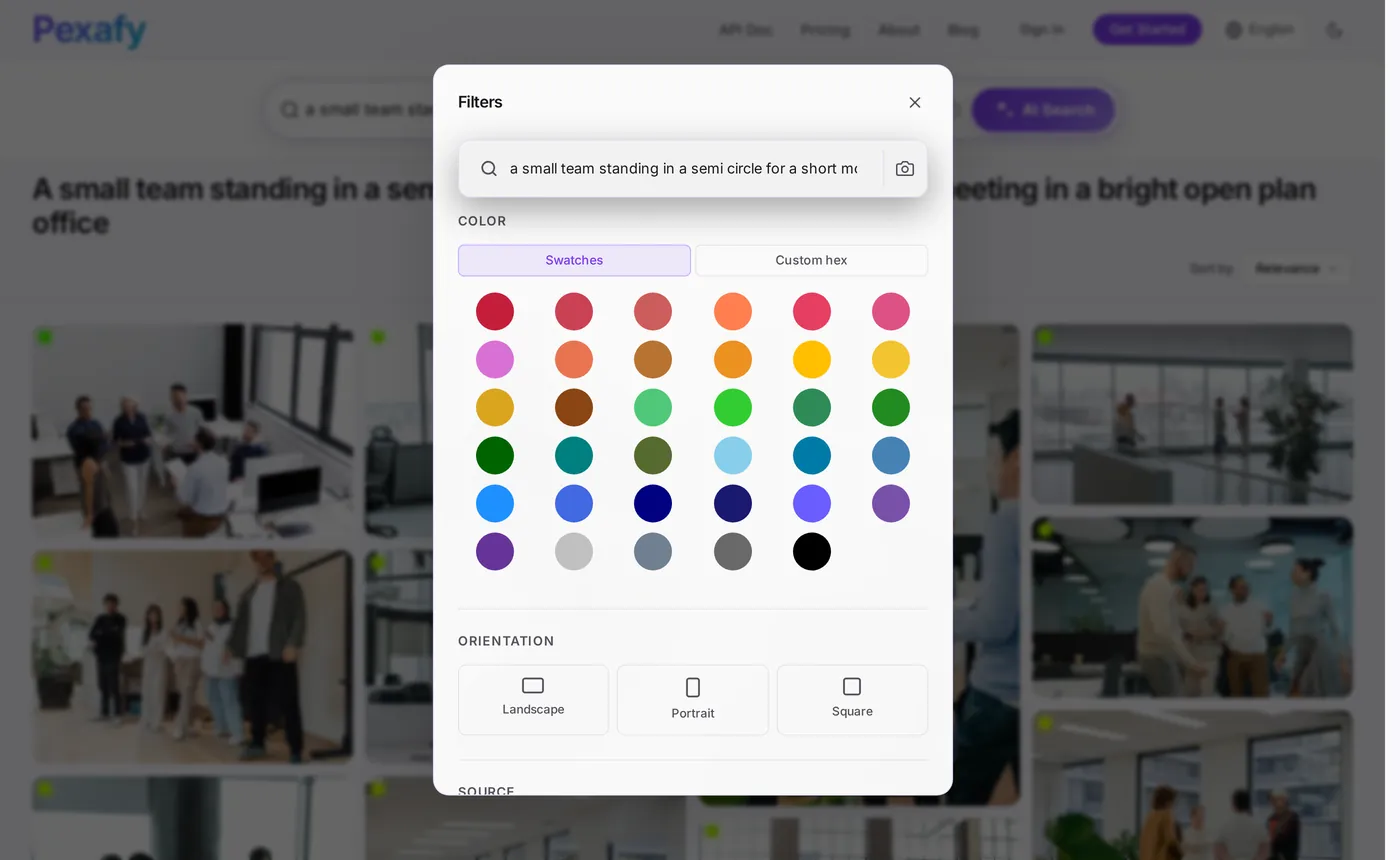
- Scrivi la frase, non la parola chiave. Soggetto + azione + luogo + luce. Fino a 500 caratteri, in una delle oltre 100 lingue disponibili.
- Filtra per orizzontale per l'immagine principale, poi rilancia senza il filtro per le immagini interne all'articolo, dove il verticale spesso rende meglio.
- Apri la foto per ottenere la riga di attribuzione già pronta, la pagina di origine e il file a piena risoluzione.
- Usa “foto simili” su quella scelta per illustrare la sezione successiva nello stesso registro visivo — stessa luce, stesso trattamento, scena diversa.
Il prompt: trasformare una bozza in una frase di ricerca
Questo è il passaggio che tutti sbagliano quando automatizzano. Inseriscono direttamente il titolo dell'articolo nel campo di ricerca, e il titolo è esattamente l'input sbagliato: è astratto (“Il costo nascosto del cambio di contesto”) e nessuna fotografia al mondo lo raffigura. Ciò che vuoi dal modello non è un riassunto — è un brief da fotografo.
# system prompt
You are a photo editor. Read the article and write ONE search sentence
for a stock-photo engine that ranks by meaning, not by keywords.

Rules:
1. Describe a scene a camera could have taken: someone doing
   something, somewhere. Never name the topic itself ("fintech",
   "productivity", "SEO") — name what would be in the frame.
2. 12 to 25 words. Longer beats shorter: every concrete detail
   (light, place, gesture, time of day) sharpens the match.
3. No text, logos, brands, charts, screenshots or famous people.
   Free photo libraries have almost none of those.
4. No invisible metaphors ("growth", "synergy", "transformation").
5. Match the mood of the article: calm, tense, tired, celebratory.
6. Write the sentence in English even if the article is not.

Return JSON only:
{ "query": "…", "orientation": "landscape", "alt": "…" }
La regola 1 fa gran parte del lavoro. Ecco la stessa regola applicata a tre bozze reali — la colonna centrale è ciò che una persona digita quando ha fretta, la colonna a destra è ciò che restituisce il prompt:
| L'articolo parla di… | La query frettolosa | Il brief da fotografo |
|---|---|---|
| Perché il tuo stand-up quotidiano non funziona | team meeting |
“a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office” |
| Ridurre l'onboarding da 6 settimane a 9 giorni | onboarding |
“a new employee on their first day at a desk, listening while a colleague leans in and points at their screen” |
| Il costo nascosto del cambio di contesto | productivity |
“a tired developer rubbing their eyes in front of two monitors late in the evening, the office empty behind them” |
team meeting restituisce lo stock generico della sala riunioni che tutti gli altri
sul tuo stesso argomento stanno già usando. La frase nella terza colonna restituisce questo, in
155 millisecondi:
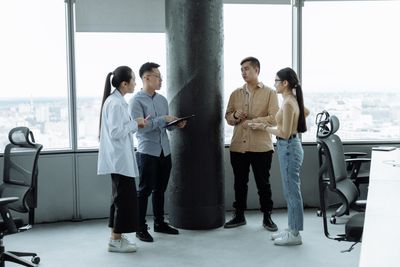

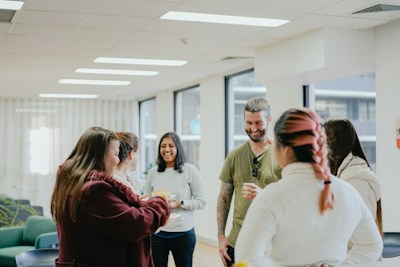
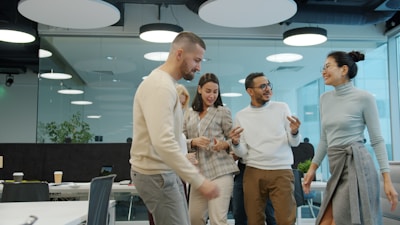
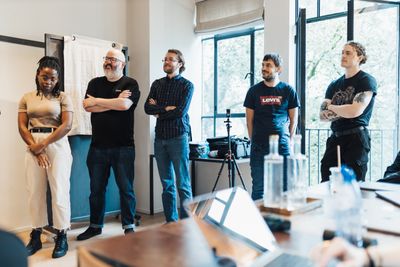
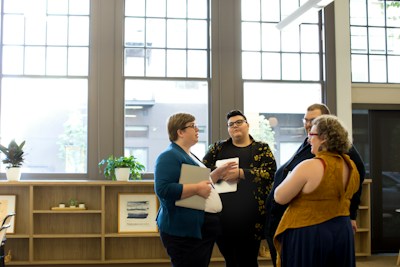
team meeting non garantisce mai.
La pipeline: bozza in ingresso, immagine principale accreditata in uscita
Quaranta righe, due chiamate: una al modello per il brief, una a Pexafy per la foto. Inseriscila nell'hook di salvataggio del tuo CMS, nella build del tuo sito statico, o in uno script che scorre una cartella di file Markdown.
import json, os, requests
from anthropic import Anthropic

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
llm = Anthropic()  # ANTHROPIC_API_KEY dall'ambiente

def camera_brief(article: str) -> dict:
    # PHOTO_EDITOR = il system prompt qui sopra
    msg = llm.messages.create(
        model="claude-sonnet-5",
        max_tokens=300,
        system=PHOTO_EDITOR,
        messages=[{ "role": "user", "content": article[:12000] }],
    )
    return json.loads(msg.content[0].text)

def illustrate(article: str) -> dict | None:
    brief = camera_brief(article)
    r = requests.get(
        SEARCH,
        headers={"X-Api-Key": os.environ["PEXAFY_API_KEY"]},
        params={
            "q": brief["query"],           # la frase completa
            "orientation": brief["orientation"],
            "per_page": 8,
            "score_threshold": 0.55,      # scarta i risultati deboli
        },
        timeout=10,
    )
    hits = r.json()["data"]
    if not hits:                        # brief troppo restrittivo → allarga, riprova
        return None

    top = hits[0]
    return {
        "src":    top["urls"]["regular"],        # 1080px — dimensione hero
        "alt":    brief["alt"] or top["alt_description"],
        "credit": top["attribution"]["html"],   # pronto da mostrare
        "width":  top["width"],
        "height": top["height"],
        "id":     top["photo_id"],           # salvalo: niente ripetizioni
    }
Tre dettagli che trasformano una demo in qualcosa che puoi lasciare in esecuzione:
score_threshold— non restituire nulla è meglio che restituire una foto scadente. Se il brief era troppo specifico, allargalo (togli l'ultima clausola) e riprova una volta.- Salva il
photo_id— una riga nel tuo database, e nessuna coppia di articoli sul tuo sito condividerà mai un'immagine principale. È l'errore in cui tutti incappano al trentesimo post. - Una richiesta per ogni slot immagine — un'immagine principale più tre immagini di sezione sono quattro richieste per articolo, oppure una sola se prendi quattro risultati diversi dalla stessa ricerca.
Non usi Python? Tutta la parte di ricerca è una riga sola, e ogni risultato porta gli stessi campi qualunque sia la libreria di provenienza:
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a tired developer rubbing their eyes at two monitors" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "per_page=6"

# → { "success": true, "data": [ … ], "meta": { "took_ms": 147 } }
La forma della risposta — urls, width,
photographer_full_name, source, license_type,
relevance_score, attribution — è identica per una foto Pexels, una
foto Pixabay e una foto Unsplash. Quella normalizzazione è la parte che altrimenti dovresti
scrivere e mantenere tu stesso; l'abbiamo scomposta campo per campo in
il confronto tra API di foto stock gratuite.
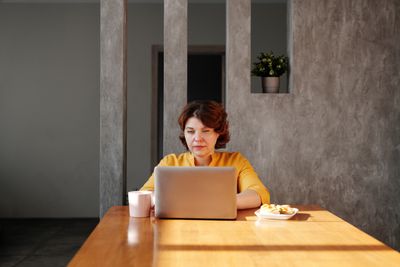
Seconda sezione, secondo brief, seconda ricerca — il punto è che un articolo produce diverse scene distinte invece di una sola foto tirata quattro volte:
Lascia che sia l'agente a scegliere l'immagine: MCP
Se un modello sta già scrivendo o modificando la bozza, la pipeline più pulita è nessuna pipeline: dai all'agente lo strumento di ricerca e lascia che illustri ciò che ha appena scritto, nella stessa conversazione, mentre ha ancora il contesto.
Pexafy gestisce un server Model Context Protocol ospitato all'indirizzo
mcp.pexafy.com/mcp. Tre strumenti:
search_photos (una frase),
search_photos_by_image (un'immagine di riferimento, eventualmente più una frase —
“come questa, ma al tramonto”), e get_similar_photos (di più simile a quella già scelta,
che è il modo per mantenere coerente una serie).
Settings → Connectors → Add custom connector
Name: Pexafy
URL:  https://mcp.pexafy.com/mcp
# poi accedi con il tuo account Pexafy quando si apre la finestra
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# oppure salvalo nel repository, così l'intero team lo ottiene — .mcp.json
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
Da qui, illustrare un articolo è una frase, non un compito. L'agente scrive il proprio brief da fotografo — ha appena letto la bozza, quindi è più in grado di chiunque altro di descrivere la scena:
You  Here's the draft of this week's post. Find a landscape hero
     and one photo for section 2, and give me the credit lines.

Claude  → search_photos(
       q="a small team standing in a semi circle for a short morning
          stand-up meeting in a bright open plan office",
       orientation="landscape")
     ← 16 photos · 155 ms

     Hero    → Photo by Thirdman on Pexels · 6453×4302 · score 0.80
     Section → Photo by Marcus Aurelius on Pexels · 6000×4000
     Both licence-free, attribution lines below, ready to paste.
Unsplash, Pexels, Pixabay e Openverse non hanno un server MCP ufficiale — quello che esiste sono wrapper della comunità che devi ospitare e configurare con la chiave tu stesso. Se il tuo flusso editoriale passa già attraverso un agente, quella differenza è l'integrazione.
Testo alternativo, licenza e velocità della pagina
L'immagine è scelta. Quattro cose decidono se aiuta la pagina o la danneggia silenziosamente:
-
Scrivi il testo alternativo per una persona, non per un crawler. Ogni
risultato include un
alt_description— usalo come bozza, poi riscrivilo nel contesto del tuo paragrafo. “Quattro colleghi in piedi in una riunione mattutina” batte un'insalata di parole chiave, ed è il testo che uno screen reader leggerà davvero. Mantienilo sotto i ~125 caratteri; lascialo vuoto (alt="") solo se l'immagine è puramente decorativa. -
Includi il credito anche quando nulla ti obbliga a farlo. L'attribuzione non
è richiesta dai termini dell'API Pexafy e ogni risultato porta con sé una stringa
attribution.htmlgià pronta — ma la licenza associata dalla libreria originale continua a regolare l'uso che fai di quella foto, e una riga di credito visibile è ciò che dice a un lettore (e a un motore di risposta) che si tratta di una fotografia reale con un autore reale. -
Servi la dimensione giusta.
urls.regular(1080 px) è adatta a un'immagine principale;urls.fullè un file da 2400 px che nessun articolo richiede. Emetti semprewidth/heightdalla risposta perché il browser riservi lo spazio — quella singola coppia di attributi fa la differenza tra un buon e un cattivo punteggio di layout-shift. Usafetchpriority="high"sull'immagine principale,loading="lazy"su tutto ciò che sta sotto la piega. -
Passa l'immagine principale ai tuoi metadati. Lo stesso URL dovrebbe essere
il tuo
og:image, il tuotwitter:imagee la proprietàimagedei tuoi dati strutturatiArticle. Una foto, tre posizioni, zero lavoro extra — e un'anteprima social che non ricade più sul tuo logo.
Quanto costa davvero 100 articoli al mese
Ipotizza un'immagine principale più tre immagini nell'articolo, quindi quattro richieste di ricerca per post — la versione deliberatamente dispendiosa, in cui esegui una query separata per ogni slot invece di riutilizzare i risultati di una sola:
| Volume | Richieste di ricerca / mese | Piano | Costo di ricerca |
|---|---|---|---|
| 20 articoli | 80 | Gratuito — 5.000 richieste/mese | $0 |
| 100 articoli | 400 | Gratuito — 5.000 richieste/mese | $0 |
| 1.000 articoliun'agenzia, o l'intero portafoglio di un cliente | 4.000 | Gratuito — ancora entro le 5.000 richieste/mese | $0 |
Sì — la quota mensile è un non-problema ai volumi tipici del content marketing, e preferiamo
dirlo piuttosto che inventare un motivo per farti pagare. Il limite che incontrerai
davvero è quello al minuto. Il piano gratuito consente 20 richieste API al minuto; uno
script di build che ri-illustra 100 articoli in un unico passaggio spara 400 richieste alla
velocità che il tuo ciclo consente, quindi o passa venti minuti a essere limitato, oppure inizia
a raccogliere errori 429. Due vie d'uscita: distanziare le chiamate (un
sleep nel ciclo, e un job notturno non se ne accorge nemmeno), oppure passare a un
piano il cui limite di frequenza corrisponda alla tua build — Starter è 30 richieste/minuto, Pro
60. Scegli in base al picco, non al volume.
L'unica altra voce è una breve chiamata al modello per articolo per produrre il brief — poche centinaia di token in entrata, trenta in uscita, che sarà la voce più economica di qualsiasi pipeline di contenuti tu possieda. Confrontalo con la generazione di quattro immagini per post, a quattrocento immagini al mese, più i tentativi che non sono stati selezionati.
E la parte che non compare in una tabella dei costi: l'editor smette di aprire cinque schede. È quello il vero risparmio.
Riferimenti e note
1 EU AI Act, articolo 50 — obblighi di trasparenza per fornitori e deployer di determinati sistemi AI, applicabile dal 2 agosto 2026. I fornitori di sistemi che generano audio, immagini, video o testo sintetici devono contrassegnare gli output in un formato leggibile da macchina e renderli rilevabili come generati artificialmente; i deployer devono dichiarare i deepfake e, in casi definiti, il testo generato dall'AI pubblicato per informare il pubblico. Il Digital Omnibus (Regolamento (UE) 2026/1744, in vigore dal 27 luglio 2026) lascia l'articolo 50 stesso non modificato, ma concede ai sistemi già sul mercato prima del 2 agosto 2026 tempo fino al 2 dicembre 2026 per soddisfare il requisito di contrassegno leggibile da macchina dell'articolo 50(2). Tutto ciò vincola i fornitori e i deployer di AI — non è una regola su quali immagini un blog possa pubblicare.
2 Google legge le C2PA Content Credentials e il proprio watermark SynthID per mostrare la provenienza in Informazioni su questa immagine in Search, Images e Lens. Questa è provenienza mediatica, non una penalizzazione nel ranking per i contenuti generati dall'AI.
Fonti verificate il 15 agosto 2026: Articolo 50 dell'AI Act · Commissione Europea — FAQ sulla trasparenza · Google — metadati delle immagini · Documentazione API e MCP di Pexafy. I tempi di ricerca e i risultati sono risposte reali dell'API pubblica, catturate nello stesso giorno.
Domande frequenti
Dovrei usare immagini generate dall'IA o foto reali per gli articoli del blog?
Come trovo automaticamente un'immagine che corrisponda al mio articolo?
GET /api/v1/search/photos?q=…, circa 150 ms, e ogni risultato arriva già con dimensioni, licenza e una stringa di attribuzione pronta all'uso.Qual è il prompt migliore per trasformare un articolo in una query di ricerca immagini?
Devo dare credito alle foto che uso nei post del blog?
Claude o un altro agente IA possono trovare le foto per il mio articolo?
mcp.pexafy.com/mcp. Aggiungilo come connettore personalizzato in Claude.ai o Claude Desktop e accedi con OAuth, oppure aggiungilo a Claude Code con un solo comando claude mcp add e una chiave API. L'agente potrà quindi cercare per frase, per immagine di riferimento o trovare foto simili da sé, mentre ha ancora la tua bozza nel contesto.Come evito che ogni articolo del mio blog usi la stessa foto?
photo_id di ogni immagine pubblicata ed escludilo nell'esecuzione successiva — basta una colonna nel tuo CMS. È il tipo di errore in cui inciampa ogni pipeline automatizzata intorno al trentesimo articolo, ed è invisibile finché qualcuno non scorre l'indice del blog. Scrivere un nuovo camera brief per ogni sezione, invece di riutilizzare il titolo dell'articolo, fa il resto.

