چطور برای هر مقالهای که منتشر میکنید تصویرسازی کنید — با عکسهای واقعی و در مقیاس بزرگ
چرا تیمهای انتشار دوباره به سراغ عکاسی واقعی میروند، و پایپلاین دقیق — همراه با پرامپت — که یک پیشنویس تمامشده را در حدود ۱۵۰ میلیثانیه به یک تصویر شاخص دارای اعتبار تبدیل میکند.
 Marouane Tijani
10 دقیقه مطالعه

هر مقالهای که منتشر میکنید به یک تصویر نیاز دارد. این یک امکان اضافه نیست — تصویر اصلی همان چیزی است که در پیشنمایش شبکههای اجتماعی نشان داده میشود، همان چیزی که خواننده پیش از خواندن اولین جمله میبیند، و در نیم ثانیه به او میگوید آیا این صفحه را کسی با دقت ساخته یا نه. این را در چهار تصویر به ازای هر پست و چهل پست در فصل ضرب کنید، آنگاه «پیدا کردن یک عکس» دیگر یک کار ساده نیست، بلکه یک مسئلهی خط تولید میشود.
ما اینطور آن را حل میکنیم: چه چیزی را به جای تصاویر تولیدشده استفاده کنیم و چرا، و سه راه برای اتصال Pexafy به گردش کار — بهصورت دستی، از طریق API، یا از طریق یک عامل هوش مصنوعی — از جمله پرامپتی که یک پیشنویس تمامشده را به جملهای جستوجویی تبدیل میکند که واقعاً نتیجه پیدا میکند.
چرا عکسهای واقعی هنوز بر تصاویر تولیدشده برتری دارند
تولید یک تصویر آسان است، و دقیقاً همین مسئله است. چهار چیز بین «تصاویر هوش مصنوعی یک میانبر است» و امروز تغییر کردهاند:
۱ · در حجم بالا، جستوجو سریعتر از تولید است
یک تولید یعنی یک پرامپت، یک انتظار، یک بازبینی، و — صادقانه بگوییم — دو یا سه تلاش دیگر پیش از آنکه یکی قابلاستفاده شود. یک جستوجوی معنایی یک درخواست ساده است که با شانزده گزینه در حدود ۱۵۰ میلیثانیه بازمیگردد، هرکدام از پیش دارای مجوز، دارای اعتبار، دارای اندازه، و با ابعادش در پاسخ. برای یک تصویر، تفاوت بهاندازهی یک فنجان قهوه است. برای چهارصد تصویر در فصل، تفاوت بین یک گردش کار و یک شغل است.
۲ · یک عکس دقیق است؛ یک تولید محتملبهنظر است
بهمحض اینکه مقالهی شما دربارهی چیزی واقعی باشد — یک حرفه، یک قطعه تجهیزات، یک شهر، یک حرکت، یک متریال — یک تصویر تولیدشده حالوهوا را درست میگیرد اما جزئیات را اشتباه. دستهای ششانگشتی نسخهی شوخیآمیز ماجراست؛ نسخهی پرهزینهاش یک ابزار جراحی است که وجود خارجی ندارد، یک کابین خلبان با دکمههای ساختگی، یا یک «خیابان لیسبون» که هیچ اهل لیسبونی آن را نمیشناسد. خوانندگانی که موضوع شما را میشناسند این را متوجه میشوند، و اول از همه متوجه تصویر میشوند.
۳ · همه یک ظاهر یکسان دارند
مدلهای انتشاری به سمت یک سبک خانگی همگرا میشوند، و دیواری از تصاویر با گرادیان نرم، نورپردازی بیشازحد و تقارن مشکوک، اکنون به چشم پرکننده میآید. آن تصور، هزینهی واقعی است: نه یک جریمه، بلکه یک سیگنال. یک عکس واقعی — با دانههای تصویر، یک صندلی نامتقارن، کسی در وسط یک جمله — به چشم گزارشگری میآید.
۴ · و حالا با یک برچسب همراه میآیند
این یکی بیشتر زمینه است تا یک استدلال، اما جهت حرکت را نشان میدهد. از ۲ اوت ۲۰۲۶، مادهی ۵۰ قانون هوش مصنوعی اتحادیهی اروپا از ارائهدهندگان سامانههای مولد میخواهد که خروجیهای مصنوعی را در قالبی قابلخواندن توسط ماشین علامتگذاری کنند، و از استقراردهندگان میخواهد که دیپفیکها را افشا کنند.1 از سمت شناسایی، گوگل Content Credentials مبتنی بر C2PA و واترمارک SynthID خودش را میخواند تا در جستوجو، تصاویر و لنز به این پرسش پاسخ دهد که «آیا این تصویر با هوش مصنوعی ساخته شده است؟»2 هیچکدام از اینها قاعدهای دربارهی اینکه یک وبلاگ چه تصاویری را میتواند منتشر کند نیست، و هیچکدام رتبهی شما را خدشهدار نمیکند. آنچه تغییر کرده، در پاییندست است: منشأ تصویری که بالای مقالهی شما قرار دارد، حالا چیزی است که خواننده میتواند در دو کلیک، بدون پرسیدن از شما، بررسی کند. یک عکس دارای مجوز چیزی برای اعلام کردن ندارد.
زمانی که تصاویر تولیدشده انتخاب درستی هستند. نمودارهای مفهومی و طرحوارهها. صحنهای که نمیتوان از آن عکس گرفت (محصولی که هنوز وجود ندارد، یک سازوکار انتزاعی، یک شهر آینده). یک سبک تصویرسازی خانگی که مالکش هستید و میخواهید در هر پست تکرار شود. و هر جایی که تصویر عمداً بهعنوان یک تصویرسازی درک میشود، نه بهعنوان سند. از هر دو استفاده کنید — فقط استفاده از تولید را بهعنوان پیشفرض برای «به یک عکس از افراد در حال جلسه نیاز دارم» متوقف کنید.
سه راه برای تصویرسازی، بسته به حجم کارتان
همان موتور، همان کاتالوگ — 9M+ عکس آزاد برای استفاده از 9 کتابخانه — و سه نقطهی ورود. بر اساس تعداد مقالههایی که منتشر میکنید انتخاب کنید، نه بر اساس میزان فنی بودنتان.
| نقطهی ورود | بهترین گزینه برایچه کسی و چه مقدار | به ازای هر مقاله | چه چیزی نیاز دارید |
|---|---|---|---|
| رابط جستوجو | ویراستاران، یک پست در هر زمان — تا حدود ۲۰ در ماه | ~۳۰ ثانیه | یک مرورگر. برای جستوجو نیازی به حساب کاربری نیست. |
| REST API | یک CMS، ساخت یک سایت استاتیک، دستهای از پیشنویسها | ~۱ درخواست، ~۱۵۰ میلیثانیه | یک کلید API. ۵٬۰۰۰ درخواست در ماه رایگان، ۲۰ در دقیقه. |
| سرور MCP | عاملی که پیشنویس را مینویسد یا ویرایش میکند | در همان گفتوگو | یک URL اتصالدهنده، OAuth یا یک کلید. |
این سه گزینه یک کاتالوگ و یک نظام رتبهبندی مشترک دارند، بنابراین عکسی که یک ویراستار در رابط کاربری پیدا میکند، دقیقاً همان عکس با همان شناسه است که API به اسکریپت ساخت شما برمیگرداند.
یک مقاله، ۳۰ ثانیه: رابط جستوجو
صحنه را همانطور توصیف کنید که برای یک عکاس توصیف میکردید، در یک جملهی کامل، به زبان خودتان. نه team meeting —
بلکه «یک تیم کوچک که بهصورت نیمدایره برای یک جلسهی کوتاه صبحگاهی در یک دفتر روشن با پلان باز ایستادهاند». هر جزئیات ملموس اضافه، مجموعهی نتایج را دقیقتر میکند نه خالیتر، چون موتور بر اساس معنا رتبهبندی میکند نه با تطبیق کلمات شما با برچسبهای کسی دیگر.
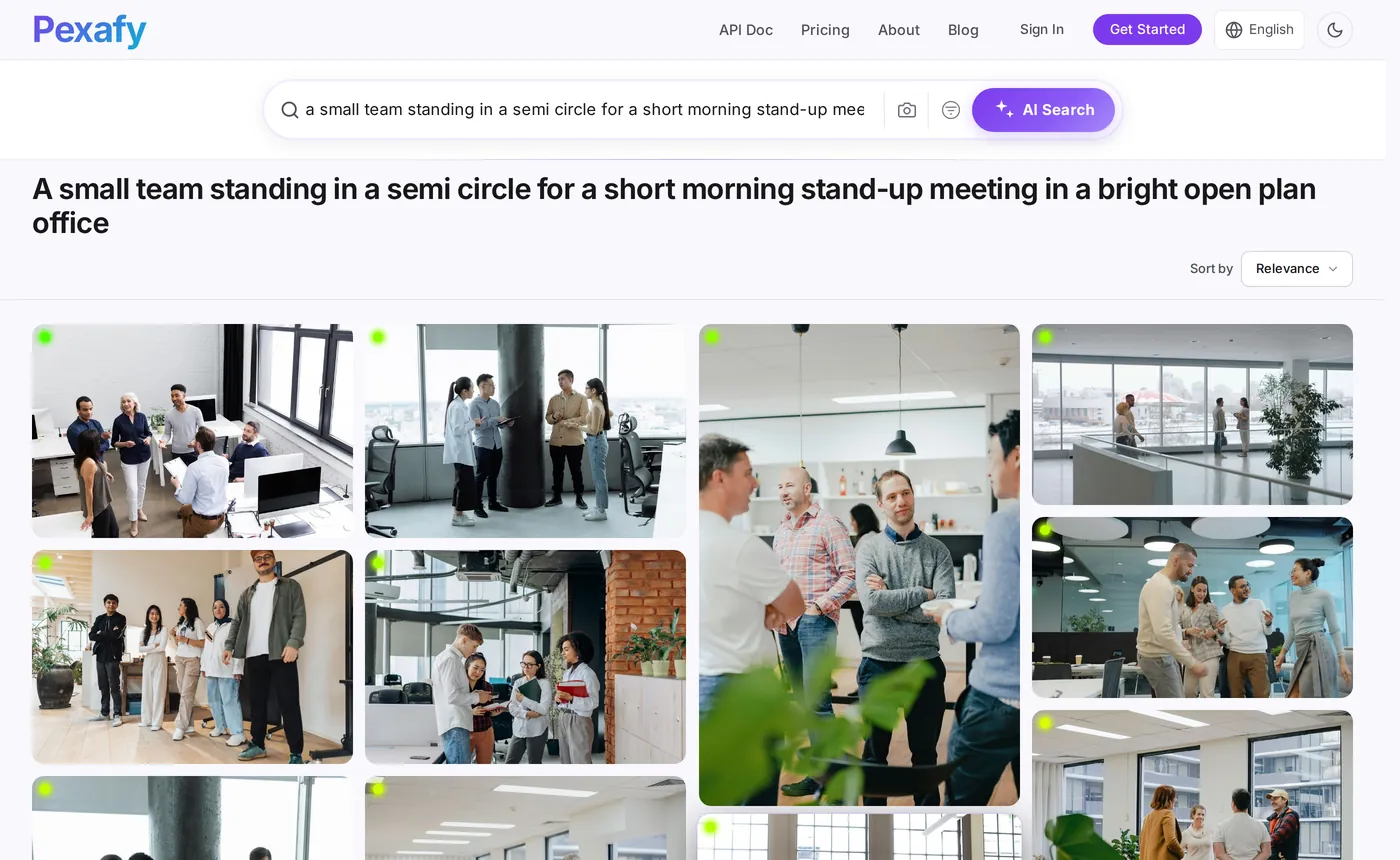
سپس آن را با فیلترهایی که برای چیدمان یک مقاله مهماند محدود کنید — و فقط همانها:
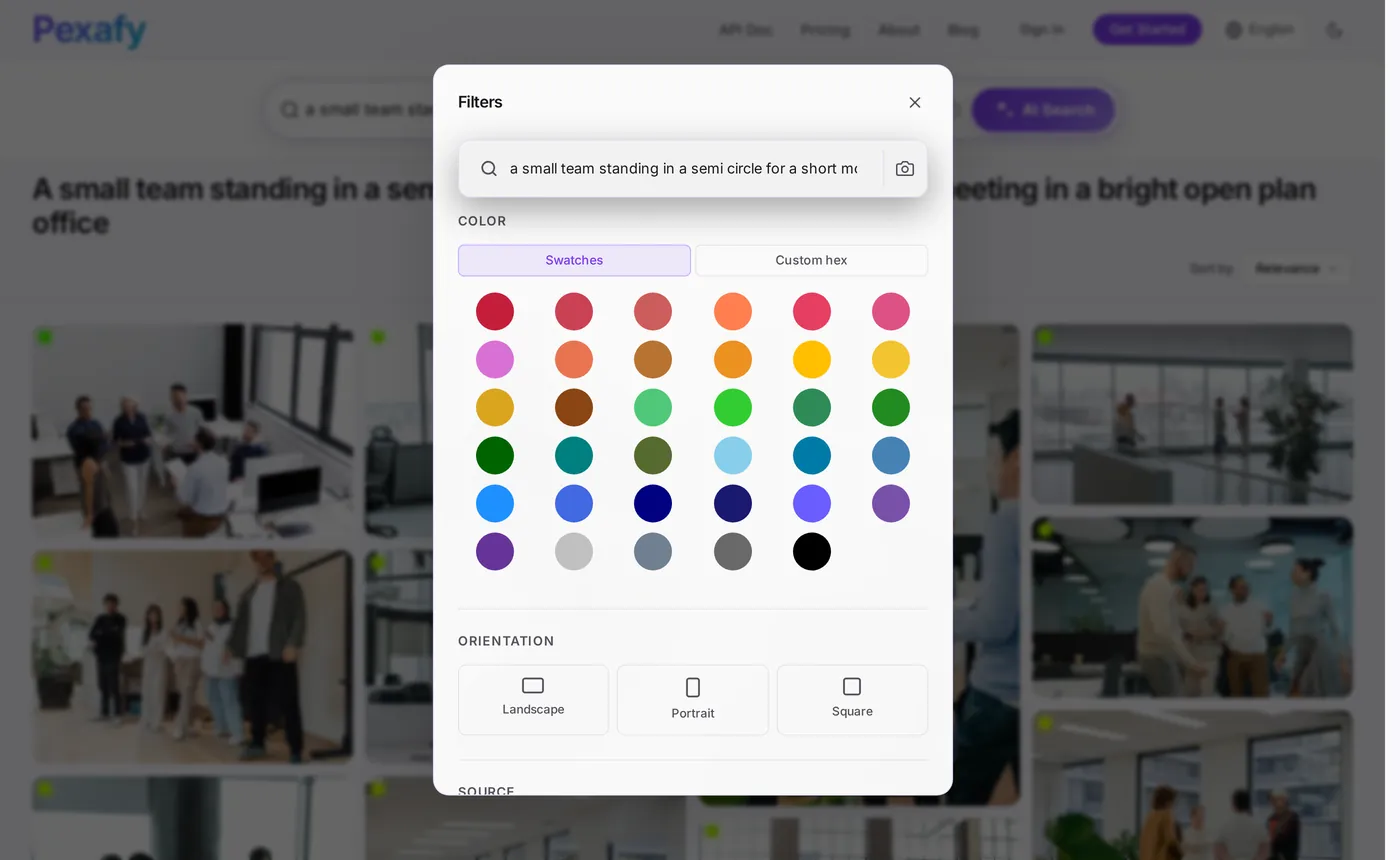
- جمله بنویسید، نه کلمهی کلیدی. موضوع + عمل + مکان + نور. تا ۵۰۰ نویسه، به هر یک از بیش از ۱۰۰ زبان.
- فیلتر به افقی برای تصویر اصلی، سپس بدون فیلتر دوباره اجرا کنید برای تصاویر داخل مقاله، جایی که تصویر عمودی اغلب بهتر بهنظر میرسد.
- عکس را باز کنید تا خط اعتبار آماده، صفحهی منبع اصلی و فایل با کیفیت کامل را دریافت کنید.
- از «عکسهای مشابه» روی عکسی که انتخاب کردهاید استفاده کنید تا بخش بعدی را با همان طیف بصری تصویرسازی کنید — همان نور، همان پردازش، صحنهای متفاوت.
پرامپت: تبدیل یک پیشنویس به یک جملهی جستوجویی
این همان مرحلهای است که همه هنگام خودکارسازی اشتباه میکنند. آنها عنوان مقاله را مستقیماً در باکس جستوجو وارد میکنند، و عنوان دقیقاً بدترین ورودی است: انتزاعی است («هزینهی پنهان جابهجایی بین کارها») و هیچ عکسی در دنیا آن را به تصویر نمیکشد. آنچه از مدل میخواهید یک خلاصه نیست — بلکه یک بریف عکاسی است.
# system prompt
You are a photo editor. Read the article and write ONE search sentence
for a stock-photo engine that ranks by meaning, not by keywords.

Rules:
1. Describe a scene a camera could have taken: someone doing
   something, somewhere. Never name the topic itself ("fintech",
   "productivity", "SEO") — name what would be in the frame.
2. 12 to 25 words. Longer beats shorter: every concrete detail
   (light, place, gesture, time of day) sharpens the match.
3. No text, logos, brands, charts, screenshots or famous people.
   Free photo libraries have almost none of those.
4. No invisible metaphors ("growth", "synergy", "transformation").
5. Match the mood of the article: calm, tense, tired, celebratory.
6. Write the sentence in English even if the article is not.

Return JSON only:
{ "query": "…", "orientation": "landscape", "alt": "…" }
قاعدهی ۱ بیشتر کار را انجام میدهد. در اینجا همان قاعده روی سه پیشنویس واقعی آمده — ستون میانی چیزی است که یک انسان وقتی عجله دارد تایپ میکند، ستون سمت راست چیزی است که پرامپت برمیگرداند:
| مقاله دربارهی… | پرسوجوی شتابزده | بریف عکاسی |
|---|---|---|
| چرا جلسهی روزانهی شما خراب است | team meeting |
«یک تیم کوچک که بهصورت نیمدایره برای یک جلسهی کوتاه صبحگاهی در یک دفتر روشن با پلان باز ایستادهاند» |
| کاهش آموزش کارکنان جدید از ۶ هفته به ۹ روز | onboarding |
«یک کارمند جدید در اولین روز کاریاش پشت میز، در حالی که گوش میدهد و همکاری خم شده و به صفحهاش اشاره میکند» |
| هزینهی پنهان جابهجایی بین کارها | productivity |
«یک برنامهنویس خسته که چشمانش را در مقابل دو مانیتور در اواخر شب میمالد، دفتر خالی پشت سرش» |
team meeting همان موجودی عمومی اتاق کنفرانس را برمیگرداند که همهی افراد دیگری که روی موضوع شما کار میکنند از قبل استفاده میکنند. جملهی ستون سوم این را در ۱۵۵ میلیثانیه برمیگرداند:
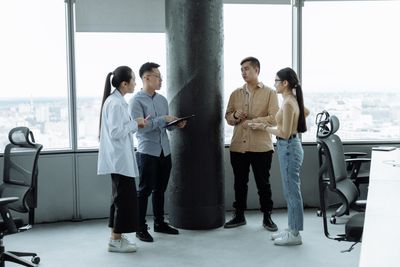

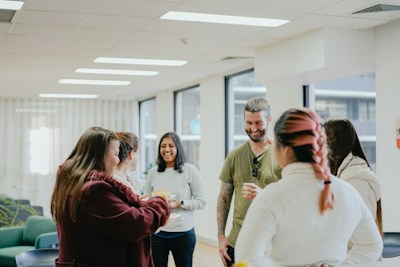
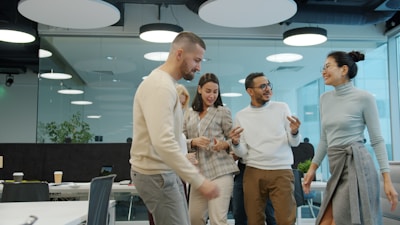
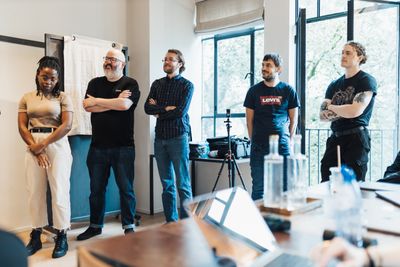
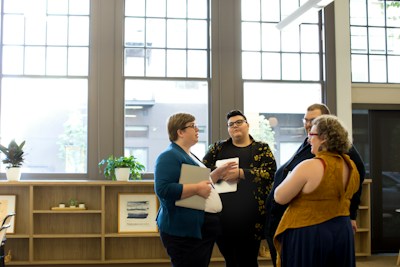
team meeting هرگز تضمین نمیکند.
خط تولید: پیشنویس ورودی، تصویر اصلی با اعتبار خروجی
چهل خط، دو فراخوانی: یکی به مدل برای بریف، یکی به Pexafy برای عکس. آن را در قلاب ذخیرهسازی CMS خود، ساخت سایت استاتیکتان، یا اسکریپتی که پوشهای از فایلهای Markdown را پیمایش میکند قرار دهید.
import json, os, requests
from anthropic import Anthropic
SEARCH = "https://api.pexafy.com/api/v1/search/photos"
llm = Anthropic() # ANTHROPIC_API_KEY از محیط سیستم
def camera_brief(article: str) -> dict:
# PHOTO_EDITOR = پرامپت سیستمی بالا
msg = llm.messages.create(
model="claude-sonnet-5",
max_tokens=300,
system=PHOTO_EDITOR,
messages=[{ "role": "user", "content": article[:12000] }],
)
return json.loads(msg.content[0].text)
def illustrate(article: str) -> dict | None:
brief = camera_brief(article)
r = requests.get(
SEARCH,
headers={"X-Api-Key": os.environ["PEXAFY_API_KEY"]},
params={
"q": brief["query"], # جملهی کامل
"orientation": brief["orientation"],
"per_page": 8,
"score_threshold": 0.55, # تطبیقهای ضعیف را حذف کن
},
timeout=10,
)
hits = r.json()["data"]
if not hits: # بریف خیلی محدود → گسترش بده، دوباره تلاش کن
return None
top = hits[0]
return {
"src": top["urls"]["regular"], # ۱۰۸۰ پیکسل — اندازهی تصویر اصلی
"alt": brief["alt"] or top["alt_description"],
"credit": top["attribution"]["html"], # آماده برای رندر
"width": top["width"],
"height": top["height"],
"id": top["photo_id"], # ذخیرهاش کن: بدون تکرار
}
سه جزئیات که یک دموی ساده را به چیزی تبدیل میکنند که میتوانید بگذارید در حال اجرا بماند:
score_threshold— برگرداندن هیچچیز بهتر از برگرداندن یک عکس بد است. اگر بریف بیشازحد خاص بود، آن را گسترش دهید (آخرین بند را حذف کنید) و یکبار دیگر تلاش کنید.photo_idرا ذخیره کنید — یک خط در پایگاه دادهی شما، و هیچ دو مقالهای در سایت شما هرگز یک تصویر اصلی مشترک نخواهند داشت. این همان خطایی است که همه در مقالهی سیام به آن برمیخورند.- یک درخواست به ازای هر جایگاه تصویر — یک تصویر اصلی بهعلاوهی سه تصویر بخش، یعنی چهار درخواست به ازای هر مقاله، یا یکی اگر چهار نتیجهی متفاوت از یک جستوجو بردارید.
پایتون بلد نیستید؟ کل نیمهی جستوجو یک خط است، و هر نتیجه فارغ از اینکه از کدام کتابخانه آمده، همان فیلدها را دارد:
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a tired developer rubbing their eyes at two monitors" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "per_page=6"

# → { "success": true, "data": [ … ], "meta": { "took_ms": 147 } }
ساختار پاسخ — urls، width، photographer_full_name،
source، license_type، relevance_score،
attribution — برای یک عکس Pexels، یک عکس Pixabay و یک عکس Unsplash یکسان است. آن یکسانسازی، بخشی است که در غیر این صورت خودتان باید بنویسید و نگهداری کنید؛ آن را فیلد به فیلد در
مقایسهی API عکسهای استوک رایگان باز کردهایم.
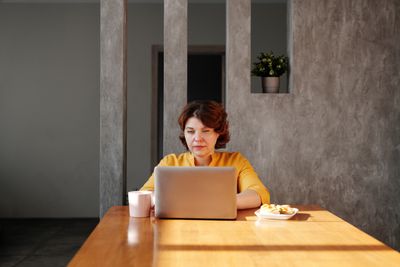
بخش دوم، بریف دوم، جستوجوی دوم — نکته این است که یک مقاله چند صحنهی متمایز میدهد بهجای یک عکس که چهار بار کشیده شده باشد:
بگذارید عامل هوش مصنوعی تصویر را انتخاب کند: MCP
اگر یک مدل از قبل در حال نوشتن یا ویرایش پیشنویس است، سادهترین خط تولید، بدون خط تولید است: ابزار جستوجو را در اختیار عامل قرار دهید و بگذارید آنچه را که هماکنون نوشته، در همان گفتوگو، درحالیکه هنوز زمینه را در ذهن دارد، تصویرسازی کند.
Pexafy یک سرور میزبانیشدهی Model Context Protocol در
mcp.pexafy.com/mcp اجرا میکند. سه ابزار:
search_photos (یک جمله)،
search_photos_by_image (یک تصویر مرجع، بههمراه یک جمله بهصورت اختیاری — «شبیه به این، اما در غروب آفتاب»)، و get_similar_photos (بیشتر شبیه به آنچه از قبل انتخاب کردهاید، که راه حفظ انسجام یک مجموعه است).
Settings → Connectors → Add custom connector
Name: Pexafy
URL:  https://mcp.pexafy.com/mcp
# سپس هنگام باز شدن پنجره با حساب Pexafy خود وارد شوید
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# یا آن را در مخزن کد ثبت کنید، تا کل تیم به آن دسترسی داشته باشد — .mcp.json
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
از این پس، تصویرسازی یک مقاله یک جمله است، نه یک وظیفه. عامل بریف عکاسی خودش را مینویسد — او همین حالا پیشنویس را خوانده، پس بهتر از هرکس دیگری برای توصیف صحنه جایگاه دارد:
You  Here's the draft of this week's post. Find a landscape hero
     and one photo for section 2, and give me the credit lines.

Claude  → search_photos(
       q="a small team standing in a semi circle for a short morning
          stand-up meeting in a bright open plan office",
       orientation="landscape")
     ← 16 photos · 155 ms

     Hero    → Photo by Thirdman on Pexels · 6453×4302 · score 0.80
     Section → Photo by Marcus Aurelius on Pexels · 6000×4000
     Both licence-free, attribution lines below, ready to paste.
Unsplash، Pexels، Pixabay و Openverse سرور MCP رسمی ندارند — آنچه وجود دارد، رَپرهای انجمنی است که خودتان باید میزبانی و کلیددهی کنید. اگر گردش کار ویرایشی شما از قبل از طریق یک عامل اجرا میشود، این تفاوت خودش همان یکپارچهسازی است.
متن جایگزین، مجوز و سرعت صفحه
تصویر انتخاب شده. چهار چیز تعیین میکند که آیا به صفحه کمک میکند یا بیسروصدا به آن آسیب میزند:
-
متن جایگزین را برای یک انسان بنویسید، نه برای یک خزنده. هر نتیجه یک
alt_descriptionارسال میکند — از آن بهعنوان پیشنویس استفاده کنید، سپس آن را در بافتار پاراگراف خودتان بازنویسی کنید. «چهار همکار که در یک جلسهی صبحگاهی ایستادهاند» بهتر از یک سالاد کلمهی کلیدی است، و این متنی است که صفحهخوان واقعاً میخواند. آن را زیر حدود ۱۲۵ نویسه نگه دارید؛ فقط زمانی آن را خالی (alt="") بگذارید که تصویر کاملاً تزئینی باشد. -
حتی وقتی چیزی شما را مجبور نمیکند، اعتبار را ارسال کنید. ذکر اعتبار طبق شرایط API پکسیفای الزامی نیست و هر نتیجه رشتهی آمادهی
attribution.htmlرا دارد — اما مجوز پیوستشده توسط کتابخانهی اصلی همچنان استفادهی شما از آن عکس را تنظیم میکند، و یک خط اعتبار قابلمشاهده همان چیزی است که به خواننده (و یک موتور پاسخدهی) میگوید این یک عکس واقعی با یک نویسندهی واقعی است. -
اندازهی درست را ارائه دهید.
urls.regular(۱۰۸۰ پیکسل) برای تصویر اصلی است؛urls.fullیک فایل ۲۴۰۰ پیکسلی است که هیچ مقالهای به آن نیاز ندارد. همیشهwidth/heightرا از پاسخ منتشر کنید تا مرورگر فضا را رزرو کند — همان یک زوج ویژگی، تفاوت بین امتیاز خوب و بد جابهجایی چیدمان است. ازfetchpriority="high"برای تصویر اصلی وloading="lazy"برای هرچیزی زیر تاخوردگی صفحه استفاده کنید. -
تصویر اصلی را به فرادادهی خود بدهید. همان آدرس باید
og:image،twitter:imageو ویژگیimageدادهی ساختیافتهیArticleشما باشد. یک عکس، سه جا، بدون کار اضافه — و یک پیشنمایش اجتماعی که دیگر به لوگوی شما بازنمیگردد.
هزینهی واقعی ۱۰۰ مقاله در ماه چقدر است
فرض کنید یک تصویر اصلی بهعلاوهی سه تصویر داخل مقاله، پس چهار درخواست جستوجو به ازای هر پست — نسخهی عمداً پرزحمت، جایی که برای هر جایگاه بهجای استفادهی دوباره از نتایج یک جستوجو، یک پرسوجوی جداگانه اجرا میکنید:
| حجم | درخواستهای جستوجو در ماه | پلن | هزینهی جستوجو |
|---|---|---|---|
| ۲۰ مقاله | ۸۰ | رایگان — ۵٬۰۰۰ درخواست در ماه | $۰ |
| ۱۰۰ مقاله | ۴۰۰ | رایگان — ۵٬۰۰۰ درخواست در ماه | $۰ |
| ۱٬۰۰۰ مقالهیک آژانس، یا کل سبد یک مشتری | ۴٬۰۰۰ | رایگان — همچنان زیر ۵٬۰۰۰ درخواست در ماه | $۰ |
بله — سهمیهی ماهانه در حجمهای بازاریابی محتوایی موضوعیتی ندارد، و ما ترجیح میدهیم این را بگوییم تا اینکه دلیلی برای پرداخت پول توسط شما اختراع کنیم. محدودیتی که واقعاً به آن برخواهید خورد، محدودیت هر دقیقه است. پلن رایگان اجازهی ۲۰ درخواست API در دقیقه را میدهد؛ اسکریپت ساختی که ۱۰۰ مقاله را در یک اجرا دوباره تصویرسازی میکند، ۴۰۰ درخواست را بهسرعتی که حلقهی شما اجازه میدهد شلیک میکند، پس یا بیست دقیقه محدود میشود یا شروع به دریافت خطای 429 میکند. دو راه خروج: فاصلهی زمانی بین فراخوانیها را بگذارید (یک sleep در حلقه، و یک کار شبانه هرگز متوجه نمیشود)، یا به پلنی بروید که سقف نرخش با ساخت شما همخوانی دارد — Starter سی درخواست در دقیقه است، Pro شصت. بر اساس انفجار درخواست انتخاب کنید، نه بر اساس حجم.
تنها خط دیگر یک فراخوانی کوتاه مدل به ازای هر مقاله برای تولید بریف است — چند صد توکن ورودی، سی خروجی، که ارزانترین قلم در هر خط تولید محتوایی خواهد بود که مالکش هستید. آن را با تولید چهار تصویر به ازای هر پست، در چهارصد تصویر در ماه، بهعلاوهی تلاشهایی که موفق نشدند مقایسه کنید.
و بخشی که در جدول هزینه دیده نمیشود: ویراستار دیگر پنج زبانه را باز نمیکند. آن صرفهجویی واقعی است.
منابع و پانویسها
1 قانون هوش مصنوعی اتحادیهی اروپا، مادهی ۵۰ — تعهدات شفافیت برای ارائهدهندگان و استقراردهندگان برخی سامانههای هوش مصنوعی، قابلاجرا از ۲ اوت ۲۰۲۶. ارائهدهندگان سامانههایی که صدا، تصویر، ویدیو یا متن مصنوعی تولید میکنند باید خروجیها را در قالبی قابلخواندن توسط ماشین علامتگذاری کنند و آنها را قابلشناسایی بهعنوان تولیدشدهی مصنوعی نمایند؛ استقراردهندگان باید دیپفیکها و، در موارد تعریفشده، متن تولیدشده توسط هوش مصنوعی که برای اطلاعرسانی به عموم منتشر میشود را افشا کنند. مقررات Digital Omnibus (مقررهٔ (EU) 2026/1744، لازمالاجرا از ۲۷ ژوئیه ۲۰۲۶) خودِ مادهی ۵۰ را بدون تغییر باقی میگذارد، اما به سامانههایی که پیش از ۲ اوت ۲۰۲۶ در بازار بودهاند تا ۲ دسامبر ۲۰۲۶ فرصت میدهد تا الزام علامتگذاری قابلخواندن توسط ماشین در مادهی ۵۰(۲) را برآورده کنند. تمام اینها ارائهدهندگان و استقراردهندگان هوش مصنوعی را متعهد میکند — و قاعدهای دربارهی اینکه یک وبلاگ چه تصاویری را میتواند منتشر کند نیست.
2 گوگل Content Credentials مبتنی بر C2PA و واترمارک SynthID خودش را میخواند تا منشأ را در بخش About this image در سراسر جستوجو، تصاویر و لنز نمایان کند. این منشأ رسانه است، نه یک جریمهی رتبهبندی روی محتوای تولیدشده با هوش مصنوعی.
منابع بررسیشده در ۱۵ اوت ۲۰۲۶: مادهی ۵۰ قانون هوش مصنوعی · کمیسیون اروپا — پرسشهای متداول شفافیت · گوگل — فرادادهی تصویر · مستندات API و MCP پکسیفای. زمانبندیهای جستوجو و نتایج، پاسخهای واقعی از API عمومی هستند که در همان روز ثبت شدهاند.
پرسشهای پرتکرار
برای مقالات وبلاگ از تصاویر تولیدشده با هوش مصنوعی استفاده کنم یا عکسهای واقعی؟
چطور بهطور خودکار تصویری پیدا کنم که با مقالهام همخوانی داشته باشد؟
GET /api/v1/search/photos?q=… انجام میشود، حدود ۱۵۰ میلیثانیه طول میکشد، و هر نتیجه به همراه اندازه، مجوز و یک رشته انتساب آماده بازمیگردد.بهترین پرامپت برای تبدیل یک مقاله به یک عبارت جستجوی تصویر چیست؟
آیا باید عکسهایی که در پستهای وبلاگ استفاده میکنم را منبعدهی کنم؟
آیا Claude یا یک عامل هوش مصنوعی دیگر میتواند عکسهای مقالهام را پیدا کند؟
mcp.pexafy.com/mcp. آن را بهعنوان یک اتصالدهنده سفارشی در Claude.ai یا Claude Desktop اضافه کنید و با OAuth وارد شوید، یا آن را با یک دستور claude mcp add و یک کلید API به Claude Code اضافه کنید. سپس عامل هوش مصنوعی میتواند بر اساس جمله، تصویر مرجع یا جستجوی عکسهای مشابه، خودش جستجو کند، در حالی که پیشنویس شما همچنان در زمینهاش قرار دارد.چطور جلوی این را بگیرم که همه مقالات وبلاگم از یک عکس یکسان استفاده کنند؟
photo_id هر تصویری که منتشر میکنید را ذخیره کنید و آن را در اجرای بعدی حذف کنید — فقط یک ستون در سیستم مدیریت محتوای شما. این همان حالت خرابی است که هر پایپلاین خودکار حدود مقاله سیام با آن روبرو میشود و تا وقتی کسی فهرست وبلاگ شما را اسکرول نکند، نامرئی میماند. نوشتن یک بریف دوربینی تازه برای هر بخش، بهجای استفاده مجدد از عنوان مقاله، بقیه کار را انجام میدهد.

