Hoe je elk artikel dat je publiceert illustreert — met echte foto's, op schaal
Waarom redactieteams teruggrijpen naar echte fotografie, en de exacte pipeline — inclusief prompt — die een afgeronde tekst in ongeveer 150 milliseconden omzet in een hero-afbeelding met bronvermelding.
 Marouane Tijani
10 min lezen

Elk artikel dat u publiceert heeft een afbeelding nodig. Geen leuke bijkomstigheid — de hero-afbeelding is wat de social preview toont, wat de lezer ziet voordat hij de eerste zin leest, en wat hem in een halve seconde vertelt of deze pagina is gemaakt door iemand die er om gaf. Vermenigvuldig dat met vier afbeeldingen per bericht en veertig berichten per kwartaal, en “een foto zoeken” houdt op een taak te zijn en wordt een pijplijnprobleem.
Zo lossen wij dit op: wat te gebruiken in plaats van gegenereerde afbeeldingen en waarom, en de drie manieren om Pexafy in de workflow te integreren — handmatig, via API, of via een AI-agent — inclusief de prompt die een afgerond concept omzet in een zoekzin die daadwerkelijk iets vindt.
Waarom echte foto's nog altijd beter zijn dan gegenereerde
Een illustratie genereren is eenvoudig, en dat is precies het probleem. Vier dingen zijn veranderd tussen “AI-afbeeldingen zijn een cheatcode” en vandaag:
1 · Bij grote volumes is zoeken sneller dan genereren
Een generatie is één prompt, een wachttijd, een inspectie, en — eerlijk gezegd — nog twee of drie pogingen voordat er één bruikbaar is. Een semantische zoekopdracht is één enkel verzoek dat terugkomt met zestien kandidaten in ongeveer 150 milliseconden, elk al gelicentieerd, al gecrediteerd, al op maat, met de afmetingen in de respons. Voor één afbeelding is het verschil een kopje koffie. Voor vier honderd afbeeldingen per kwartaal is het het verschil tussen een workflow en een klus.
2 · Een foto is accuraat; een generatie is aannemelijk
Zodra uw artikel over iets echts gaat — een beroep, een stuk gereedschap, een stad, een gebaar, een materiaal — krijgt een gegenereerde afbeelding de sfeer goed en de details fout. Handen met zes vingers zijn de grap-versie; de dure versie is een chirurgisch instrument dat niet bestaat, een cockpit met verzonnen bedieningselementen, of een “straat in Lissabon” die niemand uit Lissabon herkent. Lezers die uw onderwerp kennen, merken het, en ze merken eerst de afbeelding op.
3 · Iedereen heeft dezelfde look
Diffusiemodellen convergeren naar één huisstijl, en een muur van illustraties met zachte verlopen, te veel licht en verdacht symmetrisch leest nu als opvulling. Die perceptie is de werkelijke kostprijs: geen straf, een signaal. Een echte foto — korrel, een ongemakkelijke stoel, iemand midden in een zin — leest als verslaggeving.
4 · En nu komen ze met een label eraan
Dit is eerder context dan een argument, maar het geeft de richting aan. Sinds 2 augustus 2026 vereist Artikel 50 van de EU AI Act dat aanbieders van generatieve systemen synthetische output markeren in een machineleesbaar formaat, en dat deployers deepfakes bekendmaken.1 Aan de detectiekant leest Google C2PA Content Credentials en zijn eigen SynthID-watermerk om te antwoorden op “is dit AI-gegenereerd?” binnen Search, Images en Lens.2 Niets daarvan is een regel over welke afbeeldingen een blog mag publiceren, en niets daarvan kost u ranglijstposities. Wat is veranderd, is stroomafwaarts: de herkomst van de afbeelding bovenaan uw artikel is nu iets wat een lezer in twee klikken kan controleren, zonder het u te vragen. Een gelicentieerde foto heeft niets te verklaren.
Wanneer gegenereerde afbeeldingen wél de juiste keuze zijn. Conceptdiagrammen en schema's. Een scène die niet gefotografeerd kan worden (een product dat nog niet bestaat, een abstract mechanisme, een toekomstige stad). Een eigen huisstijl-illustratie die u wilt herhalen op elk bericht. En alles waarbij de afbeelding bewust wordt begrepen als een illustratie in plaats van als bewijs. Gebruik beide — stop alleen met generatie als standaard te gebruiken voor “ik heb een foto nodig van mensen in een vergadering.”
Drie manieren om te illustreren, afhankelijk van uw volume
Dezelfde engine, dezelfde catalogus — 9M+ gratis te gebruiken foto's uit 9 bibliotheken — en drie toegangspunten. Kies op basis van hoeveel artikelen u publiceert, niet op basis van hoe technisch u bent.
| Toegangspunt | Beste voorwie en hoeveel | Per artikel | Wat u nodig hebt |
|---|---|---|---|
| Zoekinterface | Redacteuren, één bericht tegelijk — tot ~20/maand | ~30 seconden | Een browser. Geen account nodig om te zoeken. |
| REST API | Een CMS, een static-site build, een batch conceptartikelen | ~1 aanvraag, ~150 ms | Een API-sleutel. 5.000 aanvragen/maand gratis, 20/min. |
| MCP-server | De AI-agent die het concept schrijft of bewerkt | Binnen hetzelfde gesprek | Eén connector-URL, OAuth of een sleutel. |
De drie delen één catalogus en één rangschikking, dus een foto die een redacteur in de UI vindt, is dezelfde foto, met dezelfde identifier, die de API teruggeeft aan uw buildscript.
Eén artikel, 30 seconden: de zoekinterface
Beschrijf de scène zoals u die aan een fotograaf zou beschrijven, in een volledige zin, in uw
eigen taal. Niet team meeting —
“a small team standing in a semi circle for a short morning stand-up meeting in a bright
open plan office”. Elk extra concreet detail vernauwt de resultatenset in plaats van hem leeg te maken,
omdat de engine rangschikt op betekenis in plaats van uw woorden te matchen met iemands tags.
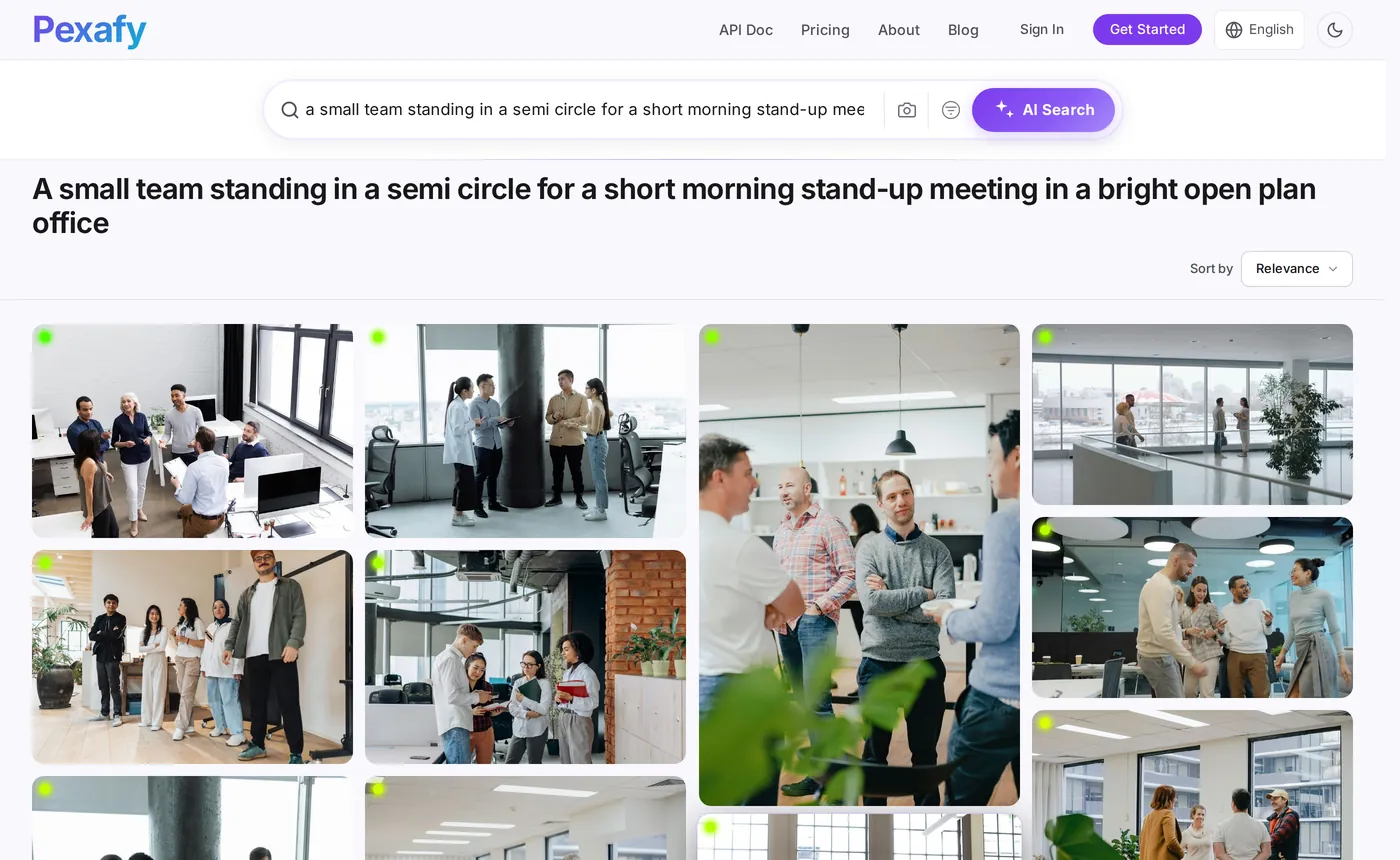
Verfijn de resultaten vervolgens met de filters die van belang zijn voor een artikellay-out — en alleen die:
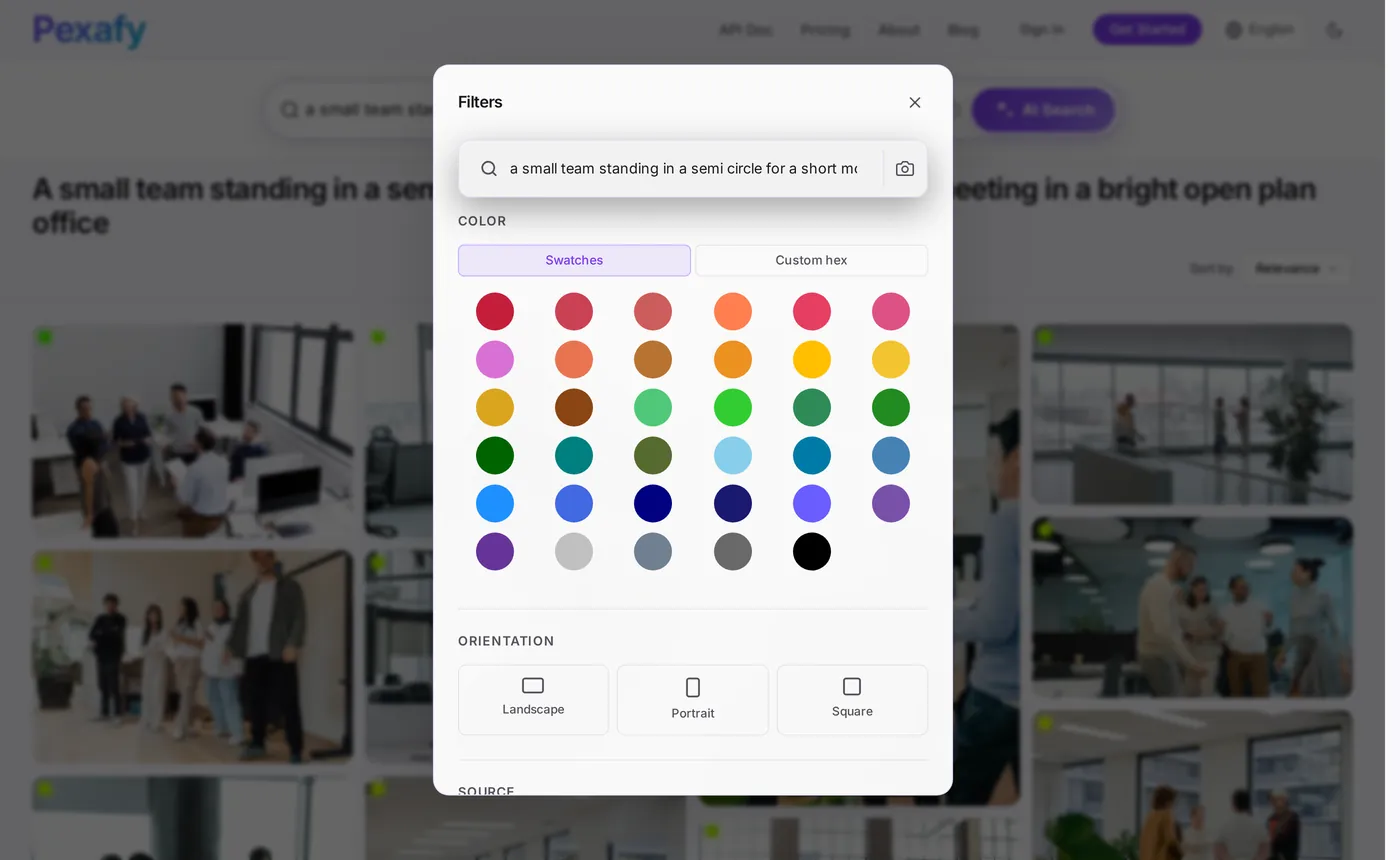
- Schrijf de zin, niet het zoekwoord. Onderwerp + actie + plaats + licht. Tot 500 tekens, in elk van de 100+ talen.
- Filter op liggend voor de hero, en voer de zoekopdracht dan opnieuw uit zonder filter voor afbeeldingen in het artikel, waar staand vaak beter oogt.
- Open de foto om de kant-en-klare attributieregel, de originele bronpagina en het bestand op volledige resolutie te krijgen.
- Gebruik “vergelijkbare foto's” op de gekozen foto om de volgende sectie te illustreren in hetzelfde visuele register — zelfde licht, zelfde behandeling, andere scène.
De prompt: een concept omzetten in een zoekzin
Dit is de stap die iedereen fout doet bij het automatiseren. Ze voeren de artikeltitel direct in het zoekvak in, en de titel is precies de verkeerde invoer: hij is abstract (“The hidden cost of context switching”) en geen enkele foto ter wereld beeldt dat af. Wat u van het model wilt, is geen samenvatting — het is een camerabriefing.
# system prompt
You are a photo editor. Read the article and write ONE search sentence
for a stock-photo engine that ranks by meaning, not by keywords.

Rules:
1. Describe a scene a camera could have taken: someone doing
   something, somewhere. Never name the topic itself ("fintech",
   "productivity", "SEO") — name what would be in the frame.
2. 12 to 25 words. Longer beats shorter: every concrete detail
   (light, place, gesture, time of day) sharpens the match.
3. No text, logos, brands, charts, screenshots or famous people.
   Free photo libraries have almost none of those.
4. No invisible metaphors ("growth", "synergy", "transformation").
5. Match the mood of the article: calm, tense, tired, celebratory.
6. Write the sentence in English even if the article is not.

Return JSON only:
{ "query": "…", "orientation": "landscape", "alt": "…" }
Regel 1 doet het meeste werk. Hier is diezelfde regel toegepast op drie echte conceptartikelen — de middelste kolom is wat een mens typt als hij haast heeft, de rechterkolom is wat de prompt teruggeeft:
| Het artikel gaat over… | De overhaaste zoekopdracht | De camerabriefing |
|---|---|---|
| Waarom uw dagelijkse stand-up niet werkt | team meeting |
“a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office” |
| Onboarding terugbrengen van 6 weken naar 9 dagen | onboarding |
“a new employee on their first day at a desk, listening while a colleague leans in and points at their screen” |
| De verborgen kosten van context switching | productivity |
“a tired developer rubbing their eyes in front of two monitors late in the evening, the office empty behind them” |
team meeting levert de generieke vergaderzaal-stockfoto op die iedereen anders die over uw onderwerp schrijft
al gebruikt. De zin in de derde kolom levert dit op, in 155 milliseconden:
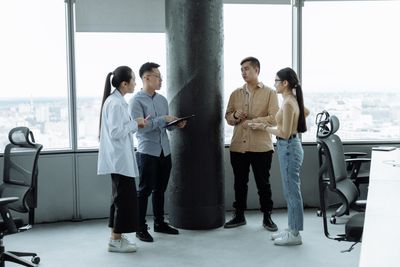

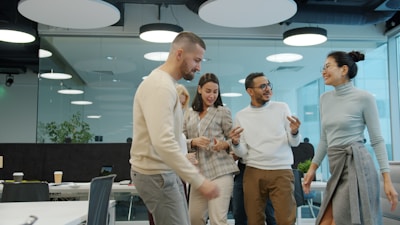
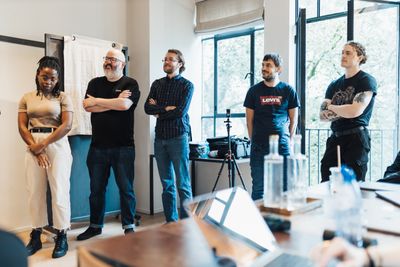
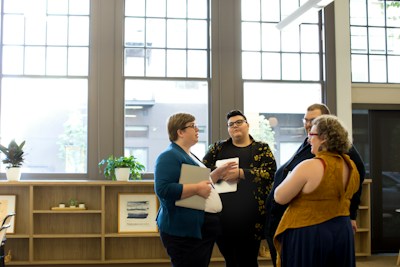
team meeting nooit garandeert.
De pipeline: concept erin, gecrediteerde hero-afbeelding eruit
Veertig regels, twee aanroepen: één naar het model voor de briefing, één naar Pexafy voor de foto. Zet het in de save-hook van uw CMS, uw static-site build, of een script dat een map met Markdown-bestanden doorloopt.
import json, os, requests
from anthropic import Anthropic

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
llm = Anthropic()  # ANTHROPIC_API_KEY uit de omgeving

def camera_brief(article: str) -> dict:
    # PHOTO_EDITOR = de systeemprompt hierboven
    msg = llm.messages.create(
        model="claude-sonnet-5",
        max_tokens=300,
        system=PHOTO_EDITOR,
        messages=[{ "role": "user", "content": article[:12000] }],
    )
    return json.loads(msg.content[0].text)

def illustrate(article: str) -> dict | None:
    brief = camera_brief(article)
    r = requests.get(
        SEARCH,
        headers={"X-Api-Key": os.environ["PEXAFY_API_KEY"]},
        params={
            "q": brief["query"],           # de volledige zin
            "orientation": brief["orientation"],
            "per_page": 8,
            "score_threshold": 0.55,      # zwakke matches negeren
        },
        timeout=10,
    )
    hits = r.json()["data"]
    if not hits:                        # briefing te specifiek → verruimen, opnieuw proberen
        return None

    top = hits[0]
    return {
        "src":    top["urls"]["regular"],        # 1080px — hero-formaat
        "alt":    brief["alt"] or top["alt_description"],
        "credit": top["attribution"]["html"],   # klaar om te tonen
        "width":  top["width"],
        "height": top["height"],
        "id":     top["photo_id"],           # bewaren: geen herhalingen
    }
Drie details die van een demo iets maken dat u kunt laten draaien:
score_threshold— niets teruggeven is beter dan een slechte foto teruggeven. Als de briefing te specifiek was, verruim hem (laat de laatste bijzin weg) en probeer het één keer opnieuw.- Bewaar de
photo_id— één regel in uw database, en nooit delen twee artikelen op uw site dezelfde hero-afbeelding. Dit is de fout waar iedereen op stuit bij artikel nummer dertig. - Eén aanvraag per afbeeldingsslot — een hero plus drie sectie-afbeeldingen is vier aanvragen per artikel, of één als u vier verschillende resultaten uit dezelfde zoekopdracht gebruikt.
Geen Python? De hele zoekhelft is één regel, en elk resultaat draagt dezelfde velden, ongeacht uit welke bibliotheek het komt:
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a tired developer rubbing their eyes at two monitors" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "per_page=6"

# → { "success": true, "data": [ … ], "meta": { "took_ms": 147 } }
De vorm van de respons — urls, width, photographer_full_name,
source, license_type, relevance_score,
attribution — is identiek voor een Pexels-foto, een Pixabay-foto en een Unsplash-
foto. Die normalisatie is het deel dat u anders zelf zou moeten schrijven en onderhouden; we hebben
het veld voor veld uit elkaar gehaald in
de vergelijking van gratis stockfoto-API's.
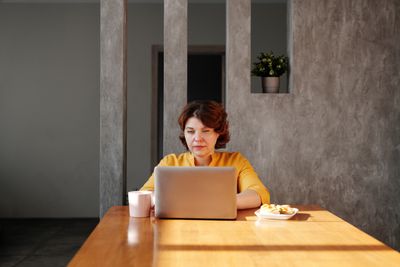
Tweede sectie, tweede briefing, tweede zoekopdracht — het punt is dat één artikel meerdere verschillende scènes oplevert in plaats van één foto vier keer uitgerekt:
Laat de agent de foto kiezen: MCP
Als een model al bezig is met het schrijven of bewerken van het concept, is de schoonste pipeline geen pipeline: geef de agent de zoektool en laat hem illustreren wat hij zojuist heeft geschreven, in hetzelfde gesprek, terwijl hij de context nog heeft.
Pexafy draait een gehoste Model Context Protocol-server op
mcp.pexafy.com/mcp. Drie tools:
search_photos (een zin),
search_photos_by_image (een referentieafbeelding, eventueel plus een zin — “zoals dit,
maar bij zonsondergang”), en get_similar_photos (meer zoals de foto die u al koos, wat u
helpt een reeks coherent te houden).
Settings → Connectors → Add custom connector
Name: Pexafy
URL:  https://mcp.pexafy.com/mcp
# meld u vervolgens aan met uw Pexafy-account wanneer het venster opent
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# of commit het naar de repo, zodat het hele team het krijgt — .mcp.json
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
Van daaruit is het illustreren van een artikel een zin, geen taak. De agent schrijft zijn eigen camerabriefing — hij heeft het concept net gelezen, dus hij is beter geplaatst dan wie dan ook om de scène te beschrijven:
You  Here's the draft of this week's post. Find a landscape hero
     and one photo for section 2, and give me the credit lines.

Claude  → search_photos(
       q="a small team standing in a semi circle for a short morning
          stand-up meeting in a bright open plan office",
       orientation="landscape")
     ← 16 photos · 155 ms

     Hero    → Photo by Thirdman on Pexels · 6453×4302 · score 0.80
     Section → Photo by Marcus Aurelius on Pexels · 6000×4000
     Both licence-free, attribution lines below, ready to paste.
Unsplash, Pexels, Pixabay en Openverse hebben geen officiële MCP-server — wat er bestaat, zijn door de community gebouwde wrappers die u zelf host en van een sleutel voorziet. Als uw redactionele workflow al via een agent verloopt, is dat verschil de integratie.
Alt-tekst, licentie en paginasnelheid
De afbeelding is gekozen. Vier dingen bepalen of ze de pagina helpt of in stilte schaadt:
-
Schrijf de alt-tekst voor een mens, niet voor een crawler. Elk resultaat wordt geleverd met een
alt_description— gebruik die als concept en herschrijf ze vervolgens in de context van uw alinea. “Vier collega's staan in een ochtendvergadering” is beter dan een zoekwoordensalade, en het is de tekst die een screenreader daadwerkelijk zal voorlezen. Houd het onder ~125 tekens; laat het alleen leeg (alt="") als de afbeelding puur decoratief is. -
Vermeld de credit, zelfs als niets u daartoe verplicht. Attributie is niet vereist
door de gebruiksvoorwaarden van de Pexafy API en elk resultaat draagt een kant-en-klare
attribution.html- string — maar de licentie die door de oorspronkelijke bibliotheek is verbonden aan die foto, is nog altijd van toepassing op uw gebruik ervan, en een zichtbare creditregel vertelt een lezer (en een answer engine) dat dit een echte foto met een echte auteur is. -
Serveer het juiste formaat.
urls.regular(1080 px) is een hero;urls.fullis een bestand van 2400 px dat geen enkel artikel nodig heeft. Geef altijdwidth/heightuit de respons mee zodat de browser de ruimte reserveert — dat ene attributenpaar is het verschil tussen een goede en een slechte layout-shift-score. Gebruikfetchpriority="high"op de hero,loading="lazy"op alles onder de vouw. -
Voed de hero aan uw metadata. Dezelfde URL moet uw
og:image, uwtwitter:imageen deimage-eigenschap van uwArticle-structured data zijn. Eén foto, drie plekken, geen extra werk — en een social preview die niet langer terugvalt op uw logo.
Wat 100 artikelen per maand daadwerkelijk kosten
Ga uit van een hero plus drie afbeeldingen in het artikel, dus vier zoekaanvragen per bericht — de bewust inefficiënte versie, waarbij u per slot een aparte zoekopdracht uitvoert in plaats van resultaten uit één opdracht te hergebruiken:
| Volume | Zoekaanvragen / maand | Plan | Zoekkosten |
|---|---|---|---|
| 20 artikelen | 80 | Gratis — 5.000 aanvr./maand | $0 |
| 100 artikelen | 400 | Gratis — 5.000 aanvr./maand | $0 |
| 1.000 artikeleneen bureau, of een hele klantportfolio | 4.000 | Gratis — nog altijd binnen 5.000 aanvr./maand | $0 |
Ja — het maandelijkse quotum is geen probleem bij volumes zoals in contentmarketing, en wij zeggen dat liever
dan een reden te verzinnen om te betalen. De limiet die u daadwerkelijk zult tegenkomen, is die per minuut.
Het gratis plan staat 20 API-aanvragen per minuut toe; een buildscript dat 100 artikelen in één keer opnieuw illustreert,
vuurt 400 aanvragen af zo snel als uw lus toestaat, dus het besteedt ofwel
twintig minuten aan afremmen, of het begint 429's te verzamelen. Twee uitwegen: spreid de
aanroepen (één sleep in de lus, en een nachtelijke taak merkt er niets van), of stap over naar een plan
waarvan het snelheidslimiet overeenkomt met uw build — Starter is 30 aanvragen/minuut, Pro 60. Kies op basis van
piekbelasting, niet op basis van volume.
De enige andere kostenpost is één korte modelaanroep per artikel om de briefing te produceren — een paar honderd tokens in, dertig uit, wat het goedkoopste onderdeel zal zijn van elke contentpijplijn die u bezit. Vergelijk dat met het genereren van vier afbeeldingen per bericht, bij vierhonderd afbeeldingen per maand, plus de pogingen die het niet haalden.
En het deel dat niet in een kostentabel verschijnt: de redacteur opent geen vijf tabbladen meer. Dat is de werkelijke besparing.
Bronnen & voetnoten
1 EU AI Act, Artikel 50 — transparantieverplichtingen voor aanbieders en deployers van bepaalde AI-systemen, van toepassing vanaf 2 augustus 2026. Aanbieders van systemen die synthetische audio, beeld, video of tekst genereren, moeten output markeren in een machineleesbaar formaat en detecteerbaar maken als kunstmatig gegenereerd; deployers moeten deepfakes bekendmaken en, in bepaalde gevallen, AI-gegenereerde tekst die wordt gepubliceerd om het publiek te informeren. De Digital Omnibus (Verordening (EU) 2026/1744, van kracht sinds 27 juli 2026) laat Artikel 50 zelf ongewijzigd, maar geeft systemen die al vóór 2 augustus 2026 op de markt waren tot 2 december 2026 de tijd om te voldoen aan de vereiste van machineleesbare markering van Artikel 50(2). Dit alles bindt AI-aanbieders en -deployers — het is geen regel over welke afbeeldingen een blog mag publiceren.
2 Google leest C2PA Content Credentials en zijn eigen SynthID- watermerk om herkomst zichtbaar te maken in About this image binnen Search, Images en Lens. Dit is media-herkomst, geen ranking-straf op AI-gegenereerde content.
Bronnen gecontroleerd op 15 augustus 2026: AI Act Artikel 50 · Europese Commissie — transparantie-FAQ · Google — afbeeldingsmetadata · Pexafy API- & MCP-documentatie. Zoektijden en resultaten zijn echte responses van de publieke API, dezelfde dag vastgelegd.
Veelgestelde vragen
Moet ik AI-gegenereerde afbeeldingen of echte foto's gebruiken voor blogartikelen?
Hoe vind ik automatisch een afbeelding die bij mijn artikel past?
GET /api/v1/search/photos?q=…, ongeveer 150 ms, en elk resultaat komt terug met zijn afmetingen, licentie en een kant-en-klare attributietekst.Wat is de beste prompt om een artikel om te zetten in een zoekopdracht voor afbeeldingen?
Moet ik de foto's die ik in blogposts gebruik crediteren?
Kan Claude of een andere AI-agent de foto's voor mijn artikel vinden?
mcp.pexafy.com/mcp. Voeg deze toe als aangepaste connector in Claude.ai of Claude Desktop en log in met OAuth, of voeg hem toe aan Claude Code met één claude mcp add-commando en een API-sleutel. De agent zoekt vervolgens zelf op zin, op referentieafbeelding of naar vergelijkbare foto's, terwijl hij je concept nog in context heeft.Hoe voorkom ik dat elk artikel op mijn blog dezelfde foto gebruikt?
photo_id op van elke afbeelding die je publiceert en sluit dat uit bij de volgende run — één kolom in je CMS. Het is het faalmoment waar elke geautomatiseerde pipeline rond artikel dertig tegenaan loopt, en het is onzichtbaar totdat iemand door je blogindex scrolt. Per sectie een nieuwe camera brief schrijven, in plaats van de artikeltitel te hergebruiken, doet de rest.

