Como Ilustrar Todo Artigo Que Você Publica — Com Fotos Reais, em Escala
Por que equipes de publicação estão voltando para a fotografia real, e o pipeline exato — prompt incluído — que transforma um rascunho finalizado em uma imagem de destaque creditada em cerca de 150 milissegundos.
 Marouane Tijani
10 min de leitura

Todo artigo que você publica precisa de uma imagem. Não é um extra — a imagem de destaque é o que a prévia social mostra, o que o leitor vê antes da primeira frase, e o que diz a ele em meio segundo se essa página foi feita por alguém que se importou. Multiplique isso por quatro imagens por post e quarenta posts por trimestre, e “encontrar uma foto” deixa de ser uma tarefa e passa a ser um problema de pipeline.
É assim que resolvemos: o que usar no lugar de imagens geradas e por quê, e as três formas de conectar o Pexafy ao fluxo de trabalho — manualmente, por API ou por meio de um agente de IA — incluindo o prompt que transforma um rascunho pronto em uma frase de busca que de fato encontra algo.
Por que fotos reais ainda superam as geradas
Gerar uma ilustração é fácil, e é justamente esse o problema. Quatro coisas mudaram entre “imagens de IA são um atalho” e hoje:
1 · Em volume, buscar é mais rápido do que gerar
Uma geração é um prompt, uma espera, uma inspeção e — sejamos honestos — mais duas ou três tentativas antes de uma ficar utilizável. Uma busca semântica é uma única requisição que retorna dezesseis candidatos em cerca de 150 milissegundos, cada um já licenciado, já com crédito, já dimensionado, com as dimensões na resposta. Para uma imagem, a diferença é um café. Para quatrocentas imagens por trimestre, é a diferença entre um fluxo de trabalho e um emprego.
2 · Uma fotografia é precisa; uma geração é plausível
No momento em que seu artigo trata de algo real — uma profissão, um equipamento, uma cidade, um gesto, um material —, uma imagem gerada acerta o clima e erra os detalhes. As mãos com seis dedos são a versão engraçada; a versão cara é um instrumento cirúrgico que não existe, um cockpit com controles inventados, ou uma “rua de Lisboa” que ninguém de Lisboa reconhece. Leitores que conhecem seu assunto percebem, e percebem a imagem primeiro.
3 · Todo mundo tem a mesma cara
Modelos de difusão convergem para um estilo de casa, e uma parede de ilustrações de gradiente suave, superiluminadas e suspeitosamente simétricas já soa como preenchimento. Essa percepção é o custo real: não uma penalidade, um sinal. Uma fotografia real — grão, uma cadeira desajeitada, alguém no meio de uma frase — soa como reportagem.
4 · E agora chegam com um rótulo grudado
Este ponto é mais contexto do que argumento, mas é a direção da estrada. Desde 2 de agosto de 2026, o Artigo 50 do EU AI Act exige que provedores de sistemas generativos marquem saídas sintéticas em formato legível por máquina, e que implantadores divulguem deepfakes.1 Do lado da detecção, o Google lê as C2PA Content Credentials e sua própria marca d'água SynthID para responder “isto foi gerado por IA?” dentro do Search, do Images e do Lens.2 Nada disso é uma regra sobre quais imagens um blog pode publicar, e nada disso custa posições no ranking. O que mudou está a jusante: a proveniência da imagem no topo do seu artigo agora é algo que um leitor pode verificar em dois cliques, sem perguntar a você. Uma fotografia licenciada não tem nada a declarar.
Quando imagens geradas são a escolha certa. Diagramas de conceito e esquemas. Uma cena que não pode ser fotografada (um produto que ainda não existe, um mecanismo abstrato, uma cidade futura). Um estilo de ilustração de casa que você possui e quer repetir em todo post. E qualquer coisa em que a imagem seja deliberadamente entendida como ilustração, e não como evidência. Use os dois — apenas pare de usar geração como padrão para “preciso de uma foto de pessoas em uma reunião”.
Três formas de ilustrar, dependendo do seu volume
Mesmo motor, mesmo catálogo — 9M+ fotos de uso livre de 9 bibliotecas — e três pontos de entrada. Escolha pela quantidade de artigos que você publica, não por quão técnico você é.
| Ponto de entrada | Melhor paraquem e quanto | Por artigo | O que você precisa |
|---|---|---|---|
| Interface de busca | Editores, um post por vez — até ~20/mês | ~30 segundos | Um navegador. Não é preciso conta para buscar. |
| API REST | Um CMS, um build de site estático, um lote de rascunhos | ~1 requisição, ~150 ms | Uma chave de API. 5.000 req/mês grátis, 20/min. |
| Servidor MCP | O agente de IA que escreve ou edita o rascunho | Dentro da mesma conversa | Uma URL de conector, OAuth ou uma chave. |
Os três compartilham um catálogo e uma classificação, de modo que uma foto encontrada por um editor na interface é a mesma foto, com o mesmo identificador, que a API retorna para o seu script de build.
Um artigo, 30 segundos: a interface de busca
Descreva a cena da forma como você descreveria para um fotógrafo, em uma frase completa, no seu
próprio idioma. Não team meeting —
“a small team standing in a semi circle for a short morning stand-up meeting in a bright
open plan office”. Cada detalhe concreto a mais estreita o conjunto de resultados em vez de
esvaziá-lo, porque o motor classifica por significado, e não comparando suas palavras com as
tags de alguém.
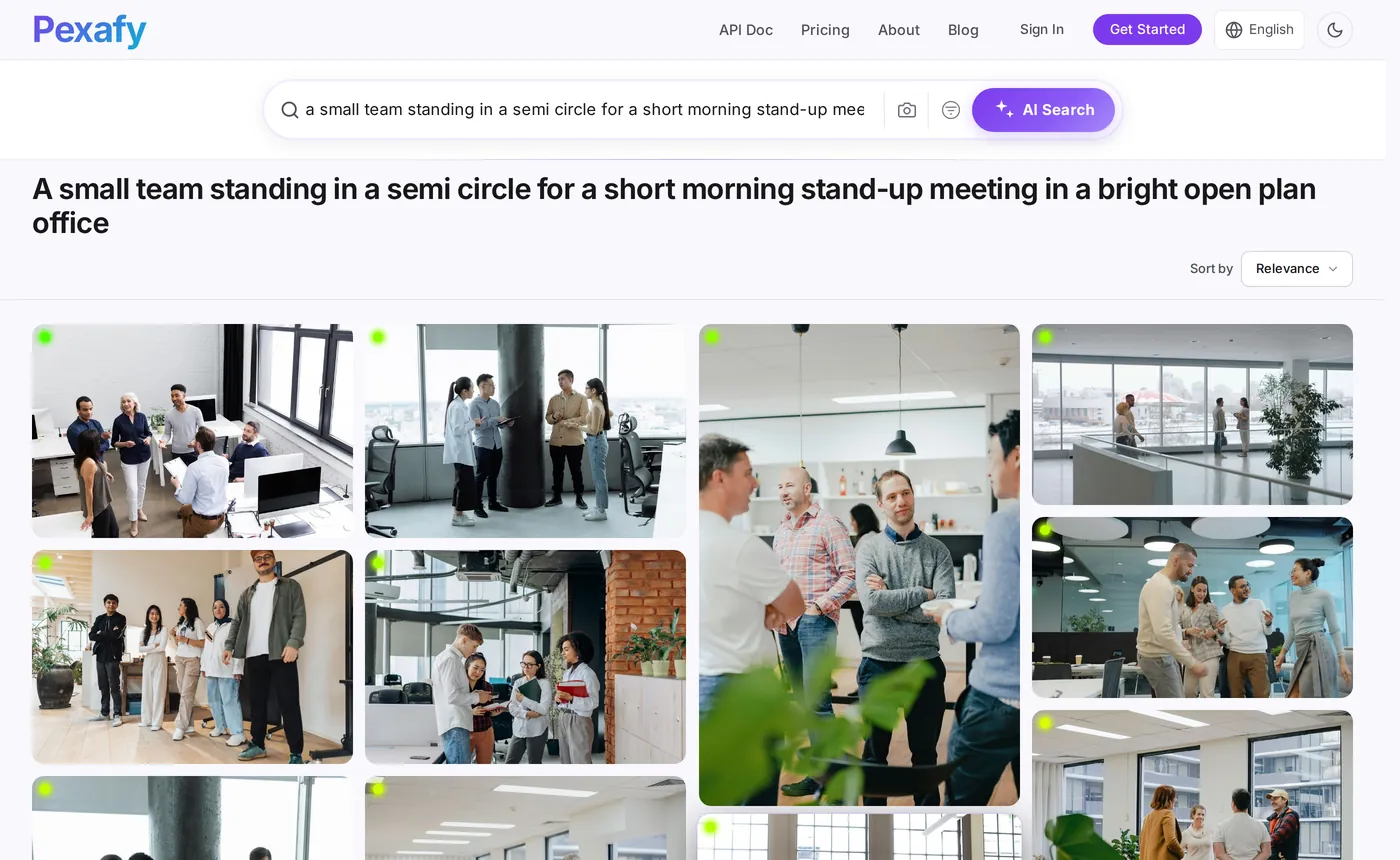
Depois, refine com os filtros que importam para o layout de um artigo — e apenas esses:
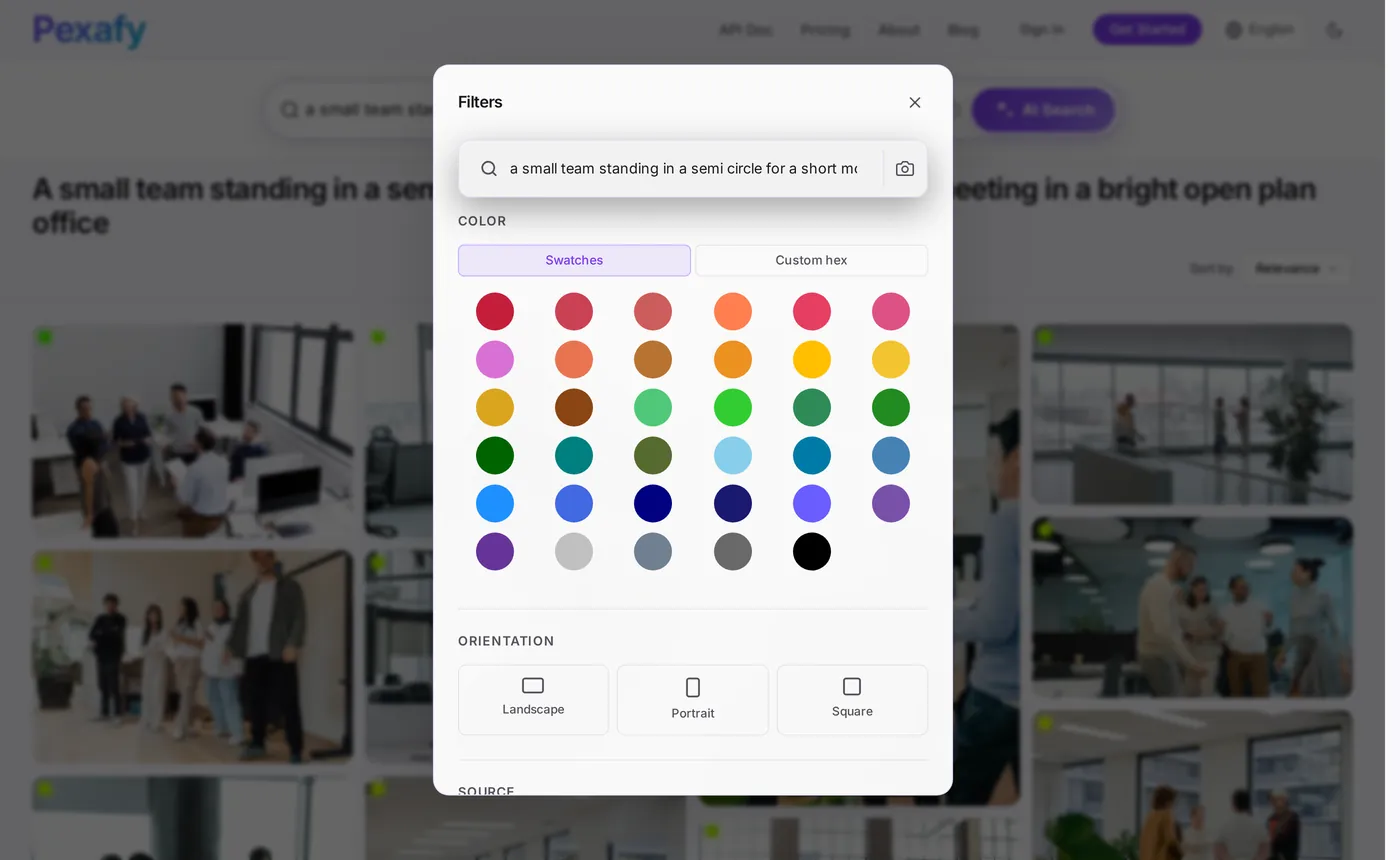
- Escreva a frase, não a palavra-chave. Sujeito + ação + lugar + luz. Até 500 caracteres, em qualquer um de mais de 100 idiomas.
- Filtre por paisagem para a imagem de destaque, depois execute de novo sem o filtro para imagens dentro do artigo, onde retrato costuma ficar melhor.
- Abra a foto para obter a linha de atribuição pronta, a página de origem original e o arquivo em resolução total.
- Use “fotos semelhantes” na que você escolheu para ilustrar a próxima seção no mesmo registro visual — mesma luz, mesmo tratamento, cena diferente.
O prompt: transforme um rascunho em uma frase de busca
Este é o passo que todo mundo erra ao automatizar. Alimentam a caixa de busca diretamente com o título do artigo, e o título é exatamente o input errado: ele é abstrato (“The hidden cost of context switching”) e nenhuma fotografia do mundo o representa. O que você quer do modelo não é um resumo — é um briefing de câmera.
# system prompt
You are a photo editor. Read the article and write ONE search sentence
for a stock-photo engine that ranks by meaning, not by keywords.

Rules:
1. Describe a scene a camera could have taken: someone doing
   something, somewhere. Never name the topic itself ("fintech",
   "productivity", "SEO") — name what would be in the frame.
2. 12 to 25 words. Longer beats shorter: every concrete detail
   (light, place, gesture, time of day) sharpens the match.
3. No text, logos, brands, charts, screenshots or famous people.
   Free photo libraries have almost none of those.
4. No invisible metaphors ("growth", "synergy", "transformation").
5. Match the mood of the article: calm, tense, tired, celebratory.
6. Write the sentence in English even if the article is not.

Return JSON only:
{ "query": "…", "orientation": "landscape", "alt": "…" }
A regra 1 faz a maior parte do trabalho. Aqui está a mesma regra aplicada a três rascunhos reais — a coluna do meio é o que uma pessoa digita quando está com pressa, a coluna da direita é o que o prompt retorna:
| O artigo é sobre… | A consulta apressada | O briefing de câmera |
|---|---|---|
| Por que sua reunião diária está quebrada | team meeting |
“a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office” |
| Reduzindo o onboarding de 6 semanas para 9 dias | onboarding |
“a new employee on their first day at a desk, listening while a colleague leans in and points at their screen” |
| O custo oculto de trocar de contexto | productivity |
“a tired developer rubbing their eyes in front of two monitors late in the evening, the office empty behind them” |
team meeting retorna o estoque genérico de sala de reunião que todo mundo que
escreve sobre seu tema já está usando. A frase na terceira coluna retorna isto, em
155 milissegundos:
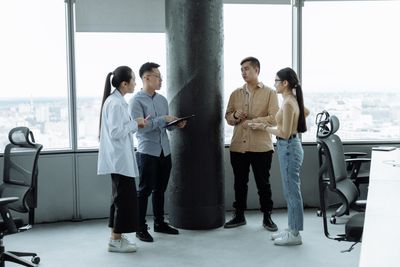

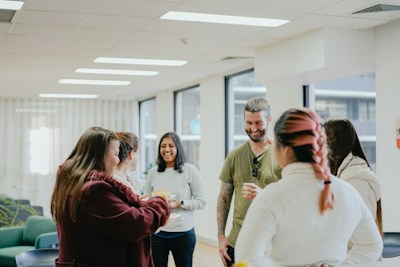
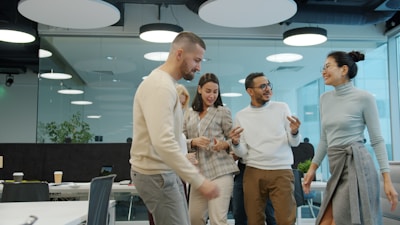
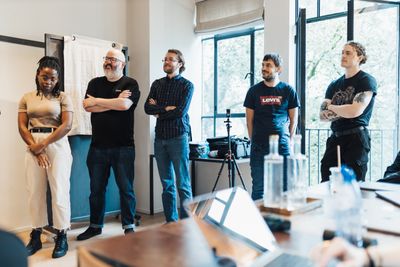
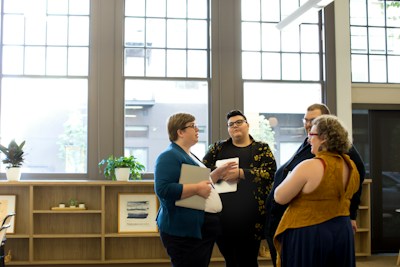
team meeting nunca garante.
O pipeline: rascunho entra, imagem de destaque com crédito sai
Quarenta linhas, duas chamadas: uma ao modelo para o briefing, outra ao Pexafy para a foto. Coloque no hook de salvamento do seu CMS, no build do seu site estático, ou em um script que percorre uma pasta de arquivos Markdown.
import json, os, requests
from anthropic import Anthropic

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
llm = Anthropic()  # ANTHROPIC_API_KEY vindo do ambiente

def camera_brief(article: str) -> dict:
    # PHOTO_EDITOR = o system prompt acima
    msg = llm.messages.create(
        model="claude-sonnet-5",
        max_tokens=300,
        system=PHOTO_EDITOR,
        messages=[{ "role": "user", "content": article[:12000] }],
    )
    return json.loads(msg.content[0].text)

def illustrate(article: str) -> dict | None:
    brief = camera_brief(article)
    r = requests.get(
        SEARCH,
        headers={"X-Api-Key": os.environ["PEXAFY_API_KEY"]},
        params={
            "q": brief["query"],           # a frase completa
            "orientation": brief["orientation"],
            "per_page": 8,
            "score_threshold": 0.55,      # descarta correspondências fracas
        },
        timeout=10,
    )
    hits = r.json()["data"]
    if not hits:                        # briefing estreito demais → amplia e tenta de novo
        return None

    top = hits[0]
    return {
        "src":    top["urls"]["regular"],        # 1080px — tamanho de destaque
        "alt":    brief["alt"] or top["alt_description"],
        "credit": top["attribution"]["html"],   # pronto para renderizar
        "width":  top["width"],
        "height": top["height"],
        "id":     top["photo_id"],           # guarde: sem repetições
    }
Três detalhes que transformam uma demonstração em algo que você pode deixar rodando:
score_threshold— não retornar nada é melhor do que retornar uma foto ruim. Se o briefing ficou específico demais, amplie-o (remova a última cláusula) e tente de novo uma vez.- Guarde o
photo_id— uma linha no seu banco de dados, e nunca dois artigos do seu site compartilham uma imagem de destaque. Essa é a falha que todo mundo encontra no artigo número trinta. - Uma requisição por slot de imagem — uma imagem de destaque mais três imagens de seção são quatro requisições por artigo, ou uma se você aproveitar quatro resultados diferentes da mesma busca.
Não usa Python? Toda a parte de busca é uma linha, e todo resultado traz os mesmos campos independentemente da biblioteca de origem:
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a tired developer rubbing their eyes at two monitors" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "per_page=6"

# → { "success": true, "data": [ … ], "meta": { "took_ms": 147 } }
O formato da resposta — urls, width,
photographer_full_name, source, license_type,
relevance_score, attribution — é idêntico para uma foto do Pexels, uma
do Pixabay e uma do Unsplash. Essa normalização é a parte que você mesmo teria que escrever e
manter; nós a desmontamos campo por campo em
a comparação de APIs gratuitas de banco de imagens.
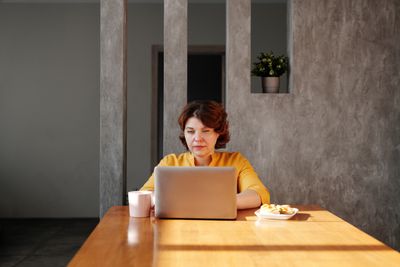
Segunda seção, segundo briefing, segunda busca — a ideia é que um artigo produza várias cenas distintas em vez de uma única foto esticada quatro vezes:
Deixe o agente escolher a imagem: MCP
Se um modelo já está escrevendo ou editando o rascunho, o pipeline mais limpo é nenhum pipeline: dê ao agente a ferramenta de busca e deixe-o ilustrar o que acabou de escrever, na mesma conversa, enquanto ainda tem o contexto.
O Pexafy roda um servidor Model Context Protocol hospedado em
mcp.pexafy.com/mcp. Três ferramentas:
search_photos (uma frase),
search_photos_by_image (uma imagem de referência, opcionalmente mais uma frase —
“como esta, mas ao pôr do sol”), e get_similar_photos (mais parecidas com a que você já
escolheu, o que é como se mantém uma série coerente).
Settings → Connectors → Add custom connector
Name: Pexafy
URL:  https://mcp.pexafy.com/mcp
# depois faça login com sua conta Pexafy quando a janela abrir
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# ou registre no repositório, para que toda a equipe tenha acesso — .mcp.json
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
A partir daí, ilustrar um artigo é uma frase, não uma tarefa. O agente escreve seu próprio briefing de câmera — ele acabou de ler o rascunho, então está em melhor posição do que ninguém para descrever a cena:
You  Here's the draft of this week's post. Find a landscape hero
     and one photo for section 2, and give me the credit lines.

Claude  → search_photos(
       q="a small team standing in a semi circle for a short morning
          stand-up meeting in a bright open plan office",
       orientation="landscape")
     ← 16 photos · 155 ms

     Hero    → Photo by Thirdman on Pexels · 6453×4302 · score 0.80
     Section → Photo by Marcus Aurelius on Pexels · 6000×4000
     Both licence-free, attribution lines below, ready to paste.
Unsplash, Pexels, Pixabay e Openverse não têm servidor MCP oficial — o que existe são wrappers comunitários que você mesmo hospeda e chaveia. Se seu fluxo editorial já passa por um agente, essa diferença é a integração.
Texto alternativo, licença e velocidade de página
A imagem está escolhida. Quatro coisas decidem se ela ajuda a página ou a prejudica em silêncio:
-
Escreva o texto alternativo para uma pessoa, não para um rastreador. Todo
resultado vem com um
alt_description— use-o como rascunho, depois reescreva-o no contexto do seu parágrafo. “Quatro colegas em pé em uma reunião matinal” supera uma salada de palavras-chave, e é o texto que um leitor de tela de fato vai ler em voz alta. Mantenha abaixo de ~125 caracteres; deixe vazio (alt="") somente se a imagem for puramente decorativa. -
Inclua o crédito mesmo quando nada o obriga. A atribuição não é exigida pelos
termos da API do Pexafy e todo resultado traz uma string
attribution.htmlpronta — mas a licença anexada pela biblioteca original ainda rege o uso que você faz daquela foto, e uma linha de crédito visível é o que diz a um leitor (e a um motor de resposta) que aquela é uma fotografia real com um autor real. -
Sirva o tamanho certo.
urls.regular(1080 px) é uma imagem de destaque;urls.fullé um arquivo de 2400 px que nenhum artigo precisa. Sempre emitawidth/heighta partir da resposta para que o navegador reserve o espaço — esse par de atributos, sozinho, é a diferença entre uma boa e uma má pontuação de mudança de layout. Usefetchpriority="high"na imagem de destaque,loading="lazy"em tudo abaixo da dobra. -
Alimente sua imagem de destaque para os seus metadados. A mesma URL deve ser
seu
og:image, seutwitter:imagee a propriedadeimagedos seus dados estruturados deArticle. Uma foto, três lugares, zero trabalho extra — e uma prévia social que deixa de recair sobre o seu logotipo.
Quanto custam de fato 100 artigos por mês
Suponha uma imagem de destaque mais três imagens dentro do artigo, ou seja, quatro requisições de busca por post — a versão deliberadamente desperdiçadora, em que você executa uma consulta separada por slot em vez de reaproveitar resultados de uma só:
| Volume | Requisições de busca / mês | Plano | Custo da busca |
|---|---|---|---|
| 20 artigos | 80 | Grátis — 5.000 req/mês | $0 |
| 100 artigos | 400 | Grátis — 5.000 req/mês | $0 |
| 1.000 artigosuma agência, ou o portfólio inteiro de um cliente | 4.000 | Grátis — ainda dentro de 5.000 req/mês | $0 |
Sim — a cota mensal não é um problema nos volumes de marketing de conteúdo, e preferimos dizer
isso a inventar um motivo para você pagar. O limite que você de fato vai encontrar é o
por minuto. O plano gratuito permite 20 requisições de API por minuto; um script de
build que reilustra 100 artigos em uma só passada dispara 400 requisições tão rápido quanto seu
laço permitir, então ou passa vinte minutos sendo limitado, ou começa a colecionar
429s. Duas saídas: espaçar as chamadas (um sleep no laço, e um job
noturno nem percebe), ou migrar para um plano cujo limite de taxa combine com seu build —
Starter é 30 requisições/minuto, Pro é 60. Escolha pelo pico, não pelo volume.
A única outra linha de custo é uma chamada curta ao modelo por artigo para produzir o briefing — algumas centenas de tokens de entrada, trinta de saída, o que será o item mais barato de qualquer pipeline de conteúdo que você possua. Compare isso com gerar quatro imagens por post, em quatrocentas imagens por mês, mais as tentativas que não deram certo.
E a parte que não aparece em nenhuma tabela de custo: o editor para de abrir cinco abas. Essa é a economia de verdade.
Referências e notas de rodapé
1 EU AI Act, Artigo 50 — obrigações de transparência para provedores e implantadores de determinados sistemas de IA, aplicável a partir de 2 de agosto de 2026. Provedores de sistemas que geram áudio, imagem, vídeo ou texto sintéticos devem marcar as saídas em formato legível por máquina e torná-las detectáveis como geradas artificialmente; implantadores devem divulgar deepfakes e, em casos definidos, texto gerado por IA publicado para informar o público. O Digital Omnibus (Regulamento (UE) 2026/1744, em vigor desde 27 de julho de 2026) deixa o próprio Artigo 50 sem alterações, mas dá aos sistemas já no mercado antes de 2 de agosto de 2026 até 2 de dezembro de 2026 para cumprir a exigência de marcação legível por máquina do Artigo 50(2). Tudo isso vincula provedores e implantadores de IA — não é uma regra sobre quais imagens um blog pode publicar.
2 O Google lê as C2PA Content Credentials e sua própria marca d'água SynthID para exibir a proveniência em Sobre esta imagem no Search, no Images e no Lens. Isso é proveniência de mídia, não uma penalidade de ranqueamento sobre conteúdo gerado por IA.
Fontes verificadas em 15 de agosto de 2026: AI Act Artigo 50 · Comissão Europeia — FAQ de transparência · Google — metadados de imagem · Documentação da API e do MCP do Pexafy. Os tempos de busca e os resultados são respostas reais da API pública, capturadas no mesmo dia.
Perguntas frequentes
Devo usar imagens geradas por IA ou fotos reais para artigos de blog?
Como encontro automaticamente uma imagem que combine com meu artigo?
GET /api/v1/search/photos?q=…, cerca de 150 ms, e cada resultado vem com seu tamanho, licença e uma string de atribuição pronta.Qual é o melhor prompt para transformar um artigo em uma consulta de busca de imagem?
Preciso creditar as fotos que uso em posts de blog?
O Claude ou outro agente de IA pode encontrar as fotos para meu artigo?
mcp.pexafy.com/mcp. Adicione-o como um conector personalizado no Claude.ai ou Claude Desktop e faça login com OAuth, ou adicione-o ao Claude Code com um único comando claude mcp add e uma chave de API. O agente então busca por frase, por imagem de referência ou por fotos semelhantes por conta própria, enquanto ainda tem seu rascunho no contexto.Como evito que todo artigo do meu blog use a mesma foto?
photo_id de cada imagem que você publica e exclua-o na próxima execução — uma coluna no seu CMS. Esse é o modo de falha que todo pipeline automatizado encontra por volta do trigésimo post, e é invisível até alguém rolar o índice do seu blog. Escrever um briefing de câmera novo por seção, em vez de reutilizar o título do artigo, faz o resto.

