Wie Sie jeden veröffentlichten Artikel mit echten Fotos illustrieren — und das im großen Maßstab
Warum Publishing-Teams zur echten Fotografie zurückkehren, und die genaue Pipeline — Prompt inklusive —, die aus einem fertigen Entwurf in rund 150 Millisekunden ein mit Quellenangabe versehenes Titelbild macht.
 Marouane Tijani
10 Min. Lesezeit

Jeder Artikel, den Sie veröffentlichen, braucht ein Bild. Kein „nice to have“ — das Titelbild ist das, was die Social-Vorschau zeigt, was die Leserin oder der Leser vor dem ersten Satz sieht, und was ihnen innerhalb einer halben Sekunde verrät, ob diese Seite von jemandem gemacht wurde, der sich Mühe gegeben hat. Multiplizieren Sie das mit vier Bildern pro Beitrag und vierzig Beiträgen im Quartal, und „ein Foto finden“ hört auf, eine Aufgabe zu sein, und wird zu einem Pipeline-Problem.
So lösen wir das: was statt generierter Bilder zu verwenden ist und warum, und die drei Wege, Pexafy in den Workflow einzubinden — manuell, per API oder über einen KI-Agenten — samt dem Prompt, der einen fertigen Entwurf in einen Suchsatz verwandelt, der tatsächlich etwas findet.
Warum echte Fotos generierten immer noch überlegen sind
Eine Illustration zu generieren ist einfach, und genau das ist das Problem. Vier Dinge haben sich verändert zwischen „KI-Bilder sind ein Cheat-Code“ und heute:
1 · Bei größerem Volumen ist Suchen schneller als Generieren
Eine Generierung bedeutet einen Prompt, eine Wartezeit, eine Prüfung und — seien wir ehrlich — zwei oder drei weitere Versuche, bevor eines brauchbar ist. Eine semantische Suche ist eine einzelne Anfrage, die mit sechzehn Kandidaten in etwa 150 Millisekunden zurückkommt, jeder davon bereits lizenziert, bereits kreditiert, bereits in passender Größe, mit den Abmessungen in der Antwort. Für ein Bild ist der Unterschied ein Kaffee. Für vierhundert Bilder im Quartal ist es der Unterschied zwischen einem Workflow und einem Job.
2 · Eine Fotografie ist akkurat; eine Generierung ist plausibel
Sobald Ihr Artikel von etwas Realem handelt — einem Beruf, einem Gerät, einer Stadt, einer Geste, einem Material — trifft ein generiertes Bild die Stimmung, aber nicht die Details. Hände mit sechs Fingern sind die scherzhafte Version; die teure Version ist ein chirurgisches Instrument, das es nicht gibt, ein Cockpit mit erfundenen Bedienelementen oder eine „Straße in Lissabon“, die niemand aus Lissabon wiedererkennt. Leser, die sich mit Ihrem Thema auskennen, bemerken das — und sie bemerken das Bild zuerst.
3 · Alle haben denselben Look
Diffusionsmodelle konvergieren auf einen Hausstil, und eine Wand aus weich schattierten, überbelichteten, verdächtig symmetrischen Illustrationen liest sich inzwischen als Lückenfüller. Diese Wahrnehmung ist die eigentliche Kosten: keine Strafe, sondern ein Signal. Eine echte Fotografie — Korn, ein unbeholfener Stuhl, jemand mitten im Satz — liest sich als Berichterstattung.
4 · Und jetzt kommen sie mit einem Label
Dieser Punkt ist eher Kontext als Argument, aber er zeigt die Richtung. Seit dem 2. August 2026 verlangt Artikel 50 des EU AI Act von Anbietern generativer Systeme, synthetische Ausgaben in maschinenlesbarer Form zu kennzeichnen, und von Einsatzverantwortlichen, Deepfakes offenzulegen.1 Auf der Erkennungsseite liest Google C2PA Content Credentials und das eigene SynthID-Wasserzeichen, um in Search, Images und Lens die Frage „Ist das KI-generiert?“ zu beantworten.2 Nichts davon ist eine Regel darüber, welche Bilder ein Blog veröffentlichen darf, und nichts davon kostet Sie Rankings. Was sich geändert hat, liegt weiter unten in der Kette: die Herkunft des Bildes am Kopf Ihres Artikels ist jetzt etwas, das eine Leserin oder ein Leser mit zwei Klicks prüfen kann, ohne Sie zu fragen. Eine lizenzierte Fotografie hat nichts zu erklären.
Wann generierte Bilder doch die richtige Wahl sind. Konzeptdiagramme und Schaubilder. Eine Szene, die sich nicht fotografieren lässt (ein Produkt, das es noch nicht gibt, ein abstrakter Mechanismus, eine zukünftige Stadt). Ein eigener Illustrationsstil, den Sie besitzen und auf jedem Beitrag wiederholen wollen. Und alles, wo das Bild bewusst als Illustration verstanden wird, nicht als Beleg. Nutzen Sie beides — hören Sie nur auf, Generierung standardmäßig für „ich brauche ein Foto von Leuten in einem Meeting“ einzusetzen.
Drei Wege zur Illustration, je nach Ihrem Volumen
Dieselbe Engine, derselbe Katalog — 9M+ frei nutzbare Fotos aus 9 Bibliotheken — und drei Einstiegspunkte. Wählen Sie danach, wie viele Artikel Sie veröffentlichen, nicht danach, wie technisch versiert Sie sind.
| Einstiegspunkt | Am besten fürwen und wie viel | Pro Artikel | Was Sie brauchen |
|---|---|---|---|
| Such-Oberfläche | Redakteure, ein Beitrag zur Zeit — bis zu ~20/Monat | ~30 Sekunden | Ein Browser. Zum Suchen ist kein Konto nötig. |
| REST-API | Ein CMS, ein Static-Site-Build, ein Stapel Entwürfe | ~1 Anfrage, ~150 ms | Ein API-Schlüssel. 5.000 Anfragen/Monat kostenlos, 20/Min. |
| MCP-Server | Der KI-Agent, der den Entwurf schreibt oder bearbeitet | Innerhalb derselben Unterhaltung | Eine Connector-URL, OAuth oder ein Schlüssel. |
Alle drei teilen sich einen Katalog und ein Ranking, sodass ein von einer Redakteurin in der Oberfläche gefundenes Foto genau dasselbe Foto ist, mit derselben Kennung, das die API an Ihr Build-Skript zurückgibt.
Ein Artikel, 30 Sekunden: die Such-Oberfläche
Beschreiben Sie die Szene so, wie Sie sie einer Fotografin gegenüber beschreiben würden, in
einem vollständigen Satz, in Ihrer eigenen Sprache. Nicht team meeting —
eher „a small team standing in a semi circle for a short morning stand-up meeting in a
bright open plan office“. Jedes zusätzliche konkrete Detail engt die Ergebnismenge ein,
statt sie zu leeren, weil die Engine nach Bedeutung rankt, nicht nach dem Abgleich Ihrer Wörter
mit den Tags einer anderen Person.
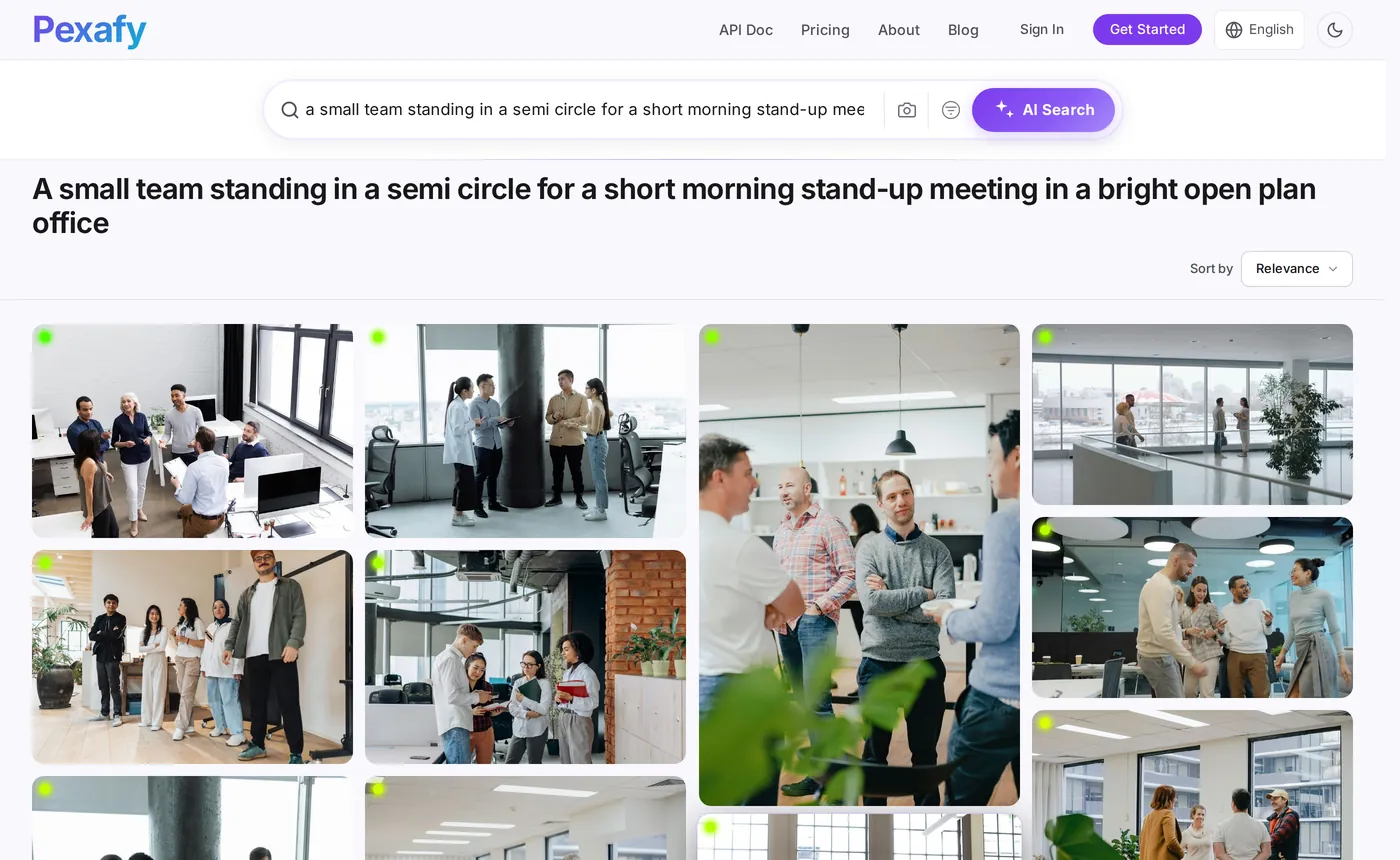
Grenzen Sie sie dann mit den Filtern ein, die für ein Artikel-Layout wichtig sind — und nur mit diesen:
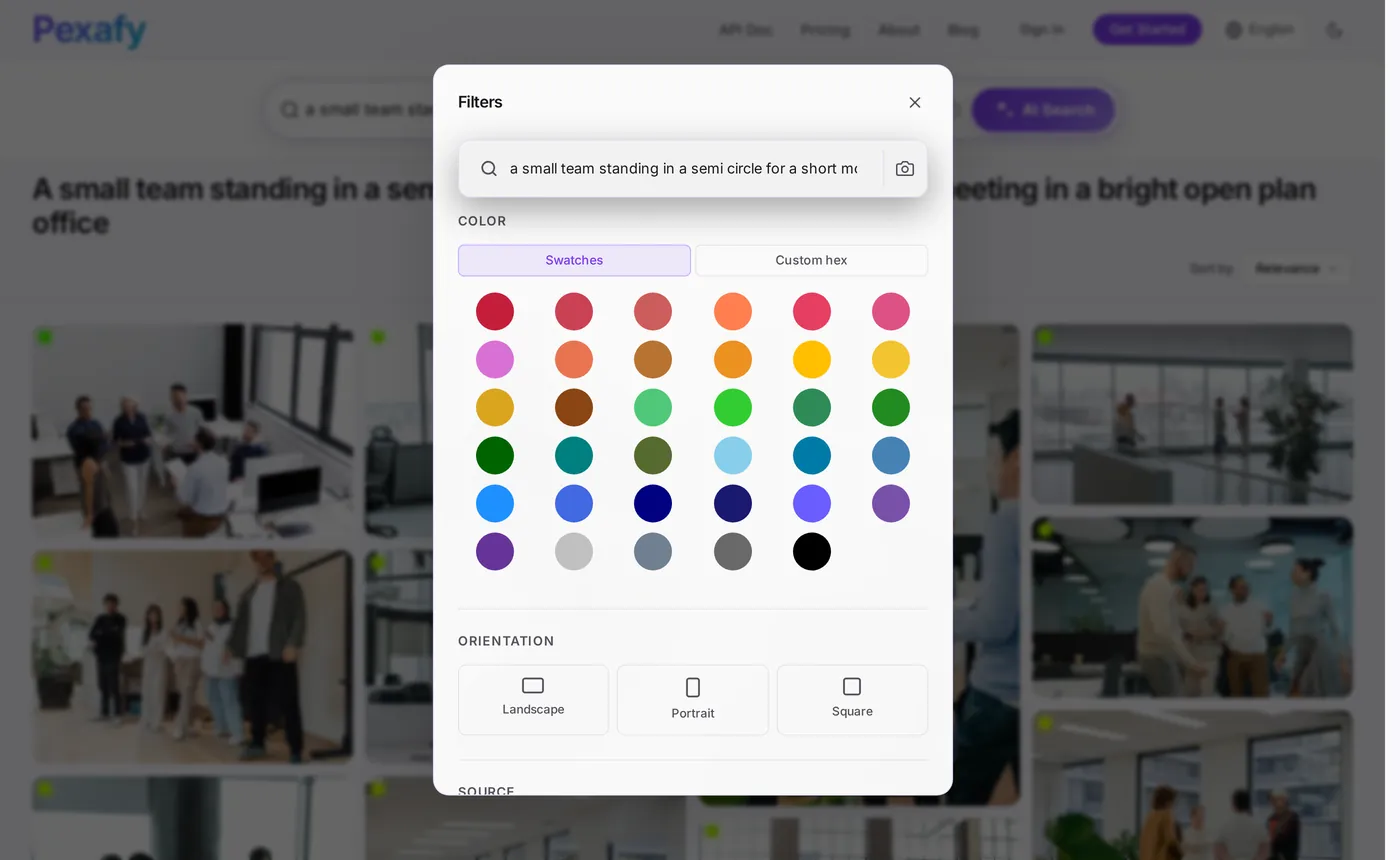
- Schreiben Sie den Satz, nicht das Schlagwort. Subjekt + Handlung + Ort + Licht. Bis zu 500 Zeichen, in einer von über 100 Sprachen.
- Filtern Sie auf Querformat für das Titelbild, und führen Sie die Suche für Bilder im Artikeltext ohne diesen Filter erneut aus — dort wirkt Hochformat oft besser.
- Öffnen Sie das Foto, um die fertige Attributionszeile, die Original-Quellseite und die Datei in voller Auflösung zu erhalten.
- Nutzen Sie „ähnliche Fotos“ zu dem gewählten Bild, um den nächsten Abschnitt im selben visuellen Register zu illustrieren — gleiches Licht, gleiche Bearbeitung, andere Szene.
Der Prompt: einen Entwurf in einen Suchsatz verwandeln
Das ist der Schritt, bei dem alle etwas falsch machen, wenn sie automatisieren. Sie geben den Artikeltitel direkt in das Suchfeld ein, und der Titel ist genau die falsche Eingabe: Er ist abstrakt („The hidden cost of context switching“), und keine Fotografie der Welt bildet ihn ab. Was Sie vom Modell wollen, ist keine Zusammenfassung — es ist ein Kamera-Briefing.
# system prompt
You are a photo editor. Read the article and write ONE search sentence
for a stock-photo engine that ranks by meaning, not by keywords.

Rules:
1. Describe a scene a camera could have taken: someone doing
   something, somewhere. Never name the topic itself ("fintech",
   "productivity", "SEO") — name what would be in the frame.
2. 12 to 25 words. Longer beats shorter: every concrete detail
   (light, place, gesture, time of day) sharpens the match.
3. No text, logos, brands, charts, screenshots or famous people.
   Free photo libraries have almost none of those.
4. No invisible metaphors ("growth", "synergy", "transformation").
5. Match the mood of the article: calm, tense, tired, celebratory.
6. Write the sentence in English even if the article is not.

Return JSON only:
{ "query": "…", "orientation": "landscape", "alt": "…" }
Regel 1 leistet den Großteil der Arbeit. Hier ist dieselbe Regel an drei echten Entwürfen — die mittlere Spalte zeigt, was ein Mensch in Eile eintippt, die rechte Spalte, was der Prompt zurückgibt:
| Der Artikel handelt von … | Die schnelle Anfrage | Das Kamera-Briefing |
|---|---|---|
| Warum Ihr tägliches Stand-up nicht funktioniert | team meeting |
„a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office“ |
| Onboarding von 6 Wochen auf 9 Tage verkürzen | onboarding |
„a new employee on their first day at a desk, listening while a colleague leans in and points at their screen“ |
| Die versteckten Kosten des Kontextwechsels | productivity |
„a tired developer rubbing their eyes in front of two monitors late in the evening, the office empty behind them“ |
team meeting liefert den generischen Konferenzraum-Stock, den alle anderen zu
Ihrem Thema bereits verwenden. Der Satz in der dritten Spalte liefert dies, in
155 Millisekunden:
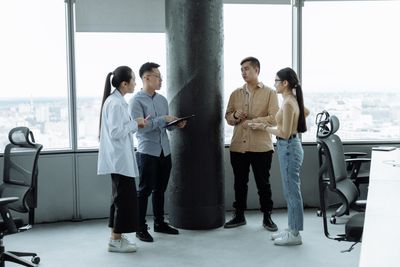

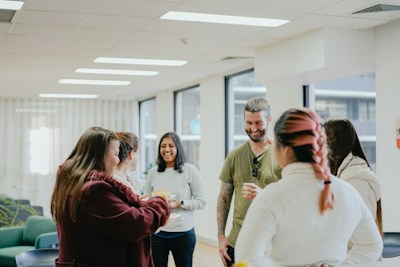
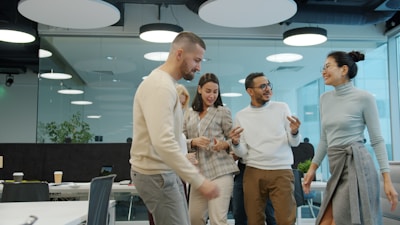
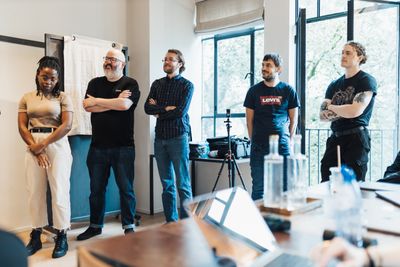
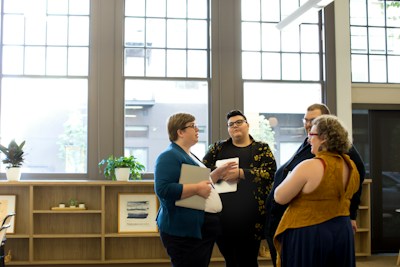
team meeting
nie garantiert.
Die Pipeline: Entwurf hinein, kreditiertes Titelbild heraus
Vierzig Zeilen, zwei Aufrufe: einer an das Modell für das Briefing, einer an Pexafy für das Foto. Setzen Sie es in Ihren CMS-Save-Hook, Ihren Static-Site-Build oder ein Skript, das einen Ordner mit Markdown-Dateien durchläuft.
import json, os, requests
from anthropic import Anthropic

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
llm = Anthropic()  # ANTHROPIC_API_KEY aus der Umgebung

def camera_brief(article: str) -> dict:
    # PHOTO_EDITOR = der obige System-Prompt
    msg = llm.messages.create(
        model="claude-sonnet-5",
        max_tokens=300,
        system=PHOTO_EDITOR,
        messages=[{ "role": "user", "content": article[:12000] }],
    )
    return json.loads(msg.content[0].text)

def illustrate(article: str) -> dict | None:
    brief = camera_brief(article)
    r = requests.get(
        SEARCH,
        headers={"X-Api-Key": os.environ["PEXAFY_API_KEY"]},
        params={
            "q": brief["query"],           # der vollständige Satz
            "orientation": brief["orientation"],
            "per_page": 8,
            "score_threshold": 0.55,      # schwache Treffer verwerfen
        },
        timeout=10,
    )
    hits = r.json()["data"]
    if not hits:                        # Briefing zu eng → erweitern, erneut versuchen
        return None

    top = hits[0]
    return {
        "src":    top["urls"]["regular"],        # 1080px — Titelbild-Größe
        "alt":    brief["alt"] or top["alt_description"],
        "credit": top["attribution"]["html"],   # fertig zum Rendern
        "width":  top["width"],
        "height": top["height"],
        "id":     top["photo_id"],           # speichern: keine Wiederholungen
    }
Drei Details, die aus einer Demo etwas machen, das Sie dauerhaft laufen lassen können:
score_threshold— nichts zurückzugeben ist besser, als ein schlechtes Foto zurückzugeben. War das Briefing zu spezifisch, erweitern Sie es (letzten Nebensatz streichen) und versuchen es einmal erneut.- Speichern Sie die
photo_id— eine Zeile in Ihrer Datenbank, und keine zwei Artikel auf Ihrer Website teilen sich je ein Titelbild. Das ist der Fehler, auf den alle beim dreißigsten Beitrag stoßen. - Eine Anfrage pro Bildplatz — ein Titelbild plus drei Abschnittsbilder sind vier Anfragen pro Artikel, oder eine, wenn Sie vier verschiedene Ergebnisse aus derselben Suche nehmen.
Kein Python? Die gesamte Suchhälfte ist eine Zeile, und jedes Ergebnis trägt dieselben Felder, ganz gleich, aus welcher Bibliothek es stammt:
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a tired developer rubbing their eyes at two monitors" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "per_page=6"

# → { "success": true, "data": [ … ], "meta": { "took_ms": 147 } }
Die Form der Antwort — urls, width,
photographer_full_name, source, license_type,
relevance_score, attribution — ist für ein Pexels-Foto, ein
Pixabay-Foto und ein Unsplash-Foto identisch. Diese Normalisierung ist der Teil, den Sie sonst
selbst schreiben und pflegen müssten; wir haben ihn Feld für Feld auseinandergenommen in
dem Vergleich der kostenlosen Stock-Foto-APIs.
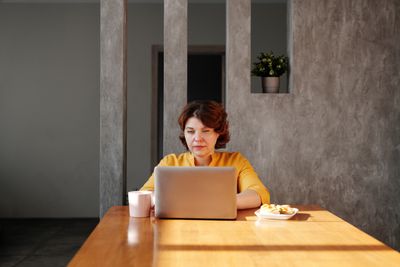
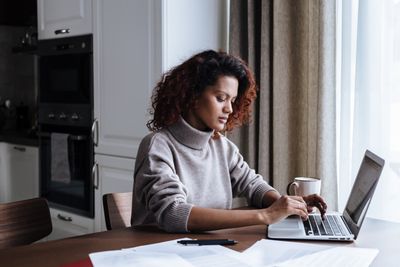
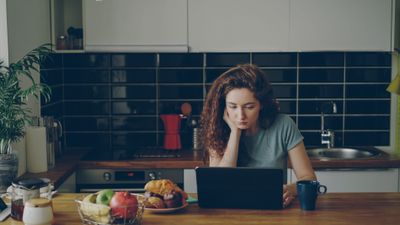
Zweiter Abschnitt, zweites Briefing, zweite Suche — der Punkt dabei: Ein Artikel ergibt mehrere unterschiedliche Szenen statt eines Fotos, das viermal gestreckt wird:
Den Agenten das Bild wählen lassen: MCP
Wenn ein Modell den Entwurf bereits schreibt oder bearbeitet, ist die sauberste Pipeline keine Pipeline: Geben Sie dem Agenten das Such-Tool und lassen Sie ihn illustrieren, was er gerade geschrieben hat, in derselben Unterhaltung, solange er den Kontext noch vor sich hat.
Pexafy betreibt einen gehosteten Model Context Protocol-Server unter
mcp.pexafy.com/mcp. Drei Tools:
search_photos (ein Satz),
search_photos_by_image (ein Referenzbild, optional plus ein Satz — „so etwas, aber
bei Sonnenuntergang“), und get_similar_photos (mehr davon wie das bereits gewählte —
so halten Sie eine Serie kohärent).
Settings → Connectors → Add custom connector
Name: Pexafy
URL:  https://mcp.pexafy.com/mcp
# dann mit Ihrem Pexafy-Konto anmelden, wenn sich das Fenster öffnet
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# oder ins Repo committen, damit das ganze Team davon profitiert — .mcp.json
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
Von da an ist das Illustrieren eines Artikels ein Satz, keine Aufgabe. Der Agent schreibt sein eigenes Kamera-Briefing — er hat den Entwurf gerade gelesen, ist also besser als jeder andere in der Lage, die Szene zu beschreiben:
You  Here's the draft of this week's post. Find a landscape hero
     and one photo for section 2, and give me the credit lines.

Claude  → search_photos(
       q="a small team standing in a semi circle for a short morning
          stand-up meeting in a bright open plan office",
       orientation="landscape")
     ← 16 photos · 155 ms

     Hero    → Photo by Thirdman on Pexels · 6453×4302 · score 0.80
     Section → Photo by Marcus Aurelius on Pexels · 6000×4000
     Both licence-free, attribution lines below, ready to paste.
Unsplash, Pexels, Pixabay und Openverse haben keinen offiziellen MCP-Server — was es gibt, sind von der Community gepflegte Wrapper, die Sie selbst hosten und mit einem Schlüssel versehen müssen. Läuft Ihr redaktioneller Workflow bereits über einen Agenten, ist dieser Unterschied die Integration.
Alt-Text, Lizenz und Ladegeschwindigkeit
Das Bild ist gewählt. Vier Dinge entscheiden, ob es der Seite hilft oder ihr im Stillen schadet:
-
Schreiben Sie den Alt-Text für einen Menschen, nicht für einen Crawler. Jedes
Ergebnis liefert eine
alt_descriptionmit — nutzen Sie sie als Entwurf und schreiben Sie sie dann im Kontext Ihres Absatzes um. „Vier Kolleginnen und Kollegen stehen in einem morgendlichen Meeting“ schlägt einen Schlagwort-Salat, und das ist der Text, den ein Screenreader tatsächlich vorliest. Halten Sie ihn unter ~125 Zeichen; lassen Sie ihn nur leer (alt=""), wenn das Bild rein dekorativ ist. -
Liefern Sie den Credit, auch wenn nichts Sie dazu zwingt. Attribution ist
nach den Pexafy-API-Bedingungen nicht vorgeschrieben, und jedes Ergebnis trägt einen
fertigen
attribution.html-String — aber die Lizenz der ursprünglichen Bibliothek gilt weiterhin für die Nutzung dieses Fotos, und eine sichtbare Credit-Zeile ist das, was einer Leserin (und einer Antwort-Engine) zeigt, dass es sich um eine echte Fotografie mit einem echten Urheber handelt. -
Liefern Sie die richtige Größe aus.
urls.regular(1.080 px) ist ein Titelbild;urls.fullist eine 2.400-px-Datei, die kein Artikel braucht. Geben Sie stetswidth/heightaus der Antwort mit aus, damit der Browser den Platz reserviert — dieses eine Attributpaar macht den Unterschied zwischen einem guten und einem schlechten Layout-Shift-Wert. Verwenden Siefetchpriority="high"beim Titelbild,loading="lazy"bei allem unterhalb der ersten Bildschirmansicht. -
Speisen Sie das Titelbild in Ihre Metadaten ein. Dieselbe URL sollte Ihr
og:image, Ihrtwitter:imageund dieimage-Eigenschaft IhrerArticle-strukturierten Daten sein. Ein Foto, drei Stellen, kein zusätzlicher Aufwand — und eine Social-Vorschau, die nicht mehr auf Ihr Logo zurückfällt.
Was 100 Artikel im Monat tatsächlich kosten
Angenommen ein Titelbild plus drei Bilder im Artikeltext, also vier Suchanfragen pro Beitrag — die bewusst verschwenderische Variante, bei der Sie pro Platz eine eigene Anfrage stellen, statt Ergebnisse aus einer einzigen wiederzuverwenden:
| Volumen | Suchanfragen / Monat | Plan | Suchkosten |
|---|---|---|---|
| 20 Artikel | 80 | Kostenlos — 5.000 Anfragen/Monat | 0 $ |
| 100 Artikel | 400 | Kostenlos — 5.000 Anfragen/Monat | 0 $ |
| 1.000 Artikeleine Agentur, oder ein gesamtes Kunden-Portfolio | 4.000 | Kostenlos — bleibt innerhalb der 5.000 Anfragen/Monat | 0 $ |
Ja — das monatliche Kontingent ist bei Content-Marketing-Volumen kein Thema, und das sagen wir
lieber offen, statt Ihnen einen Grund zum Bezahlen auszudenken. Die Grenze, an die Sie
tatsächlich stoßen werden, ist die pro Minute. Der kostenlose Plan erlaubt 20
API-Anfragen pro Minute; ein Build-Skript, das 100 Artikel in einem Durchgang neu illustriert,
feuert 400 Anfragen so schnell ab, wie es Ihre Schleife zulässt — es verbringt also entweder
zwanzig Minuten gedrosselt oder sammelt 429-Fehler. Zwei Auswege: die Aufrufe
strecken (ein sleep in der Schleife, und ein nächtlicher Job merkt es nie), oder
zu einem Plan wechseln, dessen Rate-Limit zu Ihrem Build passt — Starter liegt bei 30
Anfragen/Minute, Pro bei 60. Wählen Sie nach Burst, nicht nach Volumen.
Der einzige weitere Posten ist ein kurzer Modellaufruf pro Artikel, um das Briefing zu erstellen — ein paar hundert Tokens hinein, dreißig hinaus, was der günstigste Posten in jeder Content-Pipeline sein wird, die Sie betreiben. Vergleichen Sie das mit der Generierung von vier Bildern pro Beitrag, bei vierhundert Bildern im Monat, plus den Versuchen, die es nicht geschafft haben.
Und der Teil, der in keiner Kostentabelle auftaucht: Die Redakteurin öffnet keine fünf Tabs mehr. Das ist die eigentliche Ersparnis.
Quellen & Fußnoten
1 EU AI Act, Artikel 50 — Transparenzpflichten für Anbieter und Einsatzverantwortliche bestimmter KI-Systeme, anwendbar ab dem 2. August 2026. Anbieter von Systemen, die synthetische Audio-, Bild-, Video- oder Textinhalte erzeugen, müssen die Ausgaben in maschinenlesbarer Form kennzeichnen und als künstlich erzeugt erkennbar machen; Einsatzverantwortliche müssen Deepfakes offenlegen sowie, in definierten Fällen, KI-generierte Texte, die zur Information der Öffentlichkeit veröffentlicht werden. Der Digital Omnibus (Verordnung (EU) 2026/1744, in Kraft seit dem 27. Juli 2026) lässt Artikel 50 selbst unverändert, räumt aber Systemen, die bereits vor dem 2. August 2026 auf dem Markt waren, bis zum 2. Dezember 2026 Zeit ein, um die maschinenlesbare Kennzeichnungspflicht aus Artikel 50(2) zu erfüllen. All das bindet KI-Anbieter und Einsatzverantwortliche — es ist keine Regel darüber, welche Bilder ein Blog veröffentlichen darf.
2 Google liest C2PA Content Credentials und das eigene SynthID-Wasserzeichen, um die Herkunft unter Weitere Informationen zu diesem Bild in Search, Images und Lens anzuzeigen. Das ist Medienherkunft, keine Ranking-Strafe für KI-generierte Inhalte.
Quellen geprüft am 15. August 2026: AI Act Artikel 50 · Europäische Kommission — Transparenz-FAQ · Google — Bildmetadaten · Pexafy-API- & MCP-Dokumentation. Suchzeiten und Ergebnisse sind echte Antworten der öffentlichen API, am selben Tag erfasst.
Häufig gestellte Fragen
Sollte ich für Blogartikel KI-generierte Bilder oder echte Fotos verwenden?
Wie finde ich automatisch ein Bild, das zu meinem Artikel passt?
GET /api/v1/search/photos?q=…, rund 150 ms, und jedes Ergebnis kommt mit Größe, Lizenz und einer fertigen Zuschreibungszeile zurück.Was ist der beste Prompt, um einen Artikel in eine Bildsuchanfrage zu verwandeln?
Muss ich die Fotos, die ich in Blogbeiträgen verwende, kennzeichnen?
Kann Claude oder ein anderer KI-Agent die Fotos für meinen Artikel finden?
mcp.pexafy.com/mcp. Fügen Sie ihn als benutzerdefinierten Connector in Claude.ai oder Claude Desktop hinzu und melden Sie sich per OAuth an, oder fügen Sie ihn in Claude Code mit einem einzigen claude mcp add-Befehl und einem API-Schlüssel hinzu. Der Agent sucht dann selbst per Satz, per Referenzbild oder nach ähnlichen Fotos, während er Ihren Entwurf noch im Kontext hat.Wie verhindere ich, dass jeder Artikel auf meinem Blog dasselbe Foto verwendet?
photo_id jedes veröffentlichten Bildes und schließen Sie sie beim nächsten Durchlauf aus — eine einzige Spalte in Ihrem CMS. Das ist der Fehlerfall, in den jede automatisierte Pipeline etwa beim dreißigsten Beitrag läuft, und er bleibt unsichtbar, bis jemand durch Ihren Blog-Index scrollt. Für jeden Abschnitt ein frisches Kamera-Briefing zu schreiben, statt den Artikeltitel wiederzuverwenden, erledigt den Rest.

