公開するすべての記事に写真を入れる方法 — 実写真で、しかも大量に
なぜ制作チームは実写真に回帰しているのか。完成した原稿を、クレジット付きのヒーロー画像へと約150ミリ秒で変換する、プロンプト込みの正確なパイプラインを紹介します。
 Marouane Tijani
10 分で読めます

公開するすべての記事には画像が必要だ。あれば嬉しい程度のものではない ── ヒーロー画像はソーシャルプレビューに表示されるものであり、読者が最初の一文を読む前に目にするものであり、そのページを作ったのが気を配れる人物かどうかを0.5秒で伝えるものだ。それを1記事あたり4枚の画像、四半期に40本の記事という規模に掛け合わせると、「写真を探す」というのはもはやタスクではなく、パイプラインの問題になる。
ここではその解決方法を説明する。生成画像の代わりに何を使うべきか、その理由、そしてPexafyをワークフローに組み込む3つの方法 ── 手作業、API、AIエージェント経由 ── を、完成した下書きを実際に何かを見つけられる検索文に変換するプロンプトも含めて紹介する。
本物の写真が生成画像より優れている理由
イラストを生成するのは簡単で、それこそが問題だ。「AI画像はチートコードだ」と言われていた頃から今日までの間に、4つのことが変わった:
1 · 量が多いほど、検索の方が生成より速い
生成には、プロンプト、待ち時間、確認、そして正直に言えば ── 使える1枚が出るまでにさらに2〜3回の試行が必要になる。セマンティック検索は1回のリクエストで済み、約150 ミリ秒で16件の候補が返ってくる。それぞれすでにライセンス済み、クレジット済み、サイズ調整済みで、レスポンスには寸法まで含まれている。画像1枚ならその差はコーヒー1杯分程度だ。しかし四半期で400枚の画像となれば、それはワークフローと単なる作業の違いになる。
2 · 写真は正確で、生成は「もっともらしい」だけ
記事が現実にあるもの ── 職業、機材、都市、しぐさ、素材 ── について書かれた瞬間、生成画像は雰囲気は正しくても細部が間違ってくる。指が6本ある手は冗談で済む例だが、コストのかかる例としては、実在しない手術器具、架空の操作系を備えたコックピット、あるいはリスボンの人が誰も見覚えのない「リスボンの通り」などがある。その主題を知っている読者は気づく。しかも真っ先に画像に気づく。
3 · 誰もが同じ見た目になっている
拡散モデルはある種のハウススタイルに収束していく。柔らかいグラデーション、過剰な照明、不自然なほど左右対称なイラストの羅列は、今では穴埋めとしか読まれない。その印象こそが実質的なコストだ ── ペナルティではなく、シグナルとして機能する。粒子感のある本物の写真、不格好な椅子、話の途中の人物 ── そうしたものは「取材している」ように読める。
4 · そして今や、生成画像にはラベルが付いてくる
これは論拠というより文脈だが、今後の方向性を示すものだ。2026年8月2日以降、EU AI法第50条により、生成システムの提供者は合成出力に機械可読な形式でマークを付けることが義務付けられ、導入者はディープフェイクを開示することが求められている。1 検出側では、GoogleがC2PAコンテンツクレデンシャルと自社のSynthIDウォーターマークを読み取り、Search、Images、Lens内で「これはAI生成か?」という問いに答える。2 ここにはブログがどの画像を公開すべきかについてのルールはなく、ランキングにコストがかかることもない。変わったのは下流の話だ。記事の冒頭にある画像の来歴は、今や読者があなたに尋ねることなく2クリックで確認できるものになった。ライセンス済みの写真には申告すべきことが何もない。
生成画像が正しい選択となる場合。 コンセプト図や模式図。写真に撮ることができないシーン(まだ存在しない製品、抽象的な仕組み、未来都市)。所有していて全記事で繰り返し使いたい自社イラストスタイル。そして、その画像が証拠としてではなく意図的にイラストとして理解されるべきあらゆる場合。両方を使い分ければいい ── ただ、「会議中の人々の写真が必要」という場合にデフォルトで生成を使うのはやめよう。
量に応じた3つの画像調達方法
同じエンジン、同じカタログ ── 9のライブラリから提供される9M+枚のフリー画像 ── そして3つの入口がある。技術力ではなく、公開する記事の本数で選ぼう。
| 入口 | 最適な相手誰が、どれくらいの量で | 記事1本あたり | 必要なもの |
|---|---|---|---|
| 検索UI | 編集者、1記事ずつ ── 月20本程度まで | 約30秒 | ブラウザ。検索にアカウントは不要。 |
| REST API | CMS、静的サイトビルド、下書きの一括処理 | 約1リクエスト、約150 ms | APIキー。無料で月5,000リクエスト、毎分20回。 |
| MCPサーバー | 下書きを書く、または編集するAIエージェント | 同じ会話の中で完結 | コネクタURL1つ、OAuthまたはキー。 |
この3つは1つのカタログと1つのランキングを共有している。そのため、編集者がUIで見つけた写真は、同じ識別子を持つまったく同じ写真として、あなたのビルドスクリプトにAPIから返ってくる。
記事1本、30秒で完結:検索UI
カメラマンに説明するようにシーンを、完全な一文で、自分の言語で描写しよう。team meetingではなく ── 「明るいオープンプランのオフィスで、短い朝のスタンドアップミーティングのために半円状に立っている小さなチーム」のように。具体的な詳細を1つ加えるごとに結果セットは絞り込まれる。空になるのではない。なぜなら、このエンジンは誰かのタグと単語を照合するのではなく、意味でランク付けするからだ。
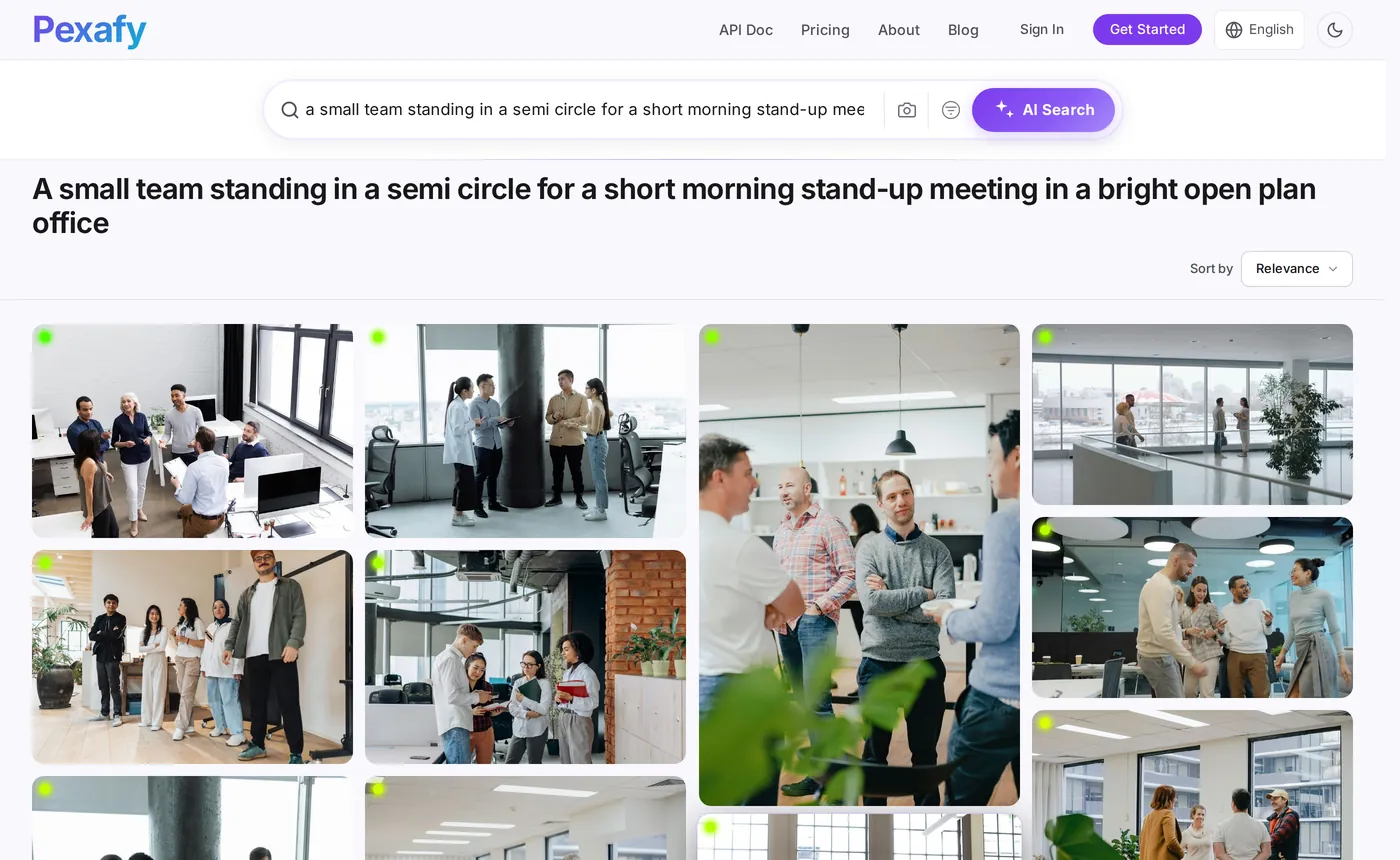
次に、記事レイアウトにとって重要なフィルターだけで絞り込む ── それだけでいい:
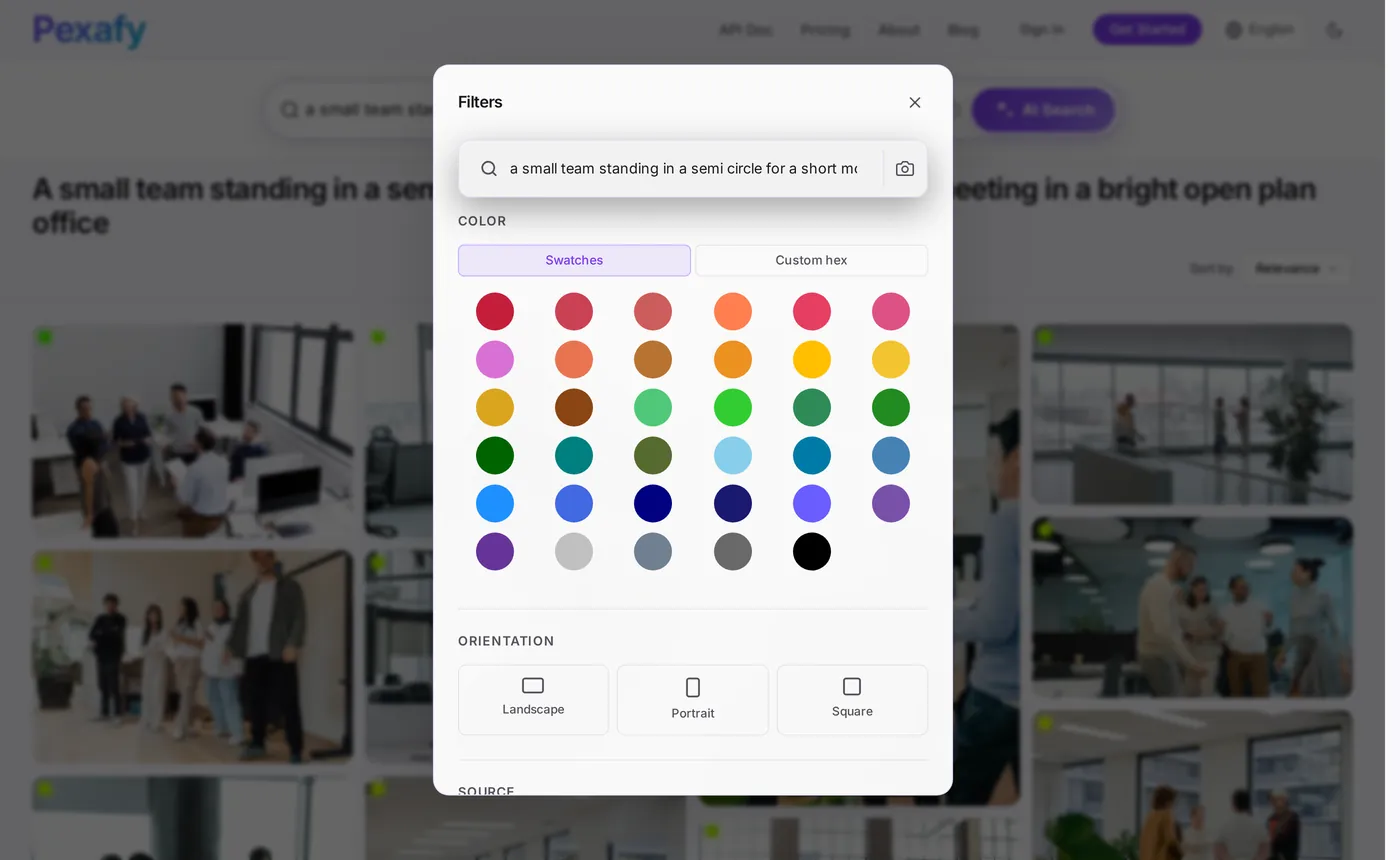
- キーワードではなく文で書く。 主語+動作+場所+光。最大500文字、100以上の言語に対応。
- 横向きにフィルターしてヒーロー画像を選び、その後フィルターなしで再検索して記事内画像を探す ── 記事内では縦向きの方がしっくりくることが多い。
- 写真を開いてすぐ使えるクレジット表記、元のソースページ、フル解像度ファイルを取得する。
- 選んだ写真の「類似写真」を使って、次のセクションを同じ視覚的トーン ── 同じ光、同じ雰囲気、違うシーン ── で描写する。
プロンプト:下書きを検索文に変換する
これは自動化する際に誰もが間違えるステップだ。記事タイトルをそのまま検索ボックスに入れてしまうのだが、タイトルこそまさに不適切な入力だ。抽象的で(「コンテキストスイッチングの隠れたコスト」)、この世のどんな写真もそれを描写していない。モデルに求めるべきは要約ではなく ── 撮影指示書だ。
# system prompt
You are a photo editor. Read the article and write ONE search sentence
for a stock-photo engine that ranks by meaning, not by keywords.

Rules:
1. Describe a scene a camera could have taken: someone doing
   something, somewhere. Never name the topic itself ("fintech",
   "productivity", "SEO") — name what would be in the frame.
2. 12 to 25 words. Longer beats shorter: every concrete detail
   (light, place, gesture, time of day) sharpens the match.
3. No text, logos, brands, charts, screenshots or famous people.
   Free photo libraries have almost none of those.
4. No invisible metaphors ("growth", "synergy", "transformation").
5. Match the mood of the article: calm, tense, tired, celebratory.
6. Write the sentence in English even if the article is not.

Return JSON only:
{ "query": "…", "orientation": "landscape", "alt": "…" }
ルール1がほとんどの仕事をこなしている。同じルールを実際の下書き3本に適用した例を挙げる ── 真ん中の列は急いでいる人間が入力するもの、右の列はこのプロンプトが返すものだ:
| 記事のテーマ… | 急いだ場合のクエリ | 撮影指示書 |
|---|---|---|
| 日次スタンドアップが機能しない理由 | team meeting |
「明るいオープンプランのオフィスで、短い朝のスタンドアップミーティングのために半円状に立っている小さなチーム」 |
| オンボーディングを6週間から9日に短縮する | onboarding |
「初日のデスクにいる新入社員が、同僚が身を乗り出して画面を指しながら話すのを聞いている」 |
| コンテキストスイッチングの隠れたコスト | productivity |
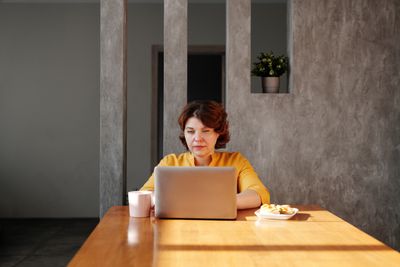
「夜遅く、2台のモニターの前で目をこする疲れた開発者。背後のオフィスは無人」 |
team meetingは、あなたのテーマについて他の全員がすでに使っているような、ありふれた会議室のストック画像を返す。3列目の一文は、155 ミリ秒でこれを返す:
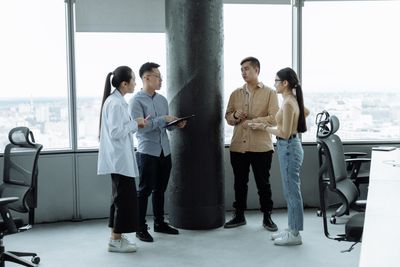

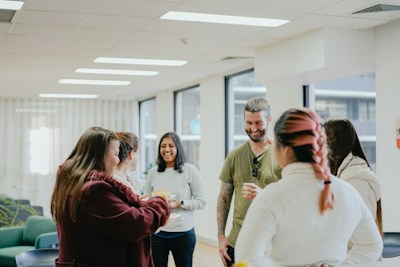
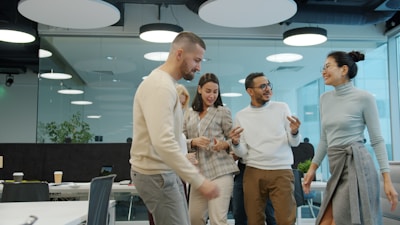
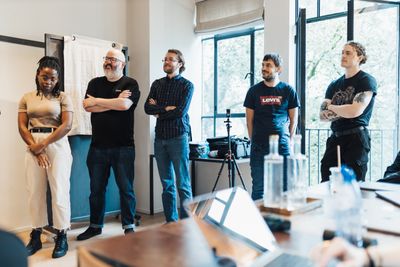
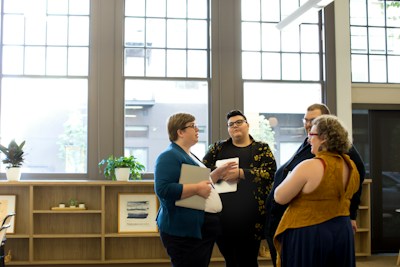
team meetingでは決して保証されないものだ。
パイプライン:下書きを入れると、クレジット付きヒーロー画像が出てくる
40行、2回の呼び出し:1つはモデルへの指示書作成用、もう1つはPexafyへの写真取得用。CMSの保存フック、静的サイトビルド、あるいはMarkdownファイルのフォルダを巡回するスクリプトに組み込もう。
import json, os, requests
from anthropic import Anthropic

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
llm = Anthropic()  # ANTHROPIC_API_KEY from the environment

def camera_brief(article: str) -> dict:
    # PHOTO_EDITOR = the system prompt above
    msg = llm.messages.create(
        model="claude-sonnet-5",
        max_tokens=300,
        system=PHOTO_EDITOR,
        messages=[{ "role": "user", "content": article[:12000] }],
    )
    return json.loads(msg.content[0].text)

def illustrate(article: str) -> dict | None:
    brief = camera_brief(article)
    r = requests.get(
        SEARCH,
        headers={"X-Api-Key": os.environ["PEXAFY_API_KEY"]},
        params={
            "q": brief["query"],           # the full sentence
            "orientation": brief["orientation"],
            "per_page": 8,
            "score_threshold": 0.55,      # drop weak matches
        },
        timeout=10,
    )
    hits = r.json()["data"]
    if not hits:                        # brief too narrow → widen, retry
        return None

    top = hits[0]
    return {
        "src":    top["urls"]["regular"],        # 1080px — hero size
        "alt":    brief["alt"] or top["alt_description"],
        "credit": top["attribution"]["html"],   # ready to render
        "width":  top["width"],
        "height": top["height"],
        "id":     top["photo_id"],           # store it: no repeats
    }
デモを実際に稼働し続けられるものに変える3つの詳細:
score_threshold── 何も返さない方が、悪い写真を返すよりましだ。指示書が具体的すぎた場合は範囲を広げ(最後の節を削り)、もう一度試そう。photo_idを保存する ── データベースに1行加えるだけで、サイト内のどの2記事も同じヒーロー画像を共有することがなくなる。これは誰もが30本目の記事で必ずぶつかる失敗だ。- 画像枠1つにつきリクエスト1回 ── ヒーロー画像+セクション画像3枚なら記事1本あたり4リクエスト。同じ検索から異なる4件の結果を使えば1リクエストで済む。
Pythonを使わない場合、検索部分だけならたった1行で済み、どのライブラリの結果でも同じフィールドが返ってくる:
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a tired developer rubbing their eyes at two monitors" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "per_page=6"

# → { "success": true, "data": [ … ], "meta": { "took_ms": 147 } }
レスポンスの形 ── urls、width、photographer_full_name、source、license_type、relevance_score、attribution ── はPexelsの写真、Pixabayの写真、Unsplashの写真いずれでも同一だ。その正規化こそ、本来なら自分で書いて保守しなければならない部分であり、
フリーストックフォトAPI比較記事でフィールドごとに分解して解説している。
2つ目のセクション、2つ目の指示書、2つ目の検索 ── 要は、1本の記事が同じ写真を4回引き伸ばすのではなく、それぞれ異なる複数のシーンを生み出すということだ:
エージェントに写真を選ばせる:MCP
モデルがすでに下書きを書いている、あるいは編集しているなら、最もクリーンなパイプラインは「パイプラインを持たないこと」だ。検索ツールをエージェントに渡し、同じ会話の中で、まだコンテキストを保持したまま、自分が書いたばかりの内容にイラストを付けさせればいい。
Pexafyはmcp.pexafy.com/mcpにホスト型のModel Context Protocolサーバーを稼働させている。ツールは3つ:
search_photos(一文で検索)、
search_photos_by_image(参照画像、任意で文も併用 ── 「これに似た感じで、でも夕暮れ時」)、
そしてget_similar_photos(すでに選んだ写真にもっと似たものを探す。これがシリーズの一貫性を保つ方法だ)。
Settings → Connectors → Add custom connector
Name: Pexafy
URL:  https://mcp.pexafy.com/mcp
# then sign in with your Pexafy account when the window opens
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# or commit it to the repo, so the whole team gets it — .mcp.json
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
ここまで来れば、記事にイラストを付けるのはタスクではなく一文で済む。エージェントは自分自身で撮影指示書を書く ── 下書きを読んだばかりなので、誰よりもそのシーンを描写するのに適した立場にある:
You  Here's the draft of this week's post. Find a landscape hero
     and one photo for section 2, and give me the credit lines.

Claude  → search_photos(
       q="a small team standing in a semi circle for a short morning
          stand-up meeting in a bright open plan office",
       orientation="landscape")
     ← 16 photos · 155 ms

     Hero    → Photo by Thirdman on Pexels · 6453×4302 · score 0.80
     Section → Photo by Marcus Aurelius on Pexels · 6000×4000
     Both licence-free, attribution lines below, ready to paste.
Unsplash、Pexels、Pixabay、Openverseには公式のMCPサーバーがない ── 存在するのは、自分でホストしキーを管理するコミュニティ製のラッパーだけだ。あなたの編集ワークフローがすでにエージェント経由で動いているなら、その違いこそが統合の意味を持つ。
Alt テキスト、ライセンス、ページ速度
写真は選ばれた。その画像がページに役立つか、それとも静かにページを傷つけるかを決める要素は4つある:
-
Altテキストはクローラーではなく人のために書く。 すべての結果に
alt_descriptionが付いている ── それを下書きとして使い、あなたの段落の文脈に合わせて書き直そう。「朝の会議で立つ4人の同僚」の方が、キーワードの羅列よりも優れているし、スクリーンリーダーが実際に読み上げるのはそのテキストだ。長さは約125文字以内に収め、画像が純粋に装飾目的の場合のみalt=""として空にする。 -
強制されなくてもクレジットを表示する。 Pexafy APIの利用規約でクレジット表記は必須ではなく、すべての結果にはすぐ使える
attribution.html文字列が付いている ── だが、元のライブラリに付随するライセンスは依然としてその写真の利用を規定しているし、目に見えるクレジット表記こそが、これが実在の作者による本物の写真であることを読者(そして回答エンジン)に伝える。 -
適切なサイズを配信する。
urls.regular(1080 px)はヒーロー画像用、urls.fullはどの記事にも必要のない2400 pxのファイルだ。ブラウザがスペースを確保できるよう、レスポンスから常にwidth/heightを出力しよう ── その属性のペアだけで、レイアウトシフトスコアの良し悪しが決まる。ヒーロー画像にはfetchpriority="high"を、フォールド以下のすべての画像にはloading="lazy"を使おう。 -
ヒーロー画像をメタデータにも使う。 同じURLを
og:image、twitter:image、そしてArticle構造化データのimageプロパティに使うべきだ。1枚の写真、3か所、追加作業ゼロ ── そしてロゴにフォールバックすることのないソーシャルプレビューが手に入る。
月100本の記事の実際のコスト
ヒーロー画像+記事内画像3枚、つまり1記事あたり4回の検索リクエストと仮定する ── これは意図的に無駄の多いバージョンで、1つの検索結果を使い回すのではなく、画像枠ごとに個別のクエリを実行する場合だ:
| 本数 | 検索リクエスト数/月 | プラン | 検索コスト |
|---|---|---|---|
| 20記事 | 80 | 無料 ── 月5,000リクエスト | $0 |
| 100記事 | 400 | 無料 ── 月5,000リクエスト | $0 |
| 1,000記事代理店、またはクライアント全体のポートフォリオ | 4,000 | 無料 ── 月5,000リクエストの範囲内 | $0 |
そう ── 月間の割当量は、コンテンツマーケティングの規模ではまったく問題にならない。無理に有料化する理由をでっち上げるより、そう言い切ってしまう方がいい。実際にぶつかることになる制限は、毎分あたりのものだ。 無料プランではAPIリクエストは毎分20回まで許可されている。100記事を一度に処理し直すビルドスクリプトは、ループが許す限りの速さで400リクエストを発行するため、20分間スロットリングされ続けるか、429を集め始めることになる。抜け出す方法は2つ:呼び出しの間隔をあける(ループにsleepを1つ入れれば、夜間ジョブなら気づきさえしない)か、あるいはビルドのペースに合ったレート制限のプランに移行する ── Starterは毎分30リクエスト、Proは毎分60リクエストだ。選ぶ基準は瞬間的な集中度であって、総量ではない。
もう1つのコストは、記事ごとに指示書を生成する短いモデル呼び出し1回だけだ ── 入力数百トークン、出力30トークン程度で、あなたが持つどんなコンテンツパイプラインにおいても最も安価な項目になるだろう。これを、1記事あたり4枚、月400枚もの画像を生成するコストと、採用に至らなかった試行分と比較してみてほしい。
そしてコスト表には表れない部分 ── 編集者がタブを5つ開かなくなる。それこそが実質的な節約だ。
参考文献と注釈
1 EU AI法第50条 ── 特定のAIシステムの提供者および導入者に対する透明性義務。2026年8月2日から適用される。合成音声、画像、動画、テキストを生成するシステムの提供者は、出力に機械可読な形式でマークを付け、人工的に生成されたものとして検出可能にしなければならない。導入者はディープフェイクを開示しなければならず、また一定のケースでは、公衆に情報提供する目的で公開されるAI生成テキストについても開示義務がある。デジタル・オムニバス(規則(EU) 2026/1744、2026年7月27日発効)は第50条自体には変更を加えていないが、2026年8月2日より前にすでに市場に出ているシステムに対しては、第50条(2)項の機械可読マーキング要件を満たすまでの猶予を2026年12月2日まで与えている。これらはすべてAIの提供者と導入者を拘束するものであり、ブログがどの画像を公開すべきかについてのルールではない。
2 GoogleはC2PAコンテンツクレデンシャルと自社のSynthIDウォーターマークを読み取り、Search、Images、Lens全体にわたって「この画像について」に来歴情報を表示する。これはメディアの来歴に関するものであり、AI生成コンテンツに対するランキングペナルティではない。
出典確認日 2026年8月15日: AI法第50条 · 欧州委員会 ── 透明性に関するFAQ · Google ── 画像メタデータ · Pexafy API & MCPドキュメント。 検索の応答時間と結果は、同日に取得した公開APIの実際のレスポンスである。
よくある質問
ブログ記事にはAI生成画像と実写真、どちらを使うべきですか?
記事に合う画像を自動的に見つけるにはどうすればよいですか?
GET /api/v1/search/photos?q=…で、おおよそ150 msで応答し、すべての結果にサイズ、ライセンス、そしてすぐに使える帰属表示文字列が付いてきます。記事を画像検索クエリに変換する最適なプロンプトは何ですか?
ブログ記事で使用する写真にはクレジット表記が必要ですか?
ClaudeなどのAIエージェントに記事用の写真を探させることはできますか?
mcp.pexafy.com/mcpにあるPexafyのホスト型MCP(Model Context Protocol)サーバーを通じて可能です。Claude.aiまたはClaude Desktopでカスタムコネクタとして追加し、OAuthでサインインするか、Claude Codeにclaude mcp addコマンド1つとAPIキーで追加できます。エージェントは原稿をまだコンテキストに保持したまま、文章による検索、参照画像による検索、あるいは類似写真の検索を自ら行います。ブログ内のすべての記事で同じ写真が使われてしまうのを防ぐにはどうすればよいですか?
photo_idを保存しておき、次回の実行時にそれらを除外します — CMSに列を1つ追加するだけです。これは自動化パイプラインが記事30本目あたりで必ずぶつかる典型的な失敗パターンであり、誰かがブログの一覧ページをスクロールするまで気づかれません。セクションごとに、記事タイトルを使い回すのではなく新しいカメラブリーフを作成することが、残りの対策になります。

