모든 발행 기사에 실제 사진을 대규모로 삽입하는 방법
퍼블리싱 팀들이 다시 실제 사진으로 돌아가는 이유, 그리고 완성된 초안을 약 150밀리초 만에 출처가 명시된 히어로 이미지로 바꿔주는 정확한 파이프라인 — 프롬프트 포함.
 Marouane Tijani
10 분 분량

발행하는 기사마다 사진이 필요합니다. 있으면 좋은 정도가 아닙니다 — 대표 이미지는 소셜 미리보기에 노출되는 화면이자, 독자가 첫 문장을 읽기도 전에 보는 것이며, 이 페이지를 신경 써서 만든 사람이 있는지를 0.5초 만에 알려줍니다. 게시물마다 이미지 네 장, 분기마다 게시물 40편을 곱하면 “사진 찾기”는 단순 작업이 아니라 파이프라인 문제가 됩니다.
다음은 우리가 이 문제를 해결하는 방식입니다: 생성된 이미지 대신 무엇을 써야 하는지와 그 이유, 그리고 Pexafy를 워크플로에 연결하는 세 가지 방법 — 수작업, API, AI 에이전트 — 을 다루며, 완성된 초안을 실제로 결과를 찾아내는 검색 문장으로 바꿔주는 프롬프트도 포함합니다.
실제 사진이 여전히 생성 이미지보다 나은 이유
삽화를 생성하는 일은 쉽고, 바로 그것이 문제입니다. “AI 이미지는 편법이다”라는 시절과 지금 사이에 네 가지가 달라졌습니다:
1 · 대량으로 다룰 때는 생성보다 검색이 빠릅니다
생성은 프롬프트 하나, 대기, 검토, 그리고 — 솔직히 말해 — 쓸 만한 결과가 나올 때까지 두세 번 더 시도하는 과정입니다. 시맨틱 검색은 단 한 번의 요청으로 약 150 밀리초 만에 후보 16개를 돌려주며, 각각 이미 라이선스가 있고, 출처 표기가 되어 있고, 크기가 정해져 있으며, 응답에 치수까지 포함되어 있습니다. 이미지 하나만 놓고 보면 차이는 커피 한 잔 정도입니다. 분기당 이미지 400장을 놓고 보면 워크플로와 업무 자체의 차이가 됩니다.
2 · 사진은 정확하고, 생성 이미지는 그럴듯할 뿐입니다
기사가 실제 대상 — 직업, 장비, 도시, 몸짓, 소재 — 을 다루는 순간, 생성 이미지는 분위기는 맞지만 디테일은 틀리기 시작합니다. 손가락이 여섯 개인 손은 우스갯소리에 불과하고, 정말 문제가 되는 것은 실재하지 않는 수술 도구, 조작 장치가 지어낸 조종석, 리스본 사람이 보면 알아보지 못할 “리스본 거리” 같은 것입니다. 주제를 잘 아는 독자는 이를 알아차리고, 그것도 사진에서 가장 먼저 알아챕니다.
3 · 모두가 같은 스타일을 갖게 됩니다
디퓨전 모델은 하나의 하우스 스타일로 수렴하고, 부드러운 그라데이션에 과하게 밝고 묘하게 대칭적인 삽화들이 줄지어 늘어서면 이제는 땜빵용으로 읽힙니다. 이러한 인식이야말로 실제 비용입니다 — 벌점이 아니라 신호입니다. 실제 사진 — 그레인, 어색한 의자, 말하는 도중의 사람 — 은 보도 사진처럼 읽힙니다.
4 · 그리고 이제는 라벨이 붙어서 옵니다
이 항목은 논거라기보다 맥락이지만, 흐름의 방향을 보여줍니다. 2026년 8월 2일부터 EU AI법 제50조는 생성형 시스템 제공자에게 합성 결과물을 기계 판독 가능한 형식으로 표시하도록 요구하며, 배포자에게는 딥페이크를 고지하도록 요구합니다.1 감지 쪽에서는 Google이 C2PA Content Credentials와 자체 SynthID 워터마크를 읽어 Search, Images, Lens 안에서 “이것이 AI로 생성된 이미지인가?”라는 질문에 답합니다.2 이 중 어느 것도 블로그가 어떤 이미지를 게시할 수 있는지에 대한 규칙이 아니며, 순위에 비용을 초래하지도 않습니다. 달라진 것은 그 이후 단계입니다: 여러분 기사 상단 사진의 출처가 이제는 독자가 여러분에게 묻지 않고도 클릭 두 번으로 확인할 수 있는 것이 되었다는 점입니다. 라이선스가 있는 사진은 따로 밝힐 것이 없습니다.
생성 이미지가 정답인 경우. 개념도와 도해. 사진으로 찍을 수 없는 장면(아직 존재하지 않는 제품, 추상적인 메커니즘, 미래 도시). 여러분이 소유하고 있어 모든 게시물에 반복해서 쓰고 싶은 하우스 삽화 스타일. 그리고 사진이 증거가 아니라 의도적으로 삽화로 이해되어야 하는 모든 경우. 둘 다 사용하되, “회의 중인 사람들의 사진이 필요하다”는 경우의 기본값을 생성으로 두는 것만은 멈추십시오.
발행량에 따른 세 가지 삽화 방식
같은 엔진, 같은 카탈로그 — 9개 라이브러리에서 가져온 무료 이용 가능 사진 9M+장 — 그리고 세 가지 진입점. 기술 숙련도가 아니라 발행하는 기사 수를 기준으로 고르십시오.
| 진입점 | 적합한 대상누구에게, 어느 정도 규모에 | 기사당 | 필요한 것 |
|---|---|---|---|
| 검색 UI | 편집자, 게시물 한 편씩 — 월 약 20편까지 | 약 30초 | 브라우저 한 대. 검색에는 계정이 필요 없습니다. |
| REST API | CMS, 정적 사이트 빌드, 초안 일괄 처리 | 약 1회 요청, 약 150 ms | API 키. 월 5,000회 요청 무료, 분당 20회. |
| MCP 서버 | 초안을 작성하거나 편집하는 AI 에이전트 | 같은 대화 안에서 | 커넥터 URL 하나, OAuth 또는 키. |
이 세 가지는 하나의 카탈로그와 하나의 랭킹을 공유하므로, 편집자가 UI에서 찾은 사진은 빌드 스크립트에서 API가 반환하는 사진과 동일한 식별자를 가진 동일한 사진입니다.
기사 한 편, 30초: 검색 UI
사진작가에게 설명하듯 완전한 문장으로, 여러분의 언어로 장면을 묘사하십시오. team meeting이 아니라
“밝고 개방적인 사무실에서 짧은 아침 스탠드업 미팅을 위해 반원으로 서 있는 소규모 팀”과 같은 식입니다. 구체적인 세부사항을 하나씩 추가할 때마다 결과 집합이 비어버리는 것이 아니라 좁혀지는데, 엔진이 여러분의 단어를 누군가의 태그와 매칭하는 것이 아니라 의미를 기준으로 순위를 매기기 때문입니다.
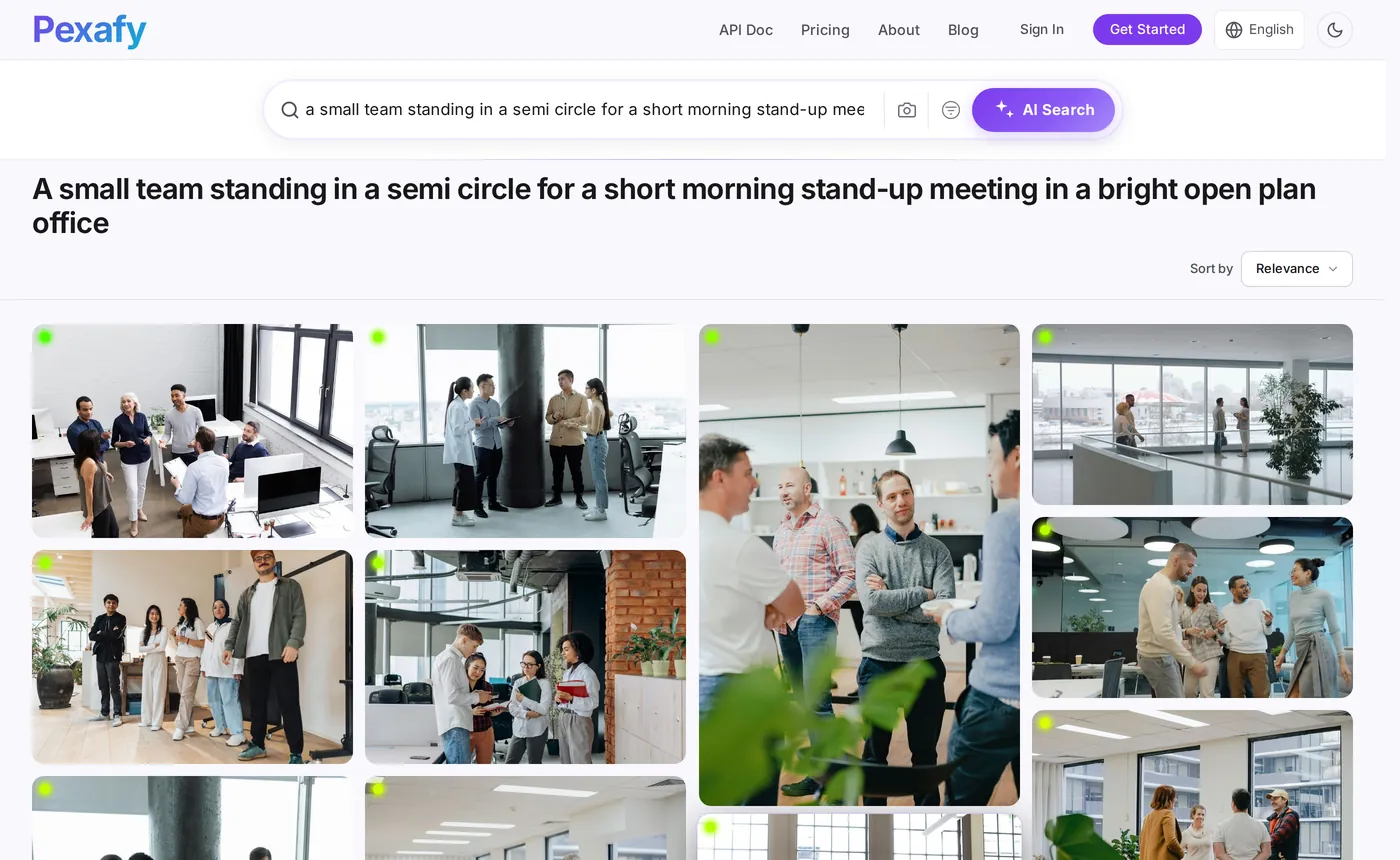
그런 다음 기사 레이아웃에 중요한 필터로만 좁히십시오 — 그것들만으로 충분합니다:
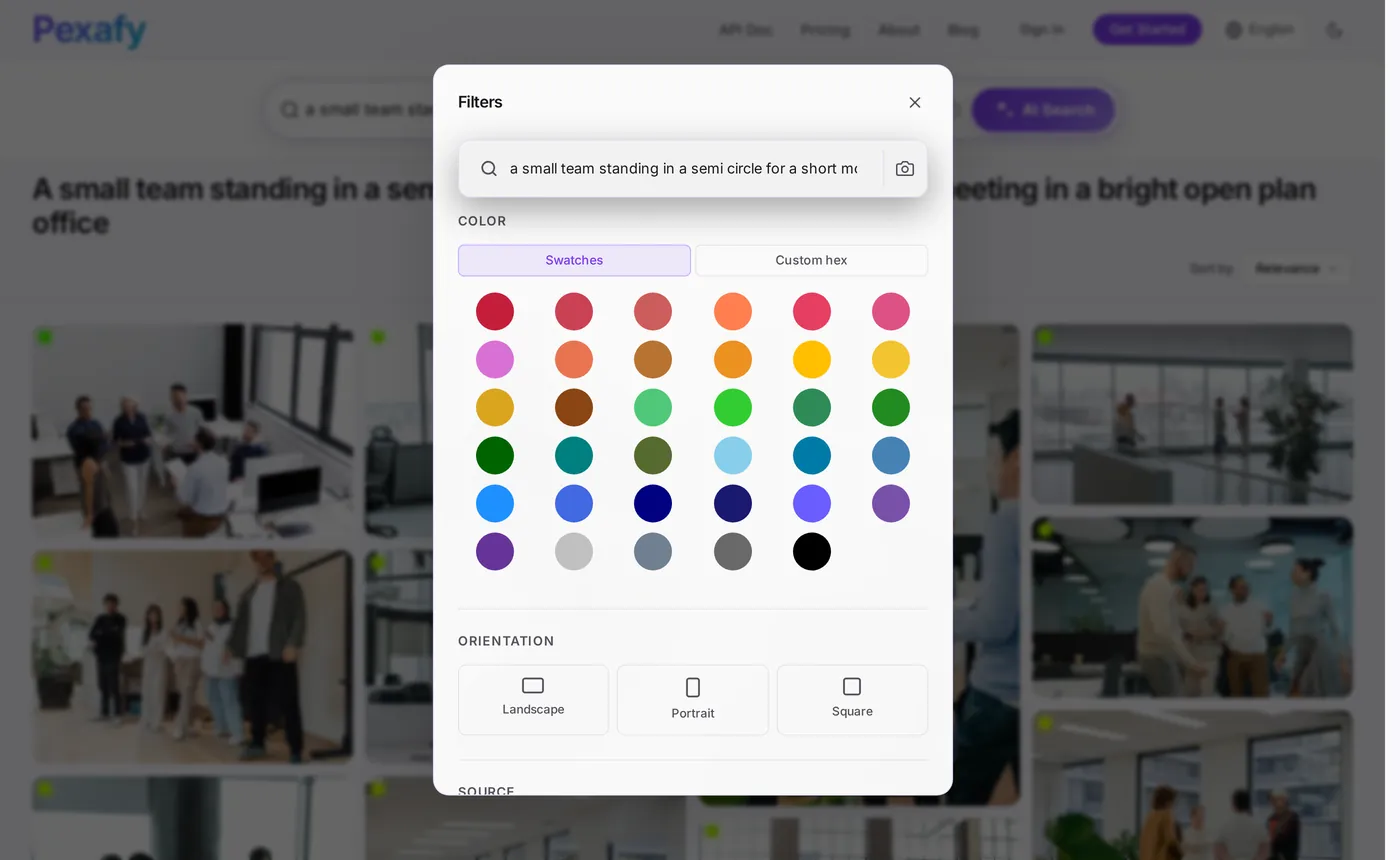
- 키워드가 아니라 문장을 쓰십시오. 주어 + 행동 + 장소 + 빛. 최대 500자, 100개 이상 언어 중 어느 것이든 가능합니다.
- 대표 이미지에는 가로 방향으로 필터링한 다음, 세로 사진이 더 잘 어울리는 경우가 많은 기사 내 이미지를 위해 필터 없이 다시 실행하십시오.
- 사진을 열어 완성된 출처 표기 문구, 원본 출처 페이지, 전체 해상도 파일을 확보하십시오.
- 선택한 사진에서 “유사한 사진”을 사용해, 다음 절을 같은 시각적 톤 — 같은 빛, 같은 처리 방식, 다른 장면 — 으로 꾸미십시오.
프롬프트: 초안을 검색 문장으로 바꾸기
이것이 자동화를 시도할 때 다들 틀리는 단계입니다. 기사 제목을 그대로 검색창에 넣는데, 제목이야말로 정확히 잘못된 입력값입니다: 제목은 추상적이고(“컨텍스트 전환의 숨겨진 비용”) 이 세상 어떤 사진도 그것을 묘사하지 않습니다. 모델에게서 필요한 것은 요약이 아니라 촬영 지시서(카메라 브리프)입니다.
# system prompt
You are a photo editor. Read the article and write ONE search sentence
for a stock-photo engine that ranks by meaning, not by keywords.

Rules:
1. Describe a scene a camera could have taken: someone doing
   something, somewhere. Never name the topic itself ("fintech",
   "productivity", "SEO") — name what would be in the frame.
2. 12 to 25 words. Longer beats shorter: every concrete detail
   (light, place, gesture, time of day) sharpens the match.
3. No text, logos, brands, charts, screenshots or famous people.
   Free photo libraries have almost none of those.
4. No invisible metaphors ("growth", "synergy", "transformation").
5. Match the mood of the article: calm, tense, tired, celebratory.
6. Write the sentence in English even if the article is not.

Return JSON only:
{ "query": "…", "orientation": "landscape", "alt": "…" }
규칙 1이 대부분의 역할을 합니다. 실제 초안 세 편에 같은 규칙을 적용해보면 이렇습니다 — 가운데 열은 사람이 급하게 입력할 법한 검색어이고, 오른쪽 열은 프롬프트가 반환한 결과입니다:
| 기사 주제… | 서두른 검색어 | 촬영 지시서 |
|---|---|---|
| 일일 스탠드업 미팅이 왜 잘 안 되는가 | team meeting |
“밝고 개방적인 사무실에서 짧은 아침 스탠드업 미팅을 위해 반원으로 서 있는 소규모 팀” |
| 온보딩 기간을 6주에서 9일로 줄이기 | onboarding |
“첫 출근일에 책상에 앉아 있는 신입 직원이 옆에서 몸을 기울여 화면을 가리키는 동료의 말을 듣고 있는 모습” |
| 컨텍스트 전환의 숨겨진 비용 | productivity |
“늦은 저녁, 텅 빈 사무실을 뒤로하고 모니터 두 대 앞에서 눈을 비비는 지친 개발자” |
team meeting은 같은 주제를 다루는 다른 모든 사람이 이미 쓰고 있는 흔한 회의실 스톡 사진을 돌려줍니다. 세 번째 열의 문장은 155 밀리초 만에 다음 결과를 돌려줍니다:
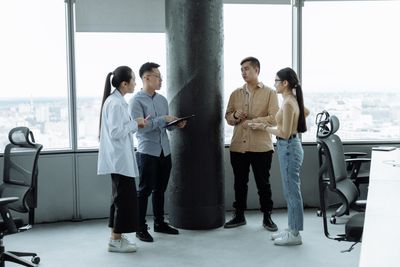

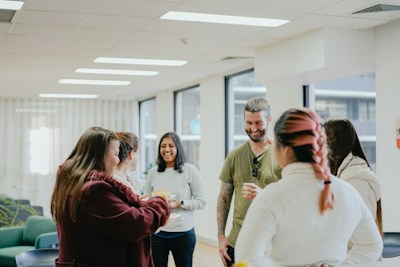
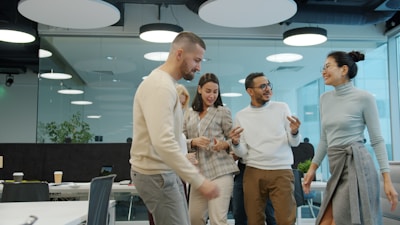
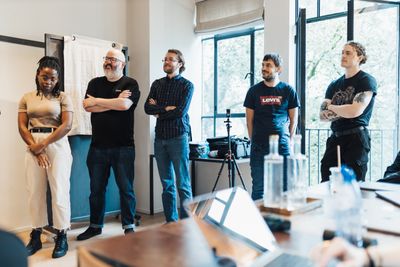
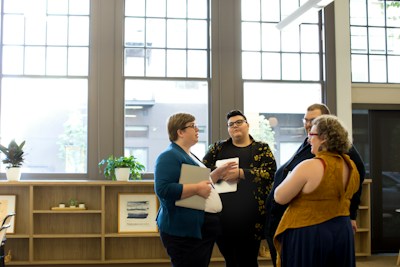
team meeting은 결코 보장해주지 않는 부분입니다.
파이프라인: 초안을 넣으면 출처 표기가 된 대표 이미지가 나온다
40줄, 호출 2회: 하나는 모델에 브리프를 요청하는 호출, 하나는 Pexafy에 사진을 요청하는 호출입니다. CMS의 저장 훅, 정적 사이트 빌드, 혹은 Markdown 파일 폴더를 순회하는 스크립트에 넣으면 됩니다.
import json, os, requests
from anthropic import Anthropic

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
llm = Anthropic()  # 환경 변수의 ANTHROPIC_API_KEY 사용

def camera_brief(article: str) -> dict:
    # PHOTO_EDITOR = 위에 나온 시스템 프롬프트
    msg = llm.messages.create(
        model="claude-sonnet-5",
        max_tokens=300,
        system=PHOTO_EDITOR,
        messages=[{ "role": "user", "content": article[:12000] }],
    )
    return json.loads(msg.content[0].text)

def illustrate(article: str) -> dict | None:
    brief = camera_brief(article)
    r = requests.get(
        SEARCH,
        headers={"X-Api-Key": os.environ["PEXAFY_API_KEY"]},
        params={
            "q": brief["query"],           # 문장 전체
            "orientation": brief["orientation"],
            "per_page": 8,
            "score_threshold": 0.55,      # 약한 매칭은 제외
        },
        timeout=10,
    )
    hits = r.json()["data"]
    if not hits:                        # 브리프가 너무 좁음 → 넓혀서 재시도
        return None

    top = hits[0]
    return {
        "src":    top["urls"]["regular"],        # 1080px — 대표 이미지 크기
        "alt":    brief["alt"] or top["alt_description"],
        "credit": top["attribution"]["html"],   # 바로 렌더링 가능
        "width":  top["width"],
        "height": top["height"],
        "id":     top["photo_id"],           # 저장해 둘 것: 중복 방지
    }
데모를 계속 돌릴 수 있는 것으로 바꿔주는 세 가지 세부사항:
score_threshold— 아무것도 반환하지 않는 편이 나쁜 사진을 반환하는 것보다 낫습니다. 브리프가 너무 구체적이었다면 (마지막 절을 빼고) 넓힌 뒤 한 번 다시 시도하십시오.photo_id를 저장하십시오 — 데이터베이스에 한 줄만 추가하면, 사이트의 어떤 두 기사도 대표 이미지를 공유하지 않게 됩니다. 이것이 게시물 30번째쯤에 누구나 겪는 실패 사례입니다.- 이미지 슬롯당 요청 하나 — 대표 이미지 하나에 절 이미지 세 개면 기사당 요청 4회이거나, 같은 검색에서 서로 다른 결과 4개를 가져오면 요청 1회로 끝납니다.
Python이 없다면? 검색 절반 전체가 한 줄이며, 결과는 출처 라이브러리와 무관하게 항상 같은 필드를 담고 있습니다:
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a tired developer rubbing their eyes at two monitors" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "per_page=6"

# → { "success": true, "data": [ … ], "meta": { "took_ms": 147 } }
응답 형태 — urls, width, photographer_full_name,
source, license_type, relevance_score,
attribution — 는 Pexels 사진, Pixabay 사진, Unsplash 사진 모두에 대해 동일합니다. 이 정규화 작업이야말로 여러분이 직접 작성하고 유지보수해야 했을 부분인데, 이를 필드 단위로 하나씩 뜯어본 내용은
무료 스톡 사진 API 비교에서 다뤘습니다.
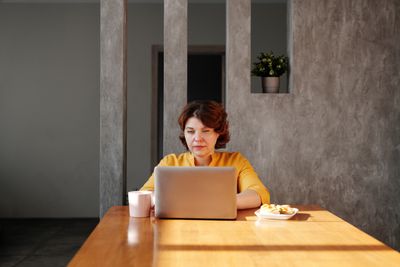
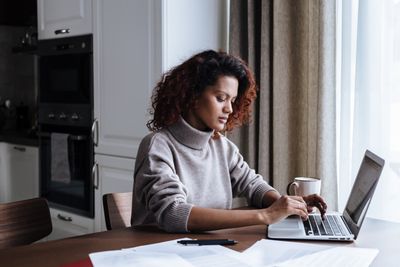
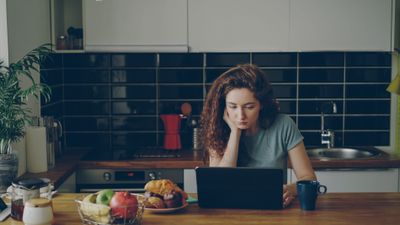
두 번째 절, 두 번째 브리프, 두 번째 검색 — 요점은 기사 한 편에서 사진 한 장을 네 번 늘려 쓰는 대신 여러 개의 서로 다른 장면이 나온다는 것입니다:
에이전트가 사진을 고르게 하기: MCP
모델이 이미 초안을 작성하거나 편집하고 있다면, 가장 깔끔한 파이프라인은 파이프라인이 없는 것입니다: 에이전트에게 검색 도구를 주고, 방금 작성한 내용을 여전히 맥락을 유지한 채 같은 대화 안에서 직접 삽화로 꾸미게 하십시오.
Pexafy는 mcp.pexafy.com/mcp에서 호스팅되는 Model Context Protocol 서버를 운영합니다. 도구 세 가지:
search_photos(문장 하나),
search_photos_by_image(참조 이미지, 선택적으로 문장 추가 — “이것과 비슷하지만 노을 질 때”),
get_similar_photos(이미 선택한 사진과 더 비슷한 것, 시리즈의 일관성을 유지하는 방법입니다).
Settings → Connectors → Add custom connector
Name: Pexafy
URL:  https://mcp.pexafy.com/mcp
# 이후 창이 열리면 Pexafy 계정으로 로그인
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# 또는 저장소에 커밋하여 팀 전체가 사용하도록 — .mcp.json
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
이렇게 설정하면 기사에 삽화를 넣는 일은 작업이 아니라 문장 하나입니다. 에이전트는 자기만의 촬영 지시서를 작성하는데 — 방금 초안을 읽었으니 그 장면을 묘사하기에 누구보다 유리한 위치에 있습니다:
You  이번 주 게시물 초안이야. 가로형 대표 이미지 하나와
     2번째 절에 쓸 사진 하나를 찾아주고, 출처 표기 문구도 줘.

Claude  → search_photos(
       q="a small team standing in a semi circle for a short morning
          stand-up meeting in a bright open plan office",
       orientation="landscape")
     ← 사진 16장 · 155 ms

     대표 이미지 → Photo by Thirdman on Pexels · 6453×4302 · 점수 0.80
     절 이미지  → Photo by Marcus Aurelius on Pexels · 6000×4000
     둘 다 라이선스 프리, 출처 표기 문구는 아래에, 바로 붙여넣을 수 있습니다.
Unsplash, Pexels, Pixabay, Openverse에는 공식 MCP 서버가 없습니다 — 존재하는 것은 여러분이 직접 호스팅하고 키를 관리해야 하는 커뮤니티 래퍼뿐입니다. 편집 워크플로가 이미 에이전트를 거쳐 돌아간다면, 그 차이야말로 통합 그 자체입니다.
Alt 텍스트, 라이선스, 페이지 속도
사진은 골랐습니다. 이 사진이 페이지에 도움이 될지, 조용히 해를 끼칠지는 다음 네 가지가 결정합니다:
-
Alt 텍스트는 크롤러가 아니라 사람을 위해 쓰십시오. 모든 결과에는
alt_description이 딸려 있습니다 — 이를 초안으로 삼고, 여러분 문단의 맥락에 맞게 다시 쓰십시오. “아침 회의 중인 동료 네 명”이 키워드 나열보다 낫고, 스크린 리더가 실제로 읽어줄 텍스트이기도 합니다. 약 125자 이내로 유지하고, 이미지가 순전히 장식용일 때만 비워 두십시오(alt=""). -
강제하지 않아도 출처 표기를 넣으십시오. 출처 표기는 Pexafy API 약관에서 요구하지 않으며 모든 결과에는 바로 쓸 수 있는
attribution.html문자열이 붙어 있습니다 — 하지만 원본 라이브러리에 부여된 라이선스는 여전히 그 사진의 사용을 규율하며, 눈에 보이는 출처 표기 문구는 이것이 실제 작가가 있는 진짜 사진이라는 것을 독자(그리고 답변 엔진)에게 알려줍니다. -
알맞은 크기를 제공하십시오.
urls.regular(1080 px)는 대표 이미지용이고,urls.full은 어떤 기사에도 필요하지 않은 2400 px 파일입니다. 브라우저가 공간을 미리 확보하도록 응답에서width/height를 항상 함께 내보내십시오 — 이 속성 한 쌍만으로 레이아웃 이동 점수가 좋은지 나쁜지가 갈립니다. 대표 이미지에는fetchpriority="high"를, 접힘 영역 아래에는 모두loading="lazy"를 쓰십시오. -
대표 이미지를 메타데이터에도 넣으십시오. 같은 URL이
og:image,twitter:image,Article구조화 데이터의image속성이 되어야 합니다. 사진 한 장, 세 곳, 추가 작업 없이 — 그리고 더는 로고로 대체되지 않는 소셜 미리보기.
한 달에 기사 100편, 실제 비용은
대표 이미지 하나에 기사 내 이미지 세 개, 즉 게시물당 검색 요청 4회를 가정합니다 — 슬롯 하나마다 하나의 검색을 실행하는, 한 번 검색 결과를 재사용하는 대신 일부러 낭비적으로 쓰는 방식입니다:
| 규모 | 월간 검색 요청 수 | 요금제 | 검색 비용 |
|---|---|---|---|
| 기사 20편 | 80 | 무료 — 월 5,000회 요청 | $0 |
| 기사 100편 | 400 | 무료 — 월 5,000회 요청 | $0 |
| 기사 1,000편에이전시, 또는 클라이언트 포트폴리오 전체 | 4,000 | 무료 — 여전히 월 5,000회 이내 | $0 |
맞습니다 — 콘텐츠 마케팅 규모에서 월간 한도는 문제가 되지 않으며, 결제할 이유를 억지로 만들어내기보다는 있는 그대로 말씀드리는 편을 택하겠습니다. 실제로 마주칠 한도는 분당 한도입니다. 무료 요금제는 분당 API 요청 20회를 허용하는데, 한 번의 빌드 스크립트가 기사 100편에 다시 삽화를 넣으면 반복문이 처리하는 속도대로 요청 400건이 발생하므로, 20분 동안 제한을 받거나 429를 받기 시작합니다. 빠져나가는 방법은 두 가지입니다: 호출 간격을 두거나(반복문에 sleep 한 줄이면 야간 작업에서는 아무런 문제가 되지 않습니다), 혹은 빌드 규모에 맞는 속도 제한을 가진 요금제로 옮기십시오 — Starter는 분당 30회 요청, Pro는 60회입니다. 총량이 아니라 순간 부하를 기준으로 고르십시오.
그 외 유일한 항목은 기사당 브리프를 만드는 짧은 모델 호출 한 번입니다 — 입력 토큰 수백 개, 출력 토큰 30개 정도로, 여러분이 운영하는 어떤 콘텐츠 파이프라인에서든 가장 저렴한 항목이 될 것입니다. 이를 게시물당 이미지 4장, 한 달에 이미지 400장, 거기에 통과하지 못한 시도까지 생성하는 것과 비교해 보십시오.
그리고 비용표에는 드러나지 않는 부분: 편집자가 더는 탭 다섯 개를 열지 않게 됩니다. 그것이 실제로 절약되는 것입니다.
참고 자료 및 각주
1 EU AI법 제50조 — 특정 AI 시스템의 제공자와 배포자에 대한 투명성 의무로, 2026년 8월 2일부터 적용됩니다. 합성 오디오, 이미지, 비디오, 텍스트를 생성하는 시스템의 제공자는 결과물을 기계 판독 가능한 형식으로 표시하여 인공적으로 생성되었음을 감지할 수 있도록 해야 하며, 배포자는 딥페이크와, 정해진 경우 대중에게 정보를 제공하기 위해 게시되는 AI 생성 텍스트를 고지해야 합니다. 디지털 옴니버스(규정 (EU) 2026/1744, 2026년 7월 27일부터 시행)는 제50조 자체는 수정하지 않지만, 2026년 8월 2일 이전에 이미 시장에 나온 시스템에는 제50조(2)의 기계 판독 가능 표시 요건을 충족할 시간을 2026년 12월 2일까지 부여합니다. 이 모든 것은 AI 제공자와 배포자를 구속하는 것이며, 블로그가 어떤 이미지를 게시할 수 있는지에 대한 규칙이 아닙니다.
2 Google은 C2PA Content Credentials와 자체 SynthID 워터마크를 읽어 Search, Images, Lens 전반에 걸쳐 이 이미지 정보에 출처를 표시합니다. 이는 미디어 출처 표시이지, AI 생성 콘텐츠에 대한 순위 벌점이 아닙니다.
2026년 8월 15일에 확인한 출처: AI법 제50조 · 유럽위원회 — 투명성 FAQ · Google — 이미지 메타데이터 · Pexafy API & MCP 문서. 검색 시간과 결과는 같은 날 수집한 공개 API의 실제 응답입니다.
자주 묻는 질문
블로그 기사에 AI 생성 이미지를 써야 할까요, 실제 사진을 써야 할까요?
제 기사와 어울리는 이미지를 어떻게 자동으로 찾을 수 있나요?
GET /api/v1/search/photos?q=…로 약 150 ms가 걸리며, 모든 결과에는 크기, 라이선스, 바로 사용 가능한 출처 표기 문구가 함께 제공됩니다.기사를 이미지 검색 쿼리로 바꾸는 최적의 프롬프트는 무엇인가요?
블로그 게시물에 사용한 사진의 출처를 반드시 표기해야 하나요?
Claude나 다른 AI 에이전트가 제 기사에 맞는 사진을 찾아줄 수 있나요?
mcp.pexafy.com/mcp에 있는 Pexafy의 호스팅형 MCP(Model Context Protocol) 서버를 통해 가능합니다. Claude.ai나 Claude Desktop에 커스텀 커넥터로 추가한 뒤 OAuth로 로그인하거나, claude mcp add 명령 한 줄과 API 키만으로 Claude Code에 추가할 수 있습니다. 그러면 에이전트가 초안을 컨텍스트로 유지한 채 문장으로, 참조 이미지로, 또는 유사 사진 검색으로 직접 사진을 찾습니다.블로그의 모든 기사가 같은 사진을 사용하지 않게 하려면 어떻게 해야 하나요?
photo_id를 저장해 두고 다음 실행 시 이를 제외하세요 — CMS에 컬럼 하나만 추가하면 됩니다. 이는 자동화된 파이프라인이 대략 30번째 게시물 즈음에서 흔히 마주치는 실패 유형이며, 누군가 블로그 인덱스를 스크롤하기 전까지는 눈에 띄지 않습니다. 기사 제목을 재사용하지 않고 섹션마다 새로운 카메라 브리프를 작성하면 나머지 문제도 해결됩니다.

