आप जो भी लेख प्रकाशित करें उसे असली फ़ोटो से बड़े पैमाने पर कैसे सजाएँ
प्रकाशन टीमें असली फ़ोटोग्राफ़ी की ओर क्यों लौट रही हैं, और वह सटीक पाइपलाइन — प्रॉम्प्ट सहित — जो एक तैयार ड्राफ्ट को लगभग 150 मिलीसेकंड में क्रेडिट सहित हीरो इमेज में बदल देती है।
 Marouane Tijani
10 मिनट पढ़ना

आप जो भी लेख प्रकाशित करते हैं, उसे एक तस्वीर की ज़रूरत होती है। यह कोई अतिरिक्त सुविधा नहीं है — हीरो इमेज ही वह है जो सोशल प्रीव्यू में दिखती है, जो पाठक पहली पंक्ति से पहले देखता है, और आधे सेकंड में यह बता देती है कि यह पेज किसी परवाह करने वाले व्यक्ति ने बनाया है या नहीं। इसे प्रति पोस्ट चार तस्वीरों और तिमाही में चालीस पोस्ट से गुणा कर दें, तो "एक फ़ोटो ढूँढना" महज़ एक काम नहीं रह जाता, बल्कि एक पाइपलाइन की समस्या बन जाता है।
हम इसे इस तरह हल करते हैं: जनरेट की गई छवियों की जगह क्या इस्तेमाल करें और क्यों, और Pexafy को वर्कफ़्लो में जोड़ने के तीन तरीक़े — हाथ से, API से, या AI एजेंट के ज़रिए — साथ ही वह प्रॉम्प्ट भी, जो एक तैयार ड्राफ़्ट को ऐसे सर्च वाक्य में बदल देता है जो वाक़ई कुछ ढूँढ लाता है।
असली तस्वीरें आज भी जनरेट की गई तस्वीरों से बेहतर क्यों हैं
एक इलस्ट्रेशन जनरेट करना आसान है, और यही असल समस्या है। "AI इमेजेज़ एक चीट कोड हैं" से लेकर आज तक चार चीज़ें बदल चुकी हैं:
1 · बड़े पैमाने पर, सर्च करना जनरेट करने से तेज़ है
एक जनरेशन में एक प्रॉम्प्ट, एक इंतज़ार, एक निरीक्षण, और — ईमानदारी से कहें तो — इस्तेमाल लायक़ नतीजा पाने से पहले दो-तीन और कोशिशें शामिल होती हैं। एक सिमेंटिक सर्च एक ही अनुरोध है जो लगभग 150 मिलीसेकंड में सोलह उम्मीदवारों के साथ लौटता है, हर एक पहले से लाइसेंस प्राप्त, पहले से क्रेडिटेड, पहले से आकार में, और रिस्पॉन्स में अपने आयामों के साथ। एक तस्वीर के लिए यह अंतर एक कॉफ़ी जितना है। तिमाही में चार सौ तस्वीरों के लिए यह एक वर्कफ़्लो और एक काम-भर के बीच का फ़र्क़ है।
2 · एक फ़ोटोग्राफ़ सटीक होता है; एक जनरेशन प्रशंसनीय भर होता है
जिस पल आपका लेख किसी असली चीज़ के बारे में हो — एक पेशा, कोई उपकरण, एक शहर, कोई मुद्रा, कोई सामग्री — जनरेट की गई तस्वीर अनुभूति तो सही पकड़ लेती है, पर विवरण ग़लत कर देती है। छह उँगलियों वाले हाथ तो मज़ाक़िया संस्करण हैं; महँगा संस्करण है एक ऐसा सर्जिकल उपकरण जो अस्तित्व में ही नहीं है, कल्पित नियंत्रणों वाला एक कॉकपिट, या ऐसी "लिस्बन की गली" जिसे लिस्बन का कोई भी व्यक्ति नहीं पहचानता। जो पाठक आपके विषय को जानते हैं, वे यह नोटिस करते हैं, और सबसे पहले तस्वीर पर ही नोटिस करते हैं।
3 · सबका लुक एक जैसा है
डिफ़्यूज़न मॉडल एक जैसी हाउस स्टाइल की ओर अभिसरित होते हैं, और नरम-ग्रेडिएंट, अत्यधिक रोशनी वाले, संदेहास्पद रूप से सममित इलस्ट्रेशनों की एक दीवार अब फ़िलर जैसी लगती है। यह धारणा ही असल क़ीमत है: कोई दंड नहीं, बल्कि एक संकेत। एक असली फ़ोटोग्राफ़ — जिसमें ग्रेन हो, एक अटपटी कुर्सी हो, कोई बीच वाक्य में हो — रिपोर्टिंग जैसा लगता है।
4 · और अब वे साथ में एक लेबल लेकर आती हैं
यह बिंदु एक तर्क कम, संदर्भ ज़्यादा है, पर यही दिशा है जिधर चीज़ें जा रही हैं। 2 अगस्त 2026 से, EU AI Act के अनुच्छेद 50 के तहत जनरेटिव सिस्टम के प्रदाताओं को सिंथेटिक आउटपुट को मशीन-पठनीय प्रारूप में चिह्नित करना अनिवार्य है, और डिप्लॉयर को डीपफ़ेक का खुलासा करना होता है।1 पहचान के मोर्चे पर, Google, C2PA Content Credentials और अपने SynthID वॉटरमार्क को पढ़कर Search, Images और Lens के भीतर "क्या यह AI-जनरेटेड है?" का जवाब देता है।2 इनमें से कुछ भी इस बारे में नियम नहीं है कि कोई ब्लॉग कौन-सी तस्वीरें प्रकाशित कर सकता है, और इनमें से कुछ भी आपकी रैंकिंग को नुक़सान नहीं पहुँचाता। जो बदला है वह डाउनस्ट्रीम में है: आपके लेख के शीर्ष पर लगी तस्वीर की उत्पत्ति अब ऐसी चीज़ है जिसे पाठक बिना आपसे पूछे, दो क्लिक में जाँच सकता है। एक लाइसेंस प्राप्त फ़ोटोग्राफ़ के पास घोषित करने के लिए कुछ नहीं होता।
जब जनरेट की गई छवियाँ सही चुनाव होती हैं। कॉन्सेप्ट डायग्राम और स्कीमैटिक्स। ऐसा दृश्य जिसकी फ़ोटो नहीं ली जा सकती (एक ऐसा प्रोडक्ट जो अभी अस्तित्व में नहीं है, कोई अमूर्त तंत्र, कोई भविष्य का शहर)। एक हाउस इलस्ट्रेशन स्टाइल जिसके आप मालिक हैं और जिसे हर पोस्ट में दोहराना चाहते हैं। और वह सब कुछ जहाँ तस्वीर को जानबूझकर साक्ष्य के बजाय इलस्ट्रेशन के रूप में समझा जाता है। दोनों का इस्तेमाल करें — बस "मुझे मीटिंग में लोगों की एक तस्वीर चाहिए" के लिए जनरेशन को डिफ़ॉल्ट बनाना बंद करें।
इलस्ट्रेट करने के तीन तरीक़े, आपके वॉल्यूम के अनुसार
वही इंजन, वही कैटलॉग — 9 लाइब्रेरी की 9M+ मुफ़्त-उपयोग तस्वीरें — और तीन एंट्री पॉइंट। आप कितने तकनीकी हैं इससे नहीं, बल्कि आप कितने लेख प्रकाशित करते हैं इससे चुनें।
| एंट्री पॉइंट | किसके लिए सबसे अच्छाकौन और कितनी मात्रा में | प्रति लेख | आपको क्या चाहिए |
|---|---|---|---|
| सर्च UI | एडिटर, एक बार में एक पोस्ट — महीने में लगभग 20 तक | ~30 सेकंड | एक ब्राउज़र। सर्च करने के लिए किसी अकाउंट की ज़रूरत नहीं। |
| REST API | एक CMS, एक स्टैटिक-साइट बिल्ड, ड्राफ़्ट्स का एक बैच | ~1 अनुरोध, ~150 ms | एक API key। 5,000 req/माह मुफ़्त, 20/मिनट। |
| MCP सर्वर | वह AI एजेंट जो ड्राफ़्ट लिखता या संपादित करता है | उसी बातचीत के भीतर | एक कनेक्टर URL, OAuth या एक key। |
तीनों एक ही कैटलॉग और एक ही रैंकिंग साझा करते हैं, इसलिए UI में एक एडिटर द्वारा ढूँढी गई तस्वीर वही तस्वीर है, उसी पहचानकर्ता के साथ, जो API आपके बिल्ड स्क्रिप्ट को लौटाता है।
एक लेख, 30 सेकंड: सर्च UI
दृश्य का वर्णन वैसे करें जैसे आप किसी फ़ोटोग्राफ़र को करते — पूरे वाक्य में, अपनी ही भाषा में। सिर्फ़ team meeting नहीं —
बल्कि "a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office". हर अतिरिक्त ठोस विवरण नतीजों के सेट को ख़ाली करने के बजाय संकुचित करता है, क्योंकि इंजन आपके शब्दों को किसी के टैग्स से मिलाने के बजाय अर्थ के आधार पर रैंक करता है।
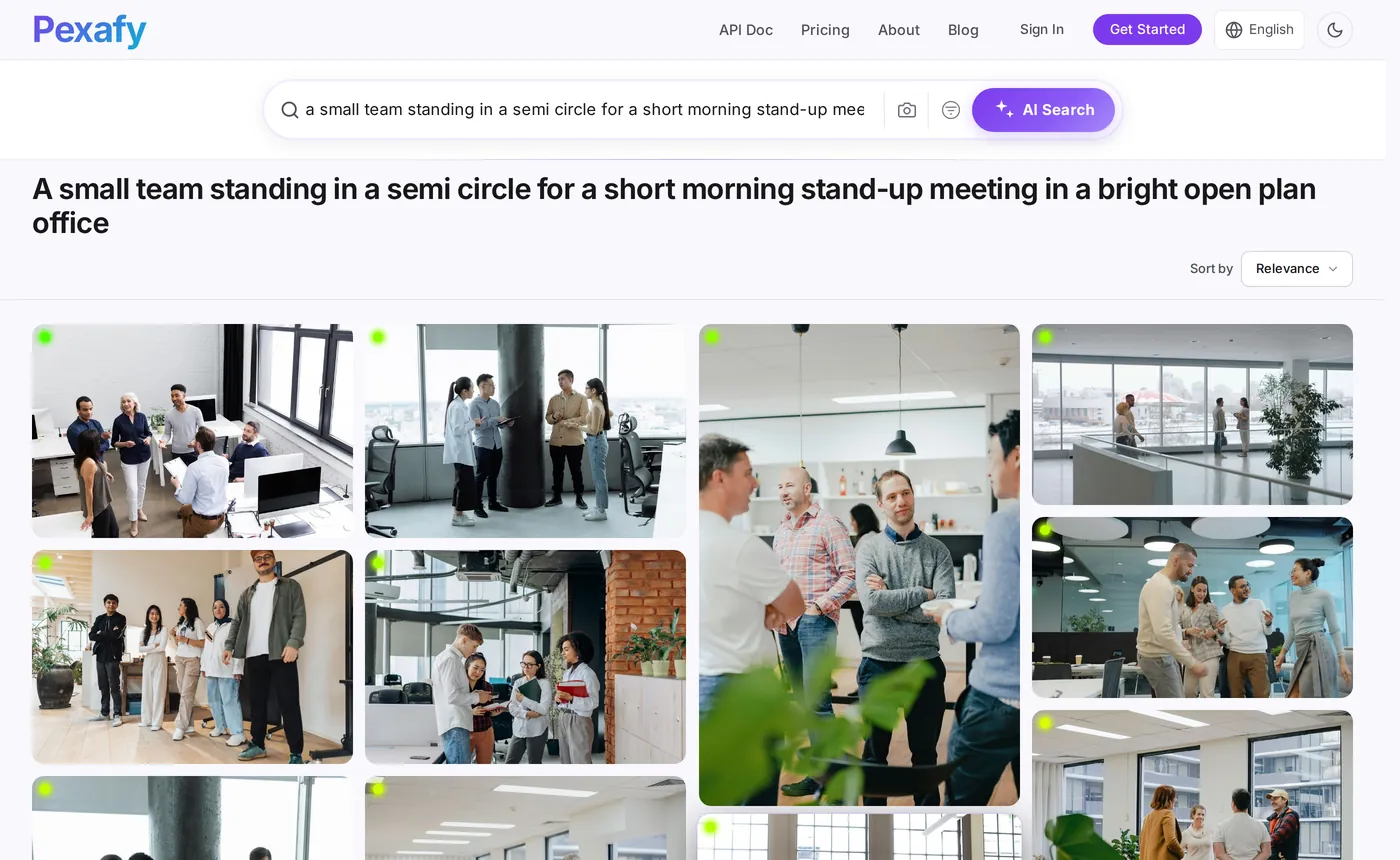
फिर उसे उन फ़िल्टर्स से संकुचित करें जो एक लेख के लेआउट के लिए मायने रखते हैं — और केवल उन्हीं से:
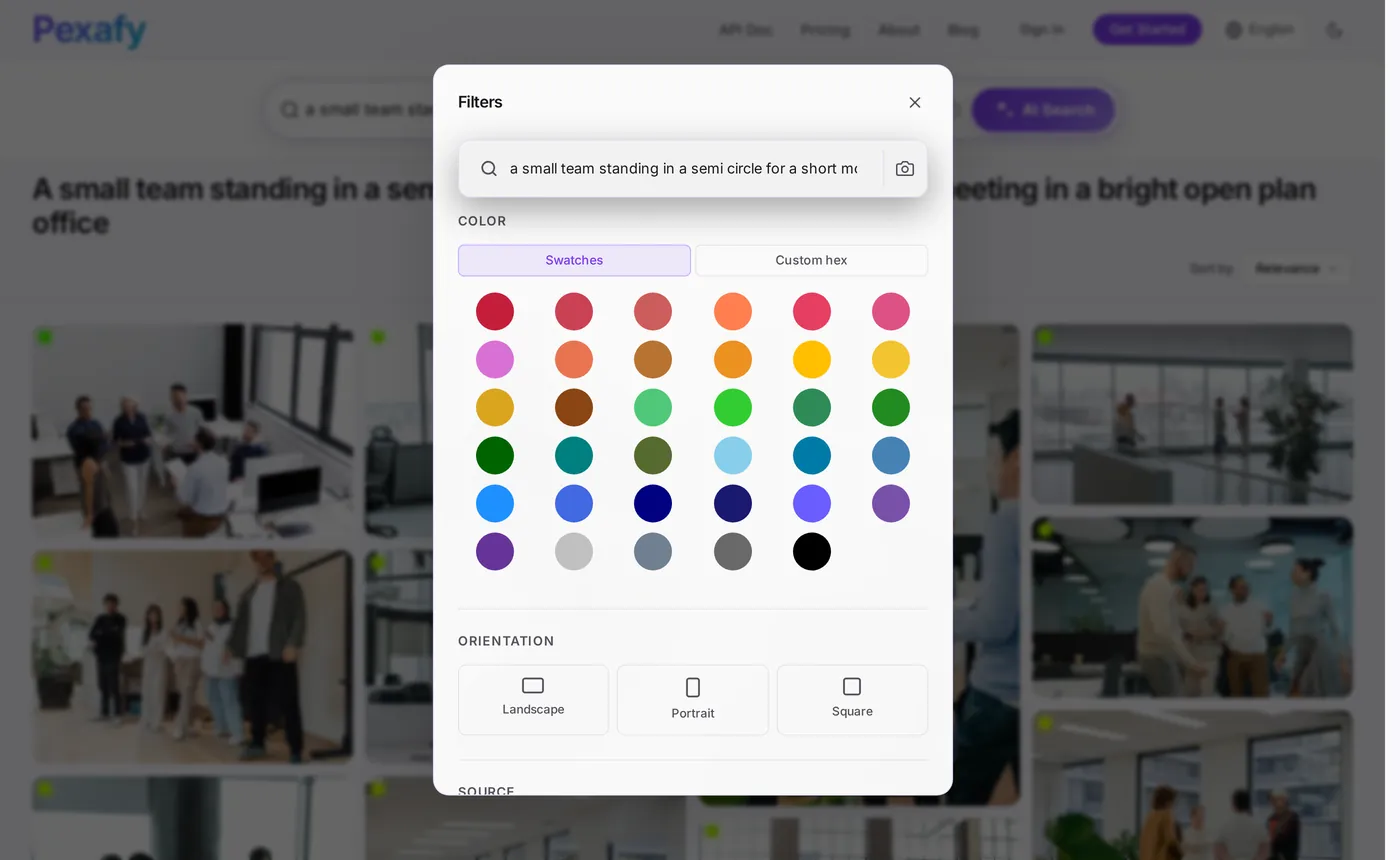
- कीवर्ड नहीं, वाक्य लिखें। विषय + क्रिया + जगह + रोशनी। 100+ भाषाओं में से किसी में भी 500 अक्षरों तक।
- हीरो के लिए लैंडस्केप फ़िल्टर करें, फिर लेख के भीतर की तस्वीरों के लिए फ़िल्टर हटाकर दोबारा चलाएँ, जहाँ अक्सर पोर्ट्रेट बेहतर लगता है।
- तस्वीर खोलें ताकि तैयार अट्रिब्यूशन लाइन, मूल स्रोत पेज और फ़ुल-रेज़ॉल्यूशन फ़ाइल मिल सके।
- अगले सेक्शन को उसी दृश्य रजिस्टर में इलस्ट्रेट करने के लिए चुनी गई तस्वीर पर "similar photos" का इस्तेमाल करें — वही रोशनी, वही ट्रीटमेंट, अलग दृश्य।
प्रॉम्प्ट: ड्राफ़्ट को सर्च वाक्य में बदलें
यह वह क़दम है जिसे हर कोई ऑटोमेट करते समय ग़लत कर बैठता है। वे लेख का शीर्षक सीधे सर्च बॉक्स में डाल देते हैं, जबकि शीर्षक बिल्कुल ग़लत इनपुट है: यह अमूर्त होता है ("The hidden cost of context switching") और धरती पर कोई फ़ोटोग्राफ़ उसे नहीं दर्शाती। मॉडल से आपको जो चाहिए वह सारांश नहीं है — बल्कि एक कैमरा ब्रीफ़ है।
# system prompt
You are a photo editor. Read the article and write ONE search sentence
for a stock-photo engine that ranks by meaning, not by keywords.

Rules:
1. Describe a scene a camera could have taken: someone doing
   something, somewhere. Never name the topic itself ("fintech",
   "productivity", "SEO") — name what would be in the frame.
2. 12 to 25 words. Longer beats shorter: every concrete detail
   (light, place, gesture, time of day) sharpens the match.
3. No text, logos, brands, charts, screenshots or famous people.
   Free photo libraries have almost none of those.
4. No invisible metaphors ("growth", "synergy", "transformation").
5. Match the mood of the article: calm, tense, tired, celebratory.
6. Write the sentence in English even if the article is not.

Return JSON only:
{ "query": "…", "orientation": "landscape", "alt": "…" }
नियम 1 सबसे ज़्यादा काम करता है। तीन असली ड्राफ़्ट पर वही नियम यहाँ देखें — बीच वाला कॉलम वह है जो कोई इंसान जल्दबाज़ी में टाइप करता है, दायाँ कॉलम वह है जो प्रॉम्प्ट लौटाता है:
| लेख इस बारे में है… | जल्दबाज़ी वाली क्वेरी | कैमरा ब्रीफ़ |
|---|---|---|
| आपकी डेली स्टैंड-अप क्यों टूटी हुई है | team meeting |
"a small team standing in a semi circle for a short morning stand-up meeting in a bright open plan office" |
| ऑनबोर्डिंग को 6 हफ़्तों से घटाकर 9 दिन करना | onboarding |
"a new employee on their first day at a desk, listening while a colleague leans in and points at their screen" |
| कॉन्टेक्स्ट स्विचिंग की छिपी हुई क़ीमत | productivity |
"a tired developer rubbing their eyes in front of two monitors late in the evening, the office empty behind them" |
team meeting वही सामान्य कॉन्फ़्रेंस-रूम स्टॉक लौटाता है जिसे आपके विषय पर बाक़ी सब पहले से इस्तेमाल कर रहे हैं। तीसरे कॉलम में दिया गया वाक्य यह लौटाता है, 155 मिलीसेकंड में:
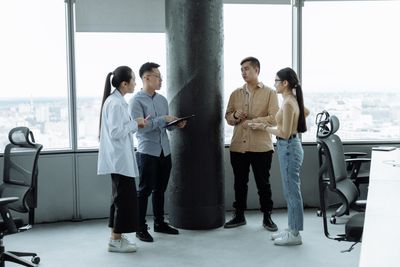

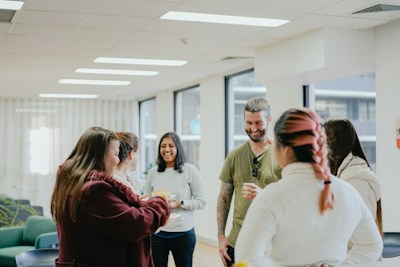
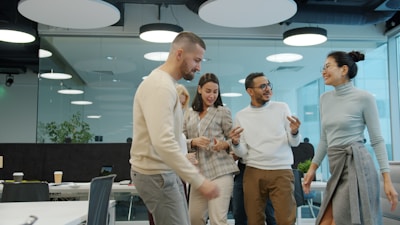
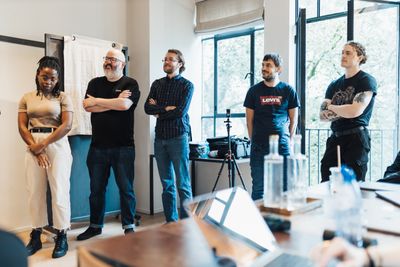
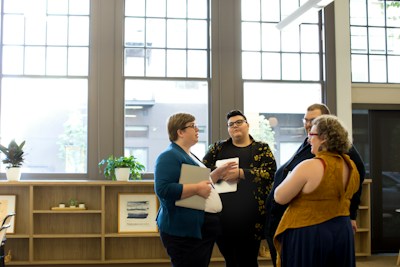
team meeting कभी सुनिश्चित नहीं करता।
पाइपलाइन: ड्राफ़्ट अंदर, क्रेडिटेड हीरो इमेज बाहर
चालीस लाइनें, दो कॉल: एक मॉडल को ब्रीफ़ के लिए, एक Pexafy को तस्वीर के लिए। इसे अपने CMS के सेव हुक में, अपने स्टैटिक-साइट बिल्ड में, या Markdown फ़ाइलों के किसी फ़ोल्डर पर चलने वाली स्क्रिप्ट में डाल दें।
import json, os, requests
from anthropic import Anthropic

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
llm = Anthropic()  # ANTHROPIC_API_KEY environment से

def camera_brief(article: str) -> dict:
    # PHOTO_EDITOR = ऊपर वाला सिस्टम प्रॉम्प्ट
    msg = llm.messages.create(
        model="claude-sonnet-5",
        max_tokens=300,
        system=PHOTO_EDITOR,
        messages=[{ "role": "user", "content": article[:12000] }],
    )
    return json.loads(msg.content[0].text)

def illustrate(article: str) -> dict | None:
    brief = camera_brief(article)
    r = requests.get(
        SEARCH,
        headers={"X-Api-Key": os.environ["PEXAFY_API_KEY"]},
        params={
            "q": brief["query"],           # पूरा वाक्य
            "orientation": brief["orientation"],
            "per_page": 8,
            "score_threshold": 0.55,      # कमज़ोर मैच हटाएँ
        },
        timeout=10,
    )
    hits = r.json()["data"]
    if not hits:                        # ब्रीफ़ बहुत संकीर्ण → चौड़ा करें, फिर कोशिश करें
        return None

    top = hits[0]
    return {
        "src":    top["urls"]["regular"],        # 1080px — हीरो साइज़
        "alt":    brief["alt"] or top["alt_description"],
        "credit": top["attribution"]["html"],   # रेंडर करने के लिए तैयार
        "width":  top["width"],
        "height": top["height"],
        "id":     top["photo_id"],           # इसे स्टोर करें: कोई दोहराव नहीं
    }
तीन बातें जो एक डेमो को कुछ ऐसा बना देती हैं जिसे आप चलता हुआ छोड़ सकते हैं:
score_threshold— कुछ न लौटाना एक बुरी तस्वीर लौटाने से बेहतर है। अगर ब्रीफ़ बहुत विशिष्ट था, तो इसे चौड़ा करें (आख़िरी हिस्सा हटा दें) और एक बार फिर कोशिश करें।photo_idको स्टोर करें — आपके डेटाबेस में एक लाइन, और आपकी साइट पर कोई भी दो लेख कभी एक ही हीरो इमेज साझा नहीं करेंगे। यह वह गड़बड़ी है जिससे हर कोई तीसवें पोस्ट पर टकराता है।- प्रति इमेज स्लॉट एक अनुरोध — एक हीरो और तीन सेक्शन इमेज मिलाकर प्रति लेख चार अनुरोध हैं, या अगर आप एक ही सर्च से चार अलग-अलग नतीजे लेते हैं तो एक।
Python नहीं जानते? पूरा सर्च वाला हिस्सा एक ही लाइन में है, और हर नतीजे में वही फ़ील्ड्स होते हैं चाहे वह किसी भी लाइब्रेरी से आया हो:
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a tired developer rubbing their eyes at two monitors" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "per_page=6"

# → { "success": true, "data": [ … ], "meta": { "took_ms": 147 } }
रिस्पॉन्स का ढाँचा — urls, width, photographer_full_name,
source, license_type, relevance_score,
attribution — Pexels की तस्वीर, Pixabay की तस्वीर और Unsplash की तस्वीर के लिए बिल्कुल एक जैसा है। यह सामान्यीकरण वह हिस्सा है जिसे आपको अन्यथा ख़ुद लिखना और बनाए रखना पड़ता; हमने इसे फ़ील्ड दर फ़ील्ड खोलकर देखा है
फ़्री स्टॉक फ़ोटो API तुलना में।
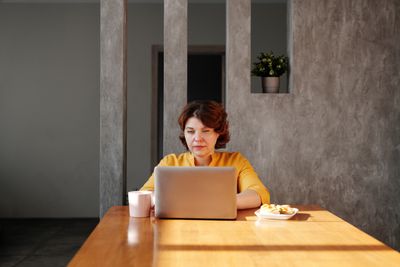
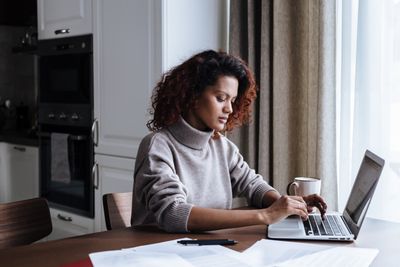
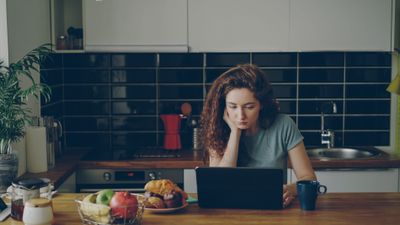
दूसरा सेक्शन, दूसरा ब्रीफ़, दूसरी सर्च — बात यह है कि एक लेख से चार गुना खींची गई एक ही तस्वीर के बजाय कई अलग-अलग दृश्य मिलते हैं:
एजेंट को तस्वीर चुनने दें: MCP
अगर कोई मॉडल पहले से ही ड्राफ़्ट लिख या संपादित कर रहा है, तो सबसे साफ़ पाइपलाइन कोई पाइपलाइन ही नहीं है: एजेंट को सर्च टूल दे दें और उसे उसी बातचीत में, जब तक उसके पास संदर्भ है, उसने अभी जो लिखा है उसे इलस्ट्रेट करने दें।
Pexafy mcp.pexafy.com/mcp पर एक होस्टेड Model Context Protocol सर्वर चलाता है। तीन टूल:
search_photos (एक वाक्य),
search_photos_by_image (एक संदर्भ इमेज, वैकल्पिक रूप से एक वाक्य के साथ — "इसके जैसा, पर सूर्यास्त में"), और get_similar_photos (जो आपने पहले चुना है उसके जैसे और नतीजे, जिससे कोई सीरीज़ सुसंगत बनी रहती है)।
Settings → Connectors → Add custom connector
Name: Pexafy
URL:  https://mcp.pexafy.com/mcp
# फिर विंडो खुलने पर अपने Pexafy अकाउंट से साइन इन करें
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# या पूरी टीम के लिए इसे रिपॉज़िटरी में कमिट कर दें — .mcp.json
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
यहाँ से, किसी लेख को इलस्ट्रेट करना एक काम नहीं, बस एक वाक्य है। एजेंट अपना ख़ुद का कैमरा ब्रीफ़ लिखता है — उसने अभी-अभी ड्राफ़्ट पढ़ा है, इसलिए दृश्य का वर्णन करने के लिए वह किसी से भी बेहतर स्थिति में है:
You  Here's the draft of this week's post. Find a landscape hero
     and one photo for section 2, and give me the credit lines.

Claude  → search_photos(
       q="a small team standing in a semi circle for a short morning
          stand-up meeting in a bright open plan office",
       orientation="landscape")
     ← 16 photos · 155 ms

     Hero    → Photo by Thirdman on Pexels · 6453×4302 · score 0.80
     Section → Photo by Marcus Aurelius on Pexels · 6000×4000
     Both licence-free, attribution lines below, ready to paste.
Unsplash, Pexels, Pixabay और Openverse के पास कोई आधिकारिक MCP सर्वर नहीं है — जो मौजूद हैं वे कम्युनिटी रैपर हैं जिन्हें आप ख़ुद होस्ट करते हैं और ख़ुद key देते हैं। अगर आपका संपादकीय वर्कफ़्लो पहले से ही किसी एजेंट के ज़रिए चलता है, तो यही फ़र्क़ ही असली इंटीग्रेशन है।
Alt टेक्स्ट, लाइसेंस और पेज स्पीड
तस्वीर चुन ली गई है। चार बातें तय करती हैं कि यह पेज की मदद करेगी या चुपचाप उसे नुक़सान पहुँचाएगी:
-
alt टेक्स्ट किसी क्रॉलर के लिए नहीं, किसी इंसान के लिए लिखें। हर नतीजे में एक
alt_descriptionमिलता है — इसे एक ड्राफ़्ट की तरह इस्तेमाल करें, फिर इसे अपने पैराग्राफ़ के संदर्भ में फिर से लिखें। "सुबह की मीटिंग में खड़े चार सहकर्मी" किसी कीवर्ड सलाद से बेहतर है, और यही वह टेक्स्ट है जो स्क्रीन रीडर वाक़ई पढ़ेगा। इसे लगभग 125 अक्षरों से कम रखें; इसे ख़ाली (alt="") तभी छोड़ें जब इमेज विशुद्ध रूप से सजावटी हो। -
क्रेडिट दें, भले ही इसके लिए कोई ज़ोर न दे रहा हो। Pexafy API की शर्तों के तहत अट्रिब्यूशन ज़रूरी नहीं है और हर नतीजे में एक तैयार
attribution.htmlस्ट्रिंग होती है — लेकिन मूल लाइब्रेरी से जुड़ा लाइसेंस फिर भी उस तस्वीर के आपके इस्तेमाल को नियंत्रित करता है, और एक दिखाई देने वाली क्रेडिट लाइन ही पाठक (और किसी उत्तर देने वाले इंजन) को बताती है कि यह एक वास्तविक लेखक वाली असली तस्वीर है। -
सही आकार परोसें।
urls.regular(1080 px) एक हीरो है;urls.fullएक 2400 px फ़ाइल है जिसकी किसी लेख को ज़रूरत नहीं। रिस्पॉन्स से हमेशाwidth/heightनिकालें ताकि ब्राउज़र जगह पहले से आरक्षित कर ले — यही attribute जोड़ी एक अच्छे और एक बुरे लेआउट-शिफ़्ट स्कोर के बीच का फ़र्क़ है। हीरो परfetchpriority="high"और फ़ोल्ड के नीचे हर चीज़ परloading="lazy"इस्तेमाल करें। -
हीरो को अपने मेटाडेटा में डालें। वही URL आपका
og:image, आपकाtwitter:imageऔर आपकेArticleस्ट्रक्चर्ड डेटा कीimageप्रॉपर्टी होना चाहिए। एक तस्वीर, तीन जगहें, शून्य अतिरिक्त काम — और एक सोशल प्रीव्यू जो अब आपके लोगो पर वापस नहीं गिरता।
महीने में 100 लेखों की असल क़ीमत क्या है
मान लें एक हीरो और लेख के भीतर तीन इमेज, यानी प्रति पोस्ट चार सर्च अनुरोध — जान-बूझकर फ़िज़ूलख़र्ची वाला संस्करण, जहाँ एक ही सर्च से नतीजे दोबारा इस्तेमाल करने के बजाय हर स्लॉट के लिए अलग क्वेरी चलाई जाती है:
| वॉल्यूम | सर्च अनुरोध / माह | प्लान | सर्च लागत |
|---|---|---|---|
| 20 लेख | 80 | फ़्री — 5,000 req/माह | $0 |
| 100 लेख | 400 | फ़्री — 5,000 req/माह | $0 |
| 1,000 लेखएक एजेंसी, या पूरा क्लाइंट पोर्टफ़ोलियो | 4,000 | फ़्री — फिर भी 5,000 req/माह के भीतर | $0 |
हाँ — कंटेंट-मार्केटिंग वॉल्यूम पर मासिक कोटा कोई मुद्दा ही नहीं है, और हम आपसे भुगतान करवाने के लिए कोई वजह गढ़ने के बजाय यह साफ़ बता देना बेहतर समझते हैं। जिस सीमा से आप वाक़ई टकराएँगे वह प्रति-मिनट वाली है। फ़्री प्लान में प्रति मिनट 20 API अनुरोध की अनुमति है; एक बिल्ड स्क्रिप्ट जो एक ही पास में 100 लेखों को फिर से इलस्ट्रेट करती है, आपके लूप की रफ़्तार जितनी तेज़ हो सके उतनी तेज़ी से 400 अनुरोध दाग देती है, तो या तो यह बीस मिनट थ्रॉटल होने में बिताती है या 429 पाना शुरू कर देती है। इससे बचने के दो तरीक़े: कॉल्स के बीच अंतराल रखें (लूप में एक sleep, और एक रात की जॉब कभी कुछ नोटिस नहीं करेगी), या ऐसे प्लान पर जाएँ जिसकी रेट लिमिट आपके बिल्ड से मेल खाती हो — Starter 30 अनुरोध/मिनट है, Pro 60। वॉल्यूम से नहीं, बर्स्ट से चुनें।
बाक़ी बचने वाली एकमात्र लाइन है प्रति लेख एक छोटा मॉडल कॉल ताकि ब्रीफ़ तैयार हो सके — कुछ सौ टोकन अंदर, तीस बाहर, जो कि आपके किसी भी कंटेंट पाइपलाइन में सबसे सस्ती चीज़ होगी। इसकी तुलना प्रति पोस्ट चार इमेज जनरेट करने से करें, महीने में चार सौ तस्वीरों पर, साथ ही उन कोशिशों से जो काम में नहीं आईं।
और वह हिस्सा जो किसी लागत तालिका में नहीं दिखता: एडिटर अब पाँच टैब खोलना बंद कर देता है। असल बचत यही है।
संदर्भ और फ़ुटनोट्स
1 EU AI Act, अनुच्छेद 50 — कुछ AI सिस्टम के प्रदाताओं और डिप्लॉयर के लिए पारदर्शिता की बाध्यताएँ, जो 2 अगस्त 2026 से लागू होती हैं। सिंथेटिक ऑडियो, इमेज, वीडियो या टेक्स्ट जनरेट करने वाले सिस्टम के प्रदाताओं को आउटपुट को मशीन-पठनीय प्रारूप में चिह्नित करना होगा और उन्हें कृत्रिम रूप से जनरेट किए गए के रूप में पहचान योग्य बनाना होगा; डिप्लॉयर को डीपफ़ेक और, कुछ तय मामलों में, जनता को सूचित करने के लिए प्रकाशित AI-जनरेटेड टेक्स्ट का खुलासा करना होगा। Digital Omnibus (Regulation (EU) 2026/1744, जो 27 जुलाई 2026 से लागू है) ख़ुद अनुच्छेद 50 में कोई संशोधन नहीं करता, पर 2 अगस्त 2026 से पहले बाज़ार में पहले से मौजूद सिस्टम को अनुच्छेद 50(2) की मशीन-पठनीय मार्किंग आवश्यकता पूरी करने के लिए 2 दिसंबर 2026 तक का समय देता है। यह सब AI प्रदाताओं और डिप्लॉयर को बाध्य करता है — यह इस बारे में नियम नहीं है कि कोई ब्लॉग कौन-सी तस्वीरें प्रकाशित कर सकता है।
2 Google, Search, Images और Lens में About this image के तहत उत्पत्ति दिखाने के लिए C2PA Content Credentials और अपने SynthID वॉटरमार्क को पढ़ता है। यह मीडिया की उत्पत्ति है, AI-जनरेटेड कंटेंट पर कोई रैंकिंग दंड नहीं।
स्रोतों की जाँच 15 अगस्त 2026 को की गई: AI Act Article 50 · European Commission — transparency FAQ · Google — image metadata · Pexafy API & MCP docs. सर्च टाइमिंग और नतीजे पब्लिक API से आए असली रिस्पॉन्स हैं, जिन्हें उसी दिन कैप्चर किया गया।
अक्सर पूछे जाने वाले प्रश्न
ब्लॉग लेखों के लिए मुझे AI-जनरेटेड इमेज इस्तेमाल करनी चाहिए या असली फ़ोटो?
मैं अपने लेख से मेल खाती इमेज अपने आप कैसे ढूँढूँ?
GET /api/v1/search/photos?q=… है, लगभग 150 ms में, और हर रिज़ल्ट अपने साइज़, लाइसेंस और एक तैयार अट्रिब्यूशन स्ट्रिंग के साथ आता है।किसी लेख को इमेज सर्च क्वेरी में बदलने के लिए सबसे अच्छा प्रॉम्प्ट क्या है?
क्या मुझे ब्लॉग पोस्ट में इस्तेमाल की गई फ़ोटो का श्रेय देना ज़रूरी है?
क्या Claude या कोई अन्य AI एजेंट मेरे लेख के लिए फ़ोटो ढूँढ सकता है?
mcp.pexafy.com/mcp के ज़रिए। इसे Claude.ai या Claude Desktop में कस्टम कनेक्टर के रूप में जोड़ें और OAuth से साइन इन करें, या इसे Claude Code में एक claude mcp add कमांड और एक API key के साथ जोड़ें। इसके बाद एजेंट खुद वाक्य के आधार पर, संदर्भ इमेज के आधार पर, या समान फ़ोटो के लिए सर्च कर सकता है, जबकि आपका ड्राफ्ट अब भी उसके संदर्भ में मौजूद रहता है।मैं अपने ब्लॉग के हर लेख में एक ही फ़ोटो इस्तेमाल होने से कैसे रोकूँ?
photo_id स्टोर करें और अगली बार उसे एक्सक्लूड कर दें — आपके CMS में बस एक कॉलम। यह वह विफलता है जिससे हर ऑटोमेटेड पाइपलाइन लगभग तीसवीं पोस्ट के आसपास टकराती है, और यह तब तक अदृश्य रहती है जब तक कोई आपके ब्लॉग इंडेक्स को स्क्रॉल न करे। लेख के शीर्षक को दोबारा इस्तेमाल करने के बजाय हर सेक्शन के लिए एक नया कैमरा ब्रीफ़ लिखना बाकी काम कर देता है।

