แสดงภาพประกอบ 10,000 หน้าต่อเดือนด้วยภาพถ่ายจริง — ใน 500 API Calls
ค้นหาหนึ่งครั้งต่อกลุ่มหัวข้อแทนที่จะค้นหาหนึ่งครั้งต่อภาพ แล้ว 40,000 API calls ก็จะกลายเป็น 500 รูปแบบ pool-and-assign, Worker ที่อยู่รอดแม้เจอ Rate Limit และหัวข้อที่พูดตรงๆ ว่าภาพถ่ายแก้ปัญหาอะไรไม่ได้
 Marouane Tijani
12 นาทีในการอ่าน

มีปัญหาเรื่องภาพประกอบเนื้อหาเวอร์ชันหนึ่งที่รสนิยมที่ดีเพียงอย่างเดียวแก้ไม่ได้ นั่นคือ คุณ ไม่ได้กำลังเลือกภาพภาพเดียว แต่กำลังเติมช่องภาพ 40,000 ช่องต่อเดือนใน 800 กลุ่มหัวข้อ 9 ภาษา และเว็บไซต์ลูกค้า 14 แห่ง และแต่ละภาพต้องมีลิขสิทธิ์ถูกต้อง มีเครดิต มีขนาดที่เหมาะสม และ แตกต่างจากภาพข้างเคียง เมื่อถึงปริมาณระดับนี้ คำถามจึงไม่ใช่ “ควรใช้ภาพไหน?” อีกต่อไป แต่กลายเป็น “สถาปัตยกรรมควรเป็นแบบไหน?”
บทความนี้คือคำตอบเชิง API: รูปแบบคำขอที่ลดจำนวนการเรียกลงสองอันดับขนาด, worker ที่รอดพ้นจาก rate limit, การกำจัดภาพซ้ำที่ทำให้เว็บไซต์ 10,000 หน้าไม่ดูเหมือนกำแพงภาพสต็อก ภาพเดียวซ้ำ ๆ — และหัวข้อที่พูดตรง ๆ ว่าภาพถ่ายทำอะไรให้คุณไม่ได้บ้าง
คอขวดตัวจริงเมื่อมี 10,000 บทความ
ทีมที่เผยแพร่เนื้อหาในปริมาณมาก — ไม่ว่าจะเป็นเว็บไซต์ programmatic SEO ขนาดใหญ่, หน้าหมวดหมู่ของมาร์เก็ตเพลส, aggregator, เครือข่าย affiliate, เอเจนซีที่ผลิตเนื้อหาให้ลูกค้าหลายราย, หรือไปป์ไลน์การแปลภาษา ที่แปลงบทความหนึ่งเป็น 20 ภาษา — ล้วนเจอกำแพงสามด้านเดียวกัน ในลำดับเดียวกัน:
- จำนวนคำขอ การค้นหาหนึ่งครั้งต่อหนึ่งช่องภาพหมายถึงการเรียก API 40,000 ครั้ง สำหรับบทความ 10,000 บทความที่มี 4 ภาพต่อบทความ ผู้ให้บริการทุกรายตั้งราคา จำกัดอัตรา และตรวจสอบคุณตามตัวเลขนี้
- ความซ้ำซาก เมื่อถึงหน้าที่สามสิบ ภาพเดิมก็เริ่มปรากฏซ้ำ พอถึงหน้าที่ สามพัน เว็บไซต์ของคุณก็มี “ลายเซ็นทางภาพ” ที่บ่งบอกว่า สร้างขึ้นแบบจำนวนมาก
- การประสานงาน บทความร้อยบทความในกลุ่มหัวข้อเดียวกันควรดูเหมือนเป็นชุดเดียวกัน ไม่ใช่บอร์ด Pinterest ร้อยบอร์ดที่ไม่เกี่ยวข้องกัน — และเมื่อแปลบทความเดียวกันเป็นอีกภาษาหนึ่ง ควรใช้ภาพเดิมซ้ำ ไม่ใช่ค้นหาใหม่ในภาษาอื่น
สังเกตว่าสิ่งที่ ไม่ อยู่ในรายการนี้คือการหาภาพดี ๆ สักภาพ เอนจินแบบ semantic คืนหน้าผลลัพธ์ที่ใช้งานได้ภายในประมาณ 130 มิลลิวินาที การค้นคืนภาพได้รับการแก้ไขแล้ว แต่การกระจายภาพยังไม่ได้รับการแก้ไข เนื้อหาด้านล่างทั้งหมดว่าด้วยเรื่องการกระจายภาพ
ทำไมภาพถ่ายจริงถึงสำคัญ โดยเฉพาะที่ปริมาณระดับนี้
เหตุผลที่ควรเลือกภาพถ่ายมากกว่าภาพที่สร้างขึ้น ยิ่งชัดเจนขึ้น เมื่อปริมาณเพิ่มขึ้น ด้วยเหตุผลที่ส่วนใหญ่เป็นเรื่องปฏิบัติการมากกว่าเรื่องความสวยงาม
| ที่ 40,000 ภาพ/เดือน | สร้างภาพขึ้นมาเอง | ค้นหาภาพ |
|---|---|---|
| เวลาต่อภาพ | ตั้งแต่วินาทีถึงนาที บวกกับความพยายามที่ถูกปฏิเสธ | คำขอเดียว (~130 ms) ครอบคลุมทั้งกลุ่มหัวข้อ |
| ปัจจัยด้านต้นทุน | ต่อภาพ ตลอดไป | ต่อคำขอ — และคำขอเดียวรองรับได้ประมาณ 25 บทความ |
| เมทาดาต้าที่ได้รับ | ไม่มี คุณต้องเขียน alt text และระบุขนาดเอง | ขนาด, สีเด่น, blur hash, ร่างคำบรรยายภาพ, บรรทัดเครดิต |
| ที่มา (Provenance) | ถูกทำเครื่องหมายโดยเครื่องว่าเป็นภาพสังเคราะห์ ภายใต้ EU AI Act ตั้งแต่ 2 สิงหาคม 20261 | ช่างภาพที่ระบุชื่อได้ วันที่ URL ต้นทางที่ผู้อ่านเปิดดูได้ |
| รูปแบบความล้มเหลว | รายละเอียดที่ดูสมเหตุสมผลแต่ผิดพลาด, สไตล์ที่เหมือนกันหมดทั้งค่าย | ไม่มีอะไรตรงกับโจทย์ — คุณจะได้ผลลัพธ์เป็นศูนย์ ซึ่งคุณจัดการได้ |
แถวเมทาดาต้าคือแถวที่ตัดสินไปป์ไลน์ ผลการค้นหาทุกรายการมาพร้อม
width, height, blur_hash, color_hex,
alt_description และสตริง attribution.html ที่พร้อมใช้งาน — นี่คือ
payload ที่เอนจินเทมเพลตต้องการพอดีเพื่อสร้าง
<img> ที่ไม่มี layout shift พร้อม placeholder และเครดิต ส่วนภาพที่สร้างขึ้นเองให้คุณเพียงไฟล์
แล้วปล่อยให้อีกหกฟิลด์ที่เหลือคุณต้องคิดขึ้นเอง
จุดที่ภาพที่สร้างขึ้นยังคงชนะในระดับ scale การอธิบายภาพระดับหมวดหมู่สำหรับ หัวข้อนามธรรม (“การย้ายระบบไปคลาวด์”, “กองทุนดัชนี”), แผนภาพ, และสไตล์เฉพาะแบรนด์ที่ต้องการให้ ซ้ำกันทั้งเว็บไซต์ด้วยเหตุผลด้านแบรนด์ แนวทางแบ่งที่สำนักพิมพ์ขนาดใหญ่ส่วนใหญ่ใช้คือ ใช้ภาพถ่ายสำหรับสิ่งที่มีอยู่จริงในโลก ใช้ภาพศิลป์ที่สร้างขึ้นสำหรับสิ่งที่มีอยู่เฉพาะ ในข้อโต้แย้งเท่านั้น เราได้อธิบายเหตุผลของการแบ่งแบบนี้อย่างครบถ้วนใน วิธีใส่ภาพประกอบให้ทุกบทความที่คุณเผยแพร่
หนึ่งคำขอ หนึ่งร้อยภาพ
นี่คือการเปลี่ยนแปลงเดียวที่ปรับโครงสร้างเลขคณิตทั้งหมด endpoint การค้นหารองรับ
per_page สูงสุด 100 และการแบ่งหน้าแบบ cursor ให้คุณเดินหน้าต่อใน
ชุดผลลัพธ์ที่จัดอันดับเดียวกันได้เรื่อย ๆ ดังนั้นหน่วยของงานจึงไม่ใช่ ภาพหนึ่งภาพ แต่เป็น พูลหนึ่งพูล
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a woman signing paperwork with an insurance agent at a kitchen table in her home" \
  --data-urlencode "per_page=100" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "score_threshold=0.5" \
  --data-urlencode "fields=photo_id,urls,width,height,blur_hash,alt_description,attribution"

# → { "success": true, "data": [ …สูงสุด 100 ภาพ… ],
#     "pagination": { "per_page": 100, "has_more": true, "next_cursor": "eyJyc…" },
#     "meta": { "took_ms": 122.33, "request_id": "7ff1fb9b-…" } }
พารามิเตอร์สามตัวในนี้กำลังทำงานอย่างเงียบ ๆ ในระดับ scale:
fields— sparse fieldset การขอเพียงเจ็ดฟิลด์ที่เทมเพลตของคุณ ต้องเรนเดอร์ ทำให้ response หยุดส่งคำอธิบาย AI ยาว ๆ ของภาพทุกภาพ เมื่อคูณด้วย 40,000 ภาพ นี่คือความต่างระหว่างการ build ที่ทำงานแบบ stream กับแบบที่ swapscore_threshold— ท้ายหน้าผลลัพธ์ 100 รายการ โดยนิยามแล้ว ย่อมมีความเกี่ยวข้องน้อยกว่าส่วนต้น การตั้งค่าขั้นต่ำหมายความว่ากลุ่มหัวข้อที่บางจะคืน ภาพ 34 ภาพแทนที่จะเป็น 100 ภาพที่คุณภาพปานกลาง และไปป์ไลน์ของคุณสามารถตอบสนองต่อสิ่งนั้น แทนที่จะเผยแพร่มันไปเลยnext_cursor— เมื่อกลุ่มหัวข้อต้องการภาพจริง ๆ ถึง 300 ภาพ ให้แบ่งหน้าในชุดผลลัพธ์ที่จัดอันดับเดียวกัน แทนที่จะยิงคำถามสามชุดที่แตกต่างกันซึ่งซ้อนทับกัน
และนี่คือเลขคณิต สำหรับเว็บไซต์ที่เผยแพร่ 10,000 หน้าต่อเดือน แต่ละหน้ามี 4 ภาพ:
| กลยุทธ์ | คำขอ / เดือน | รอบเดียวที่ rate limit ของแผนฟรี20 คำขอ/นาที | อยู่ในโควตารายเดือนของแผนฟรีหรือไม่? |
|---|---|---|---|
| ค้นหาหนึ่งครั้งต่อหนึ่งช่องภาพ | 40,000 | 33 hours | ไม่ได้ — ต้องใช้แผนแบบชำระเงิน |
| ค้นหาหนึ่งครั้งต่อหนึ่งบทความ | 10,000 | 8 hours | ไม่ได้ — ต้องใช้แผนแบบชำระเงิน |
| ค้นหาหนึ่งครั้งต่อกลุ่มหัวข้อประมาณ 20 บทความรูปแบบในบทความนี้ | 500 | 25 minutes | ได้ |
ทั้งสามแถวเผยแพร่ภาพ 40,000 ภาพเท่ากัน สิ่งเดียวที่เปลี่ยนไปคือตำแหน่งที่วางลูป
พูลและจัดสรร: รูปแบบที่ scale ได้
สถาปัตยกรรมทั้งหมดคือสองเฟสที่ทำงานด้วยความถี่ต่างกัน โดยมีตารางคั่นกลาง:
                     ┌─────────── รันทุกสัปดาห์ ~500 คำขอ ───────────┐
  topic clusters ──▶ POOL   ค้นหาหนึ่งครั้งต่อหนึ่งกลุ่มหัวข้อ per_page=100
                     │       └─▶ เก็บภาพ 100 แถวต่อหนึ่งกลุ่มหัวข้อ
                     └──────────────────┬───────────────────────────────┘
                                        ▼
                              image_pool table
                        (cluster, photo_id, urls, blur_hash,
                         alt, credit, used_by_page, used_at)
                                        │
                     ┌──────────────────┴──── รันทุกครั้งที่เผยแพร่ 0 คำขอ ───┐
  article ─────────▶ ASSIGN  เลือกแถวที่ดีที่สุดที่ยังไม่ถูกใช้สำหรับ
                     │        กลุ่มหัวข้อนี้ ทำเครื่องหมายว่าใช้แล้ว เรนเดอร์
                     └────────────────────────────────────────────────────────┘
สิ่งที่ได้รับจากรูปแบบนี้ เรียงตามความสำคัญในระดับ scale:
- การเผยแพร่ไม่ต้องรอ API เลย การจัดสรรคือการอ่านฐานข้อมูล ตัว save hook ของ CMS การ build แบบ static และการนำเข้าจำนวนมากตอนตีสามล้วนทำงานด้วยความเร็วในเครื่อง แบบออฟไลน์ โดยไม่มี rate limit ใด ๆ ในเส้นทางนั้นเลย
- การกำจัดภาพซ้ำนั้นฟรีและแม่นยำ
used_by_page IS NULLคือ ฟีเจอร์ทั้งหมด สองหน้าไม่สามารถดึงภาพเดียวกันได้ เพราะการจัดสรรเป็นทรานแซกชัน ไม่ใช่ heuristic การจัดอันดับ - การรันซ้ำนั้นถูกและ idempotent รีเฟรชพูลของกลุ่มหัวข้อเมื่อภาพเหลือน้อย
หรือเมื่อต้องการภาพถ่ายที่ใหม่กว่า (
after_dateหรือsort_by=newest) — เพียงคำขอเดียว และสิ่งที่เผยแพร่ไปแล้วจะไม่ถูกเปลี่ยน - ภาษาต่าง ๆ ได้มาฟรี การแปล 20 ภาษาของบทความหนึ่งคือหน้าเดียวในโมเดล
ของคุณที่มี 20 การเรนเดอร์ พวกมันใช้
photo_idที่จัดสรรร่วมกัน และคุณไม่ต้อง ค้นหาซ้ำเลย เมื่อคุณ ต้องการ ภาพที่ถ่ายในท้องถิ่นจริง ๆ ให้รันคำถามพูลสำหรับกลุ่มหัวข้อนั้น ในภาษาเป้าหมาย — เอนจินรับประโยคได้มากกว่า 100 ภาษา
Worker ในรูปแบบโค้ด
ประมาณหกสิบบรรทัด ตัวเติมพูลเป็นส่วนเดียวที่คุยกับเครือข่าย ดังนั้นจึงเป็นส่วนเดียวที่
ต้องระมัดระวัง — จำกัด concurrency, เคารพ 429, เขียนผลลัพธ์ในทรานแซกชันเดียว
import asyncio, os, time, httpx

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
KEY    = os.environ["PEXAFY_API_KEY"]
FIELDS = "photo_id,urls,width,height,blur_hash,alt_description,attribution"

# แผนฟรี = 20 คำขอ/นาที เผื่อไว้หนึ่งหน่วย ตัว pacer เป็นแบบ GLOBAL: การ sleep ต่อ task
# ภายใน concurrency gate จะทำให้ worker N ตัวยิงเร็วขึ้น N เท่าของ rate
PER_MIN = 19
gate    = asyncio.Semaphore(4)         # การเชื่อมต่อที่กำลังทำงานอยู่
_lock   = asyncio.Lock()
_slot   = 0.0                          # ช่วงเวลาว่างถัดไปบนไทม์ไลน์ร่วม

async def pace():
    """แจกช่องคำขอหนึ่งช่องทุก 60/PER_MIN วินาที ทั่วทั้งฟลีท"""
    global _slot
    async with _lock:
        now  = time.monotonic()
        _slot = max(now, _slot) + 60 / PER_MIN
        wait  = _slot - now
    if wait > 0:
        await asyncio.sleep(wait)

class QuotaExhausted(Exception): ...   # รายเดือน: การลองใหม่ช่วยอะไรไม่ได้

async def fill_pool(client, cluster) -> list[dict]:
    """คำขอเดียว → ภาพมีเครดิตสูงสุด 100 ภาพสำหรับหนึ่งกลุ่มหัวข้อ"""
    for attempt in range(4):
        await pace()
        async with gate:
            r = await client.get(
                SEARCH,
                headers={"X-Api-Key": KEY},
                params={
                    "q": cluster["camera_brief"],   # ฉากหนึ่ง ไม่ใช่คีย์เวิร์ด
                    "per_page": 100,
                    "orientation": "landscape",
                    "score_threshold": 0.5,
                    "fields": FIELDS,
                },
                timeout=15,
            )
        if r.status_code == 429:
            retry_after = r.headers.get("Retry-After")
            if retry_after is None:            # ไม่มี Retry-After ⇒ โควตารายเดือน
                raise QuotaExhausted(cluster["id"])   # หยุดการรันทั้งหมด
            await asyncio.sleep(int(retry_after))   # รายนาที: มันจะหายไปเอง
            continue
        r.raise_for_status()
        return r.json()["data"]
    return []                                  # บันทึก log ไว้ พูลยังคงแถวเดิม

async def refill(clusters):
    async with httpx.AsyncClient(http2=True) as client:
        pools = await asyncio.gather(*(fill_pool(client, c) for c in clusters))
    for cluster, photos in zip(clusters, pools):
        db.upsert_pool(cluster["id"], photos)     # ON CONFLICT DO NOTHING ที่ photo_id
รายละเอียดสองอย่างในนั้นคือความแตกต่างระหว่าง worker ที่รันโดยไม่มีคนดูแลกับ worker ที่ปลุกคุณ
ให้ตื่นกลางดึก ตัว pacer เป็น global ไม่ใช่ต่อ task: การวาง sleep ไว้ภายใน
concurrency gate คือความผิดพลาดคลาสสิก — worker สี่ตัวต่างหยุด 3 วินาทีหลังคำขอของ
ตัวเองจะผลิตคำขอสี่ครั้งทุก 3 วินาที ประมาณ 75 คำขอต่อนาที และแผนฟรีจะเริ่มคืน
429 ทันที และ 429 ทั้งสองแบบก็ไม่ใช่สัตว์ชนิดเดียวกัน: แบบรายนาที
จะมี Retry-After และหายไปเอง ส่วนแบบโควตารายเดือนจะไม่มี และจะไม่มีวันมี —
การลองใหม่กับแบบนั้นคือการวนซ้ำชนกำแพงเปล่า ๆ
การจัดสรร ซึ่งเป็นส่วนที่รันทุกครั้งที่เผยแพร่ ไม่แตะเครือข่ายเลย:
# ความไม่ซ้ำถูกบังคับใช้โดย schema ไม่ใช่โดยความรอบคอบของคำสั่งค้นหา
# ภาพหนึ่งภาพอาจอยู่ในพูลของหลายกลุ่มหัวข้อ แต่จะถูกเผยแพร่ได้เพียงครั้งเดียวเท่านั้น
# CREATE UNIQUE INDEX one_use_per_photo ON image_pool (photo_id)
#        WHERE used_by_page IS NOT NULL;

def assign_hero(page_id: str, cluster_id: str) -> dict | None:
    for _ in range(5):                # หากแพ้การแย่งชิงก็แค่หยิบภาพถัดไป
        try:
            return db.query_one("""
                UPDATE image_pool p SET used_by_page = %s, used_at = NOW()
                WHERE p.id = (
                    SELECT c.id FROM image_pool c
                    WHERE c.cluster_id = %s AND c.used_by_page IS NULL
                      AND NOT EXISTS (              -- ถูกใช้โดยกลุ่มหัวข้ออื่นหรือไม่?
                          SELECT 1 FROM image_pool u
                          WHERE u.photo_id = c.photo_id
                            AND u.used_by_page IS NOT NULL
                      )
                    ORDER BY c.rank ASC
                    LIMIT 1 FOR UPDATE SKIP LOCKED  -- ปลอดภัยเมื่อ worker ทำงานขนาน
                )
                RETURNING photo_id, urls, width, height, blur_hash, alt, credit
            """, [page_id, cluster_id])
        except UniqueViolation:      # สองกลุ่มหัวข้อแย่งภาพเดียวกันในมิลลิวินาทีเดียวกัน
            continue
    return None                     # พูลหมด → ขยายโจทย์ แล้วเติมใหม่

# การเรนเดอร์: ทุกแอตทริบิวต์มาจากแถวนั้นเอง — ไม่มี layout shift ไม่ต้องเดา
# <img src="{urls[regular]}" width="{width}" height="{height}"
#      alt="{alt}" loading="lazy" style="background:{blur_placeholder}">
# <figcaption>{credit}</figcaption>
รูปแบบความล้มเหลวสองแบบ กลไกสองแบบ และต้องใช้ทั้งคู่ FOR UPDATE SKIP LOCKED
จัดการ concurrency ภายใน หนึ่งกลุ่มหัวข้อ: สร้างหน้าแบบขนาน — และที่ปริมาณระดับนี้
คุณจะต้องทำแบบนั้น — และ worker สองตัวเอื้อมไปหยิบภาพอันดับต้นเดียวกันในมิลลิวินาทีเดียวกัน
ดัชนี unique แบบบางส่วนจัดการกรณีที่ทุกคนมักลืม: ภาพเดียวกันปรากฏอย่างถูกต้องในพูลของ
หลาย กลุ่มหัวข้อ เพราะกลุ่มหัวข้อใกล้เคียงกัน (“ประกันบ้านสำหรับผู้เช่า”, “…สำหรับเจ้าของบ้านให้เช่า”)
คืนผลลัพธ์ที่ซ้อนทับกัน การตรวจสอบ used_by_page IS NULL แบบต่อกลุ่มหัวข้อ
มองไม่เห็นเรื่องนี้ — แต่ละกลุ่มหัวข้อเชื่อว่าภาพนั้นว่างอยู่ NOT EXISTS
ทำให้คำสั่งค้นหานั้นซื่อสัตย์ และดัชนีทำให้เป็นไปไม่ได้ที่จะผิดพลาดภายใต้ concurrency:
ฝ่ายที่แพ้การแย่งชิงจะได้รับ violation ลองใหม่ และหยิบภาพถัดไป หากไม่มีสิ่งนี้
ข้อความ “ไม่มีสองหน้าใดใช้ภาพหลักซ้ำกัน” ก็เป็นเพียงคำกล่าวอ้าง ไม่ใช่การรับประกัน
เมื่อพูลหมดกลางคันของการ build ทางแก้ที่ทำงานได้ดีที่สุดคือขยายโจทย์แทนที่จะใช้ซ้ำ: ตัดวลีสุดท้ายของโจทย์ถ่ายภาพออก รันคำถามพูลใหม่หนึ่งครั้ง แล้วจึงใช้ภาพที่ถูกจัดสรร นานที่สุดซ้ำ — โดยมีกฎเหล็กว่าภาพนั้นจะไม่ตกลงบนหน้าในกลุ่มหัวข้อเดียวกันเด็ดขาด
หนึ่งกลุ่มหัวข้อ หนึ่งพูล: คำถามค้นหาจริง
ลองใช้เว็บไซต์เปรียบเทียบ: ประกันบ้าน ยี่สิบหน้า — “ประกันบ้านสำหรับผู้เช่า”, “…สำหรับเจ้าของบ้านให้เช่า”, “กรมธรรม์คุ้มครองอะไรบ้าง”, หน้าเมืองสิบสองเมือง, คู่มือการเคลม 3 ฉบับ โจทย์ถ่ายภาพเดียวสำหรับกลุ่มหัวข้อนี้ คำขอเดียว และนี่คือส่วนหัวของพูล ซึ่งคืนผลลัพธ์ภายใน 122 มิลลิวินาที:
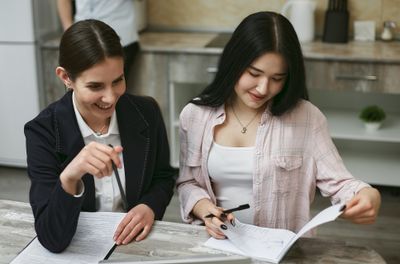
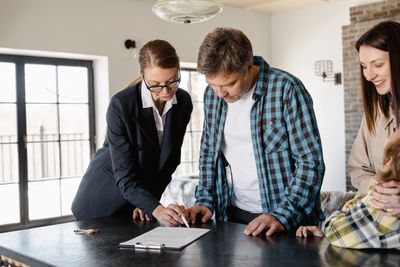
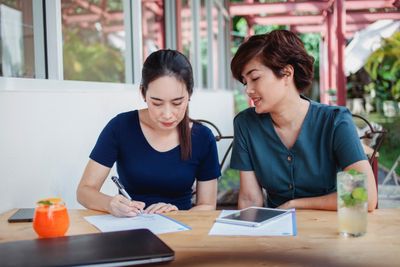
per_page=100 และเก็บที่เหลือไว้ด้วย
ลองรันคำค้นหานี้เลย →
โจทย์ถ่ายภาพสำคัญมากกว่าโค้ด กฎสองข้อที่ยังใช้ได้เมื่อเจอกับเว็บไซต์กลุ่มหัวข้อจริง ๆ:
เขียนโจทย์สำหรับ กลุ่มหัวข้อ ไม่ใช่สำหรับหน้าเดี่ยว (เพราะชื่อหน้าในชุด programmatic
มักคล้ายกันเกือบเป๊ะ ทำให้โจทย์ต่อหน้าคืนภาพที่คล้ายกันเกือบเป๊ะเช่นกัน) และให้อธิบายฉาก
ที่กล้องถ่ายได้จริง แทนที่จะเป็นหัวข้อ — ประกันบ้าน จะคืนแต่ภาพเอกสารระยะใกล้
และไม่มีอะไรอื่นเลย เราได้เผยแพร่พรอมต์ที่คัดลอกไปใช้ได้เลยซึ่งสร้างโจทย์แบบนี้ไว้ใน
บทความว่าด้วยการใส่ภาพประกอบให้ทุกโพสต์
การรักษาความสอดคล้องทางภาพสำหรับซีรีส์ 200 หน้า
ความล้มเหลวที่ตรงข้ามกับความซ้ำซากคือความไม่สอดคล้องกัน: ยี่สิบหน้าในกลุ่มหัวข้อเดียวกัน
แต่ละหน้ามีภาพที่ถูกต้องตามหลักเทคนิค แต่อยู่ในสไตล์ภาพที่ต่างกันยี่สิบแบบ ทางแก้คือ
endpoint เดียว — GET /photos/{id}/similar — รันครั้งเดียวบนภาพที่คุณอนุมัติ
สำหรับหน้าหลัก:
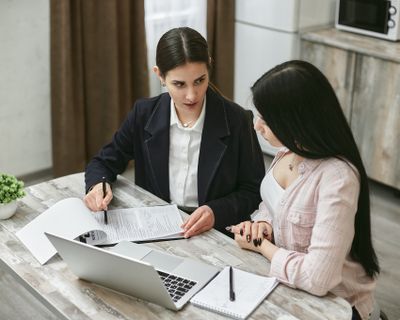
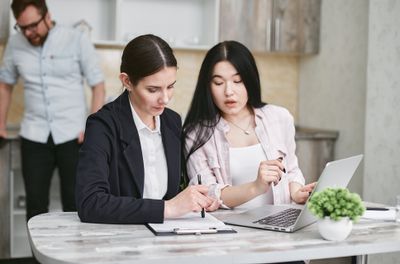
ยังมีอีกสองตัวช่วยที่ควรต่อเข้ากับคำถามพูลเมื่อความสม่ำเสมอของแบรนด์เป็นข้อกำหนด:
color_hex ร่วมกับ color_tolerance ทำให้ทั้งเว็บไซต์อยู่ในโทนสี
เดียวกัน และ photographer ตรึงกลุ่มหัวข้อไว้กับผลงานของช่างภาพคนเดียว ทั้งสอง
ตัวเป็นพารามิเตอร์คำถามธรรมดา — ไม่มีการจำกัดตามแผนสำหรับตัวกรองการค้นหา
Rate limit, โควตา และต้นทุนที่แท้จริง
เลือกแผนตาม burst ไม่ใช่ตามปริมาณ เมื่อคุณเริ่มทำพูลแล้ว โควตารายเดือน จะเลิกเป็นข้อจำกัดสำหรับเกือบทุกคน สิ่งที่ตัดสินแผนของคุณคือความเร็วที่การรีเฟรชแบบเต็ม ต้องเสร็จสิ้น
| แผน | คำขอ / เดือน= กลุ่มหัวข้อที่รีเฟรชได้ | Rate limit | API keys | รีเฟรช 1,000 กลุ่มหัวข้อเวลาจริง หนึ่งรอบ |
|---|---|---|---|---|
| Free — $0 | 5,000 | 20 / นาที | 1 | 50 min |
| Starter — $5 | 25,000 | 30 / นาที | 3 | 34 min |
| Pro — $19 | 100,000 | 60 / นาที | 5 | 17 min |
| Team — $99เอเจนซี: หนึ่งคีย์ต่อลูกค้าหนึ่งราย | 500,000 | 200 / นาที | 25 | 5 min |
| Business — $249 | 1,000,000 | 300 / นาที | unlimited | 4 min |
| Enterprise — $599 | 2,000,000 | 500 / นาที | unlimited | 2 min |
อ่านคอลัมน์แรกในเชิง กลุ่มหัวข้อ: คำขอเติมพูลหนึ่งครั้งเติมพูลได้หนึ่งกลุ่มหัวข้อ ดังนั้นโควตารายเดือนจึงเป็นจำนวนกลุ่มหัวข้อที่คุณสามารถรีเฟรชได้ และคอลัมน์สุดท้ายคือ ระยะเวลาที่การผ่านเว็บไซต์ 1,000 กลุ่มหัวข้อครบหนึ่งรอบใช้เวลาเท่าไรที่ rate limit ของแผนนั้น ทั้งสองค่าเป็นค่าจริงจากแคตตาล็อกราคา — หน้าราคาระบุ rate limit เดียวกันเป็นต่อชั่วโมง แทนที่จะเป็นต่อนาที
ดังนั้นเว็บไซต์ที่เผยแพร่ 10,000 หน้าต่อเดือนด้วยรูปแบบพูลจะใช้คำขอประมาณ 500 ครั้ง และจ่าย ไม่มีค่าใช้จ่าย สิ่งที่ผลักดันให้ทีมต้องขยับขึ้นไปในตารางนั้นแทบจะไม่ใช่ ปริมาณ แต่เป็นหนึ่งในสามสิ่งนี้: การใส่ภาพประกอบใหม่ทั้งหมดของเว็บไซต์ที่มีอยู่แล้วในคืนเดียว, การแยกคีย์ต่อลูกค้า (เอเจนซีต้องการหนึ่งคีย์ต่อลูกค้าหนึ่งราย เพื่อให้การใช้งานสามารถ ตรวจสอบย้อนกลับได้โดยไม่ต้องใช้เทคนิคแบ่งปันความลับ), หรือ build window ที่วัดเป็นนาที แทนที่จะเป็นชั่วโมง
รายละเอียดปฏิบัติการสองอย่างที่ช่วยประหยัดคืนหนึ่งของการดีบั๊ก ทุก response มี
X-RateLimit-Limit และ X-RateLimit-Remaining ดังนั้น worker
สามารถกำหนดจังหวะตัวเองได้แทนที่จะเดาสุ่ม และ 429 ที่เป็น rate limit
ต่อนาทีจริง ๆ จะมี Retry-After มาด้วย ในขณะที่การบล็อกโควตารายเดือนจะ
ไม่มี โดยเจตนา — การลองใหม่จะไม่ทำให้แบบนั้นหายไป และ worker ที่แยกแยะสอง
กรณีนี้ออกจากกันได้จะหยุดยิงซ้ำ ๆ ที่ endpoint ที่ไม่มีอะไรเหลือให้แล้ว
เมื่อ agent เป็นผู้เผยแพร่เอง
หากเนื้อหาของคุณผลิตโดย agent — และที่ปริมาณระดับนี้ก็เป็นเช่นนั้นมากขึ้นเรื่อย ๆ — ชั้น
การทำพูลจะไม่หายไป แต่ย้ายที่ ให้เครื่องมือค้นหาแก่ agent แล้วมันจะเติมพูลในขณะที่
ยังคงถือโจทย์ของกลุ่มหัวข้ออยู่ใน context โดยใช้เซิร์ฟเวอร์
Model Context Protocol ที่ mcp.pexafy.com/mcp: สามเครื่องมือ
ได้แก่ search_photos (หนึ่งประโยค), search_photos_by_image
(ภาพอ้างอิงหนึ่งภาพ อาจเสริมด้วยประโยคก็ได้) และ get_similar_photos (ตัวสร้าง
ความสอดคล้องของซีรีส์จากด้านบน)
# Claude Code / CI runner
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# หรือ commit .mcp.json เพื่อให้ worker ทุกตัวในฟลีทสืบทอดค่านี้
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
คำสั่งที่ใช้งานได้ในระดับ scale คือคำสั่งแบบชุด (batch) ไม่ใช่แบบต่อบทความ — และมันจับคู่ กับสองเฟสด้านบนได้อย่างพอดี:
You  นี่คือ 12 กลุ่มหัวข้อจากปฏิทินเนื้อหา สำหรับแต่ละกลุ่ม
     เขียนโจทย์ถ่ายภาพหนึ่งโจทย์ ดึงภาพแนวนอน 100 ภาพ และเขียน
     พูลลงใน Postgres ทำเครื่องหมายกลุ่มหัวข้อใดที่คืนผลลัพธ์ต่ำกว่า 40
     รายการที่มีคะแนนเกิน 0.5 — โจทย์เหล่านั้นต้องเขียนใหม่

Agent  → search_photos(q="a woman signing paperwork with an insurance
           agent at a kitchen table in her home", orientation="landscape")
      ← 100 ภาพ · 122 ms · 87 ภาพเกินเกณฑ์
      … อีก 11 กลุ่มหัวข้อ …

      ✓ เขียนพูล 11 พูลแล้ว (1,043 ภาพ มีเครดิตทั้งหมด)
      ⚠ "การปรับสมดุลกองทุนดัชนี" → 12 ผลลัพธ์ โจทย์นี้เป็นนามธรรมเกินไป
        ขอเสนอ: "คนคนหนึ่งที่โต๊ะครัวกำลังตรวจสอบตัวเลขบนแล็ปท็อป
        โดยมีสมุดบันทึกและกาแฟวางอยู่ข้างกัน"
บรรทัดสุดท้ายนั้นคือเหตุผลที่ควรให้ agent อยู่ในลูปนี้แทนที่จะเป็นสคริปต์: รูปแบบความ ล้มเหลวของการใส่ภาพประกอบแบบ programmatic คือโจทย์ที่ไม่ดี และโจทย์ที่ไม่ดีก็คือสิ่งที่ language model สามารถสังเกตเห็นและเขียนใหม่ได้พอดี ส่วนสคริปต์ยังคงเป็นผู้รับผิดชอบการ จัดสรร ซึ่งเป็นจุดที่ความแน่นอน (determinism) สำคัญ และความคิดสร้างสรรค์ไม่จำเป็น
สิ่งที่ภาพถ่ายแก้ไขไม่ได้
หัวข้อที่พูดตรง ๆ เพราะความล้มเหลวที่มันอธิบายนั้นมีราคาแพง ภาพถ่ายจริงที่มีเครดิตช่วยยกระดับ หน้าเพจ แต่มันไม่ได้เปลี่ยนเนื้อหาบางเบาให้กลายเป็นเนื้อหาที่ดี และไม่มีไปป์ไลน์ภาพใดเปลี่ยน วิธีที่เสิร์ชเอนจินปฏิบัติต่อหน้าที่ผลิตจำนวนมากซึ่งมีอยู่เพื่อให้ติดอันดับมากกว่าเพื่อช่วยเหลือ ผู้อ่าน นโยบายสแปมของ Google ระบุเรื่องนี้ไว้โดยตรง: scaled content abuse ครอบคลุม การสร้างหลายหน้าที่มีคุณค่าน้อย ไม่ว่าจะมีระบบอัตโนมัติเข้ามาเกี่ยวข้องหรือไม่ก็ตาม และคุณภาพของภาพประกอบบนหน้าเหล่านั้นไม่เกี่ยวข้องกับการตัดสินนั้นเลย2
ดังนั้นกรอบความคิดที่มีประโยชน์นั้นแคบและเป็นจริง: ภาพถ่ายคือ สัญญาณด้านคุณภาพที่คุณ ควบคุมได้ บนหน้าที่สมควรมีอยู่แล้ว จุดที่มันพิสูจน์แล้วว่าคุ้มค่า:
- ที่มาที่ผู้อ่านตรวจสอบได้ บรรทัดเครดิตที่มีชื่อช่างภาพและ URL ต้นทาง คือคำกล่าวอ้างที่ตรวจสอบได้ — ตรงข้ามกับภาพที่ไม่มีเครดิตบนหน้าที่ไม่มีผู้เขียนระบุตัวตน
- การเข้าถึงและ Core Web Vitals
width/heightจาก response ช่วยกำจัด layout shift,blur_hashให้ placeholder ที่แท้จริง และalt_descriptionคือร่างของ alt text ที่เทมเพลตของคุณสามารถปรับปรุงได้ แทนที่จะต้องคิดขึ้นเอง คูณด้วย 40,000 ช่องภาพ นี่คือเรื่องราวคุณภาพภาพทั้งหมดของเว็บไซต์ - ไม่ดูเหมือนผลิตแบบจำนวนมาก การกำจัดภาพซ้ำและความสอดคล้องของซีรีส์คือ สิ่งที่หยุดไม่ให้เว็บไซต์มี “ลายเซ็นทางภาพ” นี่คือต้นทุนด้านการรับรู้ที่แท้จริงพร้อมผลกระทบ ที่แท้จริง และอยู่ในการควบคุมของคุณทั้งหมด
และใบอนุญาตยังคงควบคุมภาพนั้นอยู่ การให้เครดิตไม่ได้ถูกกำหนดโดยข้อกำหนดของ Pexafy API —
ทุกผลลัพธ์มาพร้อม attribution.html และ attribution.plain ที่พร้อม
เรนเดอร์แล้ว — แต่ใบอนุญาตที่ผูกติดกับคลังภาพต้นทางนั้นยังคงมีผลกับการใช้งานภาพนั้นของคุณ
และที่ 40,000 ภาพต่อเดือน การเรนเดอร์เครดิตโดยอัตโนมัติย่อมถูกกว่าการตรวจสอบย้อนหลัง
จะเริ่มต้นวันจันทร์ตรงไหน
- จัดกลุ่มงานค้างของคุณเป็นกลุ่มหัวข้อ ละ 15–30 หน้าที่พอจะใช้ภาพถ่ายชุด เดียวกันร่วมกันได้จริง นี่คือขั้นตอนแบบแมนวลจริง ๆ เพียงขั้นตอนเดียว และมันคือสเปรดชีต ไม่ใช่โปรเจกต์ใหญ่
- เขียนโจทย์ถ่ายภาพหนึ่งโจทย์ต่อหนึ่งกลุ่มหัวข้อ — หนึ่งฉาก 12 ถึง 25 คำ ให้โมเดลสร้างโจทย์เหล่านี้ แล้วอ่านมันดู โจทย์ที่ระบุหัวข้อแทนที่จะเป็นฉากจะสังเกตเห็นได้ ในทันที
- เติมพูลหนึ่งพูล ด้วยคำขอ
per_page=100เพียงครั้งเดียว แล้วดูส่วนหัวของมัน หากสิบอันดับแรกใช้งานไม่ได้ ปัญหาอยู่ที่โจทย์ ไม่ใช่ที่เอนจิน - เพิ่มคอลัมน์
used_by_pageก่อนเผยแพร่อะไรก็ตาม ตอนนี้ใช้ เวลาห้านาที แต่ทีหลังจะกลายเป็นการ migration ทั่วเว็บไซต์ที่มีหน้าใช้งานจริง 3,000 หน้า - รันทั้งหมดนี้บนแผนฟรี จนกว่า build window จะบังคับให้คุณต้องขยับขึ้น ที่ 500 คำขอต่อเดือน จะใช้เวลาสักพักใหญ่
อ้างอิงและเชิงอรรถ
1 EU AI Act มาตรา 50 — ข้อผูกพันด้านความโปร่งใสที่มีผลบังคับใช้ ตั้งแต่ 2 สิงหาคม 2026: ผู้ให้บริการระบบที่สร้างภาพ เสียง วิดีโอ หรือข้อความสังเคราะห์ ต้องทำเครื่องหมายผลลัพธ์ในรูปแบบที่เครื่องอ่านได้ และทำให้สามารถตรวจจับได้ว่าเป็นสิ่งที่ สร้างขึ้นโดยปัญญาประดิษฐ์ มาตรานี้ผูกพันผู้ให้บริการและผู้ใช้งาน AI ไม่ใช่กฎเกี่ยวกับว่าเว็บไซต์ หนึ่งจะเผยแพร่ภาพใดได้บ้าง
2 นโยบายสแปมของ Google Search — scaled content abuse: การสร้างหลายหน้าโดยมีจุดประสงค์หลักเพื่อบิดเบือนอันดับและมอบคุณค่าเพียงเล็กน้อยแก่ผู้ใช้ ไม่ว่าจะสร้างขึ้นด้วยระบบอัตโนมัติ ความพยายามของมนุษย์ หรือทั้งสองอย่างรวมกัน คุณภาพของ ภาพประกอบไม่ใช่ปัจจัยหนึ่งในการประเมินนั้น ซึ่งเป็นเหตุผลว่าทำไมบทความนี้จึงแยกสองเรื่องนี้ ออกจากกัน
ตรวจสอบแหล่งที่มาเมื่อวันที่ 17 สิงหาคม 2026: นโยบายสแปมของ Google Search · AI Act มาตรา 50 · เอกสาร Pexafy API & MCP ขีดจำกัดของแผนคือค่าจริงจากตารางราคาของ Pexafy ส่วนเวลาการค้นหา (122 ms, 48 ms) และทุกภาพที่แสดงล้วนเป็น response ของ API จริงที่บันทึกไว้ในวันเดียวกัน
คำถามที่พบบ่อย
ฉันจะหาภาพสำหรับหน้า Programmatic SEO นับพันได้อย่างไร?
GET /api/v1/search/photos ด้วย per_page=100 จะคืนภาพถ่ายที่มีเครดิตได้สูงสุด 100 ภาพต่อหนึ่งกลุ่มหัวข้อ คุณเก็บภาพเหล่านั้นไว้ในตาราง Pool แล้วจัดสรรทีละภาพให้แต่ละหน้าตอนเผยแพร่ ระบบที่มี 10,000 หน้าต่อเดือนและใช้ 4 ภาพต่อหน้า ต้องใช้เพียงประมาณ 500 คำขอ แทนที่จะเป็น 40,000 คำขอ ซึ่งอยู่ในขอบเขตของแผนฟรี (5,000 คำขอ/เดือน)Stock Photo API ตัวไหนดีที่สุดสำหรับการผลิตเนื้อหาปริมาณมาก?
ฉันจะหยุดไม่ให้ภาพ Stock เดียวกันปรากฏซ้ำในหลายหน้าได้อย่างไร?
photo_id ของทุกภาพที่คุณเผยแพร่ และดึงภาพจาก Pool แบบ Transactional — ในภาษา SQL คือ UPDATE … WHERE used_by_page IS NULL … FOR UPDATE SKIP LOCKED การกันภาพซ้ำจะกลายเป็นเรื่องแน่นอนแทนที่จะเป็นเพียงความน่าจะเป็น และ Worker ที่ทำงานแบบขนานจะไม่แย่งภาพอันดับต้นๆ ภาพเดียวกัน มันเป็นเพียงคอลัมน์เดียว และการเพิ่มมันย้อนหลังในหน้าที่เผยแพร่ไปแล้วนับพันหน้านั้นมีต้นทุนสูงกว่าการเพิ่มมันตั้งแต่วันแรกมากหนึ่งคำขอ API สามารถคืนภาพได้กี่ภาพ?
per_page=100 และการแบ่งหน้าด้วย Cursor ช่วยให้คุณเดินหน้าต่อในชุดผลลัพธ์ที่จัดอันดับเดียวกันเพื่อสร้าง Pool ที่ลึกขึ้น รวมมันเข้ากับ score_threshold เพื่อให้กลุ่มหัวข้อที่มีข้อมูลน้อยคืนภาพที่ตรงประเด็นจริงๆ 40 ภาพแทนที่จะเป็น 100 ภาพที่หลวมๆ และใช้ fields เพื่อคืนเฉพาะ Attribute ที่เทมเพลตของคุณต้องแสดงผล ซึ่งช่วยให้ Response มีขนาดเล็กเมื่อใช้งานปริมาณมากภาพถ่ายจริงช่วยให้หน้าที่ผลิตแบบสเกลใหญ่มีอันดับดีขึ้นหรือไม่?
AI Agent สามารถเติมภาพลงใน Pool ได้โดยอัตโนมัติหรือไม่?
mcp.pexafy.com/mcp ซึ่งเปิดให้ใช้ search_photos, search_photos_by_image และ photo_similar ให้รายการกลุ่มหัวข้อแก่ Agent แล้วมันจะเขียน Camera Brief ให้ทีละหนึ่งรายการ ดึง Pool ภาพ และตั้งข้อสังเกตกับ Brief ที่คืนภาพที่ตรงประเด็นจริงมาน้อยเกินไป — ซึ่งเป็นจุดที่การทำภาพประกอบแบบ Programmatic มักล้มเหลวจริงๆ ส่วนการจัดสรรภาพยังคงอยู่ในสคริปต์ของคุณ ที่ซึ่งความแน่นอนสำคัญกว่าความคิดสร้างสรรค์

