Ilustre 10.000 páginas por mês com fotos reais — em 500 chamadas de API
Busque uma vez por cluster de tópicos em vez de uma vez por imagem, e 40.000 chamadas de API viram 500. O padrão de pool e atribuição, o worker que sobrevive aos rate limits e uma seção honesta sobre o que as fotografias não resolvem.
 Marouane Tijani
12 min de leitura

Existe uma versão do problema de ilustração de conteúdo que nenhum bom gosto resolve: você não está escolhendo uma foto, está preenchendo 40.000 espaços de imagem por mês em 800 clusters de temas, 9 idiomas e 14 sites de clientes, e cada um deles precisa estar licenciado, creditado, dimensionado e diferente do vizinho. Nesse volume a pergunta deixa de ser “qual foto?” e passa a ser “qual é a arquitetura?”
Este artigo é a resposta via API: o padrão de requisição que reduz a contagem de chamadas em duas ordens de grandeza, o worker que sobrevive a limites de taxa, a deduplicação que impede um site de 10.000 páginas de parecer uma parede da mesma foto de banco de imagens — e uma seção honesta sobre o que as imagens não podem fazer por você.
O verdadeiro gargalo com 10.000 artigos
Equipes que publicam em volume — estruturas de SEO programático, páginas de categoria de marketplace, agregadores, redes de afiliados, agências que rodam conteúdo para um portfólio de clientes, pipelines de localização que transformam um artigo em 20 — esbarram todas nos mesmos três muros, na mesma ordem:
- Contagem de chamadas. Uma busca por espaço de imagem significa 40.000 chamadas de API para 10.000 artigos de quatro imagens. Todo provedor precifica, limita e avalia você por esse número.
- Repetição. Por volta da página trinta, a mesma foto começa a reaparecer. Na página três mil, seu site tem uma assinatura visual: gerado em massa.
- Coordenação. Cem artigos de um cluster deveriam parecer uma série, não cem quadros do Pinterest sem relação — e o idioma seguinte do mesmo artigo deveria reutilizar a mesma imagem, não buscar de novo em outro idioma.
Note o que não está nessa lista: encontrar uma boa foto. Um motor semântico retorna uma página de candidatos utilizáveis em cerca de 130 milissegundos. A recuperação foi resolvida; a distribuição não. Tudo abaixo é sobre distribuição.
Por que fotos reais, especificamente neste volume
O argumento a favor da fotografia em vez da geração fica mais forte conforme o volume cresce, por razões que são majoritariamente operacionais e não estéticas.
| Com 40.000 imagens/mês | Gerando-as | Buscando-as |
|---|---|---|
| Tempo por imagem | Segundos a minutos, mais as tentativas descartadas | Uma requisição (~130 ms) cobre um cluster inteiro |
| Fator de custo | Por imagem, para sempre | Por requisição — e uma requisição atende ~25 artigos |
| Metadados que você recebe | Nenhum. Você escreve o texto alternativo e as dimensões por conta própria | Dimensões, cor dominante, blur hash, rascunho de legenda, linha de crédito |
| Procedência | Marcada por máquina como sintética sob o EU AI Act desde 2 de agosto de 20261 | Um fotógrafo nomeado, uma data, uma URL de origem que o leitor pode abrir |
| Modo de falha | Detalhes plausíveis, porém errados, estilo uniforme da casa | Nada correspondeu ao briefing — você recebe zero resultados, o que dá para tratar |
A linha dos metadados é a que decide pipelines. Todo resultado de busca já carrega
width, height, blur_hash, color_hex,
alt_description e uma string attribution.html pronta — que é
exatamente o payload de que um motor de templates precisa para emitir uma
<img> sem deslocamento de layout, com placeholder e crédito. Imagens geradas entregam um arquivo e
deixam os outros seis campos para você inventar.
Onde a geração ainda vence em escala. Ilustração em nível de categoria para taxonomias abstratas (“migração para a nuvem”, “fundos de índice”), diagramas e um estilo da casa que você quer repetido por toda uma estrutura por razões de marca. A divisão à qual a maioria dos grandes publishers chega: fotografias para tudo que existe no mundo, arte gerada para tudo que só existe em um argumento. Defendemos essa divisão por completo em como ilustrar todo artigo que você publica.
Uma requisição, cem fotos
Esta é a única mudança que reconfigura a aritmética. O endpoint de busca aceita
per_page até 100, e a paginação por cursor permite continuar percorrendo o
mesmo conjunto de resultados ranqueado. Então a unidade de trabalho não é uma imagem, é um pool.
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a woman signing paperwork with an insurance agent at a kitchen table in her home" \
  --data-urlencode "per_page=100" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "score_threshold=0.5" \
  --data-urlencode "fields=photo_id,urls,width,height,blur_hash,alt_description,attribution"

# → { "success": true, "data": [ …até 100 fotos… ],
#     "pagination": { "per_page": 100, "has_more": true, "next_cursor": "eyJyc…" },
#     "meta": { "took_ms": 122.33, "request_id": "7ff1fb9b-…" } }
Três parâmetros ali fazem um trabalho silencioso em escala:
fields— um conjunto esparso de campos. Peça os sete campos que seu template renderiza e a resposta para de enviar a longa descrição por IA de cada foto. Em 40.000 fotos, essa é a diferença entre um build que flui e um que engasga.score_threshold— a cauda de uma página de 100 resultados é, por definição, menos relevante que o topo. Definir um piso significa que um cluster raso retorna 34 fotos em vez de 100 medíocres, e seu pipeline pode reagir a isso em vez de publicá-las.next_cursor— quando um cluster realmente precisa de 300 fotos, pagine o mesmo conjunto ranqueado em vez de disparar três consultas diferentes que se sobrepõem.
E aqui está a aritmética, para um site que publica 10.000 páginas por mês com quatro imagens cada:
| Estratégia | Requisições / mês | Uma passada no limite de taxa do plano gratuito20 req/min | Cabe na cota mensal gratuita? |
|---|---|---|---|
| Uma busca por espaço de imagem | 40.000 | 33 hours | Não — um plano pago |
| Uma busca por artigo | 10.000 | 8 hours | Não — um plano pago |
| Uma busca por cluster de ~20 artigoso padrão deste artigo | 500 | 25 minutes | Sim |
As mesmas 40.000 imagens publicadas nas três linhas. A única coisa que mudou é onde o laço está.
Agrupar e atribuir: o padrão que escala
A arquitetura inteira são duas fases que rodam em frequências diferentes, com uma tabela entre elas:
                     ┌────── roda semanalmente, ~500 requisições ───────┐
  clusters de temas ──▶ POOL   busca uma vez por cluster, per_page=100
                     │       └─▶ armazena 100 linhas de fotos por cluster
                     └──────────────────┬───────────────────────────────┘
                                        ▼
                              tabela image_pool
                        (cluster, photo_id, urls, blur_hash,
                         alt, credit, used_by_page, used_at)
                                        │
                     ┌────────────┴──── roda a cada publicação, 0 requisições ───┐
  artigo ─────────▶ ASSIGN  escolhe a melhor linha não usada deste
                     │        cluster, marca como usada, renderiza
                     └────────────────────────────────────────────────────────┘
O que isso lhe dá, em ordem de quanto importa em volume:
- A publicação nunca fica bloqueada por uma API. A atribuição é uma leitura de banco. Seu hook de salvamento do CMS, seu build estático e sua importação em massa das 3 da manhã rodam todos em velocidade local, offline, sem limite de taxa em nenhum ponto do caminho.
- A deduplicação é gratuita e exata.
used_by_page IS NULLé o recurso inteiro. Duas páginas não podem pegar a mesma foto, porque a atribuição é uma transação, não uma heurística de ranqueamento. - Reexecuções são baratas e idempotentes. Atualize o pool de um cluster quando ele estiver acabando
ou quando você quiser fotografias mais recentes (
after_date, ousort_by=newest) — uma requisição, e nada já publicado se move. - Os idiomas vêm de graça. As 20 traduções de um artigo são uma página em
seu modelo com 20 renderizações; elas compartilham o
photo_idatribuído e você nunca busca duas vezes. Quando você realmente quiser um visual local, rode a consulta do pool para aquele cluster no idioma de destino — o motor aceita uma frase em mais de 100 deles.
O worker, em código
Cerca de sessenta linhas. O preenchedor do pool é a única parte que fala com a rede, então é a
única parte que precisa ter cuidado — concorrência limitada, 429 respeitado, resultados
gravados em uma transação.
import asyncio, os, time, httpx

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
KEY    = os.environ["PEXAFY_API_KEY"]
FIELDS = "photo_id,urls,width,height,blur_hash,alt_description,attribution"

# Free = 20 req/min. Fique um abaixo. O pacer é GLOBAL: um sleep por tarefa
# dentro do gate de concorrência deixaria N workers disparar N× a taxa.
PER_MIN = 19
gate    = asyncio.Semaphore(4)         # conexões em voo
_lock   = asyncio.Lock()
_slot   = 0.0                          # próximo momento livre na linha do tempo

async def pace():
    """Distribui um slot de requisição a cada 60/PER_MIN segundos, para toda a frota."""
    global _slot
    async with _lock:
        now  = time.monotonic()
        _slot = max(now, _slot) + 60 / PER_MIN
        wait  = _slot - now
    if wait > 0:
        await asyncio.sleep(wait)

class QuotaExhausted(Exception): ...   # mensal: repetir não ajuda

async def fill_pool(client, cluster) -> list[dict]:
    """Uma requisição → até 100 fotos creditadas para um cluster de tema."""
    for attempt in range(4):
        await pace()
        async with gate:
            r = await client.get(
                SEARCH,
                headers={"X-Api-Key": KEY},
                params={
                    "q": cluster["camera_brief"],   # uma cena, não a palavra-chave
                    "per_page": 100,
                    "orientation": "landscape",
                    "score_threshold": 0.5,
                    "fields": FIELDS,
                },
                timeout=15,
            )
        if r.status_code == 429:
            retry_after = r.headers.get("Retry-After")
            if retry_after is None:            # sem Retry-After ⇒ cota mensal,
                raise QuotaExhausted(cluster["id"])   # pare a execução toda
            await asyncio.sleep(int(retry_after))   # por minuto: isso passa
            continue
        r.raise_for_status()
        return r.json()["data"]
    return []                                  # registre; o pool mantém suas linhas antigas

async def refill(clusters):
    async with httpx.AsyncClient(http2=True) as client:
        pools = await asyncio.gather(*(fill_pool(client, c) for c in clusters))
    for cluster, photos in zip(clusters, pools):
        db.upsert_pool(cluster["id"], photos)     # ON CONFLICT DO NOTHING em photo_id
Dois detalhes ali são a diferença entre um worker que roda sem supervisão e um que
acorda você. O pacer é global, não por tarefa: colocar o sleep dentro do
gate de concorrência é o erro clássico — quatro workers pausando 3 segundos cada após sua
própria requisição produzem quatro requisições a cada 3 segundos, cerca de 75 por minuto, e o plano gratuito
começa a retornar 429 imediatamente. E os dois 429 não são o mesmo
animal: o por minuto carrega Retry-After e se resolve sozinho, o de cota mensal
não o carrega e nunca carregará — repetir esse é um laço contra a parede.
A atribuição, a parte que roda a cada publicação, nunca toca a rede:
# A unicidade é garantida pelo esquema, não por a consulta ser cuidadosa.
# Uma foto pode estar em vários pools de clusters; ela só pode ser PUBLICADA uma vez.
# CREATE UNIQUE INDEX one_use_per_photo ON image_pool (photo_id)
#        WHERE used_by_page IS NOT NULL;

def assign_hero(page_id: str, cluster_id: str) -> dict | None:
    for _ in range(5):                # perder a corrida só pega a próxima foto
        try:
            return db.query_one("""
                UPDATE image_pool p SET used_by_page = %s, used_at = NOW()
                WHERE p.id = (
                    SELECT c.id FROM image_pool c
                    WHERE c.cluster_id = %s AND c.used_by_page IS NULL
                      AND NOT EXISTS (              -- usada por QUALQUER outro cluster?
                          SELECT 1 FROM image_pool u
                          WHERE u.photo_id = c.photo_id
                            AND u.used_by_page IS NOT NULL
                      )
                    ORDER BY c.rank ASC
                    LIMIT 1 FOR UPDATE SKIP LOCKED  -- seguro com workers paralelos
                )
                RETURNING photo_id, urls, width, height, blur_hash, alt, credit
            """, [page_id, cluster_id])
        except UniqueViolation:      # dois clusters a reivindicaram no mesmo ms
            continue
    return None                     # pool seco → amplie o briefing, reabasteça

# Renderização: todo atributo vem da linha — sem deslocamento de layout, sem chute.
# <img src="{urls[regular]}" width="{width}" height="{height}"
#      alt="{alt}" loading="lazy" style="background:{blur_placeholder}">
# <figcaption>{credit}</figcaption>
Dois modos de falha, dois mecanismos, e ambos são necessários. FOR UPDATE SKIP LOCKED
cuida da concorrência dentro de um cluster: gere páginas em paralelo — e nesse volume
você vai — e dois workers alcançam a mesma foto mais bem ranqueada no mesmo milissegundo.
O índice único parcial cuida daquilo que todo mundo esquece: a mesma foto aparece legitimamente
nos pools de vários clusters, porque clusters vizinhos (“seguro residencial para
inquilinos”, “…para proprietários”) retornam resultados sobrepostos. Uma verificação
used_by_page IS NULL por cluster é cega a isso — cada cluster acredita que a foto está
livre. O NOT EXISTS mantém a consulta honesta, e o índice torna impossível
errar sob concorrência: quem perde a corrida recebe uma violação, tenta de novo e pega a próxima
foto. Sem ele, “nenhuma dupla de páginas compartilha uma imagem principal” é uma alegação, não uma garantia.
Quando um pool seca no meio do build, o fallback que se comporta melhor é ampliar em vez de repetir: remova a última cláusula do briefing de câmera, rode a consulta do pool mais uma vez e só então reutilize a foto atribuída há mais tempo — com a regra rígida de que ela nunca caia em uma página do mesmo cluster.
Um cluster, um pool: uma consulta real
Tome uma estrutura de comparação: seguro residencial, vinte páginas — “seguro residencial para inquilinos”, “…para proprietários”, “o que uma apólice realmente cobre”, doze páginas de cidades, três guias de sinistro. Um briefing de câmera para o cluster, uma requisição, e este é o topo do pool, retornado em 122 ms:
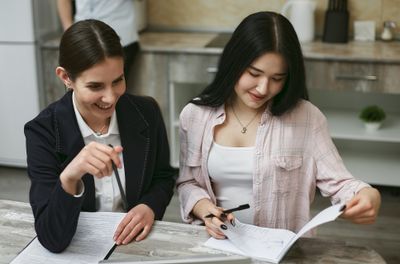
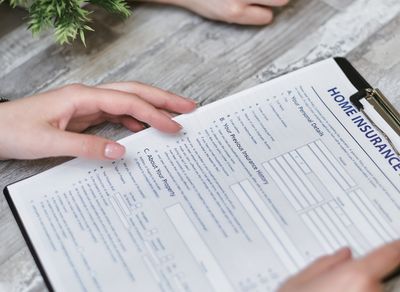
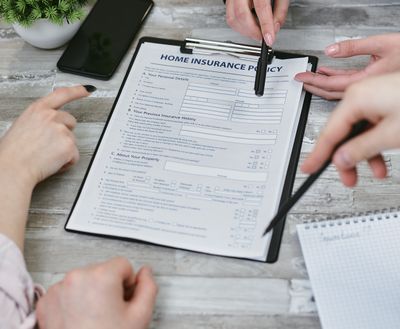
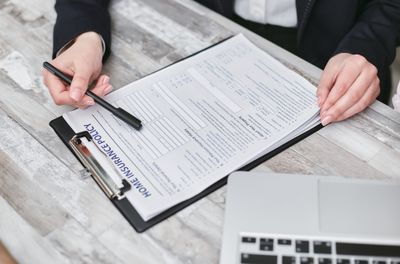
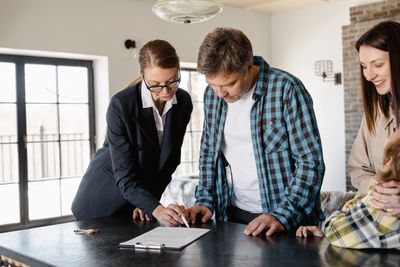
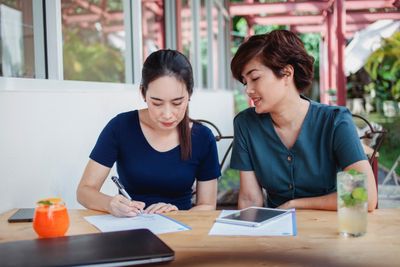
per_page=100 e guarda o resto.
Rode exatamente esta busca →
Os briefings importam mais que o código. Duas regras sobrevivem ao contato com uma estrutura real de clusters:
escreva o briefing para o cluster, não para a página (títulos de páginas são quase idênticos
em conjuntos programáticos, então briefings por página retornam fotos quase idênticas), e descreva uma cena
que uma câmera poderia ter capturado, em vez do tema — home insurance retorna close-ups de documentos
e nada mais. Publicamos o prompt pronto para copiar e colar que produz esses briefings em
o artigo sobre ilustrar cada post.
Mantendo uma série de 200 páginas visualmente coerente
A falha oposta à repetição é a incoerência: vinte páginas em um cluster, cada uma com uma
foto tecnicamente correta, em vinte registros visuais diferentes. A solução é um endpoint —
GET /photos/{id}/similar — executado uma vez sobre a foto que você aprovou para a página pilar:
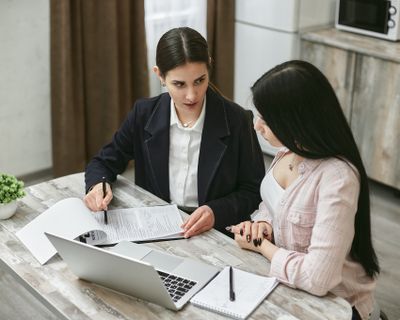
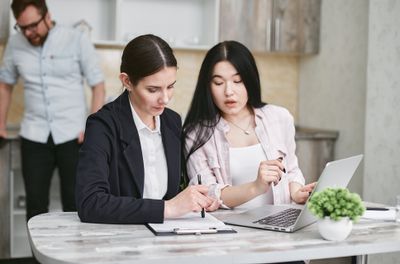
Mais duas alavancas que vale ligar à consulta do pool quando a consistência de marca é um requisito:
color_hex com um color_tolerance mantém uma estrutura inteira dentro de uma
paleta, e photographer fixa um cluster ao corpo de trabalho de um fotógrafo. Ambos
são parâmetros de consulta comuns — sem restrição de plano nos filtros de busca.
Limites de taxa, cotas e quanto isso custa de fato
Escolha o plano pelo pico, não pelo volume. Uma vez que você agrupa, a cota mensal deixa de ser a restrição para quase todo mundo; o que decide seu plano é quão rápido uma atualização completa precisa terminar.
| Plano | Requisições / mês= clusters atualizáveis | Limite de taxa | Chaves de API | Atualizar 1.000 clusterstempo de relógio, uma passada |
|---|---|---|---|---|
| Free — $0 | 5,000 | 20 / min | 1 | 50 min |
| Starter — $5 | 25,000 | 30 / min | 3 | 34 min |
| Pro — $19 | 100,000 | 60 / min | 5 | 17 min |
| Team — $99agências: uma chave por cliente | 500,000 | 200 / min | 25 | 5 min |
| Business — $249 | 1,000,000 | 300 / min | unlimited | 4 min |
| Enterprise — $599 | 2,000,000 | 500 / min | unlimited | 2 min |
Leia a primeira coluna como clusters: uma requisição de pooling preenche um cluster, então a cota mensal é o número de clusters que você pode atualizar, e a última coluna é quanto tempo uma passada completa por uma estrutura de 1.000 clusters leva no limite de taxa daquele plano. Ambos são valores ao vivo do catálogo de preços — a página de preços indica os mesmos limites de taxa por hora em vez de por minuto.
Ou seja, uma estrutura de 10.000 páginas por mês no padrão agrupado gasta ~500 requisições e paga nada. O que empurra as equipes para cima na tabela raramente é volume — é uma de três coisas: uma reilustração completa de uma estrutura existente em uma noite, isolamento de chave por cliente (uma agência quer uma chave por cliente para que o uso seja atribuível sem ginásticas de segredo compartilhado), ou uma janela de build medida em minutos e não em horas.
Dois detalhes operacionais que poupam uma noite de depuração. Toda resposta carrega
X-RateLimit-Limit e X-RateLimit-Remaining, então um worker pode ritmar
a si mesmo em vez de adivinhar. E um 429 que é um limite de taxa por minuto de verdade carrega
Retry-After, enquanto um bloqueio de cota mensal deliberadamente não carrega — repetir
não vai resolver esse, e um worker que distingue os dois para de martelar um endpoint
que não tem mais nada a oferecer.
Quando o agente faz a publicação
Se seu conteúdo é produzido por um agente — e nesses volumes cada vez mais é — a camada de pooling
não desaparece, ela se move. Dê ao agente as ferramentas de busca e ele preenche o pool enquanto
ainda mantém o briefing do cluster no contexto, usando o servidor
Model Context Protocol em mcp.pexafy.com/mcp: três ferramentas,
search_photos (uma frase), search_photos_by_image (uma imagem de referência,
opcionalmente acompanhada de uma frase) e get_similar_photos (a de coerência de série vista acima).
# Claude Code / executor de CI
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# ou versione .mcp.json para que todo worker da frota o herde
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
A instrução que funciona em escala é uma instrução em lote, não uma por artigo — e ela mapeia um a um sobre as duas fases acima:
You  Aqui estão 12 clusters de temas do calendário de conteúdo. Para cada um,
     escreva um briefing de câmera, traga 100 fotos em paisagem e grave
     o pool no Postgres. Sinalize qualquer cluster que retorne menos de 40
     resultados acima de 0,5 — esses briefings precisam ser reescritos.

Agent  → search_photos(q="a woman signing paperwork with an insurance
           agent at a kitchen table in her home", orientation="landscape")
      ← 100 fotos · 122 ms · 87 acima do limiar
      … mais 11 clusters …

      ✓ 11 pools gravados (1.043 fotos, todas creditadas)
      ⚠ "index fund rebalancing" → 12 resultados. O briefing é abstrato;
        sugestão: "a person at a kitchen table checking figures on a
        laptop with a notebook and coffee beside them"
Essa última linha é a razão para colocar o agente nesse laço em vez de um script: o modo de falha da ilustração programática é um briefing ruim, e um briefing ruim é exatamente aquilo que um modelo de linguagem consegue notar e reescrever. Os scripts continuam responsáveis pela atribuição, onde o determinismo importa e a criatividade não.
O que as fotografias não podem consertar
Uma seção honesta, porque a falha que ela descreve é cara. Fotografia real e creditada melhora uma página. Ela não transforma conteúdo raso em bom conteúdo, e nenhum pipeline de imagens muda como os buscadores tratam páginas produzidas em massa que existem para ranquear em vez de ajudar. As políticas de spam do Google nomeiam isso diretamente: abuso de conteúdo em escala cobre a geração de muitas páginas com pouco valor com ou sem envolvimento de automação, e as ilustrações dessas páginas são irrelevantes para esse julgamento.2
Portanto o enquadramento útil é estreito e verdadeiro: fotografia é um sinal de qualidade que você controla em páginas que já merecem existir. Onde isso comprovadamente compensa:
- Procedência que o leitor pode verificar. Uma linha de crédito com o nome de um fotógrafo e uma URL de origem é uma alegação que pode ser checada — o oposto de uma imagem sem atribuição em uma página com um autor sem atribuição.
- Acessibilidade e Core Web Vitals.
width/heightda resposta eliminam o deslocamento de layout,blur_hashdá um placeholder de verdade ealt_descriptioné um rascunho de texto alternativo que seu template pode melhorar em vez de inventar. Multiplique por 40.000 espaços e essa é toda a história de qualidade de imagem do site. - Não parecer produzido em massa. Deduplicação e coerência de série são o que impedem uma estrutura de ter uma assinatura visual. Esse é um custo real de percepção com consequências reais, e está inteiramente sob seu controle.
E a licença continua regendo a imagem. A atribuição não é exigida pelos termos da API da Pexafy —
todo resultado traz attribution.html e attribution.plain prontos para
renderizar — mas a licença atribuída pela biblioteca original se aplica ao seu uso daquela foto, e
a 40.000 imagens por mês, renderizar o crédito automaticamente é mais barato do que auditar depois.
Por onde começar na segunda-feira
- Agrupe seu backlog em clusters de 15 a 30 páginas que plausivelmente poderiam compartilhar um ensaio fotográfico. Este é o único passo genuinamente manual, e é uma planilha, não um projeto.
- Escreva um briefing de câmera por cluster — uma cena, de 12 a 25 palavras. Gere-os com um modelo e depois leia; briefings que nomeiam um tema em vez de uma cena são visíveis de imediato.
- Preencha um pool com uma única requisição
per_page=100e observe o topo dele. Se os dez primeiros não forem utilizáveis, o briefing está errado — não o motor. - Adicione a coluna
used_by_pageantes de publicar qualquer coisa. São cinco minutos agora e uma migração em 3.000 páginas no ar depois. - Rode tudo no plano gratuito até que uma janela de build force a subida. A 500 requisições por mês, isso vai demorar.
Referências & notas de rodapé
1 EU AI Act, Artigo 50 — obrigações de transparência aplicáveis a partir de 2 de agosto de 2026: fornecedores de sistemas que geram imagem, áudio, vídeo ou texto sintéticos devem marcar as saídas em formato legível por máquina e torná-las detectáveis como artificialmente geradas. Isso vincula fornecedores e implantadores de IA; não é uma regra sobre quais imagens um site pode publicar.
2 Políticas de spam do Google Search — abuso de conteúdo em escala: gerar muitas páginas primariamente para manipular rankings e oferecer pouco valor aos usuários, sejam elas criadas por automação, esforço humano ou uma combinação. A qualidade da ilustração não é um fator nessa avaliação, e é precisamente por isso que este artigo separa as duas coisas.
Fontes verificadas em 17 de agosto de 2026: Políticas de spam do Google Search · Artigo 50 do AI Act · Documentação da API & MCP da Pexafy. Os limites dos planos são os valores ao vivo da tabela de preços da Pexafy; os tempos de busca (122 ms, 48 ms) e cada foto exibida são respostas reais da API capturadas no mesmo dia.
Perguntas frequentes
Como consigo imagens para milhares de páginas de SEO programático?
GET /api/v1/search/photos com per_page=100 retorna até 100 fotos creditadas para um cluster; você as armazena em uma tabela de pool e atribui uma por página no momento da publicação. Um conjunto de 10.000 páginas por mês com quatro imagens por página precisa de cerca de 500 requisições em vez de 40.000, o que cabe no plano gratuito (5.000 requisições/mês).Qual é a melhor API de fotos de banco para produção de conteúdo em alto volume?
Como evito que a mesma foto de banco apareça em várias páginas?
photo_id de cada imagem publicada e reivindique as fotos do pool de forma transacional — em SQL, um UPDATE … WHERE used_by_page IS NULL … FOR UPDATE SKIP LOCKED. A deduplicação passa a ser exata em vez de probabilística, e workers de build paralelos não competem pela mesma foto mais bem ranqueada. É uma coluna só, e implantá-la depois em milhares de páginas no ar é muito mais caro do que adicioná-la no primeiro dia.Quantas fotos uma requisição de API pode retornar?
per_page=100, e a paginação por cursor permite continuar percorrendo o mesmo conjunto ranqueado para pools mais profundos. Combine com score_threshold para que um cluster escasso retorne 40 correspondências fortes em vez de 100 fracas, e com fields para retornar apenas os atributos que seu template renderiza, o que mantém as respostas pequenas em escala.Fotos reais ajudam páginas produzidas em escala a ranquear melhor?
Um agente de IA pode preencher um pool de imagens automaticamente?
mcp.pexafy.com/mcp, que expõe search_photos, search_photos_by_image e photo_similar. Dê ao agente uma lista de clusters e ele escreve um briefing fotográfico para cada um, puxa os pools e sinaliza os briefings que retornaram poucas correspondências fortes — que é o real modo de falha da ilustração programática. A atribuição continua nos seus scripts, onde o determinismo importa mais que a criatividade.

