Ilustrowanie 10 000 stron miesięcznie prawdziwymi zdjęciami — w 500 wywołaniach API
Wyszukuj raz na klaster tematyczny zamiast raz na obraz, a 40 000 wywołań API zamienia się w 500. Wzorzec pool-and-assign, worker odporny na limity zapytań i szczera sekcja o tym, czego zdjęcia nie naprawią.
 Marouane Tijani
12 min czytania

Istnieje wersja problemu ilustrowania treści, której nie rozwiąże żadna ilość dobrego gustu: nie wybierasz zdjęcia, tylko wypełniasz 40 000 miejsc na obrazy miesięcznie w 800 klastrach tematycznych, 9 lokalizacjach językowych i 14 witrynach klientów, a każde z nich musi być licencjonowane, opatrzone podpisem, przeskalowane i różne od sąsiedniego. Przy takiej skali pytanie przestaje brzmieć „które zdjęcie?”, a zaczyna brzmieć „jaka jest architektura?”
Ten artykuł to odpowiedź od strony API: wzorzec zapytań, który redukuje liczbę wywołań o dwa rzędy wielkości, worker odporny na limity żądań, deduplikacja, która nie pozwala serwisowi liczącemu 10 000 stron wyglądać jak ściana z tym samym zdjęciem stockowym — oraz szczery fragment o tym, czego zdjęcia zrobić nie mogą.
Prawdziwe wąskie gardło przy 10 000 artykułów
Zespoły publikujące na dużą skalę — programmatic SEO, strony kategorii marketplace'ów, agregatory, sieci afiliacyjne, agencje prowadzące treści dla portfolio klientów, pipeline'y lokalizacyjne zamieniające jeden artykuł w 20 — trafiają na te same trzy ściany, w tej samej kolejności:
- Liczba zapytań. Jedno wyszukiwanie na miejsce dla obrazu oznacza 40 000 wywołań API dla 10 000 artykułów po cztery zdjęcia. Każdy dostawca wycenia, ogranicza i weryfikuje cię na podstawie tej liczby.
- Powtarzalność. Mniej więcej na stronie trzydziestej to samo zdjęcie zaczyna się powtarzać. Na stronie trzy tysięcznej twój serwis ma sygnaturę wizualną: wygenerowano masowo.
- Koordynacja. Sto artykułów w jednym klastrze powinno wyglądać jak seria, a nie sto niepowiązanych tablic Pinteresta — a kolejna lokalizacja tego samego artykułu powinna ponownie użyć tego samego zdjęcia, nie wyszukiwać od nowa w innym języku.
Zwróć uwagę, czego nie ma na tej liście: znalezienia dobrego zdjęcia. Silnik semantyczny zwraca stronę wykorzystywalnych kandydatów w około 130 milisekund. Wyszukiwanie zostało rozwiązane; dystrybucja — nie. Wszystko poniżej dotyczy dystrybucji.
Dlaczego prawdziwe zdjęcia, zwłaszcza przy takiej skali
Argumenty za fotografią zamiast generowania stają się silniejsze wraz ze wzrostem skali, z powodów, które są głównie operacyjne, a nie estetyczne.
| Przy 40 000 zdjęć/miesiąc | Generowanie ich | Wyszukiwanie ich |
|---|---|---|
| Czas na jedno zdjęcie | Od sekund do minut, plus odrzucone próby | Jedno zapytanie (~130 ms) pokrywa cały klaster |
| Czynnik kosztowy | Za zdjęcie, na zawsze | Za zapytanie — a jedno zapytanie obsługuje ~25 artykułów |
| Otrzymywane metadane | Żadnych. Tekst alternatywny i wymiary piszesz sam | Wymiary, kolor dominujący, blur hash, szkic podpisu, informacja o autorstwie |
| Pochodzenie | Oznaczone maszynowo jako syntetyczne na mocy unijnego AI Act od 2 sierpnia 20261 | Nazwany fotograf, data, adres źródłowy, który czytelnik może otworzyć |
| Tryb awarii | Wiarygodne, lecz błędne detale, jednolity styl domowy | Nic nie pasowało do briefu — otrzymujesz zero wyników, co da się obsłużyć |
Wiersz z metadanymi decyduje o kształcie pipeline'ów. Każdy wynik wyszukiwania niesie już
width, height, blur_hash, color_hex,
alt_description i gotowy ciąg attribution.html — czyli dokładnie to,
czego potrzebuje silnik szablonów, aby wyemitować <img> bez przesunięcia
układu, z placeholderem i podpisem autorskim. Wygenerowane obrazy dają plik, a pozostałe sześć
pól musisz wymyślić sam.
Gdzie generowanie nadal wygrywa przy dużej skali. Ilustracje na poziomie kategorii dla abstrakcyjnych taksonomii („migracja do chmury”, „fundusze indeksowe”), diagramy oraz styl domowy, który chcesz powielić w całym serwisie z powodów wizerunkowych. Podział, do którego dochodzi większość dużych wydawców: fotografie dla wszystkiego, co istnieje w świecie, sztuka generowana dla wszystkiego, co istnieje tylko w argumentacji. Pełne uzasadnienie tego podziału przedstawiliśmy w artykule jak ilustrować każdy publikowany artykuł.
Jedno zapytanie, sto zdjęć
To pojedyncza zmiana, która przekształca całą arytmetykę. Punkt końcowy wyszukiwania przyjmuje
per_page do 100, a paginacja kursorowa pozwala kontynuować
przechodzenie po tym samym uszeregowanym zbiorze wyników. Jednostką pracy nie jest więc
obraz, tylko pula.
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a woman signing paperwork with an insurance agent at a kitchen table in her home" \
  --data-urlencode "per_page=100" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "score_threshold=0.5" \
  --data-urlencode "fields=photo_id,urls,width,height,blur_hash,alt_description,attribution"

# → { "success": true, "data": [ …do 100 zdjęć… ],
#     "pagination": { "per_page": 100, "has_more": true, "next_cursor": "eyJyc…" },
#     "meta": { "took_ms": 122.33, "request_id": "7ff1fb9b-…" } }
Trzy parametry wykonują tu cichą, lecz istotną przy skali pracę:
fields— rzadki zestaw pól (sparse fieldset). Poproś o siedem pól, które renderuje twój szablon, a odpowiedź przestanie wysyłać długi opis AI dla każdego zdjęcia. Przy 40 000 zdjęć to różnica między buildem, który płynie, a takim, który się zawiesza.score_threshold— koniec strony ze 100 wynikami jest z definicji mniej trafny niż jej początek. Ustawienie progu oznacza, że słabo obsadzony klaster zwróci 34 zdjęcia zamiast 100 przeciętnych, a twój pipeline może na to zareagować, zamiast to opublikować.next_cursor— kiedy klaster naprawdę potrzebuje 300 zdjęć, paginuj ten sam uszeregowany zbiór, zamiast wysyłać trzy różne, nakładające się zapytania.
A oto arytmetyka dla serwisu publikującego 10 000 stron miesięcznie, każda z czterema zdjęciami:
| Strategia | Zapytania / miesiąc | Jeden przebieg przy limicie planu darmowego20 zapytań/min | Mieści się w darmowym limicie miesięcznym? |
|---|---|---|---|
| Jedno wyszukiwanie na miejsce dla obrazu | 40 000 | 33 hours | Nie — plan płatny |
| Jedno wyszukiwanie na artykuł | 10 000 | 8 hours | Nie — plan płatny |
| Jedno wyszukiwanie na klaster ~20 artykułówwzorzec z tego artykułu | 500 | 25 minutes | Tak |
Te same 40 000 opublikowanych zdjęć we wszystkich trzech wierszach. Jedyne, co się zmieniło, to miejsce, w którym znajduje się pętla.
Pula i przypisanie: wzorzec, który się skaluje
Cała architektura to dwie fazy działające z różną częstotliwością, z tabelą pomiędzy nimi:
                     ┌─────────── działa co tydzień, ~500 zapytań ───────────┐
  klastry tematyczne ─▶ POOL   wyszukaj raz na klaster, per_page=100
                     │       └─▶ zapisz 100 wierszy zdjęć na klaster
                     └──────────────────┬───────────────────────────────┘
                                        ▼
                              tabela image_pool
                        (cluster, photo_id, urls, blur_hash,
                         alt, credit, used_by_page, used_at)
                                        │
                     ┌──────────────────┴──── działa przy każdej publikacji, 0 zapytań ───┐
  artykuł ─────────▶ ASSIGN  wybierz najlepszy nieużywany wiersz dla
                     │        tego klastra, oznacz jako użyty, wyrenderuj
                     └────────────────────────────────────────────────────────┘
Co to daje, w kolejności znaczenia przy dużej skali:
- Publikacja nigdy nie blokuje się na API. Przypisanie to odczyt z bazy danych. Hook zapisu twojego CMS-a, statyczny build i masowy import o 3 nad ranem działają z lokalną prędkością, offline, bez żadnego limitu żądań na całej ścieżce.
- Deduplikacja jest darmowa i dokładna.
used_by_page IS NULLto cała funkcja. Dwie strony nie mogą wylosować tego samego zdjęcia, ponieważ przypisanie to transakcja, nie heurystyka rankingowa. - Ponowne uruchomienia są tanie i idempotentne. Odśwież pulę klastra, gdy się
wyczerpuje lub gdy chcesz nowszej fotografii (
after_datealbosort_by=newest) — jedno zapytanie, a nic już opublikowanego się nie zmienia. - Lokalizacje przychodzą za darmo. 20 tłumaczeń artykułu to jedna strona w
twoim modelu z 20 renderowaniami; dzielą przypisany
photo_idi nigdy nie wyszukujesz dwa razy. Kiedy chcesz mieć wygląd zdjęcia zrobionego lokalnie, uruchom zapytanie do puli dla tego klastra w języku docelowym — silnik przyjmuje zdanie w ponad 100 z nich.
Worker w kodzie
Mniej więcej sześćdziesiąt linii. Funkcja wypełniająca pulę to jedyna część, która komunikuje
się z siecią, więc jest to jedyna część wymagająca ostrożności — ograniczona współbieżność,
respektowany 429, wyniki zapisywane w jednej transakcji.
import asyncio, os, time, httpx

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
KEY    = os.environ["PEXAFY_API_KEY"]
FIELDS = "photo_id,urls,width,height,blur_hash,alt_description,attribution"

# Free = 20 req/min. Zostań jeden poniżej. Regulator jest GLOBALNY: sen
# wewnątrz bramki współbieżności pozwoliłby N workerom wypalać N× szybszy limit.
PER_MIN = 19
gate    = asyncio.Semaphore(4)         # połączenia w locie
_lock   = asyncio.Lock()
_slot   = 0.0                          # następny wolny moment na wspólnej osi czasu

async def pace():
    """Przydziel jeden slot zapytania co 60/PER_MIN sekund, dla całej floty."""
    global _slot
    async with _lock:
        now  = time.monotonic()
        _slot = max(now, _slot) + 60 / PER_MIN
        wait  = _slot - now
    if wait > 0:
        await asyncio.sleep(wait)

class QuotaExhausted(Exception): ...   # miesięczny limit: ponawianie nie pomoże

async def fill_pool(client, cluster) -> list[dict]:
    """Jedno zapytanie → do 100 licencjonowanych zdjęć dla jednego klastra tematycznego."""
    for attempt in range(4):
        await pace()
        async with gate:
            r = await client.get(
                SEARCH,
                headers={"X-Api-Key": KEY},
                params={
                    "q": cluster["camera_brief"],   # scena, nie słowo kluczowe
                    "per_page": 100,
                    "orientation": "landscape",
                    "score_threshold": 0.5,
                    "fields": FIELDS,
                },
                timeout=15,
            )
        if r.status_code == 429:
            retry_after = r.headers.get("Retry-After")
            if retry_after is None:            # brak Retry-After ⇒ limit miesięczny,
                raise QuotaExhausted(cluster["id"])   # przerwij cały przebieg
            await asyncio.sleep(int(retry_after))   # na minutę: to się wyczyści
            continue
        r.raise_for_status()
        return r.json()["data"]
    return []                                  # zaloguj to; pula zachowuje stare wiersze

async def refill(clusters):
    async with httpx.AsyncClient(http2=True) as client:
        pools = await asyncio.gather(*(fill_pool(client, c) for c in clusters))
    for cluster, photos in zip(clusters, pools):
        db.upsert_pool(cluster["id"], photos)     # ON CONFLICT DO NOTHING na photo_id
Dwa szczegóły powyżej stanowią różnicę między workerem, który działa bez nadzoru, a takim, który
budzi cię w nocy. Regulator jest globalny, nie per-task: umieszczenie sleepa
wewnątrz bramki współbieżności to klasyczny błąd — czterej workerzy, z których każdy czeka
3 sekundy po własnym zapytaniu, generują cztery zapytania co 3 sekundy, czyli około 75
na minutę, a plan darmowy natychmiast zaczyna zwracać 429. A oba typy 429
to nie to samo zwierzę: ten na minutę niesie Retry-After i wygasa sam, a ten od
miesięcznego limitu go nie niesie i nigdy nie będzie — ponawianie tego to pętla uderzająca w
ścianę.
Przypisanie, część uruchamiana przy każdej publikacji, nigdy nie dotyka sieci:
# Unikalność egzekwuje schemat, nie ostrożność zapytania.
# Zdjęcie może znajdować się w kilku pulach klastrów; może zostać OPUBLIKOWANE tylko raz.
# CREATE UNIQUE INDEX one_use_per_photo ON image_pool (photo_id)
#        WHERE used_by_page IS NOT NULL;

def assign_hero(page_id: str, cluster_id: str) -> dict | None:
    for _ in range(5):                # przegrany wyścig po prostu bierze kolejne zdjęcie
        try:
            return db.query_one("""
                UPDATE image_pool p SET used_by_page = %s, used_at = NOW()
                WHERE p.id = (
                    SELECT c.id FROM image_pool c
                    WHERE c.cluster_id = %s AND c.used_by_page IS NULL
                      AND NOT EXISTS (              -- użyte przez INNY klaster?
                          SELECT 1 FROM image_pool u
                          WHERE u.photo_id = c.photo_id
                            AND u.used_by_page IS NOT NULL
                      )
                    ORDER BY c.rank ASC
                    LIMIT 1 FOR UPDATE SKIP LOCKED  -- bezpieczne przy równoległych workerach
                )
                RETURNING photo_id, urls, width, height, blur_hash, alt, credit
            """, [page_id, cluster_id])
        except UniqueViolation:      # dwa klastry zgłosiły to samo w tej samej milisekundzie
            continue
    return None                     # pula pusta → rozszerz brief, uzupełnij

# Renderowanie: każdy atrybut pochodzi z wiersza — bez przesunięcia układu, bez zgadywania.
# <img src="{urls[regular]}" width="{width}" height="{height}"
#      alt="{alt}" loading="lazy" style="background:{blur_placeholder}">
# <figcaption>{credit}</figcaption>
Dwa tryby awarii, dwa mechanizmy, i oba są potrzebne. FOR UPDATE SKIP LOCKED
obsługuje współbieżność wewnątrz klastra: generujesz strony równolegle — a przy tej
skali będziesz — i dwaj workerzy sięgają po to samo, najwyżej ocenione zdjęcie w tej samej
milisekundzie.
Częściowy indeks unikalny obsługuje przypadek, o którym wszyscy zapominają: to samo zdjęcie
zasadnie pojawia się w pulach kilku klastrów, ponieważ sąsiadujące klastry
(„ubezpieczenie domu dla najemców”, „…dla wynajmujących”) zwracają nakładające się wyniki.
Kontrola used_by_page IS NULL na poziomie klastra jest na to ślepa — każdy klaster
uważa zdjęcie za wolne. NOT EXISTS utrzymuje zapytanie w zgodzie z rzeczywistością,
a indeks czyni niemożliwym błąd przy współbieżności: przegrany wyścigu otrzymuje naruszenie,
ponawia próbę i bierze kolejne zdjęcie. Bez niego stwierdzenie „żadne dwie strony nie dzielą
zdjęcia głównego” jest deklaracją, nie gwarancją.
Gdy pula wyczerpie się w połowie builda, najlepiej sprawdzającym się fallbackiem jest rozszerzenie zamiast powtórzenia: usuń ostatnią klauzulę briefu, uruchom ponownie zapytanie do puli raz, a dopiero potem ponownie użyj najstarzej przypisanego zdjęcia — z twardą zasadą, że nigdy nie trafia ono na stronę tego samego klastra.
Jeden klaster, jedna pula: prawdziwe zapytanie
Weźmy serwis porównawczy: ubezpieczenie domu, dwadzieścia stron — „ubezpieczenie domu dla najemców”, „…dla wynajmujących”, „co faktycznie obejmuje polisa”, dwanaście stron miast, trzy przewodniki po zgłaszaniu szkód. Jeden brief zdjęciowy dla całego klastra, jedno zapytanie, a to jest czoło puli, zwrócone w 122 ms:
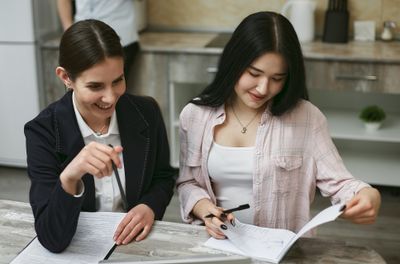
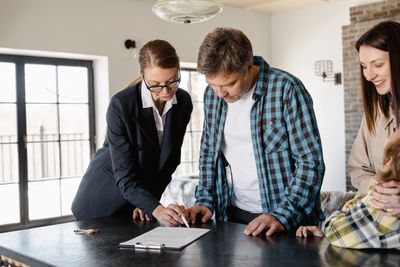
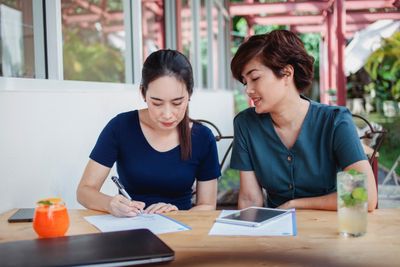
per_page=100 i zachowuje resztę.
Uruchom dokładnie to wyszukiwanie →
Briefy mają większe znaczenie niż kod. Dwie zasady przetrwały kontakt z prawdziwym serwisem
klastrów: pisz brief dla klastra, nie dla strony (tytuły stron są niemal identyczne w
zestawach programmatic, więc briefy per-strona zwracają niemal identyczne zdjęcia), i opisuj
scenę, którą mógłby uchwycić aparat, a nie temat — ubezpieczenie domu zwraca
zbliżenia dokumentów i nic więcej. Kopiuj-wklej gotowy prompt, który generuje takie briefy,
opublikowaliśmy w
artykule o ilustrowaniu każdego posta.
Utrzymanie spójności wizualnej serii liczącej 200 stron
Odwrotną awarią do powtarzalności jest niespójność: dwadzieścia stron w jednym klastrze, każda z
technicznie poprawnym zdjęciem, w dwudziestu różnych rejestrach wizualnych. Rozwiązaniem jest
jeden punkt końcowy — GET /photos/{id}/similar — uruchomiony raz na zdjęciu
zatwierdzonym dla strony filarowej:
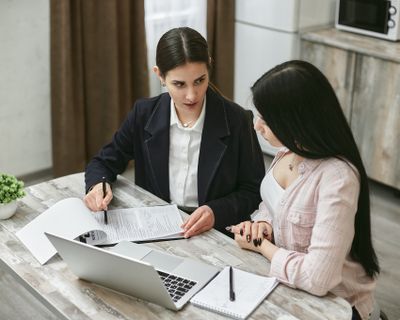
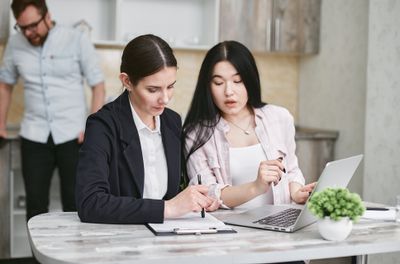
Dwie kolejne dźwignie warte podłączenia do zapytania zasilającego pulę, gdy spójność marki jest
wymogiem: color_hex z color_tolerance utrzymuje cały serwis w jednej
palecie, a photographer przypina klaster do dorobku jednego fotografa. Oba to
zwykłe parametry zapytania — bez żadnego ograniczenia planowego na filtrach wyszukiwania.
Limity żądań, limity miesięczne i faktyczny koszt
Wybierz plan na podstawie szczytowego obciążenia, nie objętości. Gdy tylko zaczniesz pulować zdjęcia, miesięczny limit przestaje być ograniczeniem dla niemal wszystkich; o planie decyduje to, jak szybko musi zakończyć się pełne odświeżenie.
| Plan | Zapytania / miesiąc= klastry do odświeżenia | Limit żądań | Klucze API | Odświeżenie 1000 klastrówczas rzeczywisty, jeden przebieg |
|---|---|---|---|---|
| Free — $0 | 5,000 | 20 / min | 1 | 50 min |
| Starter — $5 | 25,000 | 30 / min | 3 | 34 min |
| Pro — $19 | 100,000 | 60 / min | 5 | 17 min |
| Team — $99agencje: jeden klucz na klienta | 500,000 | 200 / min | 25 | 5 min |
| Business — $249 | 1,000,000 | 300 / min | unlimited | 4 min |
| Enterprise — $599 | 2,000,000 | 500 / min | unlimited | 2 min |
Odczytaj pierwszą kolumnę jako klastry: jedno zapytanie zasilające wypełnia jeden klaster, więc miesięczny limit to liczba klastrów, które można odświeżyć, a ostatnia kolumna to czas potrzebny na pełny przebieg po serwisie liczącym 1000 klastrów przy limicie żądań danego planu. Obie wartości pochodzą na żywo z katalogu cenowego — strona z cenami podaje te same limity żądań w przeliczeniu na godzinę, a nie na minutę.
Tak więc serwis publikujący 10 000 stron miesięcznie w oparciu o wzorzec pulowania zużywa ~500 zapytań i płaci nic. To, co popycha zespoły wyżej w tabeli, rzadko jest objętością — to jedna z trzech rzeczy: pełne przeilustrowanie istniejącego serwisu w ciągu jednej nocy, izolacja kluczy per-klient (agencja chce jednego klucza na klienta, aby zużycie było przypisywalne bez gimnastyki ze współdzielonymi sekretami) albo okno buildu mierzone w minutach, a nie godzinach.
Dwa szczegóły operacyjne, które oszczędzają noc debugowania. Każda odpowiedź niesie
X-RateLimit-Limit i X-RateLimit-Remaining, więc worker może
regulować własne tempo zamiast zgadywać. A 429, który jest prawdziwym limitem na
minutę, niesie Retry-After, podczas gdy blokada z powodu miesięcznego limitu
celowo nie niesie tego nagłówka — ponawianie tego nie wyczyści, a worker odróżniający
te dwa przypadki przestaje bombardować punkt końcowy, który nie ma już nic do zaoferowania.
Gdy publikacją zajmuje się agent
Jeśli twoje treści są tworzone przez agenta — a przy takiej skali coraz częściej tak jest —
warstwa pulowania nie znika, tylko się przemieszcza. Daj agentowi narzędzia do wyszukiwania, a
wypełni pulę, mając wciąż brief klastra w kontekście, korzystając z serwera
Model Context Protocol pod adresem mcp.pexafy.com/mcp: trzy
narzędzia, search_photos (zdanie), search_photos_by_image (obraz
referencyjny, opcjonalnie plus zdanie) i get_similar_photos (to od spójności serii,
opisane powyżej).
# Claude Code / runner CI
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# albo dodaj .mcp.json do repo, żeby każdy worker floty go dziedziczył
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
Instrukcja, która sprawdza się przy dużej skali, to instrukcja wsadowa, nie instrukcja na artykuł — i mapuje się jeden do jednego na dwie opisane wcześniej fazy:
You  Oto 12 klastrów tematycznych z kalendarza treści. Dla każdego
     napisz jeden brief zdjęciowy, pobierz 100 zdjęć w orientacji poziomej
     i zapisz pulę do Postgresa. Oznacz każdy klaster, który zwróci mniej
     niż 40 wyników powyżej 0.5 — takie briefy trzeba przepisać.

Agent  → search_photos(q="a woman signing paperwork with an insurance
           agent at a kitchen table in her home", orientation="landscape")
      ← 100 zdjęć · 122 ms · 87 powyżej progu
      … 11 kolejnych klastrów …

      ✓ zapisano 11 pul (1043 zdjęcia, wszystkie z podpisem autorskim)
      ⚠ „index fund rebalancing” → 12 wyników. Brief jest zbyt abstrakcyjny;
        propozycja: „osoba przy stole w kuchni sprawdzająca liczby na
        laptopie, obok notatnik i kawa”
Ostatnia linia jest powodem, by umieścić agenta w tej pętli zamiast skryptu: awarią programmatic illustration jest zły brief, a zły brief to dokładnie to, co model językowy może zauważyć i przepisać. Skrypty pozostają odpowiedzialne za przypisywanie, gdzie liczy się determinizm, a nie kreatywność.
Czego zdjęcia nie naprawią
Szczery fragment, ponieważ opisywana awaria jest kosztowna. Prawdziwa, opatrzona podpisem fotografia ulepsza stronę. Nie zamienia słabej treści w dobrą treść, a żaden pipeline obrazów nie zmienia sposobu, w jaki wyszukiwarki traktują masowo wytwarzane strony istniejące po to, by zajmować pozycje, a nie by pomagać. Zasady dotyczące spamu Google nazywają to wprost: nadużycie treści na skalę (scaled content abuse) obejmuje generowanie wielu stron o niewielkiej wartości niezależnie od tego, czy zaangażowana jest automatyzacja, a jakość ilustracji na tych stronach jest dla tej oceny nieistotna.2
Użyteczne ujęcie jest więc wąskie i prawdziwe: fotografia to sygnał jakości, który kontrolujesz na stronach, które już zasługują na istnienie. Miejsca, gdzie wyraźnie się to opłaca:
- Pochodzenie, które czytelnik może zweryfikować. Podpis z nazwiskiem fotografa i adresem źródłowym to twierdzenie, które da się sprawdzić — przeciwieństwo nieopatrzonego podpisem obrazu na stronie z nieopatrzonym podpisem autorem.
- Dostępność i Core Web Vitals.
width/heightz odpowiedzi eliminują przesunięcie układu,blur_hashdaje prawdziwy placeholder, aalt_descriptionto szkic tekstu alternatywnego, który twój szablon może ulepszyć, zamiast wymyślać od zera. Pomnóż to przez 40 000 miejsc, a to cała historia jakości obrazów w serwisie. - Niewyglądanie na masowo wyprodukowany. Deduplikacja i spójność serii to to, co powstrzymuje serwis przed posiadaniem sygnatury wizualnej. To realny koszt percepcyjny z realnymi konsekwencjami i jest całkowicie pod twoją kontrolą.
A licencja nadal reguluje samo zdjęcie. Podpis autorski nie jest wymagany przez regulamin API
Pexafy — każdy wynik zawiera gotowe do renderowania attribution.html i
attribution.plain — ale licencja dołączona przez pierwotną bibliotekę ma
zastosowanie do twojego wykorzystania tego zdjęcia, a przy 40 000 obrazów miesięcznie
automatyczne renderowanie podpisu autorskiego jest tańsze niż późniejszy audyt.
Od czego zacząć w poniedziałek
- Pogrupuj swój backlog w klastry po 15–30 stron, które mogłyby prawdopodobnie dzielić jedną sesję zdjęciową. To jedyny naprawdę ręczny krok i to arkusz kalkulacyjny, nie projekt.
- Napisz jeden brief zdjęciowy na klaster — scena, 12 do 25 słów. Wygeneruj je za pomocą modelu, a potem je przeczytaj; briefy nazywające temat zamiast sceny widać na pierwszy rzut oka.
- Wypełnij jedną pulę pojedynczym zapytaniem
per_page=100i przejrzyj jej czoło. Jeśli pierwszych dziesięć zdjęć nie nadaje się do użytku, błąd tkwi w briefie — nie w silniku. - Dodaj kolumnę
used_by_page, zanim cokolwiek opublikujesz. Teraz to pięć minut, później to migracja obejmująca 3000 działających stron. - Uruchom całość na planie darmowym, dopóki okno buildu cię nie zmusi do przejścia wyżej. Przy 500 zapytaniach miesięcznie zajmie to trochę czasu.
Źródła i przypisy
1 Unijny AI Act, artykuł 50 — obowiązki przejrzystości mające zastosowanie od 2 sierpnia 2026: dostawcy systemów generujących syntetyczny obraz, dźwięk, wideo lub tekst muszą oznaczać wyniki w formacie odczytywalnym maszynowo i uczynić je wykrywalnymi jako wygenerowane sztucznie. Wiąże dostawców i podmioty wdrażające AI; nie jest to zasada dotycząca tego, jakie zdjęcia może opublikować dana witryna.
2 Zasady dotyczące spamu w Google Search — nadużycie treści na skalę (scaled content abuse): generowanie wielu stron przede wszystkim w celu manipulowania rankingiem i oferujących użytkownikom niewielką wartość, niezależnie od tego, czy powstały dzięki automatyzacji, wysiłkowi ludzkiemu, czy ich kombinacji. Jakość ilustracji nie jest czynnikiem w tej ocenie, co jest właśnie powodem, dla którego ten artykuł rozdziela te dwie kwestie.
Źródła sprawdzone 17 sierpnia 2026: Zasady dotyczące spamu w Google Search · AI Act, artykuł 50 · Dokumentacja API i MCP Pexafy. Limity planów to aktualne wartości z tabeli cenowej Pexafy; czasy wyszukiwania (122 ms, 48 ms) oraz każde pokazane zdjęcie to rzeczywiste odpowiedzi API, zarejestrowane tego samego dnia.
Najczęściej zadawane pytania
Jak zdobyć obrazy do tysięcy stron programistycznego SEO?
GET /api/v1/search/photos z per_page=100 zwraca do 100 zdjęć z podanym autorstwem dla jednego klastra; zapisujesz je w tabeli puli i przypisujesz jedno na stronę w momencie publikacji. Zasób liczący 10 000 stron miesięcznie z czterema obrazami na stronę wymaga około 500 zapytań zamiast 40 000, co mieści się w darmowym planie (5000 zapytań miesięcznie).Jakie jest najlepsze API do zdjęć stockowych dla produkcji treści na dużą skalę?
Jak zapobiec pojawianiu się tego samego zdjęcia stockowego na kilku stronach?
photo_id każdego publikowanego obrazu i pobieraj zdjęcia z puli transakcyjnie — w SQL, UPDATE … WHERE used_by_page IS NULL … FOR UPDATE SKIP LOCKED. Deduplikacja staje się wtedy dokładna, a nie probabilistyczna, a równoległe workery budujące strony nie mogą rywalizować o to samo najwyżej ocenione zdjęcie. To jedna kolumna, a dodawanie jej retrospektywnie na tysiącach działających stron jest znacznie kosztowniejsze niż dodanie jej pierwszego dnia.Ile zdjęć może zwrócić jedno zapytanie API?
per_page=100, a paginacja kursorowa pozwala kontynuować przechodzenie przez ten sam uszeregowany zbiór wyników dla głębszych pul. Połącz to z score_threshold, aby wąski klaster zwracał 40 mocnych dopasowań zamiast 100 luźnych, oraz z fields, aby zwracać tylko atrybuty renderowane przez Twój szablon, co przy dużej skali utrzymuje odpowiedzi w małym rozmiarze.Czy prawdziwe zdjęcia pomagają stronom tworzonym na skalę lepiej się pozycjonować?
Czy agent AI może automatycznie wypełnić pulę obrazów?
mcp.pexafy.com/mcp, który udostępnia search_photos, search_photos_by_image i photo_similar. Podaj agentowi listę klastrów, a on napisze po jednym briefie fotograficznym dla każdego, pobierze pule i oznaczy briefy, które zwróciły zbyt mało mocnych dopasowań — co jest rzeczywistym trybem awarii ilustracji programistycznej. Przypisywanie pozostaje w Twoich skryptach, gdzie determinizm liczy się bardziej niż kreatywność.

