Illustreer 10.000 Pagina's per Maand Met Echte Foto's — in 500 API-aanroepen
Zoek eenmaal per onderwerpcluster in plaats van eenmaal per afbeelding, en 40.000 API-aanroepen worden er 500. Het pool-en-toewijs-patroon, de worker die rate limits overleeft, en een eerlijke sectie over wat foto's niet kunnen oplossen.
 Marouane Tijani
12 min lezen

Er is een versie van het content-illustratieprobleem die geen enkele hoeveelheid goede smaak oplost: je kiest niet één foto, je vult 40.000 afbeeldingsslots per maand over 800 topic clusters, 9 locales en 14 klantensites, en elke afbeelding moet gelicentieerd, gecrediteerd, geschaald en verschillend van de buurman zijn. Bij dat volume verandert de vraag van “welke foto?” in “wat is de architectuur?”
Dit artikel is het API-antwoord: het requestpatroon dat het aantal calls met twee ordes van grootte verkleint, de worker die rate limits overleeft, de deduplicatie die voorkomt dat een site van 10.000 pagina's eruitziet als een muur van dezelfde stockfoto — en een eerlijke sectie over wat afbeeldingen niet voor je kunnen doen.
Het echte knelpunt bij 10.000 artikelen
Teams die op volume publiceren — programmatic-SEO-landgoederen, marketplace-categoriepagina's, aggregators, affiliatenetwerken, bureaus die content draaien voor een portfolio aan klanten, lokalisatiepipelines die één artikel omzetten in 20 — lopen allemaal tegen dezelfde drie muren aan, in dezelfde volgorde:
- Aantal calls. Eén zoekopdracht per afbeeldingsslot betekent 40.000 API-calls voor 10.000 artikelen met elk vier afbeeldingen. Elke provider beprijst, throttelt en beoordeelt je op dat aantal.
- Herhaling. Rond pagina dertig begint dezelfde foto opnieuw op te duiken. Bij pagina drieduizend heeft je site een visuele signatuur: massaal gegenereerd.
- Coördinatie. Honderd artikelen in één cluster zouden eruit moeten zien als een serie, niet als honderd losstaande Pinterest-borden — en de volgende locale van hetzelfde artikel zou dezelfde afbeelding moeten hergebruiken, niet opnieuw zoeken in een andere taal.
Merk op wat niet op die lijst staat: een goede foto vinden. Een semantische engine levert een pagina met bruikbare kandidaten in ongeveer 130 milliseconden. Retrieval was al opgelost; distributie niet. Alles hieronder gaat over distributie.
Waarom echte foto's, specifiek op dit volume
Het pleidooi voor fotografie boven generatie wordt sterker naarmate het volume toeneemt, om redenen die vooral operationeel zijn in plaats van esthetisch.
| Bij 40.000 afbeeldingen/maand | Genereren | Zoeken |
|---|---|---|
| Tijd per afbeelding | Seconden tot minuten, plus de afgekeurde pogingen | Eén request (~130 ms) dekt een heel cluster |
| Kostenfactor | Per afbeelding, voor altijd | Per request — en één request bedient ~25 artikelen |
| Metadata die je krijgt | Geen. Je schrijft de alt-tekst en afmetingen zelf | Afmetingen, dominante kleur, blur hash, conceptbijschrift, credit line |
| Herkomst | Machinaal gemarkeerd als synthetisch onder de EU AI Act sinds 2 augustus 20261 | Een genoemde fotograaf, een datum, een bron-URL die een lezer kan openen |
| Faalmodus | Plausibele maar onjuiste details, uniforme huisstijl | Niets voldeed aan de briefing — je krijgt nul resultaten, waarmee je kunt werken |
De rij metadata is degene die pipelines bepaalt. Elk zoekresultaat draagt al width,
height, blur_hash, color_hex, alt_description
en een kant-en-klare attribution.html-string mee — precies de payload die een
templating-engine nodig heeft om een <img> zonder layout shift met een
placeholder en een credit te tonen. Gegenereerde afbeeldingen geven je een bestand en laten de
andere zes velden aan jou over om te bedenken.
Waar generatie op schaal nog steeds wint. Illustratie op categorieniveau voor abstracte taxonomieën (“cloud-migratie”, “indexfondsen”), diagrammen, en een huisstijl die je over een heel landgoed wilt herhalen om merkredenen. De splitsing waar de meeste grote uitgevers op uitkomen: foto's voor alles wat in de wereld bestaat, gegenereerde kunst voor alles wat alleen in een argument bestaat. We hebben het volledige pleidooi voor die splitsing gegeven in hoe je elk artikel dat je publiceert illustreert.
Eén request, honderd foto's
Dit is de enige verandering die de rekensom herschikt. Het zoek-endpoint accepteert
per_page tot 100, en cursorpaginering laat je door dezelfde
gerangschikte resultatenset blijven lopen. De eenheid van werk is dus niet een afbeelding,
maar een pool.
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a woman signing paperwork with an insurance agent at a kitchen table in her home" \
  --data-urlencode "per_page=100" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "score_threshold=0.5" \
  --data-urlencode "fields=photo_id,urls,width,height,blur_hash,alt_description,attribution"

# → { "success": true, "data": [ …tot 100 foto's… ],
#     "pagination": { "per_page": 100, "has_more": true, "next_cursor": "eyJyc…" },
#     "meta": { "took_ms": 122.33, "request_id": "7ff1fb9b-…" } }
Drie parameters daarin doen stilzwijgend werk op schaal:
fields— een sparse fieldset. Vraag de zeven velden op die je template rendert en de respons stopt met het meesturen van de lange AI-beschrijving van elke foto. Over 40.000 foto's is dat het verschil tussen een build die streamt en een die vastloopt.score_threshold— de staart van een pagina met 100 resultaten is per definitie minder relevant dan de kop. Een ondergrens instellen betekent dat een dun cluster 34 foto's teruggeeft in plaats van 100 middelmatige, en je pipeline kan daarop reageren in plaats van het te publiceren.next_cursor— als een cluster echt 300 foto's nodig heeft, pagineer dan door dezelfde gerangschikte set in plaats van drie verschillende overlappende queries af te vuren.
En hier is de rekensom, voor een site die 10.000 pagina's per maand publiceert met elk vier afbeeldingen:
| Strategie | Requests / maand | Eén doorloop bij de rate limit van het gratis abonnement20 req/min | Past binnen het gratis maandquotum? |
|---|---|---|---|
| Eén zoekopdracht per afbeeldingsslot | 40.000 | 33 hours | Nee — een betaald abonnement |
| Eén zoekopdracht per artikel | 10.000 | 8 hours | Nee — een betaald abonnement |
| Eén zoekopdracht per cluster van ~20 artikelenhet patroon in dit artikel | 500 | 25 minutes | Ja |
Dezelfde 40.000 gepubliceerde afbeeldingen in alle drie de rijen. Het enige dat verandert is waar de lus zit.
Poolen en toewijzen: het patroon dat schaalt
De hele architectuur bestaat uit twee fasen die op verschillende frequenties draaien, met een tabel ertussen:
                     ┌─────────── draait wekelijks, ~500 requests ───────────┐
  topic clusters ──▶ POOL   zoek eenmaal per cluster, per_page=100
                     │       └─▶ sla 100 fotorijen per cluster op
                     └──────────────────┬───────────────────────────────┘
                                        ▼
                              image_pool tabel
                        (cluster, photo_id, urls, blur_hash,
                         alt, credit, used_by_page, used_at)
                                        │
                     ┌──────────────────┴──── draait per publicatie, 0 requests ───┐
  artikel ─────────▶ ASSIGN  kies de beste ongebruikte rij voor dit
                     │        cluster, markeer als gebruikt, render
                     └────────────────────────────────────────────────────────┘
Wat dit oplevert, in volgorde van belang bij hoog volume:
- Publiceren blokkeert nooit op een API. Toewijzing is een leesactie in de database. Je CMS-savehook, je static build en je import om 3 uur 's nachts draaien allemaal op lokale snelheid, offline, zonder rate limit ergens in het pad.
- Deduplicatie is gratis en exact.
used_by_page IS NULLis de hele functie. Twee pagina's kunnen niet dezelfde foto trekken, omdat toewijzing een transactie is, geen rangschikkingsheuristiek. - Opnieuw uitvoeren is goedkoop en idempotent. Ververs de pool van een cluster
wanneer die bijna leeg is of wanneer je nieuwere fotografie wilt (
after_date, ofsort_by=newest) — één request, en niets wat al gepubliceerd is verandert. - Locales komen gratis mee. De 20 vertalingen van een artikel zijn één pagina
in je model met 20 renderingen; ze delen de toegewezen
photo_iden je zoekt nooit twee keer. Wil je wel een lokaal geschoten look, voer dan de poolquery voor dat cluster in de doeltaal uit — de engine accepteert een zin in meer dan 100 talen.
De worker, in code
Ruwweg zestig regels. De poolvuller is het enige deel dat met het netwerk praat, dus is het het
enige deel dat voorzichtig moet zijn — concurrency begrensd, 429 gerespecteerd,
resultaten weggeschreven in één transactie.
import asyncio, os, time, httpx

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
KEY    = os.environ["PEXAFY_API_KEY"]
FIELDS = "photo_id,urls,width,height,blur_hash,alt_description,attribution"

# Free = 20 req/min. Blijf er één onder. De pacer is GLOBAAL: een sleep per taak
# binnen de concurrency-gate zou N workers N× het tarief laten vuren.
PER_MIN = 19
gate    = asyncio.Semaphore(4)         # actieve verbindingen
_lock   = asyncio.Lock()
_slot   = 0.0                          # eerstvolgende vrije moment op de gedeelde tijdlijn

async def pace():
    """Geef vlootbreed elke 60/PER_MIN seconden één requestslot uit."""
    global _slot
    async with _lock:
        now  = time.monotonic()
        _slot = max(now, _slot) + 60 / PER_MIN
        wait  = _slot - now
    if wait > 0:
        await asyncio.sleep(wait)

class QuotaExhausted(Exception): ...   # maandelijks: opnieuw proberen helpt niet

async def fill_pool(client, cluster) -> list[dict]:
    """Eén request → tot 100 credited foto's voor één topic cluster."""
    for attempt in range(4):
        await pace()
        async with gate:
            r = await client.get(
                SEARCH,
                headers={"X-Api-Key": KEY},
                params={
                    "q": cluster["camera_brief"],   # een scène, geen zoekwoord
                    "per_page": 100,
                    "orientation": "landscape",
                    "score_threshold": 0.5,
                    "fields": FIELDS,
                },
                timeout=15,
            )
        if r.status_code == 429:
            retry_after = r.headers.get("Retry-After")
            if retry_after is None:            # geen Retry-After ⇒ maandquotum,
                raise QuotaExhausted(cluster["id"])   # stop de hele run
            await asyncio.sleep(int(retry_after))   # per minuut: dit trekt bij
            continue
        r.raise_for_status()
        return r.json()["data"]
    return []                                  # log het; de pool houdt zijn oude rijen

async def refill(clusters):
    async with httpx.AsyncClient(http2=True) as client:
        pools = await asyncio.gather(*(fill_pool(client, c) for c in clusters))
    for cluster, photos in zip(clusters, pools):
        db.upsert_pool(cluster["id"], photos)     # ON CONFLICT DO NOTHING op photo_id
Twee details daarin maken het verschil tussen een worker die onbeheerd draait en een die je
's nachts wakker maakt. De pacer is globaal, niet per taak: de sleep binnen de
concurrency-gate zetten is de klassieke fout — vier workers die elk 3 seconden pauzeren na
hun eigen request produceren vier requests elke 3 seconden, ongeveer 75 per minuut, en het
gratis abonnement begint meteen 429 terug te geven. En de twee soorten
429 zijn niet hetzelfde beestje: die per minuut draagt Retry-After mee
en trekt vanzelf bij, die van het maandquotum draagt het niet mee en zal dat ook nooit doen —
daarop opnieuw proberen is een lus tegen een muur.
Toewijzing, het deel dat bij elke publicatie draait, raakt het netwerk nooit aan:
# Uniciteit wordt afgedwongen door het schema, niet doordat de query voorzichtig is.
# Een foto kan in meerdere clusterpools staan; hij mag maar één keer GEPUBLICEERD worden.
# CREATE UNIQUE INDEX one_use_per_photo ON image_pool (photo_id)
#        WHERE used_by_page IS NOT NULL;

def assign_hero(page_id: str, cluster_id: str) -> dict | None:
    for _ in range(5):                # een verloren race pakt gewoon de volgende foto
        try:
            return db.query_one("""
                UPDATE image_pool p SET used_by_page = %s, used_at = NOW()
                WHERE p.id = (
                    SELECT c.id FROM image_pool c
                    WHERE c.cluster_id = %s AND c.used_by_page IS NULL
                      AND NOT EXISTS (              -- gebruikt door EEN ANDER cluster?
                          SELECT 1 FROM image_pool u
                          WHERE u.photo_id = c.photo_id
                            AND u.used_by_page IS NOT NULL
                      )
                    ORDER BY c.rank ASC
                    LIMIT 1 FOR UPDATE SKIP LOCKED  -- veilig met parallelle workers
                )
                RETURNING photo_id, urls, width, height, blur_hash, alt, credit
            """, [page_id, cluster_id])
        except UniqueViolation:      # twee clusters claimden hem in dezelfde ms
            continue
    return None                     # pool leeg → verbreed de briefing, vul opnieuw

# Rendering: elk attribuut komt uit de rij — geen layout shift, geen gokwerk.
# <img src="{urls[regular]}" width="{width}" height="{height}"
#      alt="{alt}" loading="lazy" style="background:{blur_placeholder}">
# <figcaption>{credit}</figcaption>
Twee faalmodi, twee mechanismen, en beide zijn nodig. FOR UPDATE SKIP LOCKED
handelt concurrency binnen een cluster af: genereer pagina's parallel — en bij dit
volume ga je dat doen — en twee workers reiken op hetzelfde moment naar dezelfde
hoogst-gerangschikte foto.
De partiële unieke index handelt het geval af dat iedereen vergeet: dezelfde foto komt
legitiem voor in de pools van meerdere clusters, omdat naburige clusters
(“woonverzekering voor huurders”, “…voor verhuurders”) overlappende resultaten opleveren. Een
used_by_page IS NULL-check per cluster ziet dat niet — elk cluster denkt dat de
foto vrij is. De NOT EXISTS houdt de query eerlijk, en de index maakt het
onmogelijk om dit fout te doen onder concurrency: de verliezer van de race krijgt een
overtreding, probeert opnieuw, en pakt de volgende foto. Zonder dit is “geen twee pagina's
delen een hero” een bewering, geen garantie.
Wanneer een pool halverwege een build leegraakt, is de fallback die het beste gedrag vertoont om te verbreden in plaats van te herhalen: laat de laatste zin van de camera-brief vallen, voer de poolquery eenmaal opnieuw uit, en hergebruik pas dan de langst-geleden-toegewezen foto — met een harde regel dat hij nooit op een pagina in hetzelfde cluster terechtkomt.
Eén cluster, één pool: een echte query
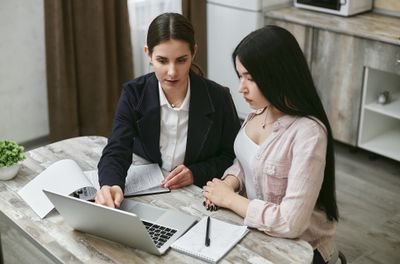
Neem een vergelijkingslandgoed: woonverzekering, twintig pagina's — “woonverzekering voor huurders”, “…voor verhuurders”, “wat een polis eigenlijk dekt”, twaalf stadspagina's, drie schadegidsen. Eén camera-brief voor het cluster, één request, en dit is de kop van de pool, teruggegeven in 122 ms:
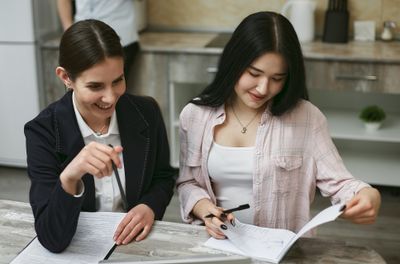
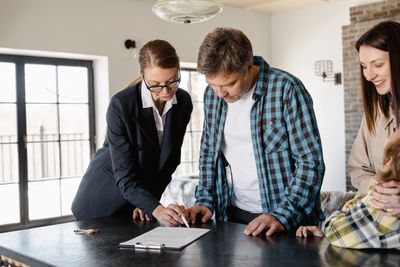
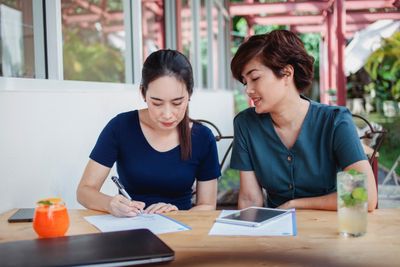
per_page=100 en houdt de rest.
Voer precies deze zoekopdracht uit →
De briefs zijn belangrijker dan de code. Twee regels overleven het contact met een echt
landgoed van clusters: schrijf de brief voor het cluster, niet voor de pagina
(paginatitels zijn bijna identiek binnen programmatische sets, dus briefs per pagina geven
bijna identieke foto's terug), en beschrijf een scène die een camera had kunnen vastleggen in
plaats van het onderwerp — woonverzekering geeft close-ups van documenten en
verder niets. We hebben de kopieerbare prompt die deze briefs oplevert gepubliceerd in
het artikel over het illustreren van elk bericht.
Een serie van 200 pagina's visueel samenhangend houden
Het tegenovergestelde falen van herhaling is incoherentie: twintig pagina's in één cluster,
elk met een technisch correcte foto, in twintig verschillende visuele registers. De oplossing is
één endpoint — GET /photos/{id}/similar — eenmaal uitgevoerd op de foto die je
goedkeurde voor de pillar-pagina:
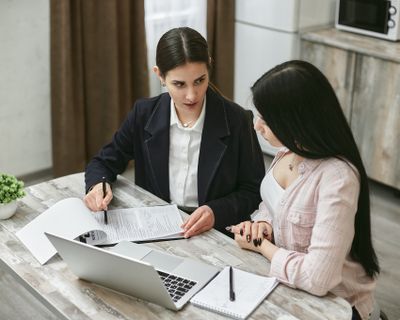
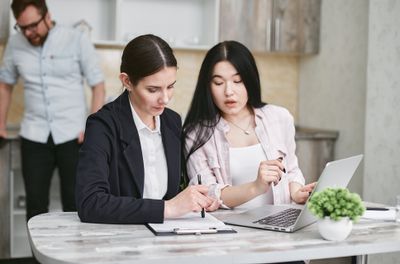
Nog twee hendels die het waard zijn om in de poolquery te verwerken wanneer merkconsistentie
een vereiste is: color_hex met een color_tolerance houdt een heel
landgoed binnen een palet, en photographer bindt een cluster aan het oeuvre van
één fotograaf. Beide zijn gewone queryparameters — geen plan-beperking op zoekfilters.
Rate limits, quota en wat het echt kost
Kies het abonnement op basis van burst, niet op volume. Zodra je poolt, houdt het maandquotum voor bijna iedereen op de beperking te zijn; wat je abonnement bepaalt is hoe snel een volledige refresh moet zijn afgerond.
| Abonnement | Requests / maand= verversbare clusters | Rate limit | API-sleutels | 1.000 clusters verversenkloktijd, één doorloop |
|---|---|---|---|---|
| Free — $0 | 5,000 | 20 / min | 1 | 50 min |
| Starter — $5 | 25,000 | 30 / min | 3 | 34 min |
| Pro — $19 | 100,000 | 60 / min | 5 | 17 min |
| Team — $99bureaus: een sleutel per klant | 500,000 | 200 / min | 25 | 5 min |
| Business — $249 | 1,000,000 | 300 / min | unlimited | 4 min |
| Enterprise — $599 | 2,000,000 | 500 / min | unlimited | 2 min |
Lees de eerste kolom als clusters: één poolrequest vult één cluster, dus het maandquotum is het aantal clusters dat je kunt verversen, en de laatste kolom is hoe lang een volledige doorloop over een landgoed van 1.000 clusters duurt bij de rate limit van dat abonnement. Beide zijn live waarden uit de prijscatalogus — de prijzenpagina vermeldt dezelfde rate limits per uur in plaats van per minuut.
Een landgoed van 10.000 pagina's per maand op het gepoolde patroon besteedt dus ~500 requests en betaalt niets. Wat teams de tabel op duwt is zelden volume — het is een van drie dingen: een volledige heriillustratie van een bestaand landgoed in één nacht, isolatie van sleutels per klant (een bureau wil één sleutel per klant zodat gebruik toewijsbaar is zonder gedeelde-geheimen-gymnastiek), of een buildvenster gemeten in minuten in plaats van uren.
Twee operationele details die een nacht debuggen besparen. Elke respons draagt
X-RateLimit-Limit en X-RateLimit-Remaining mee, zodat een worker
zichzelf kan temporiseren in plaats van te gokken. En een 429 die een echte rate
limit per minuut is, draagt Retry-After mee, terwijl een blokkade door
maandquotum dat opzettelijk niet doet — opnieuw proberen lost die niet op, en een
worker die de twee onderscheidt, stopt met hameren op een endpoint dat niets meer te geven heeft.
Wanneer de agent het publiceren doet
Als je content wordt geproduceerd door een agent — en bij deze volumes is dat steeds vaker het
geval — verdwijnt de poollaag niet, hij verschuift. Geef de agent de zoektools en hij vult de
pool terwijl hij de cluster-brief nog in context heeft, met de
Model Context Protocol-server op mcp.pexafy.com/mcp: drie tools,
search_photos (een zin), search_photos_by_image (een referentiebeeld,
eventueel plus een zin) en get_similar_photos (de bovengenoemde tool voor
seriecoherentie).
# Claude Code / CI-runner
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# of commit .mcp.json zodat elke worker in de vloot het overneemt
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
De instructie die op schaal werkt, is een batch-instructie, geen instructie per artikel — en hij komt één-op-één overeen met de twee fasen hierboven:
You  Hier zijn 12 topic clusters uit de contentkalender. Schrijf voor
     elk cluster één camera-brief, haal 100 landscape-foto's op, en
     schrijf de pool naar Postgres. Markeer elk cluster dat minder
     dan 40 resultaten boven 0,5 oplevert — die briefs moeten
     herschreven worden.

Agent  → search_photos(q="a woman signing paperwork with an insurance
           agent at a kitchen table in her home", orientation="landscape")
      ← 100 foto's · 122 ms · 87 boven drempelwaarde
      … nog 11 clusters …

      ✓ 11 pools weggeschreven (1.043 foto's, allemaal gecrediteerd)
      ⚠ "index fund rebalancing" → 12 resultaten. De brief is abstract;
        suggestie: "a person at a kitchen table checking figures on a
        laptop with a notebook and coffee beside them"
Die laatste regel is de reden om de agent in deze lus te zetten in plaats van een script: de faalmodus van programmatische illustratie is een slechte brief, en een slechte brief is precies het soort ding dat een taalmodel kan opmerken en herschrijven. De scripts blijven verantwoordelijk voor toewijzing, waar determinisme telt en creativiteit niet.
Wat foto's niet kunnen oplossen
Een eerlijke sectie, want het falen dat hij beschrijft is duur. Echte, gecrediteerde fotografie verbetert een pagina. Het verandert geen dunne content in goede content, en geen enkele afbeeldingspipeline verandert hoe zoekmachines omgaan met massaal geproduceerde pagina's die bestaan om te scoren in plaats van te helpen. Google's spambeleid noemt dit rechtstreeks: scaled content abuse omvat het genereren van veel pagina's met weinig waarde ongeacht of automatisering erbij betrokken is, en de illustraties op die pagina's zijn irrelevant voor die beoordeling.2
De bruikbare framing is dus smal en waar: fotografie is een kwaliteitssignaal dat je zelf beheerst op pagina's die al recht hebben om te bestaan. Waar het aantoonbaar loont:
- Herkomst die een lezer kan verifiëren. Een credit line met de naam van een fotograaf en een bron-URL is een bewering die gecontroleerd kan worden — het tegenovergestelde van een niet-toegeschreven afbeelding op een pagina met een niet-toegeschreven auteur.
- Toegankelijkheid en Core Web Vitals.
width/heightuit de respons voorkomen layout shift,blur_hashgeeft een echte placeholder, enalt_descriptionis een concept alt-tekst die je template kan verbeteren in plaats van bedenken. Vermenigvuldig dat met 40.000 slots en dat is het hele afbeeldingskwaliteitsverhaal van de site. - Niet massaal geproduceerd oogen. Deduplicatie en seriecoherentie zijn wat voorkomt dat een landgoed een visuele signatuur krijgt. Dat is een reële perceptiekost met reële gevolgen, en volledig onder jouw controle.
En de licentie blijft van toepassing op de foto. Attributie is niet vereist volgens de
voorwaarden van de Pexafy API — elk resultaat levert attribution.html en
attribution.plain kant-en-klaar voor rendering — maar de licentie die de
oorspronkelijke bibliotheek aan de foto verbindt, geldt voor jouw gebruik ervan, en bij 40.000
afbeeldingen per maand is de credit automatisch renderen goedkoper dan het later te controleren.
Waar maandag mee te beginnen
- Groepeer je backlog in clusters van 15–30 pagina's die aannemelijk een fotoshoot kunnen delen. Dit is de enige echt handmatige stap, en het is een spreadsheet, geen project.
- Schrijf één camera-brief per cluster — een scène, 12 tot 25 woorden. Genereer ze met een model, lees ze dan; briefs die een onderwerp benoemen in plaats van een scène zijn in één oogopslag zichtbaar.
- Vul één pool met een enkele
per_page=100-request en bekijk de kop ervan. Als de eerste tien niet bruikbaar zijn, is de brief fout — niet de engine. - Voeg de kolom
used_by_pagetoe voordat je iets publiceert. Het is nu vijf minuten en later een migratie over 3.000 live pagina's. - Draai het geheel op het gratis abonnement tot een buildvenster je dwingt op te schalen. Bij 500 requests per maand duurt dat wel even.
Referenties & voetnoten
1 EU AI Act, artikel 50 — transparantieverplichtingen van toepassing vanaf 2 augustus 2026: aanbieders van systemen die synthetische afbeeldingen, audio, video of tekst genereren, moeten output markeren in een machineleesbaar formaat en detecteerbaar maken als kunstmatig gegenereerd. Het bindt AI-aanbieders en -implementeerders; het is geen regel over welke afbeeldingen een website mag publiceren.
2 Google Search-spambeleid — scaled content abuse: het genereren van veel pagina's primair om ranglijsten te manipuleren en die weinig waarde bieden aan gebruikers, ongeacht of ze gemaakt zijn via automatisering, menselijke inspanning of een combinatie. Illustratiekwaliteit speelt geen rol in die beoordeling, en precies daarom scheidt dit artikel de twee.
Bronnen gecontroleerd op 17 augustus 2026: Google Search-spambeleid · AI Act artikel 50 · Pexafy API- & MCP-documentatie. De abonnementslimieten zijn de live waarden uit de Pexafy-prijstabel; de zoektijden (122 ms, 48 ms) en elke getoonde foto zijn echte API-responses, vastgelegd op dezelfde dag.
Veelgestelde vragen
Hoe krijg ik afbeeldingen voor duizenden programmatische SEO-pagina's?
GET /api/v1/search/photos-aanvraag met per_page=100 levert tot 100 gecrediteerde foto's op voor één cluster; je slaat ze op in een pooltabel en wijst er bij het publiceren één toe per pagina. Een bestand van 10.000 pagina's per maand met vier afbeeldingen per pagina heeft ongeveer 500 aanvragen nodig in plaats van 40.000, wat binnen het gratis abonnement past (5.000 aanvragen/maand).Wat is de beste stockfoto-API voor contentproductie op grote schaal?
Hoe voorkom ik dat dezelfde stockfoto op meerdere pagina's verschijnt?
photo_id van elke afbeelding die je publiceert op en claim foto's uit de pool transactioneel — in SQL, een UPDATE … WHERE used_by_page IS NULL … FOR UPDATE SKIP LOCKED. Deduplicatie wordt dan exact in plaats van probabilistisch, en parallelle build-workers kunnen niet racen om dezelfde hoogst gerangschikte foto. Het is één kolom, en het achteraf toevoegen ervan aan duizenden live pagina's is veel duurder dan het op dag één toevoegen.Hoeveel foto's kan één API-aanvraag opleveren?
per_page=100, en cursor-paginering laat je door dezelfde gerangschikte resultatenset blijven bladeren voor diepere pools. Combineer het met score_threshold zodat een dun cluster 40 sterke matches oplevert in plaats van 100 losse, en met fields om alleen de attributen terug te geven die je template rendert, wat responses klein houdt bij hoog volume.Helpen echte foto's pagina's die op schaal geproduceerd zijn beter te ranken?
Kan een AI-agent automatisch een afbeeldingspool vullen?
mcp.pexafy.com/mcp, die search_photos, search_photos_by_image en photo_similar aanbiedt. Geef de agent een lijst met clusters en hij schrijft voor elk één camerabriefing, haalt de pools op en markeert de briefings die te weinig sterke matches opleverden — wat het werkelijke faalmodus van programmatische illustratie is. Toewijzing blijft in je scripts, waar determinisme belangrijker is dan creativiteit.

