Gratis Stock Foto API's Vergeleken: Unsplash, Pexels, Pixabay, Openverse & Pexafy
Veertien criteria, vijf API's, elk cijfer uit de eigen documentatie van de providers: wat elke gratis laag écht biedt, de voorwaarden die in productie bijten, en waar elke API — inclusief Pexafy — de verkeerde keuze is.
 Marouane Tijani
11 min lezen

Je hebt vrij te gebruiken foto's nodig in een product. De voor de hand liggende stap is een API-sleutel aanvragen bij Unsplash, Pexels of Pixabay en live gaan. Twee weken later ontdek je het deel dat niemand vergelijkt: je app zit vast op 50 requests per uur totdat een mens hem goedkeurt, de ene provider verbiedt hotlinking, de andere wil een tracking call bij elke download — en je zoekresultaten zijn alleen zo goed als de tags die een vreemde jaren geleden heeft ingetypt.
Deze pagina is de vergelijking die we zelf wilden toen we met Pexafy begonnen: quota in dezelfde eenheid, de voorwaarden die er in productie echt toe doen, en wat elke API wel en niet kan. Elk concurrentiecijfer komt uit de eigen documentatie van de provider, gelinkt onderaan. We zeggen ook ronduit waar Pexafy niet het juiste antwoord is.
De vergelijkingstabel
Vijf opties, veertien criteria. Unsplash, Pexels en Pixabay zijn losse bibliotheken met hun eigen API's. Openverse en Pexafy zijn aggregators — ze doorzoeken meerdere bibliotheken tegelijk — een onderscheid dat de meeste vergelijkingsartikelen stilzwijgend overslaan.
| UnsplashAPI | PexelsAPI | PixabayAPI | Openverseaggregator | Pexafyaggregator | |
|---|---|---|---|---|---|
| Gratis quota | 50 req/uur (demo) | 200 req/uur 20.000/maand |
100 req/minuut | Geen sleutel nodig (beperkt) | 5.000 req/maand |
| Hogere laag | Na handmatige beoordeling1 | Op aanvraag | Op aanvraag (volledige API) | App registreren | Vanaf $5/maand · 25.000 req |
| Sleutel uitgegeven | Direct (alleen demo) | Direct | Direct | Niet vereist | Direct geen kaart |
| App-review om live te gaan | Vereist | Nee | Alleen volledige API | Nee | Geen |
| Naamsvermelding vereistvolgens de API-voorwaarden | Fotograaf + Unsplash | Prominente link naar Pexels + credit | Moet herkomst van afbeelding tonen | Per bronlicentie (CC BY…) | Niet vereist2 |
| Download-tracking call | Vereist bij elke download | Nee | Nee | Nee | Nee |
| Hotlinken van afbeeldingen | Vereist | Toegestaan | Niet toegestaan cache 24 u | Links naar de bron | Toegestaan + CDN-miniaturen |
| Zoeken matcht op | Trefwoorden & tags | Trefwoorden & tags | Trefwoorden & tags | Trefwoorden & metadata | Betekenis semantisch |
| Volledige zinnen als zoekopdracht | Verslechteren resultaten | Verslechteren resultaten | Max. 100 tekens | Verslechteren resultaten | 500 tekens — verbeteren resultaten |
| Afbeelding → afbeelding zoeken | Nee | Nee | Nee | Nee | Ja + "meer zoals dit" |
| Zoektalen | lang-parameter (bèta) |
28 taalinstellingen | 26 taalcodes | Voornamelijk Engels | 100+, één index |
| Bibliotheken per request | 1 | 1 | 1 | Meerdere (CC-bronnen) | 9 |
| Response-schema | Eigen structuur | Eigen structuur | Eigen structuur | Uniform | Uniform + credit-string |
| MCP-server voor AI-agents | Geen officiële | Geen officiële | Geen officiële | Geen officiële | Ja gehost, OAuth 2.1 |
Bronnen: de publieke documentatie van elke provider, gecontroleerd op 14 augustus 2026 — links in de referenties onderaan. Iets verouderd gevonden? Laat het ons weten en we corrigeren het.
Quota: lees de eenheid, niet het getal
Quotavergelijkingen zijn waar dit soort artikelen meestal misgaat, omdat de vier API's vier verschillende dingen tellen over vier verschillende tijdsvensters. Omgerekend naar een gemeenschappelijke eenheid — een zoekopdracht die een gebruiker daadwerkelijk ziet — verandert de rangschikking:
| Gratis plan | Zoals gedocumenteerd | Per uur | Wat één request oplevert |
|---|---|---|---|
| Unsplash | 50 req/uur (demo) | 50 | Eén bibliotheek, gerangschikt op trefwoord |
| Pexels | 200 req/uur · 20.000/maand | 200 | Eén bibliotheek, gerangschikt op trefwoord |
| Pixabay | 100 req/minuut | 6.000 | Eén bibliotheek, gerangschikt op trefwoord |
| Pexafy | 5.000 req/maand · 20 req/min | 1.200 (piek) | 9 bibliotheken, semantisch gerangschikt, gededupliceerd, één schema |
Laten we eerlijk zijn over wat dit betekent: als je pure volume nodig hebt tegen één enkele bibliotheek, is Pixabay's 100 requests per minuut de meest genereuze gratis laag op deze pagina, en dat ontkennen we niet. Wat het je niet geeft, is dekking. Om dezelfde resultatenset zelf samen te stellen uit drie bibliotheken, is de kostprijs niet één request — het zijn er drie, plus alles eromheen:
| Om "één zoekopdracht over 3 bibliotheken" te leveren | Directe API's | Pexafy |
|---|---|---|
| Accounts & API-sleutels om te beheren | 3 | 1 |
| Goedkeuringen om op te wachten | 1 (Unsplash) | 0 |
| HTTP-calls per gebruikerszoekopdracht | 3 | 1 |
| Rate-limitvensters om rekening mee te houden | 3 (uur, uur, minuut) | 1 |
| JSON-structuren om te normaliseren | 3 | 1 |
| Merge-, dedupe- en herrangschikkingslogica | Zelf schrijven en onderhouden | Inbegrepen |
| Sets voorwaarden om aan te voldoen | 3 | 1 |
| Relevantie tussen bibliotheken | 3 losse trefwoordrangschikkingen, samengevoegd | Eén rangschikking, één score |
De eenheid die telt. Eén Pexafy-request = één semantische zoekopdracht over 9 bibliotheken, gededupliceerd en gerangschikt in één enkele lijst. Met de eigen API's van de providers kost dezelfde zoekopdracht voor de gebruiker 3 tot 5 calls plus de merge-laag — code die je schrijft, test en voor altijd onderhoudt.
De regels die je pas na livegang ontdekt
Quota worden geadverteerd. Voorwaarden niet. Dit zijn de vier clausules die het vaakst een herschrijving afdwingen — allemaal openbaar, allemaal makkelijk over het hoofd te zien:
- Unsplash: productietoegang is een menselijke beslissing. Apps starten in demomodus op 50 requests/uur. Om verhoogd te worden, dien je screenshots, een titel en een beschrijving in, en je app moet aantoonbaar de richtlijnen volgen — inclusief het rapporteren van views en downloads. Totdat iemand het goedkeurt, is 50/uur je plafond, in productie, met echte gebruikers.
-
Unsplash: de download-tracking call. Elke keer dat je app een foto downloadt, moet je
ook de
/photos/:id/download-endpoint aanroepen. Het is niet optioneel, het maakt deel uit van de richtlijnen, en het is een tweede round-trip die je in elk codepad moet onthouden dat een afbeelding opslaat. - Pixabay: geen permanente hotlinks, en 24 uur cachen. Je moet afbeeldingen naar je eigen server downloaden voor permanent gebruik, en API-responses moeten 24 uur worden gecachet. Dat betekent opslag, een cachelaag en een invalidatiebeleid — infrastructuur, nog voordat je één foto hebt getoond.
- Iedereen: naamsvermeldingsregels verschillen van licentieregels. De fotolicenties zijn beroemd permissief, maar de API-voorwaarden voegen hun eigen verplichtingen toe — een prominente link terug naar Pexels, credit aan de fotograaf en Unsplash, of het tonen van de herkomst van Pixabay-afbeeldingen. Lees de API-voorwaarden, niet alleen de licentiepagina.
Het standpunt van Pexafy, ronduit gezegd: je sleutel werkt bij de eerste call, er is geen app-review,
geen verplichte tracking-endpoint en geen cacheverplichting. Naamsvermelding is niet vereist volgens onze
API-voorwaarden — en elk resultaat wordt toch geleverd met een kant-en-klare attribution-string
(HTML en platte tekst), omdat het crediteren van fotografen goede praktijk is en wij het liever één regel
code maken dan een klusje. De eigen licentie van de bronbibliotheek blijft uiteraard altijd van toepassing.
Trefwoord vs. semantisch: wat er verandert in de resultaten
Elke API op deze pagina behalve Pexafy matcht jouw woorden met woorden die aan een foto zijn gekoppeld — tags, titels, beschrijvingen. Pexafy vergelijkt betekenis: jouw zin en elke afbeelding worden omgezet in numerieke vingerafdrukken, en de dichtstbijzijnde komen terug. Twee gevolgen zijn direct zichtbaar in productie.
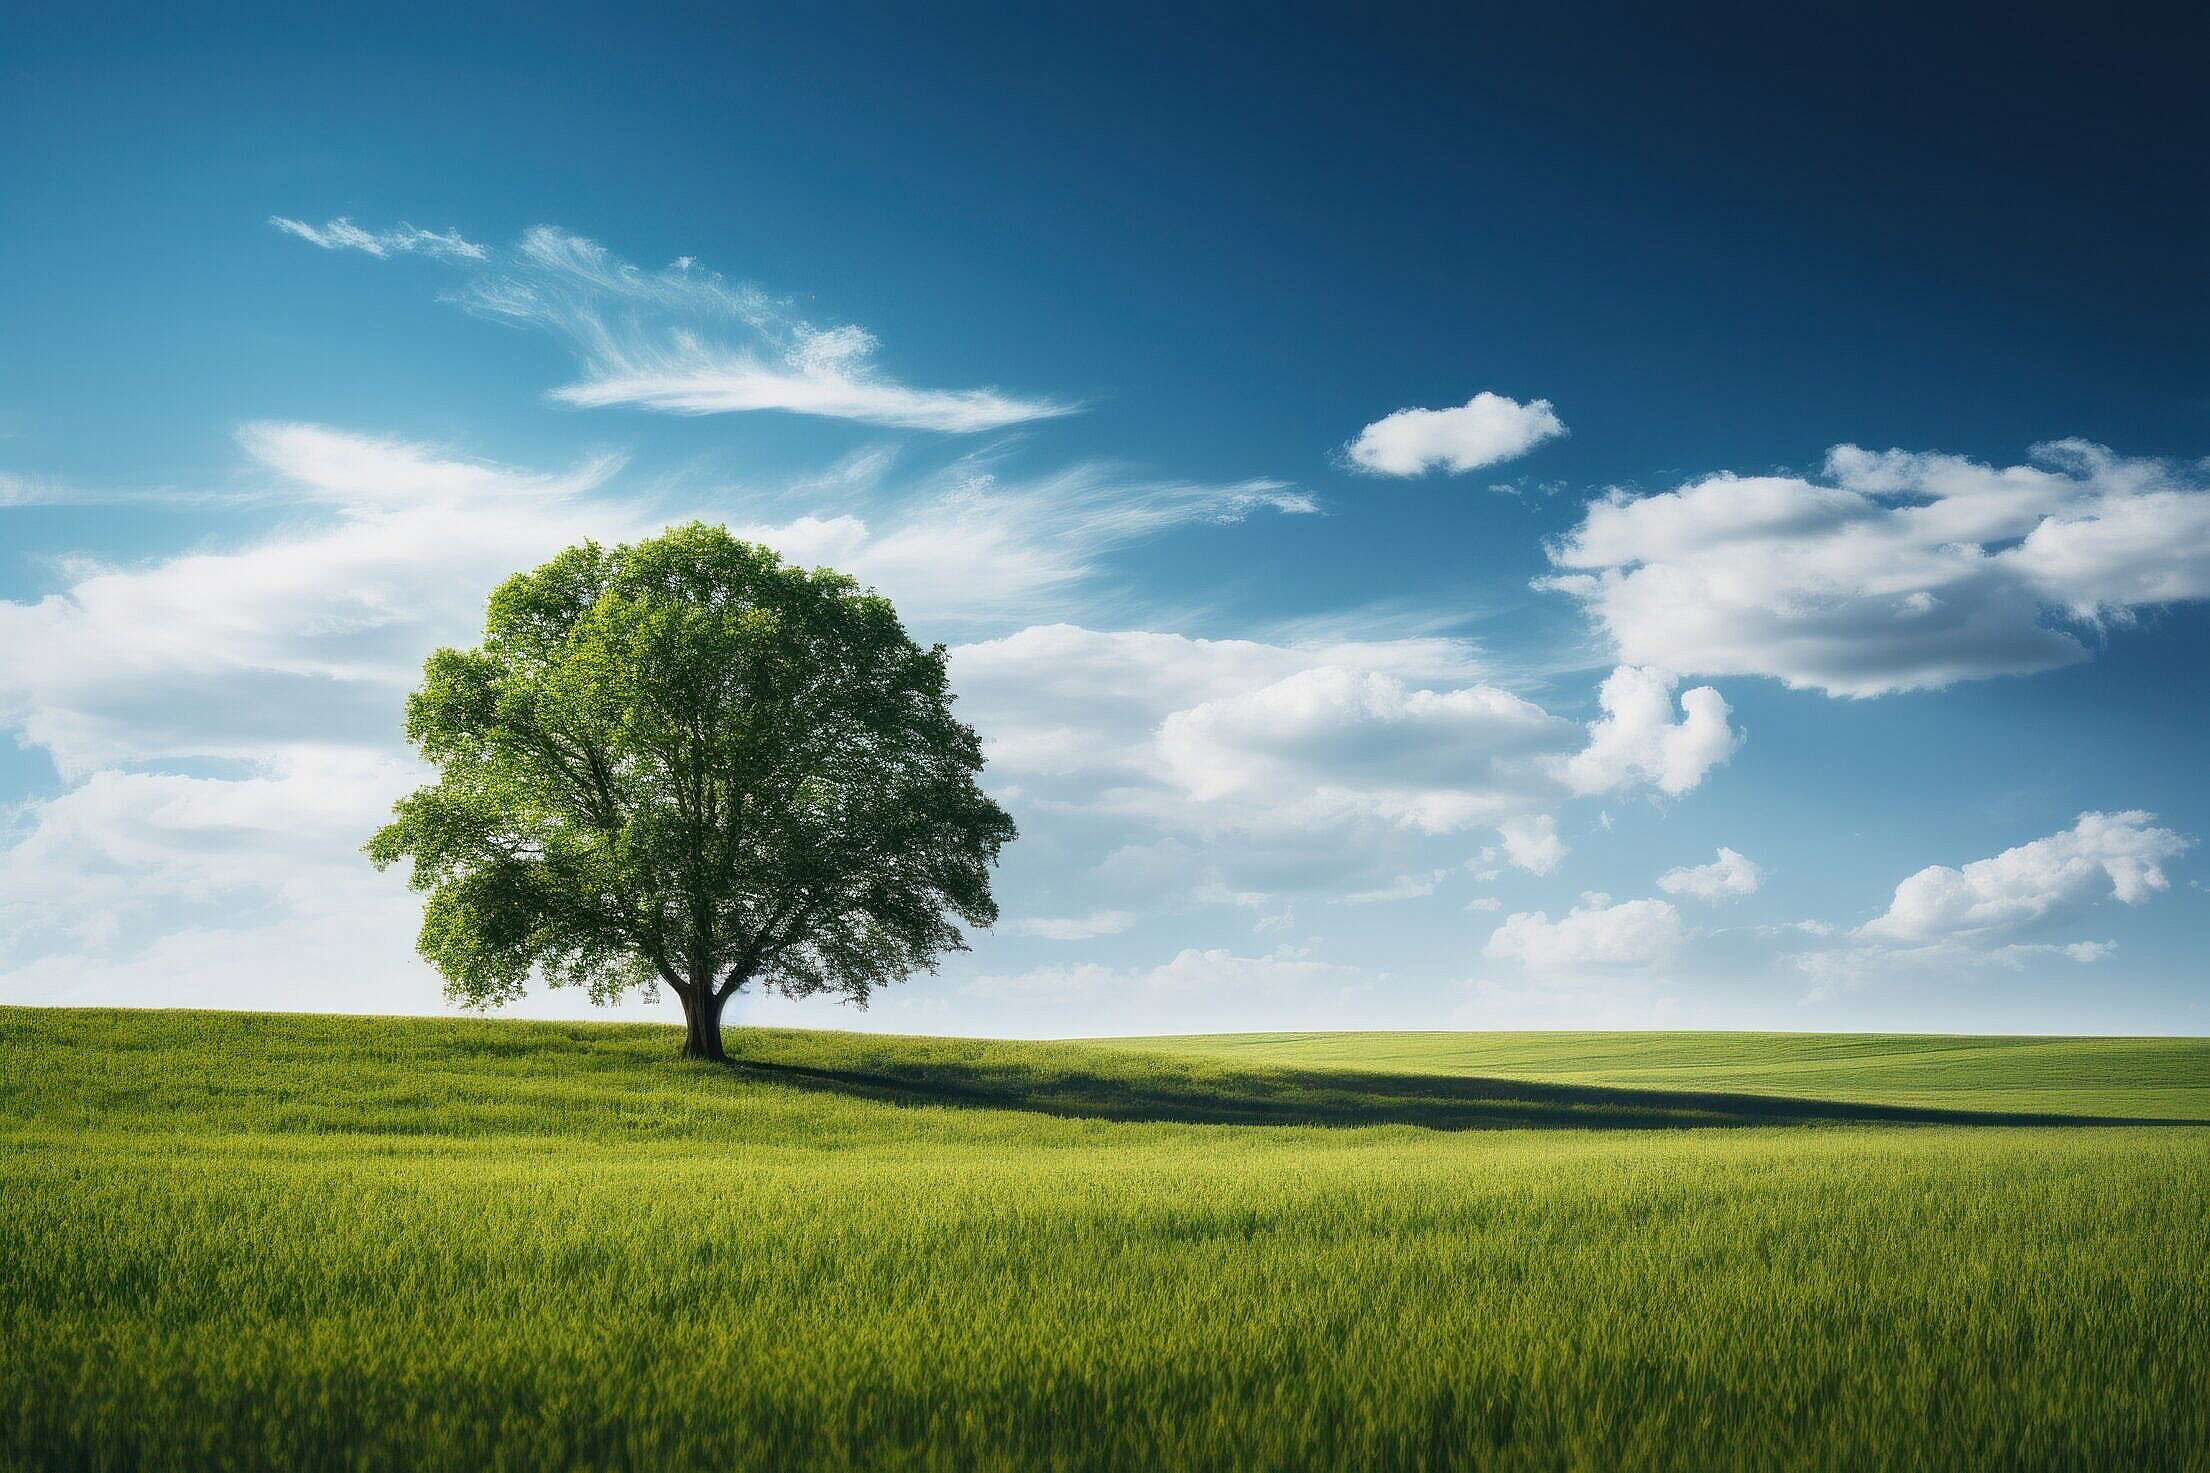
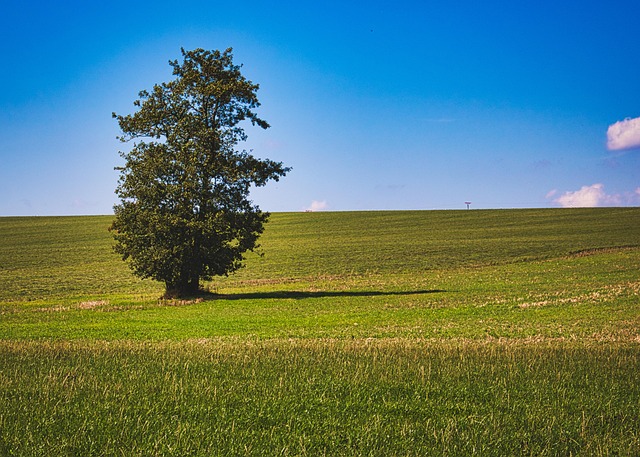
Ten eerste: dekking die je niet had gevraagd. Hier is één echte Pexafy-request — één zoekopdracht, één gerangschikte lijst. Kijk naar de bronbadges:
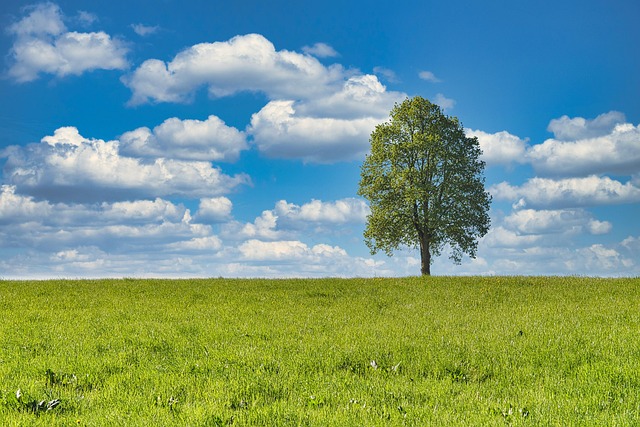
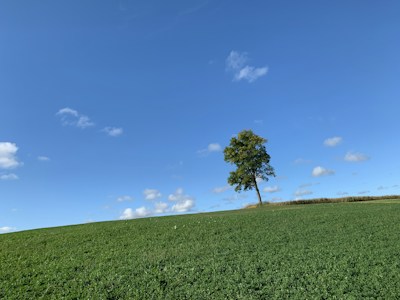
Ten tweede: de zoekopdracht is geen woordpuzzel meer. Bij tag-matching is elk extra woord
iets wat de tags waarschijnlijk niet bevatten, dus je leert typen boom veld en scrollen. Bij
semantisch zoeken geldt het omgekeerde — "een eenzame boom in een leeg groen veld onder een wijde blauwe
lucht" is een betere zoekopdracht dan "boom", omdat elk detail de match aanscherpt. Hetzelfde
effect geldt voor stemmingen (rustig, nostalgisch, minimalistisch) en voor
talen: de zin komt op dezelfde plek terecht of je hem nu in het Engels, Frans of Japans schrijft, tegen
dezelfde ene index. We hebben dat uitgeplozen met echte zoekopdrachten in
semantisch beeldzoeken versus trefwoorden.
Eén schema in plaats van drie
Dit is het onderdeel dat de meeste engineeringtijd kost en nooit in een vergelijkingstabel verschijnt. Hetzelfde concept — "de middelgrote afbeeldings-URL" en "wie heeft de foto gemaakt" — heet in elke API anders:
// Unsplash
results[].urls.regular        results[].user.name
// Pexels
photos[].src.large            photos[].photographer
// Pixabay
hits[].webformatURL           hits[].user
Vermenigvuldig dat met afmetingen, oriëntatie, dominante kleur, bronpagina-URL, licentie en paginering, en je krijgt een adapter per provider, een normalisatielaag, een dedupe-stap (dezelfde foto staat vaak op meerdere bibliotheken) en een herrangschikkingsheuristiek — doorgaans een paar honderd regels die je moet bijhouden in lijn met drie changelogs. Bij Pexafy is die laag het product:
curl -H "X-Api-Key: $PEXAFY_KEY" \
  "https://api.pexafy.com/api/v1/search/photos?q=a+lone+tree+in+an+empty+green+field"

{
  "success": true,
  "data": [
    {
      "photo_id": "019e4cd9-6369-70c3-ab2b-0ffd7e7965ad",
      "urls": { "thumb": "…", "small": "…", "regular": "…", "large": "…", "full": "…" },
      "width": 5376, "height": 3584, "orientation": "landscape",
      "color_name": "xanadu", "color_hex": "#697E77",
      "photographer_full_name": "Viktor Hanacek",
      "photographer_url": "https://picjumbo.com/about-viktor-hanacek/",
      "source": "Picjumbo", "license_type": "free",
      "relevance_score": 0.80,
      "alt_description": "A single tree standing in a wide green field",
      "attribution": { "html": "Photo by …", "plain": "Photo by …" }
    }
  ],
  "meta": { "took_ms": 147 }
}
Identieke velden voor een Picjumbo-foto, een Unsplash-foto en een Pixabay-foto. Eén
relevance_score die vergelijkbaar is over alle bronnen heen, omdat ze samen gerangschikt
werden in plaats van achteraf aan elkaar geplakt. En een attribution-blok dat je zo kunt
weergeven.
Twee dingen die geen van de anderen doet
1 · Zoeken op afbeelding, niet alleen op woorden
Geef Pexafy een afbeelding — een URL, of eentje die je uploadt — en het levert visueel en semantisch vergelijkbare foto's op uit elke geïndexeerde bibliotheek. Je kunt tegelijk met tekst bijsturen ("zoals deze foto, maar bij zonsondergang"). Zo bouw je "meer zoals dit", of vind je een gratis alternatief voor een afbeelding die je niet mag gebruiken. Geen van Unsplash, Pexels, Pixabay of Openverse biedt een image-to-image-endpoint.
2 · Een MCP-server, zodat AI-agents native afbeeldingen kunnen zoeken
Pexafy draait een gehoste Model Context Protocol-server op
mcp.pexafy.com/mcp met OAuth 2.1 — koppel hem aan Claude, of aan je eigen agent, en het
model doorzoekt zelf 9 fotobibliotheken, ziet de miniaturen inline, en levert
gecrediteerde afbeeldingen terug. Drie tools: tekstzoeken, zoeken op afbeelding en gelijkaardige foto's.
De andere providers hebben geen officiële MCP-server; wat bestaat zijn community-wrappers die je zelf
host en van sleutels voorziet. Als je een agent bouwt die afbeeldingen nodig heeft, is dat verschil de
hele integratie.
Welke moet je nu eigenlijk gebruiken?
Een vergelijking waarin één product elke rij wint, is marketing, geen informatie. Hier is de eerlijke verdeling:
- Pixabay — je hebt hoogvolume, single-library toegang nodig op een gratis laag en je kunt de afbeeldingen zelf hosten. 100 requests/minuut is hier ongeëvenaard.
- Unsplash — de visuele identiteit van je product hangt specifiek af van Unsplash's redactionele stijl, en je bent bereid door de app-review te gaan en de tracking call te implementeren.
- Pexels — je wilt één schone bibliotheek met een directe sleutel, een royaal uurtarief, en geen infrastructuurverplichtingen.
- Openverse — je hebt Creative Commons- en publiek-domeinmateriaal nodig naast de commerciële stockbibliotheken, inclusief museum- en institutionele collecties.
- Pexafy — je wilt breedte zonder integratiewerk: één sleutel, 9 bibliotheken, één schema, betekenisgebaseerde rangschikking, image-to-image zoeken, en een MCP-server voor AI-agents. Of je bent een bureau, een CMS, of een AI-product waarbij "de juiste afbeelding vinden" een functie is, geen pagina.
Je kunt ze ook allebei gebruiken: veel teams houden een directe Unsplash-integratie aan voor merkfotografie en gebruiken Pexafy voor al de rest, juist omdat het maar één sleutel kost en geen goedkeuring vraagt om uit te proberen.
Referenties & voetnoten
1 De documentatie van Unsplash vermeldt dat demo-applicaties beperkt zijn tot 50 requests/uur en dat de limiet wordt verhoogd na goedkeuring voor productie. Het gepubliceerde productiecijfer is op de API-documentatiepagina gedocumenteerd als 1.000 requests/uur, terwijl Unsplash-helppagina's en externe handleidingen al lang 5.000 requests/uur aanhalen. Hoe dan ook, het is afgeschermd achter een handmatige beoordeling — en dat is het punt dat ertoe doet als je een lancering plant.
2 Naamsvermelding is niet vereist volgens de API-voorwaarden van Pexafy, en elk resultaat bevat een kant-en-klare attribution-string. De licentie die aan elke foto is gekoppeld door de originele bibliotheek blijft van toepassing op jouw gebruik van die foto — Pexafy is een zoekmachine over andermans bibliotheken, niet de rechthebbende.
Documentatie gecontroleerd op 14 augustus 2026: Unsplash API-documentatie · Pexels API-documentatie · Pixabay API-documentatie · Openverse API-documentatie · Pexafy API-documentatie. Pexafy-cijfers weerspiegelen de gepubliceerde plannen op dezelfde datum.
Veelgestelde vragen
Welke gratis stock foto API heeft de beste gratis laag?
Heb ik goedkeuring nodig om de Unsplash API in productie te gebruiken?
Is attributie verplicht bij het gebruik van deze API's?
Wat is het beste alternatief voor de Unsplash API?
Kan ik stock foto's doorzoeken met een volledige zin via een API?
Kan een AI-agent rechtstreeks stock foto's doorzoeken?
mcp.pexafy.com/mcp, beveiligd met OAuth 2.1. Verbind deze met Claude of je eigen agent, en het model doorzoekt zelf elke geïndexeerde bibliotheek — op tekst of afbeelding — en geeft foto's terug met credits. Unsplash, Pexels, Pixabay en Openverse hebben geen officiële MCP-server; alleen door de community onderhouden wrappers die je zelf moet hosten.

