10,000페이지를 실제 사진으로 매달 삽화 처리하기 — API 호출 500번으로
이미지 한 장마다 검색하는 대신 토픽 클러스터당 한 번만 검색하면, API 호출 40,000번이 500번으로 줄어듭니다. 풀에 담아두고 배정하는 패턴, 레이트 리밋을 견디는 워커, 그리고 사진이 해결해줄 수 없는 것들에 대한 솔직한 이야기까지 다룹니다.
 Marouane Tijani
12 분 분량

콘텐츠 일러스트레이션 문제에는 아무리 안목이 좋아도 해결되지 않는 버전이 있습니다. 사진 한 장을 고르는 것이 아니라, 800개의 토픽 클러스터, 9개 로케일, 14개 클라이언트 사이트에 걸쳐 매달 40,000개의 이미지 슬롯을 채워야 하고, 그 각각은 라이선스가 있어야 하고, 크레딧이 표기되어야 하고, 크기가 맞아야 하고, 옆에 있는 것과 달라야 합니다. 이 정도 규모에서는 질문이 더 이상 “어떤 사진을 쓸까?”가 아니라 “어떤 아키텍처가 필요한가?”가 됩니다.
이 글은 그 질문에 대한 API 차원의 답입니다: 호출 수를 두 자릿수 배로 줄이는 요청 패턴, 속도 제한(rate limit)을 견디는 워커, 10,000페이지 규모의 사이트가 똑같은 스톡 사진의 벽처럼 보이지 않게 하는 중복 제거 방식 — 그리고 사진이 해결해 줄 수 없는 부분에 대한 솔직한 섹션까지 다룹니다.
10,000개 글에서 진짜 병목은 무엇인가
대규모로 발행하는 팀들 — 프로그래매틱 SEO 자산, 마켓플레이스 카테고리 페이지, 애그리게이터, 제휴 네트워크, 여러 클라이언트의 콘텐츠를 운영하는 에이전시, 하나의 글을 20개로 번역하는 로컬라이제이션 파이프라인 — 은 모두 같은 순서로 같은 세 가지 벽에 부딪힙니다:
- 호출 수. 이미지 슬롯마다 한 번씩 검색하면 4장짜리 글 10,000개에 40,000번의 API 호출이 필요합니다. 어떤 제공업체든 이 숫자를 기준으로 가격을 매기고, 제한을 걸고, 검토합니다.
- 반복. 30번째 페이지쯤부터 같은 사진이 다시 등장하기 시작합니다. 3,000번째 페이지쯤 되면 사이트에는 대량 생성됨이라는 시각적 서명이 남습니다.
- 일관성. 하나의 클러스터에 속한 100개의 글은 서로 무관한 100개의 핀터레스트 보드가 아니라 하나의 시리즈처럼 보여야 하며, 같은 글의 다음 로케일 버전은 다른 언어로 다시 검색하는 것이 아니라 같은 사진을 재사용해야 합니다.
이 목록에 빠져 있는 항목에 주목하십시오: 좋은 사진을 찾는 일 자체는 없습니다. 시맨틱 엔진은 약 130 밀리초 만에 사용 가능한 후보 한 페이지를 반환합니다. 검색(retrieval)은 이미 해결된 문제이고, 배분(distribution)이 해결되지 않은 것입니다. 아래 내용은 전부 배분에 관한 것입니다.
이 규모에서 왜 굳이 실사진인가
물량이 늘어날수록 생성형 이미지보다 실사진을 쓰는 논거는 더 강해집니다. 그 이유는 대체로 미학이 아니라 운영상의 문제입니다.
| 월 40,000장 기준 | 생성하는 경우 | 검색하는 경우 |
|---|---|---|
| 이미지 한 장당 소요 시간 | 몇 초에서 몇 분, 여기에 실패한 시도까지 더해짐 | 요청 한 번(약 130 ms)으로 클러스터 전체를 커버 |
| 비용 구조 | 이미지 한 장당, 영구적으로 | 요청 한 번당 — 그리고 요청 한 번이 약 25개 글에 쓰임 |
| 제공되는 메타데이터 | 없음. alt 텍스트와 크기를 직접 작성해야 함 | 크기, 대표 색상, 블러 해시, 캡션 초안, 크레딧 표기 |
| 출처(provenance) | 2026년 8월 2일부터 시행된 EU AI Act에 따라 합성물로 기계 표시됨1 | 실명이 있는 사진가, 촬영일, 독자가 직접 열어볼 수 있는 출처 URL |
| 실패 양상 | 그럴듯하지만 세부가 틀린 결과, 획일적인 하우스 스타일 | 브리프에 맞는 것이 없으면 결과 0건 — 이는 처리 가능한 상황 |
메타데이터 행이 파이프라인의 방향을 결정합니다. 모든 검색 결과에는 이미 width, height, blur_hash, color_hex, alt_description, 그리고 곧바로 쓸 수 있는 attribution.html 문자열이 포함되어 있습니다 — 이는 템플릿 엔진이 레이아웃 시프트 없는 <img>를 플레이스홀더와 크레딧까지 포함해 출력하는 데 정확히 필요한 페이로드입니다. 생성된 이미지는 파일 하나만 줄 뿐, 나머지 여섯 필드는 직접 만들어야 합니다.
생성형 이미지가 여전히 대규모에서 우위인 경우. 추상적인 분류 체계(“클라우드 마이그레이션”, “인덱스 펀드”)를 위한 카테고리 수준의 일러스트, 다이어그램, 그리고 브랜드상의 이유로 전체 자산에 걸쳐 반복하고 싶은 하우스 스타일이 그 예입니다. 대다수 대형 퍼블리셔가 정착한 구분은 다음과 같습니다: 세상에 실재하는 것에는 실사진을, 논증 안에만 존재하는 것에는 생성형 아트를. 이 구분에 대한 전체 논거는 모든 발행 글을 일러스트하는 방법에서 다루었습니다.
요청 하나, 사진 백 장
이것이 산술 구조 전체를 바꾸는 단 하나의 변화입니다. 검색 엔드포인트는 per_page를 최대 100까지 받으며, 커서 페이지네이션을 통해 동일한 순위 결과 집합을 계속 탐색할 수 있습니다. 따라서 작업 단위는 이미지 한 장이 아니라 풀(pool)이 됩니다.
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a woman signing paperwork with an insurance agent at a kitchen table in her home" \
  --data-urlencode "per_page=100" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "score_threshold=0.5" \
  --data-urlencode "fields=photo_id,urls,width,height,blur_hash,alt_description,attribution"

# → { "success": true, "data": [ …최대 100장의 사진… ],
#     "pagination": { "per_page": 100, "has_more": true, "next_cursor": "eyJyc…" },
#     "meta": { "took_ms": 122.33, "request_id": "7ff1fb9b-…" } }
여기에는 대규모 운영에서 조용히 큰 역할을 하는 세 가지 파라미터가 있습니다:
fields— 스파스 필드셋(sparse fieldset)입니다. 템플릿이 실제로 렌더링하는 일곱 개 필드만 요청하면, 응답에 모든 사진의 긴 AI 설명 텍스트가 실리지 않습니다. 40,000장 규모에서는 이것이 스트리밍되는 빌드와 스와핑되는 빌드의 차이를 만듭니다.score_threshold— 정의상 100건 결과 페이지의 뒷부분은 앞부분보다 관련성이 떨어집니다. 하한선을 설정하면 얇은 클러스터는 평범한 사진 100장 대신 34장만 반환하며, 파이프라인은 이를 그대로 발행하는 대신 이에 반응할 수 있습니다.next_cursor— 클러스터에 정말로 300장이 필요할 때는 서로 겹치는 세 개의 다른 쿼리를 날리는 대신, 같은 순위 결과 집합을 페이지네이션하십시오.
그리고 매달 10,000페이지, 페이지당 이미지 4장을 발행하는 사이트를 기준으로 한 산술은 다음과 같습니다:
| 전략 | 월간 요청 수 | 무료 플랜 속도 제한 기준 1회 처리분당 20건 | 무료 월간 한도에 들어맞는가? |
|---|---|---|---|
| 이미지 슬롯 한 개당 검색 | 40,000 | 33 hours | 아니요 — 유료 플랜 필요 |
| 글 한 개당 검색 | 10,000 | 8 hours | 아니요 — 유료 플랜 필요 |
| 약 20개 글로 구성된 클러스터 한 개당 검색이 글에서 다룬 패턴 | 500 | 25 minutes | 예 |
세 행 모두 동일하게 40,000장의 이미지가 발행됩니다. 달라진 것은 오직 루프가 어디에 위치하느냐뿐입니다.
풀링과 배정: 확장 가능한 패턴
전체 아키텍처는 서로 다른 주기로 실행되는 두 단계로 이루어져 있으며, 그 사이에 테이블이 하나 있습니다:
                     ┌─────────── 주 1회 실행, 약 500건 요청 ───────────┐
  topic clusters ──▶ POOL   클러스터당 한 번 검색, per_page=100
                     │       └─▶ 클러스터당 사진 100행 저장
                     └──────────────────┬───────────────────────────────┘
                                        ▼
                              image_pool 테이블
                        (cluster, photo_id, urls, blur_hash,
                         alt, credit, used_by_page, used_at)
                                        │
                     ┌──────────────────┴──── 발행 시마다 실행, 요청 0건 ───┐
  article ─────────▶ ASSIGN  이 클러스터에서 아직 사용되지
                     │        않은 최적의 행을 골라 사용 처리 후 렌더링
                     └────────────────────────────────────────────────────────┘
이 구조가 가져다주는 이점을 중요도 순으로 나열하면:
- 발행이 API에 의해 막히지 않습니다. 배정은 데이터베이스 읽기 작업입니다. CMS 저장 훅, 정적 빌드, 새벽 3시의 대량 임포트 모두 경로 어디에도 속도 제한 없이, 오프라인에서, 로컬 속도로 실행됩니다.
- 중복 제거는 공짜이면서도 정확합니다.
used_by_page IS NULL이 기능의 전부입니다. 배정이 랭킹 휴리스틱이 아니라 트랜잭션이기 때문에 두 페이지가 같은 사진을 가져갈 수 없습니다. - 재실행은 저렴하고 멱등적입니다. 풀이 부족해지거나 더 새로운 사진(
after_date, 또는sort_by=newest)을 원할 때 클러스터의 풀을 새로고침하십시오 — 요청 한 번이면 되고, 이미 발행된 것은 아무것도 바뀌지 않습니다. - 로케일은 공짜로 해결됩니다. 한 글의 20개 번역본은 모델상 한 페이지가 20번 렌더링된 것이며, 배정된
photo_id를 공유하므로 두 번 검색할 필요가 없습니다. 현지에서 촬영된 듯한 느낌을 원할 때는 대상 언어로 해당 클러스터의 풀 쿼리를 실행하십시오 — 엔진은 100개 이상의 언어로 문장을 처리합니다.
코드로 보는 워커
대략 60줄입니다. 네트워크와 통신하는 부분은 풀 채우기(pool filler)뿐이므로, 주의가 필요한 부분도 그곳뿐입니다 — 동시성 제한, 429 준수, 하나의 트랜잭션으로 결과 기록.
import asyncio, os, time, httpx

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
KEY    = os.environ["PEXAFY_API_KEY"]
FIELDS = "photo_id,urls,width,height,blur_hash,alt_description,attribution"

# Free = 분당 20건. 한 건 여유를 둡니다. 이 페이서는 전역(GLOBAL)입니다: 동시성
# 게이트 안에 태스크별 sleep을 두면 N개의 워커가 N배의 속도로 요청을 쏘게 됩니다.
PER_MIN = 19
gate    = asyncio.Semaphore(4)         # 동시 진행 중인 연결 수
_lock   = asyncio.Lock()
_slot   = 0.0                          # 공유 타임라인 상의 다음 여유 시점

async def pace():
    """전체 워커에 걸쳐 60/PER_MIN초마다 요청 슬롯 하나씩 배분."""
    global _slot
    async with _lock:
        now  = time.monotonic()
        _slot = max(now, _slot) + 60 / PER_MIN
        wait  = _slot - now
    if wait > 0:
        await asyncio.sleep(wait)

class QuotaExhausted(Exception): ...   # 월간 한도: 재시도해도 소용없음

async def fill_pool(client, cluster) -> list[dict]:
    """요청 한 번 → 하나의 토픽 클러스터에 대해 최대 100장의 크레딧 표기 사진."""
    for attempt in range(4):
        await pace()
        async with gate:
            r = await client.get(
                SEARCH,
                headers={"X-Api-Key": KEY},
                params={
                    "q": cluster["camera_brief"],   # 키워드가 아니라 장면 묘사
                    "per_page": 100,
                    "orientation": "landscape",
                    "score_threshold": 0.5,
                    "fields": FIELDS,
                },
                timeout=15,
            )
        if r.status_code == 429:
            retry_after = r.headers.get("Retry-After")
            if retry_after is None:            # Retry-After가 없다면 ⇒ 월간 한도이므로,
                raise QuotaExhausted(cluster["id"])   # 전체 실행 중단
            await asyncio.sleep(int(retry_after))   # 분당 제한: 곧 풀림
            continue
        r.raise_for_status()
        return r.json()["data"]
    return []                                  # 로그만 남기고; 풀은 기존 행 유지

async def refill(clusters):
    async with httpx.AsyncClient(http2=True) as client:
        pools = await asyncio.gather(*(fill_pool(client, c) for c in clusters))
    for cluster, photos in zip(clusters, pools):
        db.upsert_pool(cluster["id"], photos)     # photo_id 기준 ON CONFLICT DO NOTHING
여기서 두 가지 세부 사항이 방치해도 되는 워커와 한밤중에 사람을 깨우는 워커의 차이를 만듭니다. 페이서는 태스크별이 아니라 전역입니다: 동시성 게이트 안에 sleep을 넣는 것은 흔한 실수입니다 — 워커 4개가 각자 자신의 요청 후 3초씩 대기하면 실제로는 3초마다 요청 4개, 즉 분당 약 75건이 발생하고 무료 플랜은 즉시 429를 반환하기 시작합니다. 그리고 두 종류의 429는 같은 것이 아닙니다: 분당 제한에 의한 것은 Retry-After를 동반하며 저절로 해소되지만, 월간 한도에 의한 것은 이를 동반하지 않으며 앞으로도 그럴 것입니다 — 이를 재시도하는 것은 벽을 향한 무한 루프일 뿐입니다.
발행할 때마다 실행되는 배정 부분은 네트워크를 전혀 건드리지 않습니다:
# 유일성은 신중한 쿼리가 아니라 스키마에 의해 강제됩니다.
# 사진 한 장이 여러 클러스터 풀에 존재할 수는 있지만, 발행(PUBLISHED)은 단 한 번만 가능합니다.
# CREATE UNIQUE INDEX one_use_per_photo ON image_pool (photo_id)
#        WHERE used_by_page IS NOT NULL;

def assign_hero(page_id: str, cluster_id: str) -> dict | None:
    for _ in range(5):                # 경합에서 진 경우 그냥 다음 사진을 사용
        try:
            return db.query_one("""
                UPDATE image_pool p SET used_by_page = %s, used_at = NOW()
                WHERE p.id = (
                    SELECT c.id FROM image_pool c
                    WHERE c.cluster_id = %s AND c.used_by_page IS NULL
                      AND NOT EXISTS (              -- 다른 클러스터에서 이미 사용 중인가?
                          SELECT 1 FROM image_pool u
                          WHERE u.photo_id = c.photo_id
                            AND u.used_by_page IS NOT NULL
                      )
                    ORDER BY c.rank ASC
                    LIMIT 1 FOR UPDATE SKIP LOCKED  -- 병렬 워커에도 안전
                )
                RETURNING photo_id, urls, width, height, blur_hash, alt, credit
            """, [page_id, cluster_id])
        except UniqueViolation:      # 같은 밀리초에 두 클러스터가 동시에 요청함
            continue
    return None                     # 풀 고갈 → 브리프를 넓히고 재충전

# 렌더링: 모든 속성이 행(row)에서 나옵니다 — 레이아웃 시프트도, 추측도 없음.
# <img src="{urls[regular]}" width="{width}" height="{height}"
#      alt="{alt}" loading="lazy" style="background:{blur_placeholder}">
# <figcaption>{credit}</figcaption>
실패 양상 두 가지에 각각 대응하는 메커니즘이 두 가지이며, 둘 다 필요합니다. FOR UPDATE SKIP LOCKED는 한 클러스터 내부의 동시성을 처리합니다: 이 규모에서는 여러 페이지를 병렬로 생성하게 될 것이고, 두 워커가 같은 밀리초에 순위가 가장 높은 같은 사진을 가져가려 하는 상황이 생깁니다.
부분 유니크 인덱스는 다들 놓치기 쉬운 경우를 처리합니다: 같은 사진이 여러 클러스터의 풀에 정당하게 등장하는 경우입니다. 이웃한 클러스터들(“임차인을 위한 주택보험”, “...임대인을 위한”)이 겹치는 결과를 반환하기 때문입니다. 클러스터별 used_by_page IS NULL 체크만으로는 이를 알 수 없습니다 — 각 클러스터가 그 사진이 자유롭다고 믿기 때문입니다. NOT EXISTS는 쿼리를 정직하게 유지하고, 인덱스는 동시성 상황에서도 오류가 발생하지 않도록 만듭니다: 경합에서 진 쪽은 위반(violation)을 받고, 재시도한 뒤 다음 사진을 가져갑니다. 이것이 없으면 “두 페이지가 히어로 이미지를 공유하지 않는다”는 것은 보장이 아니라 그저 주장일 뿐입니다.
빌드 도중 풀이 고갈되었을 때 가장 잘 작동하는 폴백(fallback)은 반복하는 것이 아니라 넓히는 것입니다: 카메라 브리프의 마지막 절을 제거하고 풀 쿼리를 한 번 더 실행한 다음, 그때만 가장 오래전에 배정된 사진을 재사용하되 — 같은 클러스터 내 페이지에는 절대 배정되지 않는다는 엄격한 규칙을 적용하십시오.
클러스터 하나, 풀 하나: 실제 쿼리
비교용 자산을 예로 들어 보겠습니다: 주택보험, 20개 페이지 — “임차인을 위한 주택보험”, “...임대인을 위한”, “보험이 실제로 보장하는 범위”, 12개 도시 페이지, 3개 청구 가이드. 클러스터를 위한 카메라 브리프 하나, 요청 하나, 그리고 이것이 122 ms만에 반환된 풀의 상위 결과입니다:
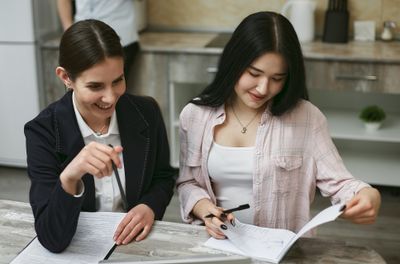
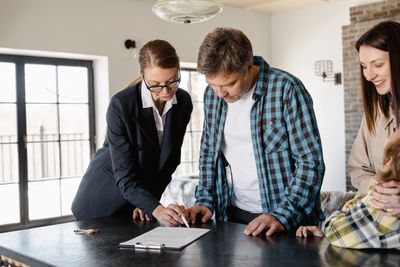
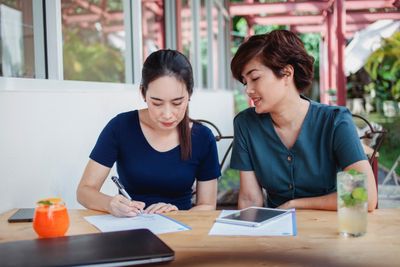
per_page=100을 요청하여 나머지도 확보합니다.
이 검색을 직접 실행해 보기 →
실제로는 코드보다 브리프가 더 중요합니다. 실제 클러스터 자산에서 살아남는 규칙은 두 가지입니다: 브리프는 페이지가 아니라 클러스터 단위로 작성하십시오(프로그래매틱 세트에서는 페이지 제목이 거의 동일하기 때문에, 페이지별 브리프는 거의 동일한 사진을 반환합니다). 그리고 주제가 아니라 카메라가 실제로 찍었을 법한 장면을 묘사하십시오 — home insurance라는 단어 자체는 서류 클로즈업 외에는 아무것도 반환하지 않습니다. 이런 브리프를 만드는 복사-붙여넣기 가능한 프롬프트는
모든 글을 일러스트하는 방법에 대한 글에 공개해 두었습니다.
200페이지 시리즈의 시각적 일관성 유지하기
반복의 반대쪽에 있는 실패는 비일관성입니다: 하나의 클러스터에 속한 20개 페이지 각각이 기술적으로는 올바른 사진을 쓰고 있지만 20개의 서로 다른 시각적 톤을 가진 경우입니다. 이를 해결하는 것은 엔드포인트 하나 — GET /photos/{id}/similar — 를 필러 페이지용으로 승인한 사진에 대해 한 번 실행하는 것입니다:
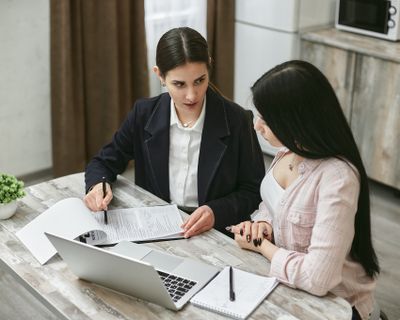
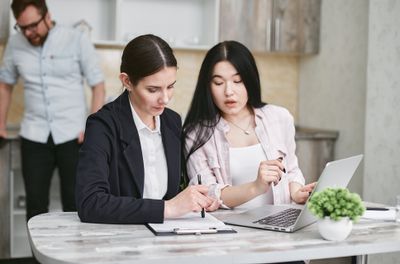
브랜드 일관성이 요구 사항일 때 풀 쿼리에 추가로 연결해 볼 만한 레버 두 가지가 더 있습니다: color_hex와 color_tolerance를 함께 쓰면 전체 자산을 하나의 팔레트 안에 유지할 수 있고, photographer는 클러스터를 특정 사진가의 작품군에 고정합니다. 둘 다 일반적인 쿼리 파라미터이며 — 검색 필터에는 플랜별 제한이 없습니다.
속도 제한, 할당량, 그리고 실제 비용
플랜은 물량이 아니라 버스트(burst) 기준으로 선택하십시오. 일단 풀링을 하면 월간 할당량은 거의 모든 경우에 더 이상 제약이 되지 않습니다. 플랜을 결정하는 것은 전체 새로고침이 얼마나 빨리 끝나야 하는가입니다.
| 플랜 | 월간 요청 수= 새로고침 가능한 클러스터 수 | 속도 제한 | API 키 | 1,000개 클러스터 새로고침실제 소요 시간, 1회 처리 |
|---|---|---|---|---|
| Free — $0 | 5,000 | 분당 20 | 1 | 50 min |
| Starter — $5 | 25,000 | 분당 30 | 3 | 34 min |
| Pro — $19 | 100,000 | 분당 60 | 5 | 17 min |
| Team — $99에이전시: 클라이언트당 키 하나 | 500,000 | 분당 200 | 25 | 5 min |
| Business — $249 | 1,000,000 | 분당 300 | unlimited | 4 min |
| Enterprise — $599 | 2,000,000 | 분당 500 | unlimited | 2 min |
첫 번째 열은 클러스터 수로 읽으십시오: 풀링 요청 한 번이 클러스터 하나를 채우므로, 월간 할당량은 새로고침할 수 있는 클러스터의 수이며, 마지막 열은 해당 플랜의 속도 제한으로 1,000개 클러스터 규모의 자산을 한 번 전부 처리하는 데 걸리는 시간입니다. 둘 다 가격 카탈로그에 있는 실제 값이며 — 가격 페이지에는 동일한 속도 제한을 분당이 아니라 시간당 기준으로 표기하고 있습니다.
즉, 풀링 패턴을 쓰는 월 10,000페이지 규모의 자산은 약 500번의 요청만 소비하고 비용이 전혀 들지 않습니다. 팀을 상위 플랜으로 밀어 올리는 것은 대개 물량이 아니라 다음 세 가지 중 하나입니다: 기존 자산 전체를 하룻밤 사이에 재일러스트하는 작업, 클라이언트별 키 격리(공유 비밀키 없이 사용량을 클라이언트별로 귀속시키고 싶은 에이전시), 또는 몇 시간이 아니라 몇 분 단위로 측정되는 빌드 윈도우.
하룻밤의 디버깅을 아껴주는 운영상의 세부 사항이 두 가지 있습니다. 모든 응답에는 X-RateLimit-Limit과 X-RateLimit-Remaining이 포함되어 있어, 워커가 추측하는 대신 스스로 속도를 조절할 수 있습니다. 그리고 진짜 분당 속도 제한에 의한 429는 Retry-After를 동반하지만, 월간 할당량에 의한 차단은 의도적으로 이를 동반하지 않습니다 — 재시도해도 후자는 풀리지 않으며, 이 둘을 구분하는 워커는 더 이상 내줄 것이 없는 엔드포인트를 계속 두드리지 않게 됩니다.
에이전트가 발행을 대신할 때
콘텐츠가 에이전트에 의해 생성된다면 — 이 정도 규모에서는 점점 더 그렇게 되고 있습니다 — 풀링 계층이 사라지는 것이 아니라 위치만 옮겨갑니다. 검색 도구를 에이전트에게 제공하면, 에이전트는 클러스터 브리프를 아직 컨텍스트에 담고 있는 상태에서 Model Context Protocol 서버인 mcp.pexafy.com/mcp를 통해 풀을 채웁니다: 세 가지 도구가 있습니다 — search_photos(문장), search_photos_by_image(참조 이미지, 선택적으로 문장 추가), get_similar_photos(위에서 다룬 시리즈 일관성용 도구).
# Claude Code / CI 러너
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# 또는 .mcp.json을 커밋해서 워커 전체가 이를 물려받도록 함
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
대규모에서 실제로 통하는 지시는 글 한 편당 지시가 아니라 배치(batch) 지시이며, 이는 위에서 설명한 두 단계에 정확히 대응합니다:
You  콘텐츠 캘린더에서 가져온 토픽 클러스터 12개입니다. 각각에 대해
     카메라 브리프를 하나씩 작성하고, landscape 사진 100장을 가져와서
     풀을 Postgres에 기록해 주세요. 0.5 이상 결과가 40건 미만인
     클러스터는 표시해 주세요 — 그런 브리프는 다시 써야 합니다.

Agent  → search_photos(q="a woman signing paperwork with an insurance
           agent at a kitchen table in her home", orientation="landscape")
      ← 사진 100장 · 122 ms · 임계값 이상 87건
      … 나머지 클러스터 11개 …

      ✓ 풀 11개 기록 완료 (사진 1,043장, 전부 크레딧 표기됨)
      ⚠ "인덱스 펀드 리밸런싱" → 결과 12건. 브리프가 추상적입니다;
        제안: "노트북에서 숫자를 확인하고 있는 사람이 식탁에 앉아 있고
        옆에 노트와 커피가 놓여 있는 장면"
마지막 줄이 바로 이 루프에 스크립트가 아니라 에이전트를 두는 이유입니다: 프로그래매틱 일러스트레이션의 실패 양상은 나쁜 브리프이며, 나쁜 브리프는 언어 모델이 알아채고 다시 쓸 수 있는 바로 그런 종류의 문제입니다. 배정 단계는 결정성이 중요하고 창의성은 중요하지 않은 부분이므로 스크립트가 계속 담당합니다.
사진이 해결해 줄 수 없는 것
솔직한 섹션입니다. 여기서 설명하는 실패는 비용이 크기 때문입니다. 실제로 존재하고 크레딧이 표기된 사진은 페이지를 개선합니다. 하지만 얇은 콘텐츠를 좋은 콘텐츠로 바꾸어 주지는 않으며, 어떤 이미지 파이프라인도 검색엔진이 도움을 주기 위해서가 아니라 순위를 얻기 위해 대량 생산된 페이지를 다루는 방식을 바꾸지 않습니다. 구글의 스팸 정책은 이를 직접적으로 명시합니다: 대규모 콘텐츠 남용(scaled content abuse)은 자동화 여부와 무관하게 가치가 거의 없는 많은 페이지를 생성하는 행위를 포괄하며, 그 페이지의 일러스트는 이 판단과 무관합니다.2
따라서 유용한 관점은 좁지만 정확합니다: 사진은 이미 존재할 자격이 있는 페이지에서 직접 통제할 수 있는 품질 신호입니다. 실제로 이점이 확인되는 부분은 다음과 같습니다:
- 독자가 검증할 수 있는 출처(provenance). 사진가의 실명과 출처 URL이 포함된 크레딧 표기는 검증 가능한 주장입니다 — 익명의 저자가 쓴 페이지에 있는 출처 불명의 이미지와는 정반대입니다.
- 접근성과 Core Web Vitals. 응답에 포함된
width/height는 레이아웃 시프트를 없애고,blur_hash는 실제로 쓸 수 있는 플레이스홀더를 제공하며,alt_description은 직접 만들어내는 것이 아니라 템플릿이 개선할 수 있는 alt 텍스트 초안이 됩니다. 이를 40,000개 슬롯에 곱하면 사이트 전체의 이미지 품질 이야기가 됩니다. - 대량 생산처럼 보이지 않기. 중복 제거와 시리즈 일관성은 자산이 시각적 서명을 갖지 않도록 막아줍니다. 이는 실제 인식 비용이 실제 결과로 이어지는 문제이며, 전적으로 여러분이 통제할 수 있는 부분입니다.
그리고 라이선스는 여전히 사진을 지배합니다. Pexafy API 약관에서는 크레딧 표기를 요구하지 않으며 — 모든 결과에는 바로 렌더링할 수 있는 attribution.html과 attribution.plain이 포함되어 있습니다 — 하지만 원본 라이브러리에 붙은 라이선스는 해당 사진의 사용에 여전히 적용되며, 월 40,000장 규모에서는 나중에 감사하는 것보다 크레딧을 자동으로 렌더링하는 편이 훨씬 저렴합니다.
월요일에 시작할 곳
- 백로그를 클러스터로 묶으십시오 — 그럴듯하게 하나의 촬영 세션을 공유할 수 있는 15~30페이지 단위로. 이것이 진짜로 유일하게 수작업이 필요한 단계이며, 프로젝트가 아니라 스프레드시트 작업입니다.
- 클러스터당 카메라 브리프 하나를 작성하십시오 — 장면 묘사, 12~25 단어. 모델로 초안을 생성한 다음 직접 읽어 보십시오; 주제를 그대로 옮긴 브리프는 한눈에 티가 납니다.
- 풀 하나를 채워 보십시오 —
per_page=100요청 한 번으로. 그리고 상위 결과를 직접 눈으로 확인하십시오. 상위 10장이 쓸 만하지 않다면 엔진이 아니라 브리프가 잘못된 것입니다. - 무언가를 발행하기 전에
used_by_page컬럼을 추가하십시오. 지금 하면 5분이면 되지만 나중에는 실제 운영 중인 3,000페이지에 대한 마이그레이션이 됩니다. - 빌드 윈도우가 여러분을 밀어 올리기 전까지는 무료 플랜에서 전부 실행해 보십시오. 월 500건 요청이라면 시간이 꽤 걸릴 것입니다.
참고 자료 및 각주
1 EU AI Act, 제50조 — 2026년 8월 2일부터 적용되는 투명성 의무: 합성 이미지, 오디오, 비디오, 텍스트를 생성하는 시스템의 제공자는 결과물을 기계 판독 가능한 형식으로 표시하고, 인공적으로 생성되었음을 감지 가능하게 만들어야 합니다. 이는 AI 제공자와 배포자를 구속하는 규정이며, 웹사이트가 어떤 이미지를 게시할 수 있는가에 대한 규칙이 아닙니다.
2 구글 검색 스팸 정책 — 대규모 콘텐츠 남용(scaled content abuse): 자동화, 사람의 작업, 또는 이 둘의 조합을 통해 만들어졌는지 여부와 무관하게, 순위 조작을 주된 목적으로 하며 사용자에게 거의 가치를 제공하지 않는 많은 페이지를 생성하는 행위를 말합니다. 일러스트의 품질은 이 판단에서 요소가 아니며, 이것이 바로 이 글이 둘을 분리해서 다루는 이유입니다.
출처 확인일: 2026년 8월 17일: 구글 검색 스팸 정책 · AI Act 제50조 · Pexafy API 및 MCP 문서. 플랜 한도는 Pexafy 가격 테이블의 실제 값이며, 검색 소요 시간(122 ms, 48 ms)과 여기 표시된 모든 사진은 같은 날 실제로 캡처된 API 응답입니다.
자주 묻는 질문
수천 개의 프로그래매틱 SEO 페이지에 쓸 이미지는 어떻게 확보하나요?
per_page=100으로 GET /api/v1/search/photos를 한 번 요청하면 하나의 클러스터에 대해 최대 100장의 크레딧 사진이 반환됩니다. 이를 풀 테이블에 저장해두고 발행 시점에 페이지마다 한 장씩 배정하면 됩니다. 페이지당 이미지 4장씩, 월 10,000페이지 규모라면 40,000번이 아니라 약 500번의 요청으로 충분하며, 이는 무료 플랜(월 5,000회 요청)으로도 감당됩니다.대량 콘텐츠 제작에 가장 적합한 스톡 사진 API는 무엇인가요?
같은 스톡 사진이 여러 페이지에 중복 노출되지 않게 하려면 어떻게 하나요?
photo_id를 저장하고, 풀에서 사진을 가져올 때는 트랜잭션으로 처리하세요 — SQL이라면 UPDATE … WHERE used_by_page IS NULL … FOR UPDATE SKIP LOCKED 형태입니다. 이렇게 하면 중복 제거가 확률적이 아니라 정확해지고, 병렬로 실행되는 빌드 워커들이 같은 상위 순위 사진을 두고 경쟁하는 일이 없습니다. 이는 컬럼 하나만 추가하면 되는 일이지만, 이미 운영 중인 수천 개의 페이지에 나중에 적용하려면 훨씬 큰 비용이 듭니다.API 요청 한 번으로 사진을 몇 장까지 받을 수 있나요?
per_page=100을 사용하면 최대 100장까지 받을 수 있고, 커서 페이지네이션을 활용하면 같은 순위 결과 집합을 계속 따라가며 더 깊은 풀을 구성할 수 있습니다. score_threshold를 함께 사용하면 얕은 클러스터에서는 느슨한 매칭 100개 대신 강력한 매칭 40개만 반환되며, fields를 사용하면 템플릿이 실제로 렌더링하는 속성만 받아 대량 처리 시 응답 크기를 작게 유지할 수 있습니다.실제 사진을 넣으면 대량 생산된 페이지의 순위가 더 잘 나오나요?
AI 에이전트가 자동으로 이미지 풀을 채울 수 있나요?
mcp.pexafy.com/mcp를 통해 가능합니다. 이 서버는 search_photos, search_photos_by_image, photo_similar를 제공합니다. 에이전트에게 클러스터 목록을 주면 각각에 대해 카메라 브리프를 하나씩 작성하고, 풀을 채운 뒤, 강력한 매칭이 너무 적게 반환된 브리프를 표시해줍니다 — 이것이 실제로 프로그래매틱 삽화 작업에서 발생하는 실패 유형입니다. 배정 작업은 여러분의 스크립트 안에 그대로 두는 것이 좋습니다. 창의성보다 결정론적 처리가 더 중요한 부분이기 때문입니다.

