Illustra 10.000 pagine al mese con foto reali — in 500 chiamate API
Cerca una volta per cluster tematico invece che una volta per immagine, e 40.000 chiamate API diventano 500. Il pattern pool-and-assign, il worker che sopravvive ai rate limit e una sezione onesta su ciò che le fotografie non possono risolvere.
 Marouane Tijani
12 min di lettura

Esiste una versione del problema dell'illustrazione dei contenuti che nessuna quantità di buon gusto risolve: non state scegliendo una foto, state riempiendo 40.000 slot immagine al mese su 800 cluster tematici, 9 locali e 14 siti clienti, e ognuno di essi deve essere licenziato, accreditato, dimensionato e diverso da quello accanto. A quel volume la domanda smette di essere "quale foto?" e diventa "qual è l'architettura?"
Questo articolo è la risposta API: lo schema di richiesta che riduce il numero di chiamate di due ordini di grandezza, il worker che sopravvive ai rate limit, la deduplicazione che impedisce a un sito da 10.000 pagine di sembrare un muro della stessa foto stock — e una sezione onesta su cosa le immagini non possono fare per voi.
Il vero collo di bottiglia a 10.000 articoli
I team che pubblicano su larga scala — proprietà di programmatic SEO, pagine categoria di marketplace, aggregatori, reti di affiliazione, agenzie che gestiscono contenuti per un portfolio di clienti, pipeline di localizzazione che trasformano un articolo in 20 — incontrano tutti gli stessi tre muri, nello stesso ordine:
- Numero di chiamate. Una ricerca per slot immagine significa 40.000 chiamate API per 10.000 articoli da quattro immagini. Ogni provider vi fa pagare, limita e valuta su quel numero.
- Ripetizione. Intorno alla pagina trenta, la stessa foto ricomincia a ricomparire. Alla pagina tremila, il vostro sito ha una firma visiva: generato in blocco.
- Coordinamento. Cento articoli in un cluster dovrebbero somigliare a una serie, non a cento bacheche Pinterest scollegate tra loro — e la locale successiva dello stesso articolo dovrebbe riusare la stessa immagine, non cercare di nuovo in un'altra lingua.
Notate cosa non è in quella lista: trovare una buona foto. Un motore semantico restituisce una pagina di candidati utilizzabili in circa 130 millisecondi. Il retrieval era risolto; la distribuzione no. Tutto quello che segue riguarda la distribuzione.
Perché foto reali, in particolare a questo volume
L'argomento a favore della fotografia rispetto alla generazione si rafforza all'aumentare del volume, per ragioni che sono soprattutto operative piuttosto che estetiche.
| A 40.000 immagini/mese | Generarle | Cercarle |
|---|---|---|
| Tempo per immagine | Da secondi a minuti, più i tentativi scartati | Una richiesta (~130 ms) copre un intero cluster |
| Fattore di costo | Per immagine, per sempre | Per richiesta — e una richiesta serve ~25 articoli |
| Metadati che ottenete | Nessuno. Scrivete voi stessi l'alt text e le dimensioni | Dimensioni, colore dominante, blur hash, bozza di didascalia, riga di credito |
| Provenienza | Contrassegnata come sintetica dalla macchina secondo l'AI Act UE dal 2 agosto 20261 | Un fotografo con nome, una data, un URL sorgente che un lettore può aprire |
| Modalità di fallimento | Dettagli plausibili ma errati, stile uniforme | Nulla corrisponde al brief — ottenete zero risultati, cosa che potete gestire |
La riga dei metadati è quella che decide le pipeline. Ogni risultato di ricerca porta già con sé
width, height, blur_hash, color_hex,
alt_description e una stringa attribution.html pronta all'uso — che è
esattamente il payload di cui un motore di templating ha bisogno per generare un
<img> senza layout shift con un placeholder e un credito. Le immagini generate vi danno un file e
lasciano a voi da inventare gli altri sei campi.
Dove la generazione vince ancora su larga scala. L'illustrazione a livello di categoria per tassonomie astratte ("migrazione al cloud", "fondi indicizzati"), diagrammi, e uno stile aziendale che volete ripetere su un'intera proprietà per motivi di brand. La suddivisione a cui approdano la maggior parte dei grandi editori: fotografie per tutto ciò che esiste nel mondo, arte generata per tutto ciò che esiste solo in un'argomentazione. Abbiamo esposto per intero questa suddivisione in come illustrare ogni articolo che pubblicate.
Una richiesta, cento foto
Questo è l'unico cambiamento che ridisegna l'aritmetica. L'endpoint di ricerca accetta
per_page fino a 100, e la paginazione a cursore vi permette di continuare a scorrere
lo stesso set di risultati classificato. Quindi l'unità di lavoro non è un'immagine, è un pool.
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a woman signing paperwork with an insurance agent at a kitchen table in her home" \
  --data-urlencode "per_page=100" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "score_threshold=0.5" \
  --data-urlencode "fields=photo_id,urls,width,height,blur_hash,alt_description,attribution"

# → { "success": true, "data": [ …fino a 100 foto… ],
#     "pagination": { "per_page": 100, "has_more": true, "next_cursor": "eyJyc…" },
#     "meta": { "took_ms": 122.33, "request_id": "7ff1fb9b-…" } }
Tre parametri qui dentro fanno un lavoro silenzioso su larga scala:
fields— un fieldset ridotto. Richiedete i sette campi che il vostro template renderizza e la risposta smette di trasportare la lunga descrizione AI di ogni foto. Su 40.000 foto è la differenza tra una build che scorre in streaming e una che va in swap.score_threshold— la coda di una pagina da 100 risultati è, per definizione, meno rilevante della testa. Impostare una soglia minima significa che un cluster con poco materiale restituisce 34 foto invece di 100 mediocri, e la vostra pipeline può reagire a questo invece di pubblicarlo.next_cursor— quando un cluster ha davvero bisogno di 300 foto, paginate lo stesso set classificato invece di lanciare tre query diverse che si sovrappongono.
Ed ecco l'aritmetica, per un sito che pubblica 10.000 pagine al mese con quattro immagini ciascuna:
| Strategia | Richieste / mese | Un passaggio al rate limit del piano free20 req/min | Rientra nella quota mensile free? |
|---|---|---|---|
| Una ricerca per slot immagine | 40.000 | 33 hours | No — serve un piano a pagamento |
| Una ricerca per articolo | 10.000 | 8 hours | No — serve un piano a pagamento |
| Una ricerca per cluster di ~20 articolilo schema di questo articolo | 500 | 25 minutes | Sì |
Stesse 40.000 immagini pubblicate in tutte e tre le righe. L'unica cosa che cambia è dove si trova il ciclo.
Pool e assegnazione: lo schema che scala
L'intera architettura è costituita da due fasi che vengono eseguite a frequenze diverse, con una tabella tra loro:
                     ┌─────────── eseguito settimanalmente, ~500 richieste ────┐
  cluster tematici ─▶ POOL   cerca una volta per cluster, per_page=100
                     │       └─▶ memorizza 100 righe foto per cluster
                     └──────────────────┬───────────────────────────────┘
                                        ▼
                              tabella image_pool
                        (cluster, photo_id, urls, blur_hash,
                         alt, credit, used_by_page, used_at)
                                        │
                     ┌──────────────────┴──── eseguito ad ogni pubblicazione, 0 richieste ──┐
  articolo ────────▶ ASSIGN  scegli la migliore riga non usata per questo
                     │        cluster, contrassegnala come usata, renderizza
                     └────────────────────────────────────────────────────────┘
Ciò che questo vi offre, in ordine di importanza a livello di volume:
- La pubblicazione non si blocca mai su una API. L'assegnazione è una lettura da database. L'hook di salvataggio del vostro CMS, la vostra build statica e la vostra importazione massiva delle 3 del mattino corrono tutti alla velocità locale, offline, senza rate limit lungo il percorso.
- La deduplicazione è gratuita ed esatta.
used_by_page IS NULLè l' intera funzionalità. Due pagine non possono ottenere la stessa foto, perché l'assegnazione è una transazione, non un' euristica di ranking. - Le riesecuzioni sono economiche e idempotenti. Aggiornate il pool di un cluster quando si esaurisce
o quando volete fotografie più recenti (
after_date, osort_by=newest) — una richiesta, e nulla di già pubblicato si sposta. - Le locale sono gratuite. Le 20 traduzioni di un articolo sono una pagina nel
vostro modello con 20 rendering; condividono il
photo_idassegnato e non cercate mai due volte. Quando volete davvero un look girato localmente, eseguite la query del pool per quel cluster nella lingua di destinazione — il motore accetta una frase in oltre 100 lingue.
Il worker, in codice
Circa sessanta righe. Il riempitore di pool è l'unica parte che parla con la rete, quindi è la
sola parte che deve essere gestita con attenzione — concorrenza limitata, 429 rispettato, risultati
scritti in un'unica transazione.
import asyncio, os, time, httpx

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
KEY    = os.environ["PEXAFY_API_KEY"]
FIELDS = "photo_id,urls,width,height,blur_hash,alt_description,attribution"

# Free = 20 req/min. State un margine di uno sotto. Il pacer è GLOBALE: una sleep per task
# dentro il gate di concorrenza permetterebbe a N worker di sparare a N× il rate.
PER_MIN = 19
gate    = asyncio.Semaphore(4)         # connessioni in corso
_lock   = asyncio.Lock()
_slot   = 0.0                          # prossimo momento libero sulla timeline condivisa

async def pace():
    """Assegna uno slot di richiesta ogni 60/PER_MIN secondi, per l'intera flotta."""
    global _slot
    async with _lock:
        now  = time.monotonic()
        _slot = max(now, _slot) + 60 / PER_MIN
        wait  = _slot - now
    if wait > 0:
        await asyncio.sleep(wait)

class QuotaExhausted(Exception): ...   # mensile: riprovare non aiuta

async def fill_pool(client, cluster) -> list[dict]:
    """Una richiesta → fino a 100 foto accreditate per un cluster tematico."""
    for attempt in range(4):
        await pace()
        async with gate:
            r = await client.get(
                SEARCH,
                headers={"X-Api-Key": KEY},
                params={
                    "q": cluster["camera_brief"],   # una scena, non la parola chiave
                    "per_page": 100,
                    "orientation": "landscape",
                    "score_threshold": 0.5,
                    "fields": FIELDS,
                },
                timeout=15,
            )
        if r.status_code == 429:
            retry_after = r.headers.get("Retry-After")
            if retry_after is None:            # nessun Retry-After ⇒ quota mensile,
                raise QuotaExhausted(cluster["id"])   # ferma l'intera esecuzione
            await asyncio.sleep(int(retry_after))   # al minuto: si risolve
            continue
        r.raise_for_status()
        return r.json()["data"]
    return []                                  # registralo nel log; il pool mantiene le vecchie righe

async def refill(clusters):
    async with httpx.AsyncClient(http2=True) as client:
        pools = await asyncio.gather(*(fill_pool(client, c) for c in clusters))
    for cluster, photos in zip(clusters, pools):
        db.upsert_pool(cluster["id"], photos)     # ON CONFLICT DO NOTHING su photo_id
Due dettagli lì dentro fanno la differenza tra un worker che gira incustodito e uno che vi
sveglia nel cuore della notte. Il pacer è globale, non per-task: mettere la sleep dentro il
gate di concorrenza è l'errore classico — quattro worker che ciascuno pausa 3 secondi dopo la propria
richiesta producono quattro richieste ogni 3 secondi, circa 75 al minuto, e il piano free
inizia subito a restituire 429. E i due 429 non sono la stessa
bestia: quello al minuto porta con sé Retry-After e si risolve da solo, quello di quota mensile
non lo porta e non lo porterà mai — riprovarci è un ciclo contro un muro.
L'assegnazione, la parte che gira ad ogni pubblicazione, non tocca mai la rete:
# L'unicità è imposta dallo schema, non dalla query che sta attenta.
# Una foto può stare in più pool di cluster; può essere PUBBLICATA una sola volta.
# CREATE UNIQUE INDEX one_use_per_photo ON image_pool (photo_id)
#        WHERE used_by_page IS NOT NULL;

def assign_hero(page_id: str, cluster_id: str) -> dict | None:
    for _ in range(5):                # una race persa prende semplicemente la foto successiva
        try:
            return db.query_one("""
                UPDATE image_pool p SET used_by_page = %s, used_at = NOW()
                WHERE p.id = (
                    SELECT c.id FROM image_pool c
                    WHERE c.cluster_id = %s AND c.used_by_page IS NULL
                      AND NOT EXISTS (              -- usata da QUALSIASI altro cluster?
                          SELECT 1 FROM image_pool u
                          WHERE u.photo_id = c.photo_id
                            AND u.used_by_page IS NOT NULL
                      )
                    ORDER BY c.rank ASC
                    LIMIT 1 FOR UPDATE SKIP LOCKED  -- sicuro con worker paralleli
                )
                RETURNING photo_id, urls, width, height, blur_hash, alt, credit
            """, [page_id, cluster_id])
        except UniqueViolation:      # due cluster l'hanno reclamata nello stesso ms
            continue
    return None                     # pool esaurito → amplia il brief, ricarica

# Rendering: ogni attributo proviene dalla riga — nessun layout shift, nessuna supposizione.
# <img src="{urls[regular]}" width="{width}" height="{height}"
#      alt="{alt}" loading="lazy" style="background:{blur_placeholder}">
# <figcaption>{credit}</figcaption>
Due modalità di fallimento, due meccanismi, ed entrambi sono necessari. FOR UPDATE SKIP LOCKED
gestisce la concorrenza all'interno di un cluster: generate pagine in parallelo — e a questo volume lo
farete — e due worker afferrano la stessa foto in cima alla classifica nello stesso millisecondo.
L'indice unico parziale gestisce quello che tutti dimenticano: la stessa foto legittimamente compare
nei pool di più cluster, perché cluster vicini ("assicurazione casa per
inquilini", "…per proprietari") restituiscono risultati sovrapposti. Un controllo per-cluster
used_by_page IS NULL è cieco a questo — ogni cluster crede che la foto sia
libera. Il NOT EXISTS mantiene la query onesta, e l'indice rende impossibile
sbagliare sotto concorrenza: chi perde la race ottiene una violazione, riprova, e prende la
foto successiva. Senza di esso, "nessuna pagina condivide un'immagine hero con un'altra" è un'affermazione, non una garanzia.
Quando un pool si esaurisce a metà build, il fallback che si comporta meglio è ampliare piuttosto che ripetere: eliminate l'ultima clausola del brief fotografico, rieseguite la query del pool una volta, e solo allora riusate la foto assegnata più vecchia — con una regola rigida che non finisca mai su una pagina dello stesso cluster.
Un cluster, un pool: una query reale
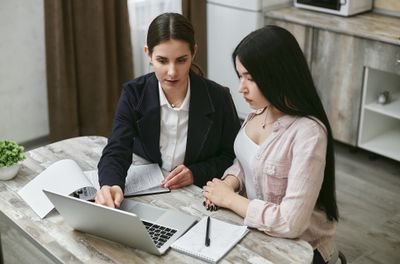
Prendete una proprietà di confronto: assicurazione casa, venti pagine — "assicurazione casa per inquilini", "…per proprietari", "cosa copre davvero una polizza", dodici pagine città, tre guide ai sinistri. Un brief fotografico per il cluster, una richiesta, e questa è la testa del pool, restituita in 122 ms:
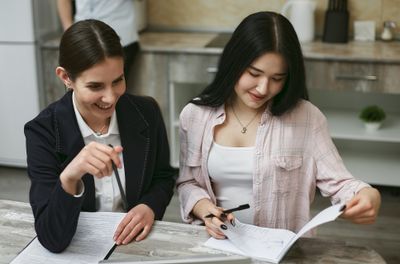
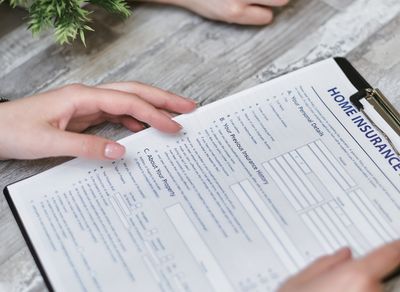
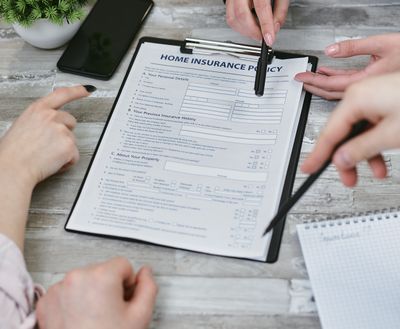
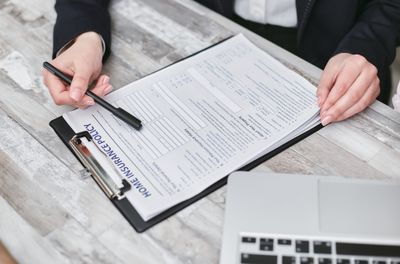
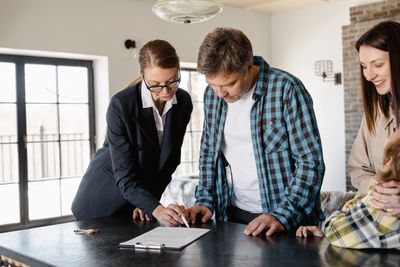
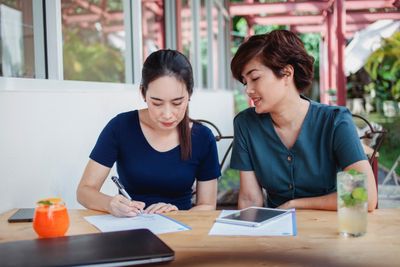
per_page=100 e conserva il resto.
Eseguite esattamente questa ricerca →
I brief contano più del codice. Due regole sopravvivono al contatto con una vera proprietà di cluster:
scrivete il brief per il cluster, non per la pagina (i titoli delle pagine sono quasi identici
tra insiemi programmatici, quindi i brief per pagina restituiscono foto quasi identiche), e descrivete una scena
che una macchina fotografica avrebbe potuto catturare piuttosto che l'argomento — assicurazione casa restituisce
primi piani di documenti e nient'altro. Abbiamo pubblicato il prompt copia-incolla che produce questi brief in
l'articolo sull'illustrare ogni articolo.
Mantenere coerente visivamente una serie di 200 pagine
Il fallimento opposto della ripetizione è l'incoerenza: venti pagine in un cluster, ognuna con una foto
tecnicamente corretta, in venti registri visivi diversi. La soluzione è un solo endpoint —
GET /photos/{id}/similar — eseguito una volta sulla foto approvata per la pagina pilastro:
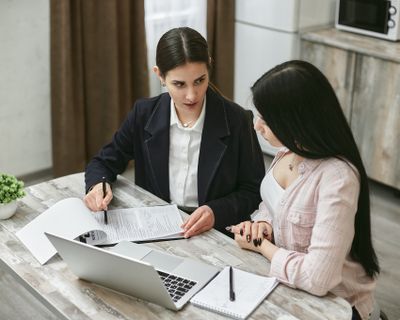
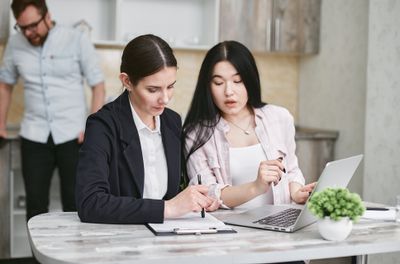
Altre due leve utili da collegare alla query del pool quando la coerenza del brand è un requisito:
color_hex con una color_tolerance mantiene un'intera proprietà dentro una
palette, e photographer ancora un cluster al corpus di un singolo fotografo. Entrambi
sono normali parametri di query — nessuna limitazione di piano sui filtri di ricerca.
Rate limit, quote e cosa costa davvero
Scegliete il piano in base al picco, non al volume. Una volta raggruppato in pool, la quota mensile smette di essere il vincolo per quasi tutti; ciò che decide il vostro piano è quanto velocemente un refresh completo deve terminare.
| Piano | Richieste / mese= cluster aggiornabili | Rate limit | Chiavi API | Refresh 1.000 clustertempo reale, un passaggio |
|---|---|---|---|---|
| Free — $0 | 5,000 | 20 / min | 1 | 50 min |
| Starter — $5 | 25,000 | 30 / min | 3 | 34 min |
| Pro — $19 | 100,000 | 60 / min | 5 | 17 min |
| Team — $99agenzie: una chiave per cliente | 500,000 | 200 / min | 25 | 5 min |
| Business — $249 | 1,000,000 | 300 / min | unlimited | 4 min |
| Enterprise — $599 | 2,000,000 | 500 / min | unlimited | 2 min |
Leggete la prima colonna come cluster: una richiesta di pool riempie un cluster, quindi la quota mensile è il numero di cluster che potete aggiornare, e l'ultima colonna è quanto tempo richiede un passaggio completo su una proprietà da 1.000 cluster al rate limit di quel piano. Entrambi sono valori live dal catalogo prezzi — la pagina dei prezzi indica gli stessi rate limit su base oraria piuttosto che al minuto.
Quindi una proprietà da 10.000 pagine al mese con lo schema raggruppato spende ~500 richieste e paga zero. Ciò che spinge i team a salire nella tabella raramente è il volume — è una di tre cose: una completa ri-illustrazione di una proprietà esistente in una notte, l'isolamento delle chiavi per cliente (un' agenzia vuole una chiave per cliente in modo che l'utilizzo sia attribuibile senza acrobazie di segreto condiviso), oppure una finestra di build misurata in minuti anziché ore.
Due dettagli operativi che vi salvano una nottata di debug. Ogni risposta porta con sé
X-RateLimit-Limit e X-RateLimit-Remaining, così un worker può regolare
il proprio ritmo invece di indovinare. E un 429 che è un vero rate limit al minuto porta con sé
Retry-After, mentre un blocco per quota mensile deliberatamente non lo fa — riprovare
non risolverà quest'ultimo, e un worker che distingue i due smette di martellare un endpoint
che non ha più nulla da offrire.
Quando è l'agente a pubblicare
Se i vostri contenuti sono prodotti da un agente — e a questi volumi lo sono sempre più spesso — lo strato di
pooling non scompare, si sposta. Date all'agente gli strumenti di ricerca e questo riempie il pool mentre
ha ancora il brief del cluster nel contesto, usando il server
Model Context Protocol su mcp.pexafy.com/mcp: tre strumenti,
search_photos (una frase), search_photos_by_image (un'immagine di riferimento,
eventualmente più una frase) e get_similar_photos (quello sulla coerenza della serie visto sopra).
# Claude Code / runner CI
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# oppure committate .mcp.json in modo che ogni worker della flotta lo erediti
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
L'istruzione che funziona su larga scala è un'istruzione di lotto, non una per singolo articolo — e si mappa uno a uno sulle due fasi viste sopra:
You  Ecco 12 cluster tematici dal calendario editoriale. Per ciascuno,
     scrivi un brief fotografico, recupera 100 foto in orizzontale, e scrivi
     il pool su Postgres. Segnala ogni cluster che restituisce meno di 40
     risultati sopra 0.5 — quei brief vanno riscritti.

Agent  → search_photos(q="a woman signing paperwork with an insurance
           agent at a kitchen table in her home", orientation="landscape")
      ← 100 foto · 122 ms · 87 sopra soglia
      … altri 11 cluster …

      ✓ 11 pool scritti (1.043 foto, tutte accreditate)
      ⚠ "ribilanciamento fondo indicizzato" → 12 risultati. Il brief è astratto;
        suggerimento: "una persona a un tavolo di cucina che controlla cifre su
        un laptop con un quaderno e un caffè accanto"
Quest'ultima riga è la ragione per mettere l'agente in questo ciclo piuttosto che uno script: la modalità di fallimento dell'illustrazione programmatica è un brief scadente, ed è esattamente ciò che un modello linguistico può notare e riscrivere. Gli script rimangono responsabili dell'assegnazione, dove il determinismo conta e la creatività no.
Ciò che le fotografie non possono risolvere
Una sezione onesta, perché il fallimento che descrive è costoso. Una fotografia reale e accreditata migliora una pagina. Non trasforma un contenuto scarso in un buon contenuto, e nessuna pipeline di immagini cambia il modo in cui i motori di ricerca trattano pagine prodotte in massa che esistono per posizionarsi piuttosto che per aiutare. Le policy anti-spam di Google lo indicano direttamente: abuso di contenuti scalati copre la generazione di molte pagine con poco valore che sia coinvolta l'automazione o meno, e le illustrazioni su quelle pagine sono irrilevanti per quel giudizio.2
Quindi l'inquadratura utile è ristretta e vera: la fotografia è un segnale di qualità che controllate su pagine che meritano già di esistere. Dove porta un beneficio dimostrabile:
- Provenienza verificabile da un lettore. Una riga di credito con il nome di un fotografo e un URL sorgente è un'affermazione che può essere verificata — l'opposto di un'immagine senza attribuzione su una pagina con un autore senza attribuzione.
- Accessibilità e Core Web Vitals.
width/heightdalla risposta eliminano il layout shift,blur_hashfornisce un vero placeholder, ealt_descriptionè una bozza di alt text che il vostro template può migliorare piuttosto che inventare. Moltiplicate per 40.000 slot e questa è l'intera storia della qualità delle immagini del sito. - Non sembrare prodotto in massa. Deduplicazione e coerenza della serie sono ciò che impedisce a una proprietà di avere una firma visiva. Questo è un costo percettivo reale con conseguenze reali, ed è interamente sotto il vostro controllo.
E la licenza continua a governare l'immagine. L'attribuzione non è richiesta dai termini API di Pexafy —
ogni risultato porta con sé attribution.html e attribution.plain pronti al
rendering — ma la licenza allegata dalla libreria originale si applica al vostro uso di quella foto, e
a 40.000 immagini al mese, renderizzare il credito automaticamente è più economico che fare audit in seguito.
Da dove iniziare lunedì
- Raggruppate il vostro arretrato in cluster di 15–30 pagine che potrebbero plausibilmente condividere un servizio fotografico. Questo è l'unico passaggio genuinamente manuale, ed è un foglio di calcolo, non un progetto.
- Scrivete un brief fotografico per cluster — una scena, da 12 a 25 parole. Generateli con un modello, poi leggeteli; i brief che nominano un argomento invece di una scena sono visibili a colpo d'occhio.
- Riempite un pool con una singola richiesta
per_page=100e date un'occhiata alla testa del pool. Se i primi dieci non sono utilizzabili, il brief è sbagliato — non il motore. - Aggiungete la colonna
used_by_pageprima di pubblicare qualsiasi cosa. Sono cinque minuti adesso e una migrazione su 3.000 pagine live più tardi. - Eseguite tutto sul piano free finché una finestra di build non vi costringe a salire. A 500 richieste al mese, ci vorrà un po'.
Riferimenti e note
1 AI Act UE, Articolo 50 — obblighi di trasparenza applicabili dal 2 agosto 2026: i fornitori di sistemi che generano immagini, audio, video o testo sintetici devono contrassegnare gli output in un formato leggibile da macchina e renderli rilevabili come generati artificialmente. Vincola i fornitori e i deployer di AI; non è una regola su quali immagini un sito web possa pubblicare.
2 Policy anti-spam di Google Search — abuso di contenuti scalati: generare molte pagine principalmente per manipolare il ranking e offrire poco valore agli utenti, che siano create tramite automazione, sforzo umano o una combinazione. La qualità dell'illustrazione non è un fattore in quella valutazione, ed è precisamente per questo che questo articolo separa le due cose.
Fonti verificate il 17 agosto 2026: Policy anti-spam di Google Search · AI Act Articolo 50 · Documentazione API & MCP di Pexafy. I limiti dei piani sono i valori live dalla tabella prezzi di Pexafy; i tempi di ricerca (122 ms, 48 ms) e ogni foto mostrata sono risposte API reali catturate lo stesso giorno.
Domande frequenti
Come ottengo immagini per migliaia di pagine SEO programmatiche?
GET /api/v1/search/photos con per_page=100 restituisce fino a 100 foto accreditate per un cluster; le memorizzi in una tabella pool e ne assegni una per pagina al momento della pubblicazione. Un sito da 10.000 pagine al mese con quattro immagini per pagina richiede circa 500 richieste invece di 40.000, il che rientra nel piano gratuito (5.000 richieste/mese).Qual è la migliore API di foto stock per la produzione di contenuti ad alto volume?
Come evito che la stessa foto stock appaia su più pagine?
photo_id di ogni immagine che pubblichi e reclama le foto dal pool in modo transazionale — in SQL, un UPDATE … WHERE used_by_page IS NULL … FOR UPDATE SKIP LOCKED. La deduplicazione diventa quindi esatta anziché probabilistica, e i worker di build paralleli non possono competere per la stessa foto in cima ai risultati. È una sola colonna, e aggiungerla retroattivamente su migliaia di pagine già live è molto più costoso che inserirla fin dal primo giorno.Quante foto può restituire una singola richiesta API?
per_page=100, e la paginazione con cursore ti permette di continuare a scorrere lo stesso set di risultati ordinati per pool più profondi. Combinalo con score_threshold in modo che un cluster poco popolato restituisca 40 corrispondenze forti anziché 100 approssimative, e con fields per restituire solo gli attributi che il tuo template renderizza, mantenendo le risposte leggere su larga scala.Le foto reali aiutano le pagine prodotte su larga scala a posizionarsi meglio?
Un agente AI può riempire un pool di immagini automaticamente?
mcp.pexafy.com/mcp, che espone search_photos, search_photos_by_image e photo_similar. Dai all'agente un elenco di cluster e lui scrive un brief fotografico per ciascuno, recupera i pool e segnala i brief che hanno restituito troppo poche corrispondenze forti — che è la vera modalità di fallimento dell'illustrazione programmatica. L'assegnazione resta nei tuoi script, dove il determinismo conta più della creatività.

