हर महीने 10,000 पेज को असली फ़ोटो से सजाएँ — सिर्फ़ 500 API कॉल में
हर इमेज के लिए नहीं, हर टॉपिक क्लस्टर के लिए एक बार सर्च करें और 40,000 API कॉल घटकर 500 रह जाती हैं। पूल-एंड-असाइन पैटर्न, रेट लिमिट झेलने वाला वर्कर, और एक ईमानदार सेक्शन कि तस्वीरें क्या ठीक नहीं कर सकतीं।
 Marouane Tijani
12 मिनट पढ़ना

कंटेंट-इलस्ट्रेशन की समस्या का एक रूप ऐसा है जिसे कितनी भी अच्छी रुचि हल नहीं कर सकती: आप एक फ़ोटो नहीं चुन रहे, आप 800 टॉपिक क्लस्टर, 9 लोकेल और 14 क्लाइंट साइटों में महीने के 40,000 इमेज स्लॉट भर रहे हैं, और उनमें से हर एक को लाइसेंस्ड, क्रेडिटेड, सही आकार का और अपने बगल वाले से अलग होना चाहिए। उस मात्रा पर प्रश्न “कौन-सी फ़ोटो?” रहना बंद कर देता है और बन जाता है “आर्किटेक्चर क्या है?”
यह लेख API उत्तर है: वह अनुरोध पैटर्न जो कॉल गिनती को दो क्रम-परिमाण घटा देता है, वह वर्कर जो रेट लिमिट झेल जाता है, वह डीडुप्लिकेशन जो 10,000-पेज वाली साइट को एक ही स्टॉक फ़ोटो की दीवार जैसा दिखने से बचाता है — और एक ईमानदार अनुभाग कि तस्वीरें आपके लिए क्या नहीं कर सकतीं।
10,000 लेखों पर असली अड़चन
बड़े पैमाने पर प्रकाशित करने वाली टीमें — प्रोग्रामैटिक SEO एस्टेट, मार्केटप्लेस कैटेगरी पेज, एग्रीगेटर, एफ़िलिएट नेटवर्क, क्लाइंट पोर्टफ़ोलियो के लिए कंटेंट चलाने वाली एजेंसियाँ, एक लेख को 20 में बदलने वाली लोकलाइज़ेशन पाइपलाइनें — सब एक ही तीन दीवारों से, उसी क्रम में टकराती हैं:
- कॉल गिनती। प्रति इमेज स्लॉट एक खोज का मतलब है 10,000 चार-छवि वाले लेखों के लिए 40,000 API कॉल। हर प्रोवाइडर उसी संख्या पर आपकी कीमत तय करता है, थ्रॉटल करता है और समीक्षा करता है।
- पुनरावृत्ति। लगभग तीसवें पेज पर वही फ़ोटो दोबारा दिखने लगती है। तीन हज़ारवें पेज पर आपकी साइट का एक दृश्य हस्ताक्षर बन जाता है: थोक में बनाया गया।
- समन्वय। एक क्लस्टर के सौ लेख एक शृंखला जैसे दिखने चाहिए, सौ असंबद्ध Pinterest बोर्ड जैसे नहीं — और उसी लेख के अगले लोकेल को वही तस्वीर दोबारा उपयोग करनी चाहिए, दूसरी भाषा में फिर से खोजना नहीं चाहिए।
ध्यान दें कि इस सूची में क्या नहीं है: एक अच्छी फ़ोटो ढूँढना। एक सिमैंटिक इंजन लगभग 130 मिलीसेकंड में उपयोगी उम्मीदवारों का एक पेज लौटा देता है। रिट्रीवल हल हो चुका था; वितरण नहीं। नीचे सब कुछ वितरण के बारे में है।
असली फ़ोटो क्यों, ख़ासकर इस मात्रा पर
जनरेशन के मुक़ाबले फ़ोटोग्राफ़ी का तर्क मात्रा बढ़ने के साथ और मज़बूत होता जाता है, ऐसे कारणों से जो सौंदर्यात्मक से ज़्यादा परिचालनात्मक हैं।
| 40,000 छवियाँ/माह पर | उन्हें जनरेट करना | उन्हें खोजना |
|---|---|---|
| प्रति छवि समय | सेकंड से मिनट, साथ में अस्वीकृत प्रयास | एक अनुरोध (~130 ms) पूरे क्लस्टर को कवर करता है |
| लागत का चालक | प्रति छवि, हमेशा | प्रति अनुरोध — और एक अनुरोध ~25 लेखों को सेवा देता है |
| आपको मिलने वाला मेटाडेटा | कुछ नहीं। alt टेक्स्ट और आयाम आप स्वयं लिखते हैं | आयाम, प्रमुख रंग, ब्लर हैश, कैप्शन ड्राफ़्ट, क्रेडिट लाइन |
| उद्गम | 2 अगस्त 2026 से EU AI Act के तहत मशीन-चिह्नित सिंथेटिक1 | एक नामित फ़ोटोग्राफ़र, एक तारीख़, एक स्रोत URL जिसे पाठक खोल सके |
| विफलता का रूप | विश्वसनीय पर ग़लत विवरण, एकसमान हाउस स्टाइल | ब्रीफ़ से कुछ मेल नहीं खाया — शून्य परिणाम मिलते हैं, जिन्हें आप संभाल सकते हैं |
मेटाडेटा वाली पंक्ति ही पाइपलाइनों का फ़ैसला करती है। हर खोज परिणाम पहले से
width, height, blur_hash, color_hex,
alt_description और एक तैयार attribution.html स्ट्रिंग लेकर आता है — यही
वह पेलोड है जिसकी एक टेम्प्लेटिंग इंजन को लेआउट-शिफ़्ट-मुक्त
<img> प्लेसहोल्डर और क्रेडिट के साथ बनाने के लिए ज़रूरत होती है। जनरेट की गई छवियाँ आपको एक फ़ाइल देती हैं और
बाक़ी छह फ़ील्ड आपके गढ़ने के लिए छोड़ देती हैं।
स्केल पर जनरेशन अब भी कहाँ जीतता है। अमूर्त टैक्सोनॉमी (“cloud migration”, “index funds”) के लिए श्रेणी-स्तरीय इलस्ट्रेशन, डायग्राम, और वह हाउस स्टाइल जिसे आप ब्रांड कारणों से पूरे एस्टेट में दोहराना चाहते हैं। अधिकांश बड़े प्रकाशक जिस विभाजन पर पहुँचते हैं: जो कुछ दुनिया में मौजूद है उसके लिए फ़ोटोग्राफ़, और जो केवल एक तर्क में मौजूद है उसके लिए जनरेटेड आर्ट। उस विभाजन का पूरा तर्क हमने how to illustrate every article you publish में रखा है।
एक अनुरोध, सौ फ़ोटो
यही वह अकेला बदलाव है जो गणित को नए सिरे से गढ़ता है। सर्च एंडपॉइंट
per_page को 100 तक लेता है, और कर्सर पेजिनेशन आपको
उसी रैंक किए गए परिणाम-सेट में आगे चलते रहने देता है। तो काम की इकाई एक छवि नहीं, एक पूल है।
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a woman signing paperwork with an insurance agent at a kitchen table in her home" \
  --data-urlencode "per_page=100" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "score_threshold=0.5" \
  --data-urlencode "fields=photo_id,urls,width,height,blur_hash,alt_description,attribution"

# → { "success": true, "data": [ …100 तक फ़ोटो… ],
#     "pagination": { "per_page": 100, "has_more": true, "next_cursor": "eyJyc…" },
#     "meta": { "took_ms": 122.33, "request_id": "7ff1fb9b-…" } }
इसमें तीन पैरामीटर स्केल पर चुपचाप काम कर रहे हैं:
fields— एक स्पार्स फ़ील्डसेट। उन सात फ़ील्ड माँगें जिन्हें आपका टेम्प्लेट रेंडर करता है और रिस्पॉन्स हर फ़ोटो का लंबा AI विवरण भेजना बंद कर देता है। 40,000 फ़ोटो पर यह उस बिल्ड और दूसरे बिल्ड का अंतर है जो स्ट्रीम करता है बनाम जो स्वैप करता है।score_threshold— 100-परिणाम वाले पेज की पूँछ, परिभाषा से, सिर से कम प्रासंगिक होती है। एक फ़्लोर तय करने का मतलब है कि पतला क्लस्टर 100 औसत दर्जे की जगह 34 फ़ोटो लौटाता है, और आपकी पाइपलाइन उसे प्रकाशित करने के बजाय उस पर प्रतिक्रिया दे सकती है।next_cursor— जब किसी क्लस्टर को सचमुच 300 फ़ोटो चाहिए, तो तीन अलग-अलग ओवरलैप करती क्वेरी चलाने के बजाय उसी रैंक किए गए सेट को पेजिनेट करें।
और यह रहा गणित, उस साइट के लिए जो महीने में 10,000 पेज प्रकाशित करती है, प्रत्येक में चार छवियाँ:
| रणनीति | अनुरोध / माह | फ्री प्लान की रेट लिमिट पर एक पास20 req/min | क्या फ्री मासिक कोटा में समाता है? |
|---|---|---|---|
| प्रति इमेज स्लॉट एक खोज | 40,000 | 33 hours | नहीं — एक पेड प्लान |
| प्रति लेख एक खोज | 10,000 | 8 hours | नहीं — एक पेड प्लान |
| ~20 लेखों के प्रति क्लस्टर एक खोजइस लेख का पैटर्न | 500 | 25 minutes | हाँ |
तीनों पंक्तियों में वही 40,000 प्रकाशित छवियाँ। बदला केवल यह कि लूप कहाँ बैठा है।
पूल और असाइन: वह पैटर्न जो स्केल करता है
पूरा आर्किटेक्चर दो चरण हैं जो अलग-अलग आवृत्तियों पर चलते हैं, और बीच में एक टेबल है:
                     ┌────── साप्ताहिक चलता है, ~500 अनुरोध ──────┐
  topic clusters ──▶ POOL   प्रति क्लस्टर एक खोज, per_page=100
                     │       └─▶ प्रति क्लस्टर 100 फ़ोटो पंक्तियाँ संग्रहीत करें
                     └──────────────────┬───────────────────────────────┘
                                        ▼
                              image_pool table
                        (cluster, photo_id, urls, blur_hash,
                         alt, credit, used_by_page, used_at)
                                        │
                     ┌──────────────────┴──── प्रति प्रकाशन चलता है, 0 अनुरोध ───┐
  article ─────────▶ ASSIGN  इस क्लस्टर के लिए सर्वोत्तम अप्रयुक्त पंक्ति चुनें,
                     │        उसे used चिह्नित करें, रेंडर करें
                     └────────────────────────────────────────────────────────┘
इससे आपको क्या मिलता है, इस क्रम में कि मात्रा पर कितना मायने रखता है:
- प्रकाशन कभी API पर नहीं अटकता। असाइनमेंट एक डेटाबेस रीड है। आपका CMS सेव हुक, आपका स्टैटिक बिल्ड और रात 3 बजे का बल्क इम्पोर्ट सब स्थानीय गति पर, ऑफ़लाइन चलते हैं, पथ में कहीं भी कोई रेट लिमिट नहीं।
- डीडुप्लिकेशन मुफ़्त और सटीक है।
used_by_page IS NULLही पूरा फ़ीचर है। दो पेज एक ही फ़ोटो नहीं खींच सकते, क्योंकि असाइनमेंट एक ट्रांज़ैक्शन है, कोई रैंकिंग ह्यूरिस्टिक नहीं। - दोबारा चलाना सस्ता और आइडेम्पोटेंट है। जब क्लस्टर का पूल कम पड़ जाए
या जब आप नई फ़ोटोग्राफ़ी चाहें तो उसे रिफ़्रेश करें (
after_date, याsort_by=newest) — एक अनुरोध, और जो पहले प्रकाशित है वह हिलता नहीं। - लोकेल मुफ़्त में मिलते हैं। किसी लेख के 20 अनुवाद आपके मॉडल में
एक पेज हैं जिसके 20 रेंडरिंग हैं; वे असाइन किया गया
photo_idसाझा करते हैं और आप कभी दो बार नहीं खोजते। जब आप सचमुच स्थानीय रूप से शूट किया लुक चाहें, तो उस क्लस्टर की पूल क्वेरी लक्ष्य भाषा में चलाएँ — इंजन 100 से अधिक भाषाओं में वाक्य लेता है।
वर्कर, कोड में
लगभग साठ पंक्तियाँ। पूल भरने वाला हिस्सा ही नेटवर्क से बात करता है, इसलिए वही
हिस्सा है जिसे सावधान रहना है — कॉनकरेंसी सीमित, 429 का सम्मान, परिणाम
एक ही ट्रांज़ैक्शन में लिखे गए।
import asyncio, os, time, httpx

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
KEY    = os.environ["PEXAFY_API_KEY"]
FIELDS = "photo_id,urls,width,height,blur_hash,alt_description,attribution"

# Free = 20 req/min. एक कम रहें। पेसर GLOBAL है: कॉनकरेंसी गेट के अंदर
# प्रति-टास्क sleep से N वर्कर N× दर से अनुरोध भेजेंगे।
PER_MIN = 19
gate    = asyncio.Semaphore(4)         # चालू कनेक्शन
_lock   = asyncio.Lock()
_slot   = 0.0                          # साझा टाइमलाइन पर अगला खाली क्षण

async def pace():
    """पूरे फ़्लीट में हर 60/PER_MIN सेकंड पर एक अनुरोध स्लॉट दें।"""
    global _slot
    async with _lock:
        now  = time.monotonic()
        _slot = max(now, _slot) + 60 / PER_MIN
        wait  = _slot - now
    if wait > 0:
        await asyncio.sleep(wait)

class QuotaExhausted(Exception): ...   # मासिक: पुनः प्रयास बेकार

async def fill_pool(client, cluster) -> list[dict]:
    """एक अनुरोध → एक टॉपिक क्लस्टर के लिए 100 तक क्रेडिटेड फ़ोटो।"""
    for attempt in range(4):
        await pace()
        async with gate:
            r = await client.get(
                SEARCH,
                headers={"X-Api-Key": KEY},
                params={
                    "q": cluster["camera_brief"],   # एक दृश्य, कीवर्ड नहीं
                    "per_page": 100,
                    "orientation": "landscape",
                    "score_threshold": 0.5,
                    "fields": FIELDS,
                },
                timeout=15,
            )
        if r.status_code == 429:
            retry_after = r.headers.get("Retry-After")
            if retry_after is None:            # Retry-After नहीं ⇒ मासिक कोटा,
                raise QuotaExhausted(cluster["id"])   # पूरा रन रोकें
            await asyncio.sleep(int(retry_after))   # प्रति-मिनट: यह साफ़ हो जाता है
            continue
        r.raise_for_status()
        return r.json()["data"]
    return []                                  # लॉग करें; पूल पुरानी पंक्तियाँ रखता है

async def refill(clusters):
    async with httpx.AsyncClient(http2=True) as client:
        pools = await asyncio.gather(*(fill_pool(client, c) for c in clusters))
    for cluster, photos in zip(clusters, pools):
        db.upsert_pool(cluster["id"], photos)     # photo_id पर ON CONFLICT DO NOTHING
इसमें दो विवरण ही उस वर्कर और उस वर्कर के बीच का अंतर हैं जो बिना निगरानी चलता है बनाम जो
आपको रात में जगाता है। पेसर ग्लोबल है, प्रति-टास्क नहीं: sleep को
कॉनकरेंसी गेट के अंदर रखना क्लासिक ग़लती है — चार वर्कर, हर एक अपने अनुरोध के बाद
3 सेकंड रुकता हुआ, हर 3 सेकंड में चार अनुरोध पैदा करता है, लगभग 75 प्रति मिनट, और फ्री प्लान
तुरंत 429 लौटाने लगता है। और दोनों 429 एक ही
जीव नहीं हैं: प्रति-मिनट वाला Retry-After लाता है और स्वयं साफ़ हो जाता है, मासिक-कोटा
वाला उसे नहीं लाता और कभी नहीं लाएगा — उस पर पुनः प्रयास दीवार से टकराता लूप है।
असाइनमेंट, जो हर प्रकाशन पर चलता है, नेटवर्क को कभी नहीं छूता:
# विशिष्टता स्कीमा द्वारा लागू होती है, क्वेरी की सावधानी से नहीं।
# एक फ़ोटो कई क्लस्टर पूल में हो सकती है; PUBLISH केवल एक बार हो सकती है।
# CREATE UNIQUE INDEX one_use_per_photo ON image_pool (photo_id)
#        WHERE used_by_page IS NOT NULL;

def assign_hero(page_id: str, cluster_id: str) -> dict | None:
    for _ in range(5):                # दौड़ हारने पर अगली फ़ोटो ले लें
        try:
            return db.query_one("""
                UPDATE image_pool p SET used_by_page = %s, used_at = NOW()
                WHERE p.id = (
                    SELECT c.id FROM image_pool c
                    WHERE c.cluster_id = %s AND c.used_by_page IS NULL
                      AND NOT EXISTS (              -- किसी अन्य क्लस्टर ने इस्तेमाल की?
                          SELECT 1 FROM image_pool u
                          WHERE u.photo_id = c.photo_id
                            AND u.used_by_page IS NOT NULL
                      )
                    ORDER BY c.rank ASC
                    LIMIT 1 FOR UPDATE SKIP LOCKED  -- समानांतर वर्कर के साथ सुरक्षित
                )
                RETURNING photo_id, urls, width, height, blur_hash, alt, credit
            """, [page_id, cluster_id])
        except UniqueViolation:      # दो क्लस्टर ने उसी ms में दावा किया
            continue
    return None                     # पूल खाली → ब्रीफ़ चौड़ा करें, दोबारा भरें

# रेंडरिंग: हर एट्रिब्यूट पंक्ति से आता है — कोई लेआउट शिफ़्ट नहीं, कोई अनुमान नहीं।
# <img src="{urls[regular]}" width="{width}" height="{height}"
#      alt="{alt}" loading="lazy" style="background:{blur_placeholder}">
# <figcaption>{credit}</figcaption>
दो विफलता-रूप, दो तंत्र, और दोनों ज़रूरी हैं। FOR UPDATE SKIP LOCKED
क्लस्टर के भीतर कॉनकरेंसी संभालता है: पेज समानांतर में बनाएँ — और इस मात्रा पर
आप बनाएँगे — और दो वर्कर उसी मिलीसेकंड में उसी शीर्ष-रैंक फ़ोटो तक पहुँचते हैं।
आंशिक यूनीक इंडेक्स उस समस्या को संभालता है जिसे सब भूल जाते हैं: वही फ़ोटो जायज़ तौर पर
कई क्लस्टरों के पूल में आती है, क्योंकि पड़ोसी क्लस्टर (“home insurance for
renters”, “…for landlords”) ओवरलैप करते परिणाम लौटाते हैं। प्रति-क्लस्टर
used_by_page IS NULL जाँच इसके प्रति अंधी है — हर क्लस्टर मानता है कि फ़ोटो
मुफ़्त है। NOT EXISTS क्वेरी को ईमानदार रखता है, और इंडेक्स कॉनकरेंसी के तहत
इसे ग़लत होना असंभव बना देता है: दौड़ हारने वाले को violation मिलता है, वह पुनः प्रयास करता है, और अगली
फ़ोटो लेता है। इसके बिना, “कोई दो पेज एक हीरो साझा नहीं करते” एक दावा है, गारंटी नहीं।
जब बिल्ड के बीच पूल खाली हो जाए, तो सबसे अच्छा व्यवहार करने वाला फ़ॉलबैक दोहराने के बजाय चौड़ा करना है: कैमरा ब्रीफ़ का अंतिम खंड हटाएँ, पूल क्वेरी एक बार दोबारा चलाएँ, और तभी सबसे पुरानी असाइन की गई फ़ोटो दोबारा उपयोग करें — इस सख़्त नियम के साथ कि वह उसी क्लस्टर के किसी पेज पर कभी न पहुँचे।
एक क्लस्टर, एक पूल: एक असली क्वेरी
एक तुलना एस्टेट लीजिए: home insurance, बीस पेज — “home insurance for renters”, “…for landlords”, “what a policy actually covers”, बारह सिटी पेज, तीन क्लेम गाइड। क्लस्टर के लिए एक कैमरा ब्रीफ़, एक अनुरोध, और यह पूल का शीर्ष है, जो 122 ms में लौटा:
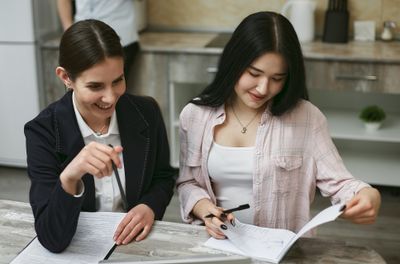
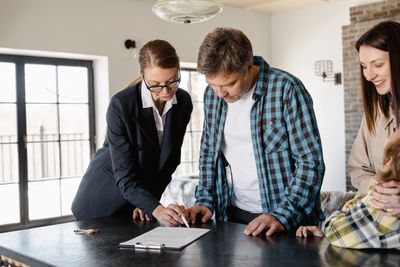
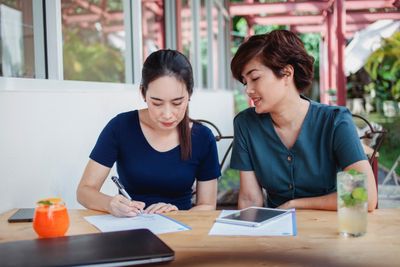
per_page=100 माँगता है और बाक़ी रख लेता है।
यही खोज चलाएँ →
ब्रीफ़ कोड से ज़्यादा मायने रखते हैं। असली क्लस्टर एस्टेट से टकराने पर दो नियम टिकते हैं:
ब्रीफ़ क्लस्टर के लिए लिखें, पेज के लिए नहीं (प्रोग्रामैटिक सेट में पेज शीर्षक लगभग एक जैसे होते हैं,
इसलिए प्रति-पेज ब्रीफ़ लगभग एक जैसी फ़ोटो लौटाते हैं), और विषय के बजाय ऐसा दृश्य वर्णित करें
जिसे कोई कैमरा खींच सकता — home insurance दस्तावेज़ों के क्लोज़-अप लौटाता है और कुछ नहीं।
इन ब्रीफ़ को बनाने वाला कॉपी-पेस्ट योग्य प्रॉम्प्ट हमने
the article on illustrating every post में प्रकाशित किया है।
200-पेज की शृंखला को दृश्यात्मक रूप से संगत रखना
पुनरावृत्ति की उलटी विफलता असंगति है: एक क्लस्टर में बीस पेज, हर एक में
तकनीकी रूप से सही फ़ोटो, बीस अलग दृश्य रजिस्टरों में। समाधान एक एंडपॉइंट है —
GET /photos/{id}/similar — जिसे आप पिलर पेज के लिए स्वीकृत फ़ोटो पर एक बार चलाते हैं:
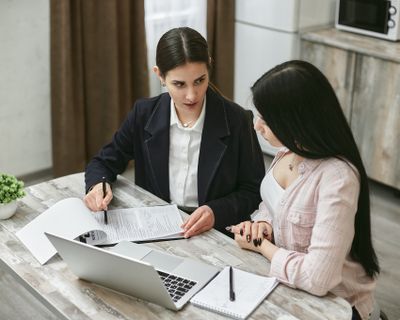
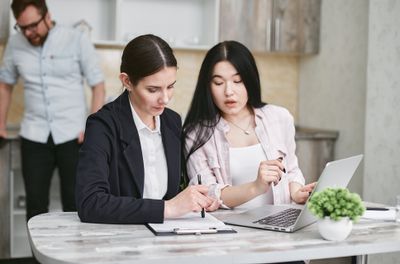
ब्रांड संगति ज़रूरी हो तो पूल क्वेरी में जोड़ने लायक दो और लीवर:
color_hex के साथ color_tolerance पूरे एस्टेट को एक
पैलेट के भीतर रखता है, और photographer किसी क्लस्टर को एक फ़ोटोग्राफ़र के काम पर टिका देता है। दोनों
सामान्य क्वेरी पैरामीटर हैं — सर्च फ़िल्टर पर कोई प्लान गेटिंग नहीं।
रेट लिमिट, कोटा और वास्तविक लागत
प्लान बर्स्ट के आधार पर चुनें, वॉल्यूम के आधार पर नहीं। एक बार पूलिंग करने के बाद मासिक कोटा लगभग सबके लिए बाधा नहीं रहता; आपका प्लान यह तय करता है कि एक पूरा रिफ़्रेश कितनी तेज़ी से पूरा होना चाहिए।
| प्लान | अनुरोध / माह= रिफ़्रेश किए जा सकने वाले क्लस्टर | रेट लिमिट | API कीज़ | 1,000 क्लस्टर रिफ़्रेशवॉल-क्लॉक, एक पास |
|---|---|---|---|---|
| Free — $0 | 5,000 | 20 / min | 1 | 50 min |
| Starter — $5 | 25,000 | 30 / min | 3 | 34 min |
| Pro — $19 | 100,000 | 60 / min | 5 | 17 min |
| Team — $99एजेंसियाँ: प्रति क्लाइंट एक की | 500,000 | 200 / min | 25 | 5 min |
| Business — $249 | 1,000,000 | 300 / min | unlimited | 4 min |
| Enterprise — $599 | 2,000,000 | 500 / min | unlimited | 2 min |
पहले कॉलम को क्लस्टर के रूप में पढ़ें: एक पूलिंग अनुरोध एक क्लस्टर भरता है, इसलिए मासिक कोटा उन क्लस्टरों की संख्या है जिन्हें आप रिफ़्रेश कर सकते हैं, और आख़िरी कॉलम बताता है कि उस प्लान की रेट लिमिट पर 1,000-क्लस्टर एस्टेट पर एक पूरा पास कितना समय लेता है। दोनों प्राइसिंग कैटलॉग से लाइव मान हैं — प्राइसिंग पेज वही रेट लिमिट प्रति मिनट के बजाय प्रति घंटा बताता है।
तो पूल्ड पैटर्न पर महीने में 10,000 पेज वाला एस्टेट ~500 अनुरोध ख़र्च करता है और कुछ नहीं चुकाता। टीमों को तालिका में ऊपर जो धकेलता है वह शायद ही कभी वॉल्यूम होता है — वह तीन में से एक चीज़ होती है: एक रात में मौजूदा एस्टेट का पूरा पुनः-इलस्ट्रेशन, प्रति-क्लाइंट की आइसोलेशन (कोई एजेंसी प्रति क्लाइंट एक की चाहती है ताकि उपयोग साझा-सीक्रेट कसरत के बिना जिम्मेदार ठहराया जा सके), या घंटों के बजाय मिनटों में मापी जाने वाली बिल्ड विंडो।
दो परिचालन विवरण जो डिबगिंग की एक रात बचाते हैं। हर रिस्पॉन्स
X-RateLimit-Limit और X-RateLimit-Remaining लाता है, ताकि वर्कर अनुमान लगाने के बजाय
ख़ुद की गति नियंत्रित कर सके। और वह 429 जो सचमुच प्रति-मिनट रेट लिमिट है,
Retry-After लाता है, जबकि मासिक-कोटा ब्लॉक जानबूझकर नहीं लाता — पुनः प्रयास
उसे साफ़ नहीं करेगा, और जो वर्कर दोनों में फ़र्क़ करता है वह ऐसे एंडपॉइंट को पीटना बंद कर देता है
जिसके पास देने को कुछ बचा ही नहीं।
जब प्रकाशन एजेंट करता है
यदि आपका कंटेंट एक एजेंट बनाता है — और इन मात्राओं पर यह बढ़ता ही जा रहा है — तो पूलिंग
परत ग़ायब नहीं होती, वह जगह बदल लेती है। एजेंट को सर्च टूल दीजिए और वह पूल तब भरता है जब
क्लस्टर ब्रीफ़ अब भी उसके संदर्भ में है,
mcp.pexafy.com/mcp पर Model Context Protocol सर्वर का उपयोग करते हुए: तीन टूल,
search_photos (एक वाक्य), search_photos_by_image (एक संदर्भ छवि,
वैकल्पिक रूप से एक वाक्य के साथ) और get_similar_photos (ऊपर वाला शृंखला-संगति टूल)।
# Claude Code / CI रनर
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# या .mcp.json कमिट करें ताकि फ़्लीट का हर वर्कर उसे पाए
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
स्केल पर जो निर्देश काम करता है वह बैच निर्देश है, प्रति-लेख वाला नहीं — और वह ऊपर के दो चरणों से एक-से-एक मेल खाता है:
You  कंटेंट कैलेंडर से 12 टॉपिक क्लस्टर यहाँ हैं। हर एक के लिए
     एक कैमरा ब्रीफ़ लिखो, 100 लैंडस्केप फ़ोटो खींचो, और
     पूल को Postgres में लिखो। जिस भी क्लस्टर में 0.5 से ऊपर 40 से कम
     परिणाम आएँ उसे फ़्लैग करो — उन ब्रीफ़ को दोबारा लिखना होगा।

Agent  → search_photos(q="a woman signing paperwork with an insurance
           agent at a kitchen table in her home", orientation="landscape")
      ← 100 फ़ोटो · 122 ms · 87 थ्रेशोल्ड से ऊपर
      … 11 और क्लस्टर …

      ✓ 11 पूल लिखे गए (1,043 फ़ोटो, सभी क्रेडिटेड)
      ⚠ "index fund rebalancing" → 12 परिणाम। ब्रीफ़ अमूर्त है;
        सुझाव: "a person at a kitchen table checking figures on a
        laptop with a notebook and coffee beside them"
वह आख़िरी पंक्ति ही कारण है कि इस लूप में स्क्रिप्ट के बजाय एजेंट रखा जाए: प्रोग्रामैटिक इलस्ट्रेशन की विफलता का रूप एक ख़राब ब्रीफ़ है, और ख़राब ब्रीफ़ ठीक वही चीज़ है जिसे भाषा मॉडल पहचान कर दोबारा लिख सकता है। स्क्रिप्ट असाइनमेंट की ज़िम्मेदार रहती हैं, जहाँ नियतत्व मायने रखता है और रचनात्मकता नहीं।
फ़ोटोग्राफ़ क्या ठीक नहीं कर सकते
एक ईमानदार अनुभाग, क्योंकि जिस विफलता का यह वर्णन करता है वह महँगी है। असली, क्रेडिटेड फ़ोटोग्राफ़ी किसी पेज को बेहतर बनाती है। यह पतले कंटेंट को अच्छा कंटेंट नहीं बनाती, और कोई भी इमेज पाइपलाइन यह नहीं बदलती कि सर्च इंजन उन बड़े पैमाने पर बने पेजों के साथ कैसा व्यवहार करते हैं जो मदद करने के बजाय रैंक करने के लिए मौजूद हैं। Google की स्पैम नीतियाँ इसे सीधे नाम देती हैं: scaled content abuse में कम मूल्य वाले बहुत सारे पेज बनाना शामिल है चाहे उसमें ऑटोमेशन हो या न हो, और उन पेजों के इलस्ट्रेशन उस निर्णय के लिए अप्रासंगिक हैं।2
तो उपयोगी ढाँचा संकीर्ण और सच्चा है: फ़ोटोग्राफ़ी एक गुणवत्ता संकेत है जो आपके नियंत्रण में है उन पेजों पर जो पहले से अस्तित्व के हक़दार हैं। यह जहाँ स्पष्ट रूप से फ़ायदा देती है:
- ऐसा उद्गम जिसे पाठक सत्यापित कर सके। फ़ोटोग्राफ़र के नाम और स्रोत URL वाली क्रेडिट लाइन एक ऐसा दावा है जिसे जाँचा जा सकता है — बिना श्रेय वाले लेखक के पेज पर बिना श्रेय वाली छवि का उल्टा।
- एक्सेसिबिलिटी और Core Web Vitals। रिस्पॉन्स से मिले
width/heightलेआउट शिफ़्ट ख़त्म करते हैं,blur_hashअसली प्लेसहोल्डर देता है, औरalt_descriptionalt टेक्स्ट का ड्राफ़्ट है जिसे आपका टेम्प्लेट गढ़ने के बजाय बेहतर कर सकता है। इसे 40,000 स्लॉट से गुणा करें और यही साइट की पूरी इमेज-गुणवत्ता कहानी है। - थोक में बना हुआ न दिखना। डीडुप्लिकेशन और शृंखला संगति ही वे चीज़ें हैं जो किसी एस्टेट को दृश्य हस्ताक्षर पाने से रोकती हैं। यह वास्तविक परिणामों वाली वास्तविक धारणा-लागत है, और यह पूरी तरह आपके नियंत्रण में है।
और लाइसेंस अब भी तस्वीर पर लागू होता है। Pexafy API शर्तों के तहत एट्रिब्यूशन आवश्यक नहीं है —
हर परिणाम रेंडर करने को तैयार attribution.html और attribution.plain भेजता है
— पर मूल लाइब्रेरी द्वारा लगाया गया लाइसेंस उस फ़ोटो के आपके उपयोग पर लागू होता है, और
महीने की 40,000 छवियों पर क्रेडिट को स्वतः रेंडर करना बाद में ऑडिट करने से सस्ता है।
सोमवार को कहाँ से शुरू करें
- अपने बैकलॉग को क्लस्टरों में समूहित करें — 15–30 पेज के, जो व्यावहारिक रूप से एक फ़ोटो शूट साझा कर सकें। यह एकमात्र सचमुच मैनुअल क़दम है, और यह एक स्प्रेडशीट है, प्रोजेक्ट नहीं।
- प्रति क्लस्टर एक कैमरा ब्रीफ़ लिखें — एक दृश्य, 12 से 25 शब्द। उन्हें मॉडल से बनवाएँ, फिर पढ़ें; जो ब्रीफ़ दृश्य के बजाय विषय का नाम लेते हैं वे एक नज़र में दिख जाते हैं।
- एक पूल भरें एक
per_page=100अनुरोध से और उसके शीर्ष पर नज़र डालें। यदि शीर्ष दस उपयोगी नहीं हैं, तो ब्रीफ़ ग़लत है — इंजन नहीं। used_by_pageकॉलम जोड़ें कुछ भी प्रकाशित करने से पहले। अभी यह पाँच मिनट है और बाद में 3,000 लाइव पेजों पर माइग्रेशन।- पूरी चीज़ फ्री प्लान पर चलाएँ जब तक कोई बिल्ड विंडो आपको ऊपर न धकेले। महीने में 500 अनुरोध पर, इसमें काफ़ी वक़्त लगेगा।
संदर्भ & फ़ुटनोट
1 EU AI Act, अनुच्छेद 50 — 2 अगस्त 2026 से लागू पारदर्शिता दायित्व: सिंथेटिक छवि, ऑडियो, वीडियो या टेक्स्ट बनाने वाली प्रणालियों के प्रदाताओं को आउटपुट मशीन-पठनीय प्रारूप में चिह्नित करना होगा और उन्हें कृत्रिम रूप से उत्पन्न के रूप में पहचान योग्य बनाना होगा। यह AI प्रदाताओं और डिप्लॉयर्स पर बाध्यकारी है; यह इस बारे में नियम नहीं है कि कोई वेबसाइट कौन-सी छवियाँ प्रकाशित कर सकती है।
2 Google Search स्पैम नीतियाँ — scaled content abuse: मुख्यतः रैंकिंग में हेरफेर के लिए बहुत सारे पेज बनाना और उपयोगकर्ताओं को कम मूल्य देना, चाहे वे ऑटोमेशन से बने हों, मानव प्रयास से या दोनों के संयोजन से। उस आकलन में इलस्ट्रेशन गुणवत्ता कोई कारक नहीं है, और ठीक इसीलिए यह लेख दोनों को अलग रखता है।
17 अगस्त 2026 को जाँचे गए स्रोत: Google Search spam policies · AI Act Article 50 · Pexafy API & MCP docs. प्लान सीमाएँ Pexafy प्राइसिंग तालिका के लाइव मान हैं; खोज समय (122 ms, 48 ms) और दिखाई गई हर फ़ोटो उसी दिन कैप्चर किए गए असली API रिस्पॉन्स हैं।
अक्सर पूछे जाने वाले प्रश्न
हज़ारों प्रोग्रामैटिक SEO पेजों के लिए इमेज कैसे लाएँ?
per_page=100 के साथ एक ही GET /api/v1/search/photos रिक्वेस्ट एक क्लस्टर के लिए 100 तक क्रेडिटेड फ़ोटो लौटाती है; आप उन्हें एक पूल टेबल में स्टोर करते हैं और पब्लिश के समय हर पेज को एक असाइन करते हैं। महीने में 10,000 पेज और प्रति पेज चार इमेज वाले सेटअप को 40,000 के बजाय लगभग 500 रिक्वेस्ट चाहिए, जो फ़्री प्लान (5,000 रिक्वेस्ट/माह) के भीतर आ जाता है।हाई-वॉल्यूम कंटेंट प्रोडक्शन के लिए सबसे अच्छा स्टॉक फ़ोटो API कौन-सा है?
एक ही स्टॉक फ़ोटो को कई पेजों पर आने से कैसे रोकूँ?
photo_id स्टोर करें और पूल से फ़ोटो ट्रांज़ैक्शनली क्लेम करें — SQL में, UPDATE … WHERE used_by_page IS NULL … FOR UPDATE SKIP LOCKED। इससे डीडुप्लीकेशन संभावनात्मक नहीं, बल्कि सटीक हो जाता है, और समानांतर बिल्ड वर्कर एक ही टॉप-रैंक्ड फ़ोटो के लिए आपस में नहीं टकरा सकते। यह सिर्फ़ एक कॉलम है, और हज़ारों लाइव पेजों पर बाद में जोड़ना पहले दिन जोड़ने से कहीं ज़्यादा महँगा पड़ता है।एक API रिक्वेस्ट कितनी फ़ोटो लौटा सकती है?
per_page=100 के ज़रिए 100 तक, और कर्सर पेजिनेशन से आप गहरे पूल के लिए उसी रैंक्ड रिज़ल्ट सेट में आगे बढ़ते रह सकते हैं। इसे score_threshold के साथ मिलाएँ ताकि पतला क्लस्टर 100 ढीले मैच के बजाय 40 मज़बूत मैच लौटाए, और fields के साथ ताकि सिर्फ़ वही एट्रिब्यूट लौटें जो आपका टेम्पलेट रेंडर करता है — इससे बड़े पैमाने पर रिस्पॉन्स छोटे रहते हैं।क्या असली फ़ोटो बड़े पैमाने पर बने पेजों की रैंकिंग सुधारती हैं?
क्या कोई AI एजेंट इमेज पूल अपने आप भर सकता है?
mcp.pexafy.com/mcp के ज़रिए, जो search_photos, search_photos_by_image और photo_similar उपलब्ध कराता है। एजेंट को क्लस्टरों की सूची दें और वह हर एक के लिए एक कैमरा ब्रीफ़ लिखता है, पूल खींचता है और उन ब्रीफ़ को फ़्लैग करता है जिनसे बहुत कम मज़बूत मैच मिले — प्रोग्रामैटिक इलस्ट्रेशन की असली विफलता यही है। असाइनमेंट आपकी स्क्रिप्ट में ही रहे, जहाँ रचनात्मकता से ज़्यादा नियतात्मकता मायने रखती है।

