मुफ़्त स्टॉक फोटो APIs की तुलना: Unsplash, Pexels, Pixabay, Openverse और Pexafy
चौदह मानदंड, पाँच APIs, और हर आँकड़ा प्रदाताओं के अपने दस्तावेज़ों से: हर मुफ़्त टियर वास्तव में क्या देता है, प्रोडक्शन में कौन-सी शर्तें भारी पड़ती हैं, और हर विकल्प — Pexafy सहित — कहाँ गलत चुनाव है।
 Marouane Tijani
11 मिनट पढ़ना

आपको अपने प्रोडक्ट के भीतर मुफ़्त इस्तेमाल वाली फ़ोटो चाहिए। सीधा रास्ता यह लगता है कि Unsplash, Pexels या Pixabay से एक API की लो और शिप कर दो। दो हफ़्ते बाद आपको वह हिस्सा दिखता है जिसकी तुलना कोई नहीं करता: जब तक कोई इंसान आपके ऐप को मंज़ूरी नहीं देता, वह 50 रिक्वेस्ट प्रति घंटा पर अटका रहता है, एक प्रोवाइडर हॉटलिंकिंग की मनाही करता है, दूसरा हर डाउनलोड पर ट्रैकिंग कॉल चाहता है — और आपके सर्च नतीजे उतने ही अच्छे हैं जितने वे टैग जो किसी अजनबी ने सालों पहले टाइप किए थे।
यह पेज वही तुलना है जो Pexafy बनाना शुरू करते वक़्त हमें चाहिए थी: कोटा एक ही इकाई में, वे शर्तें जो प्रोडक्शन में सचमुच चुभती हैं, और हर API क्या कर सकता है और क्या नहीं। प्रतिस्पर्धियों से जुड़ा हर आँकड़ा प्रोवाइडर के अपने डॉक्स से आया है, जिनके लिंक नीचे दिए हैं। हम यह भी साफ़ कहते हैं कि Pexafy कहाँ सही जवाब नहीं है।
तुलना तालिका
पाँच विकल्प, चौदह मानदंड। Unsplash, Pexels और Pixabay अपनी-अपनी API वाली अकेली लाइब्रेरी हैं। Openverse और Pexafy एग्रीगेटर हैं — वे एक साथ कई लाइब्रेरी में खोजते हैं — और यही वह फ़र्क़ है जिसे ज़्यादातर तुलना लेख चुपचाप छोड़ देते हैं।
| UnsplashAPI | PexelsAPI | PixabayAPI | Openverseएग्रीगेटर | Pexafyएग्रीगेटर | |
|---|---|---|---|---|---|
| मुफ़्त कोटा | 50 रिक्वेस्ट/घंटा (डेमो) | 200 रिक्वेस्ट/घंटा 20,000/महीना |
100 रिक्वेस्ट/मिनट | की की ज़रूरत नहीं (थ्रॉटल्ड) | 5,000 रिक्वेस्ट/महीना |
| ऊपर का टियर | मैनुअल रिव्यू के बाद1 | अनुरोध पर | अनुरोध पर (पूरी API) | ऐप रजिस्टर करें | $5/माह से · 25,000 रिक्वेस्ट |
| की जारी होना | तुरंत (सिर्फ़ डेमो) | तुरंत | तुरंत | ज़रूरी नहीं | तुरंत कार्ड नहीं |
| लाइव जाने के लिए ऐप रिव्यू | ज़रूरी | नहीं | सिर्फ़ पूरी API के लिए | नहीं | कोई नहीं |
| एट्रिब्यूशन ज़रूरीAPI शर्तों के अनुसार | फ़ोटोग्राफ़र + Unsplash | Pexels का प्रमुख लिंक + क्रेडिट | छवि का स्रोत दिखाना ज़रूरी | स्रोत के लाइसेंस के अनुसार (CC BY…) | ज़रूरी नहीं2 |
| डाउनलोड-ट्रैकिंग कॉल | हर डाउनलोड पर ज़रूरी | नहीं | नहीं | नहीं | नहीं |
| छवियों की हॉटलिंकिंग | ज़रूरी | अनुमति है | अनुमति नहीं 24 घंटे कैश | स्रोत से लिंक | अनुमति है + CDN थंबनेल |
| सर्च किस पर मैच करता है | कीवर्ड और टैग | कीवर्ड और टैग | कीवर्ड और टैग | कीवर्ड और मेटाडेटा | अर्थ सिमैंटिक |
| पूरे वाक्य वाली क्वेरी | नतीजे बिगाड़ती हैं | नतीजे बिगाड़ती हैं | अधिकतम 100 अक्षर | नतीजे बिगाड़ती हैं | 500 अक्षर — नतीजे बेहतर करती हैं |
| छवि → छवि सर्च | नहीं | नहीं | नहीं | नहीं | हाँ + “इससे मिलती-जुलती और” |
| क्वेरी की भाषाएँ | lang पैरामीटर (बीटा) |
28 लोकेल | 26 भाषा कोड | अंग्रेज़ी-केंद्रित | 100+, एक ही इंडेक्स |
| प्रति रिक्वेस्ट लाइब्रेरी | 1 | 1 | 1 | कई (CC स्रोत) | 9 |
| रिस्पॉन्स स्कीमा | अपना | अपना | अपना | एकीकृत | एकीकृत + क्रेडिट स्ट्रिंग |
| AI एजेंट के लिए MCP सर्वर | कोई आधिकारिक नहीं | कोई आधिकारिक नहीं | कोई आधिकारिक नहीं | कोई आधिकारिक नहीं | हाँ होस्टेड, OAuth 2.1 |
स्रोत: हर प्रोवाइडर का सार्वजनिक डॉक्युमेंटेशन, 14 August 2026 को जाँचा गया — लिंक अंत में संदर्भ में हैं। कुछ पुराना लगा? हमें बताइए और हम उसे ठीक कर देंगे।
कोटा: संख्या नहीं, इकाई पढ़िए
कोटा की तुलना वहीं है जहाँ ऐसे लेख अक्सर गड़बड़ करते हैं, क्योंकि चारों API चार अलग-अलग चीज़ें चार अलग-अलग समय-खिड़कियों में गिनते हैं। एक साझा इकाई में बदलिए — एक ऐसा सर्च जो उपयोगकर्ता को सचमुच दिखता है — तो क्रम बदल जाता है:
| फ़्री प्लान | डॉक्स के अनुसार | प्रति घंटा | एक रिक्वेस्ट से क्या मिलता है |
|---|---|---|---|
| Unsplash | 50 रिक्वेस्ट/घंटा (डेमो) | 50 | एक लाइब्रेरी, कीवर्ड-रैंक |
| Pexels | 200 रिक्वेस्ट/घंटा · 20,000/महीना | 200 | एक लाइब्रेरी, कीवर्ड-रैंक |
| Pixabay | 100 रिक्वेस्ट/मिनट | 6,000 | एक लाइब्रेरी, कीवर्ड-रैंक |
| Pexafy | 5,000 रिक्वेस्ट/महीना · 20 रिक्वेस्ट/मिनट | 1,200 (बर्स्ट) | 9 लाइब्रेरी, सिमैंटिक रैंकिंग, डुप्लिकेट हटाए हुए, एक स्कीमा |
इसका मतलब साफ़ कहें: अगर आपको एक ही लाइब्रेरी पर कच्चा वॉल्यूम चाहिए, तो Pixabay का 100 रिक्वेस्ट प्रति मिनट इस पेज का सबसे उदार फ़्री टियर है, और हम इसके उलट दिखाने की कोशिश नहीं करेंगे। जो वह नहीं देता, वह है कवरेज। तीन लाइब्रेरी से वही नतीजों का सेट खुद जोड़ने की लागत एक रिक्वेस्ट नहीं है — वह तीन है, साथ में उनके इर्द-गिर्द की हर चीज़:
| “3 लाइब्रेरी पर एक सर्च” शिप करने के लिए | सीधी API | Pexafy |
|---|---|---|
| संभालने के लिए अकाउंट और API की | 3 | 1 |
| जिन मंज़ूरियों का इंतज़ार करना है | 1 (Unsplash) | 0 |
| प्रति उपयोगकर्ता सर्च HTTP कॉल | 3 | 1 |
| जिन रेट-लिमिट खिड़कियों का ध्यान रखना है | 3 (घंटा, घंटा, मिनट) | 1 |
| नॉर्मलाइज़ करने के लिए JSON ढाँचे | 3 | 1 |
| मर्ज, डीडुप और री-रैंक लॉजिक | आप लिखते और मेंटेन करते हैं | शामिल |
| जिन शर्तों का पालन करना है | 3 | 1 |
| लाइब्रेरियों के बीच प्रासंगिकता | 3 अलग कीवर्ड रैंकिंग, जोड़ी हुई | एक रैंकिंग, एक स्कोर |
असली मायने वाली इकाई। एक Pexafy रिक्वेस्ट = 9 लाइब्रेरी पर एक सिमैंटिक सर्च, डुप्लिकेट हटाकर एक ही सूची में रैंक किया हुआ। प्रोवाइडरों की अपनी API के साथ, उपयोगकर्ता को दिखने वाले उसी सर्च की लागत 3 से 5 कॉल है, साथ में मर्ज लेयर — वह कोड जो आप लिखते हैं, टेस्ट करते हैं और जिसकी मेंटेनेंस की क़ीमत हमेशा चुकाते हैं।
वे नियम जो शिप करने के बाद पता चलते हैं
कोटा का प्रचार होता है। शर्तों का नहीं। ये वे चार क्लॉज़ हैं जो सबसे अधिक बार दोबारा कोड लिखने पर मजबूर करते हैं — सब सार्वजनिक हैं, और सब आसानी से छूट जाते हैं:
- Unsplash: प्रोडक्शन एक्सेस एक इंसानी फ़ैसला है। ऐप्स डेमो मोड में 50 रिक्वेस्ट/घंटा से शुरू होते हैं। लिमिट बढ़वाने के लिए आपको स्क्रीनशॉट, एक शीर्षक और विवरण जमा करना होता है, और आपका ऐप दिखने लायक तरीके से गाइडलाइन्स का पालन करता हुआ होना चाहिए — जिसमें व्यू और डाउनलोड रिपोर्टिंग शामिल है। जब तक कोई मंज़ूरी नहीं देता, असली उपयोगकर्ताओं के साथ प्रोडक्शन में आपकी सीमा 50/घंटा ही है।
-
Unsplash: डाउनलोड-ट्रैकिंग कॉल। जब भी आपका ऐप कोई फ़ोटो डाउनलोड करता है, आपको
/photos/:id/downloadएंडपॉइंट भी कॉल करना होता है। यह वैकल्पिक नहीं है, यह गाइडलाइन्स का हिस्सा है, और यह एक दूसरा राउंड-ट्रिप है जिसे आपको हर उस कोड पाथ में याद रखना पड़ता है जो कोई छवि सहेजता है। - Pixabay: स्थायी हॉटलिंकिंग नहीं, और 24 घंटे कैश। स्थायी उपयोग के लिए आपको छवियाँ अपने सर्वर पर डाउनलोड करनी होंगी, और API रिस्पॉन्स को 24 घंटे कैश करना होगा। यानी स्टोरेज, एक कैश लेयर और एक इनवैलिडेशन नीति — यानी इंफ़्रास्ट्रक्चर, इससे पहले कि आपने एक भी फ़ोटो दिखाई हो।
- सबके लिए: एट्रिब्यूशन के नियम लाइसेंस के नियमों से अलग हैं। फ़ोटो लाइसेंस मशहूर तौर पर उदार हैं, लेकिन API शर्तें अपनी अलग ज़िम्मेदारियाँ जोड़ती हैं — Pexels का एक प्रमुख वापसी लिंक, फ़ोटोग्राफ़र और Unsplash को क्रेडिट, उपयोगकर्ताओं को यह दिखाना कि Pixabay की छवियाँ कहाँ से आई हैं। सिर्फ़ लाइसेंस पेज नहीं, API शर्तें पढ़िए।
Pexafy की स्थिति, सीधे शब्दों में: आपकी की पहली कॉल पर ही काम करती है, कोई आवेदन रिव्यू नहीं है, कोई
अनिवार्य ट्रैकिंग एंडपॉइंट नहीं, और कोई कैशिंग बाध्यता नहीं। हमारी API शर्तों में एट्रिब्यूशन ज़रूरी नहीं है —
फिर भी हर नतीजे के साथ तैयार attribution स्ट्रिंग आती है (HTML और प्लेन टेक्स्ट),
क्योंकि फ़ोटोग्राफ़रों को क्रेडिट देना अच्छी प्रथा है और हम चाहते हैं कि यह एक लाइन का कोड हो, कोई बोझ नहीं।
स्रोत लाइब्रेरी का अपना लाइसेंस, बेशक, हमेशा लागू रहता है।
कीवर्ड बनाम सिमैंटिक: नतीजों में क्या बदलता है
इस पेज पर Pexafy को छोड़कर हर API आपके शब्दों को फ़ोटो से जुड़े शब्दों से मिलाती है — टैग, शीर्षक, विवरण। Pexafy अर्थ की तुलना करता है: आपके वाक्य और हर छवि को संख्यात्मक फ़िंगरप्रिंट में बदला जाता है, और सबसे नज़दीकी वापस आते हैं। इसके दो नतीजे प्रोडक्शन में तुरंत दिखते हैं।
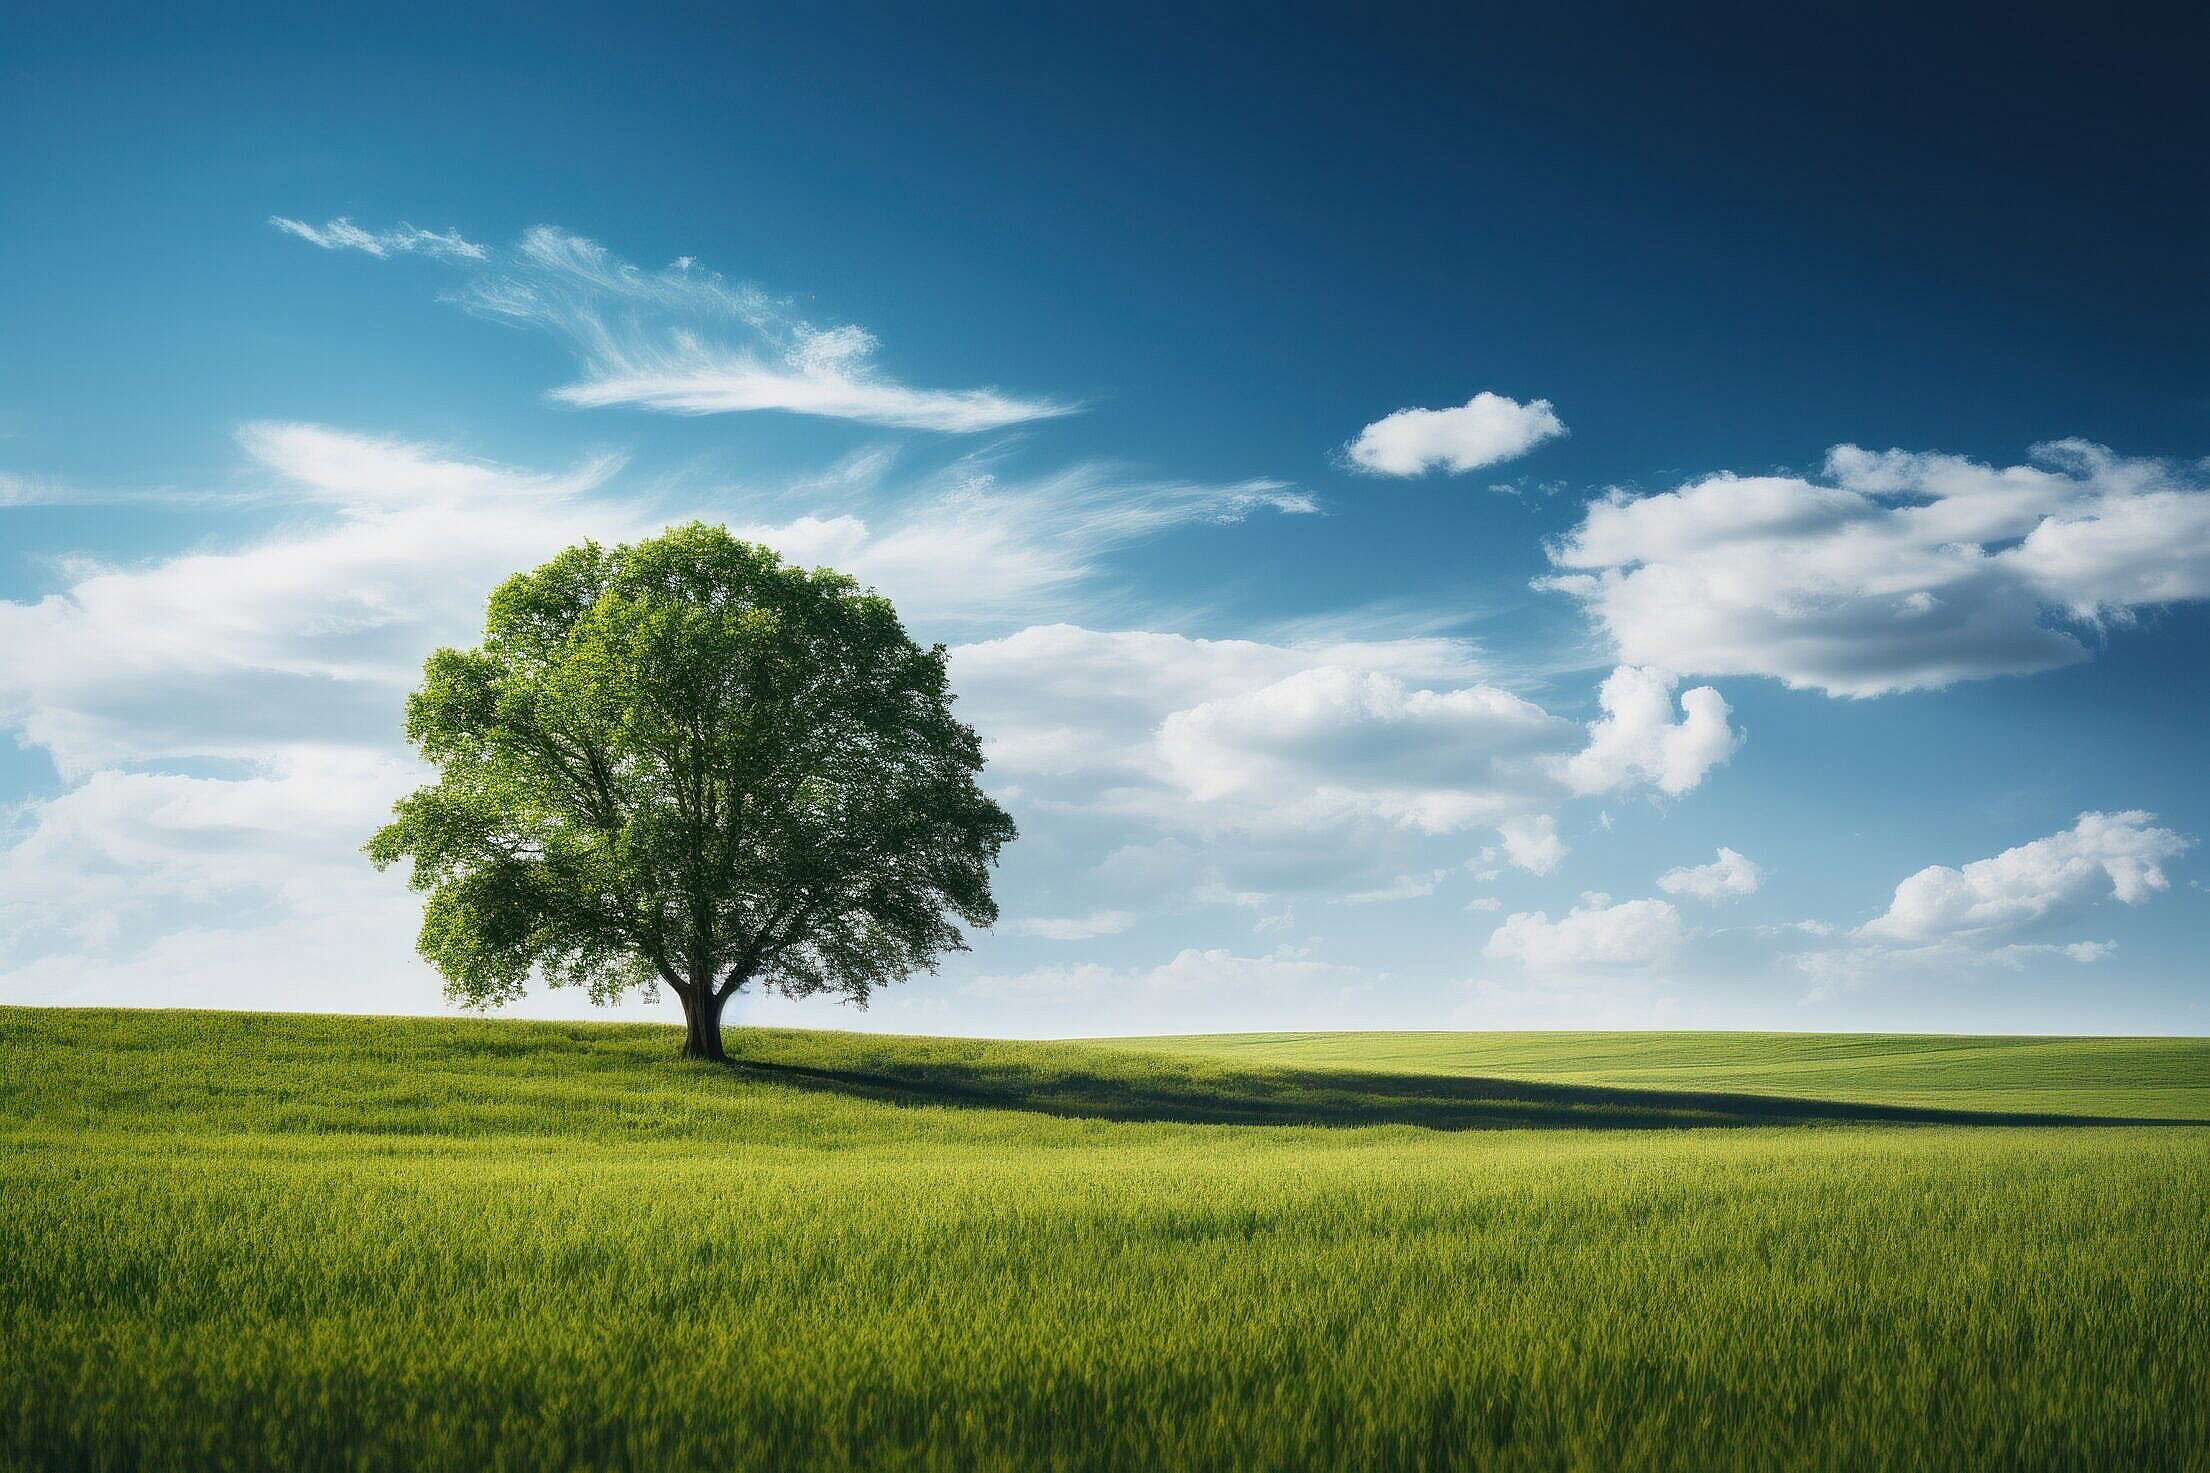
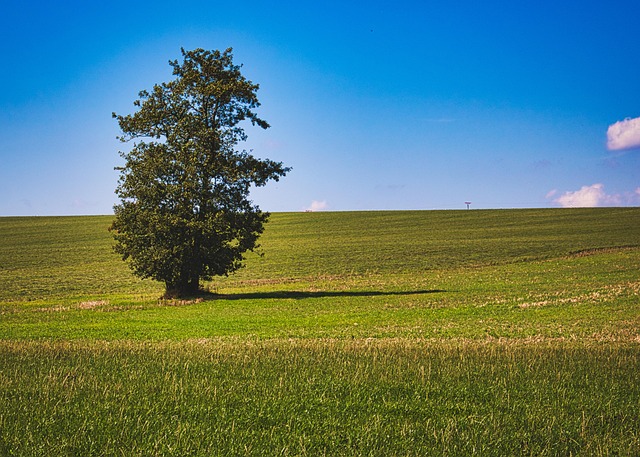
पहला: वह कवरेज जो आपने माँगी ही नहीं थी। यह एक असली Pexafy रिक्वेस्ट है — एक क्वेरी, एक रैंक की हुई सूची। स्रोत बैज देखिए:
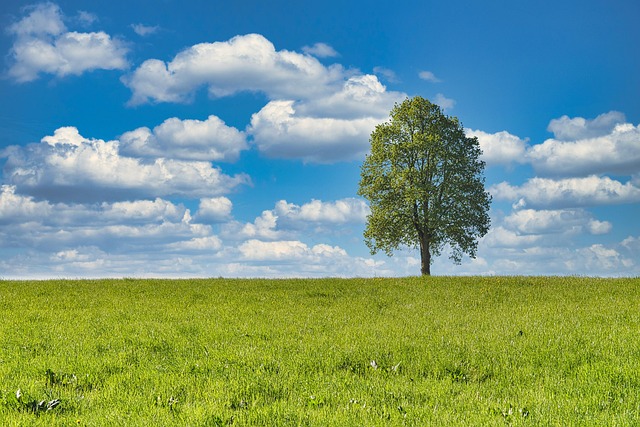
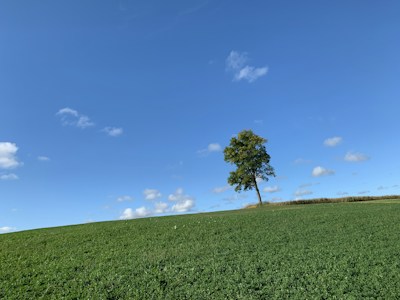
दूसरा: क्वेरी अब कीवर्ड की पहेली नहीं रहती। टैग मैचिंग में हर अतिरिक्त शब्द एक और चीज़ है
जो टैग में शायद मौजूद नहीं है, इसलिए आप tree field टाइप करना और स्क्रॉल करना सीख जाते हैं।
सिमैंटिक सर्च में उलटा होता है — “चौड़े नीले आसमान के नीचे खाली हरे मैदान में खड़ा अकेला पेड़”
“पेड़” से बेहतर क्वेरी है, क्योंकि हर विवरण मैच को और पैना करता है। यही असर
भावों पर भी है (शांत, नॉस्टैल्जिक, मिनिमल) और भाषाओं पर भी: वाक्य उसी जगह पहुँचता है,
चाहे आप उसे अंग्रेज़ी, फ़्रेंच या जापानी में लिखें, वही एक इंडेक्स पर।
हमने इसे असली सर्च के साथ
सिमैंटिक इमेज सर्च बनाम कीवर्ड में विस्तार से देखा है।
तीन के बजाय एक स्कीमा
यही वह हिस्सा है जो सबसे ज़्यादा इंजीनियरिंग समय खाता है और किसी तुलना तालिका में कभी नहीं दिखता। एक ही अवधारणा — “मध्यम आकार की छवि का URL” और “यह किसने खींची” — हर API में अलग नाम से आती है:
// Unsplash
results[].urls.regular        results[].user.name
// Pexels
photos[].src.large            photos[].photographer
// Pixabay
hits[].webformatURL           hits[].user
इसे आयामों, ओरिएंटेशन, प्रमुख रंग, स्रोत पेज URL, लाइसेंस और पेजिनेशन से गुणा कीजिए, और आपके पास हर प्रोवाइडर के लिए एक अडैप्टर, एक नॉर्मलाइज़ेशन लेयर, एक डीडुप पास (एक ही फ़ोटो अक्सर कई लाइब्रेरी में होती है) और एक री-रैंकिंग ह्यूरिस्टिक आ जाता है — आम तौर पर कुछ सौ लाइनें जिन्हें तीन चेंजलॉग के साथ तालमेल में रखना पड़ता है। Pexafy में वही लेयर ही प्रोडक्ट है:
curl -H "X-Api-Key: $PEXAFY_KEY" \
  "https://api.pexafy.com/api/v1/search/photos?q=a+lone+tree+in+an+empty+green+field"

{
  "success": true,
  "data": [
    {
      "photo_id": "019e4cd9-6369-70c3-ab2b-0ffd7e7965ad",
      "urls": { "thumb": "…", "small": "…", "regular": "…", "large": "…", "full": "…" },
      "width": 5376, "height": 3584, "orientation": "landscape",
      "color_name": "xanadu", "color_hex": "#697E77",
      "photographer_full_name": "Viktor Hanacek",
      "photographer_url": "https://picjumbo.com/about-viktor-hanacek/",
      "source": "Picjumbo", "license_type": "free",
      "relevance_score": 0.80,
      "alt_description": "A single tree standing in a wide green field",
      "attribution": { "html": "Photo by …", "plain": "Photo by …" }
    }
  ],
  "meta": { "took_ms": 147 }
}
Picjumbo की फ़ोटो, Unsplash की फ़ोटो और Pixabay की फ़ोटो — तीनों के लिए एक जैसे फ़ील्ड। एक relevance_score
जो हर स्रोत के बीच तुलनीय है, क्योंकि उन्हें जोड़-जाड़कर नहीं, बल्कि साथ मिलकर रैंक किया गया है। और एक
attribution ब्लॉक जिसे आप जैसा है वैसा ही रेंडर कर सकते हैं।
दो चीज़ें जो बाकी कोई नहीं करता
1 · सिर्फ़ शब्दों से नहीं, छवि से सर्च
Pexafy को एक छवि दीजिए — कोई URL, या आपकी अपलोड की हुई — और वह हर इंडेक्स की गई लाइब्रेरी से दृश्य और अर्थ के लिहाज़ से मिलती-जुलती फ़ोटो लौटाता है। आप साथ-साथ टेक्स्ट से दिशा भी दे सकते हैं (“इस फ़ोटो जैसी, लेकिन सूर्यास्त में”)। “इससे मिलती-जुलती और” ऐसे ही बनता है, या ऐसे ही आप किसी ऐसी छवि का मुफ़्त विकल्प ढूँढते हैं जिसका लाइसेंस आप नहीं ले सकते। Unsplash, Pexels, Pixabay या Openverse में से कोई भी छवि-से-छवि एंडपॉइंट नहीं देता।
2 · एक MCP सर्वर, ताकि AI एजेंट खुद छवियाँ खोज सकें
Pexafy mcp.pexafy.com/mcp पर OAuth 2.1 के साथ एक होस्टेड Model Context Protocol
सर्वर चलाता है — इसे Claude से, या अपने एजेंट से जोड़िए, और मॉडल खुद
9 फ़ोटो लाइब्रेरी में खोजता है, थंबनेल इनलाइन देखता है, और
क्रेडिट सहित छवियाँ लौटाता है। तीन टूल: टेक्स्ट सर्च, छवि से सर्च, और मिलती-जुलती फ़ोटो। बाकी प्रोवाइडरों के पास
कोई आधिकारिक MCP सर्वर नहीं है; जो मौजूद हैं वे कम्युनिटी रैपर हैं जिन्हें आप खुद होस्ट और की-सेटअप करते हैं।
अगर आप ऐसा एजेंट बना रहे हैं जिसे तस्वीरें चाहिए, तो यही फ़र्क़ पूरा इंटीग्रेशन है।
आपको असल में कौन-सा इस्तेमाल करना चाहिए?
ऐसी तुलना जिसमें एक ही प्रोडक्ट हर पंक्ति जीत जाए, वह मार्केटिंग है, जानकारी नहीं। ईमानदार बँटवारा यह है:
- Pixabay — आपको फ़्री टियर पर एक लाइब्रेरी तक हाई-वॉल्यूम एक्सेस चाहिए और आप छवियाँ खुद होस्ट कर सकते हैं। यहाँ 100 रिक्वेस्ट/मिनट का कोई मुक़ाबला नहीं।
- Unsplash — आपके प्रोडक्ट की विज़ुअल पहचान ख़ास तौर पर Unsplash की एडिटोरियल शैली पर टिकी है, और आप ऐप रिव्यू से गुज़रने और ट्रैकिंग कॉल लागू करने को तैयार हैं।
- Pexels — आपको तुरंत मिलने वाली की, उदार प्रति-घंटा दर और बिना इंफ़्रास्ट्रक्चर बाध्यताओं वाली एक साफ़-सुथरी लाइब्रेरी चाहिए।
- Openverse — आपको व्यावसायिक स्टॉक लाइब्रेरियों से परे Creative Commons और पब्लिक-डोमेन सामग्री चाहिए, जिसमें म्यूज़ियम और संस्थागत संग्रह शामिल हों।
- Pexafy — आपको इंटीग्रेशन की मेहनत के बिना विस्तार चाहिए: एक की, 9 लाइब्रेरी, एक स्कीमा, अर्थ-आधारित रैंकिंग, छवि-से-छवि सर्च, और AI एजेंट के लिए एक MCP सर्वर। या फिर आप एक एजेंसी, एक CMS, या ऐसा AI प्रोडक्ट हैं जहाँ “सही तस्वीर ढूँढना” एक फ़ीचर है, कोई पेज नहीं।
आप दोनों भी इस्तेमाल कर सकते हैं: कई टीमें ब्रांड फ़ोटोग्राफ़ी के लिए सीधा Unsplash इंटीग्रेशन रखती हैं और बाकी सब के लिए Pexafy का उपयोग करती हैं, ठीक इसलिए कि इसे आज़माने में एक की लगती है और कोई मंज़ूरी नहीं।
संदर्भ और फ़ुटनोट
1 Unsplash का डॉक्युमेंटेशन कहता है कि डेमो एप्लिकेशन 50 रिक्वेस्ट/घंटा तक सीमित हैं और प्रोडक्शन के लिए मंज़ूरी मिलने के बाद यह सीमा बढ़ाई जाती है। प्रकाशित प्रोडक्शन आँकड़ा API डॉक्युमेंटेशन पेज पर 1,000 रिक्वेस्ट/घंटा दर्ज रहा है, जबकि Unsplash के हेल्प पेज और तीसरे पक्ष की गाइडें लंबे समय से 5,000 रिक्वेस्ट/घंटा बताती रही हैं। जो भी हो, यह एक मैनुअल रिव्यू के पीछे है — और लॉन्च की योजना बनाते समय यही बात मायने रखती है।
2 Pexafy की API शर्तों में एट्रिब्यूशन ज़रूरी नहीं है, और हर नतीजे के साथ एक तैयार एट्रिब्यूशन स्ट्रिंग आती है। हर फ़ोटो पर उसकी मूल लाइब्रेरी द्वारा लगाया गया लाइसेंस उस फ़ोटो के आपके उपयोग पर लागू रहता है — Pexafy दूसरों की लाइब्रेरियों पर चलने वाला एक सर्च इंजन है, अधिकार धारक नहीं।
डॉक्युमेंटेशन 14 August 2026 को जाँचा गया: Unsplash API डॉक्स · Pexels API डॉक्स · Pixabay API डॉक्स · Openverse API डॉक्स · Pexafy API डॉक्स। Pexafy के आँकड़े उसी तारीख को प्रकाशित प्लान दर्शाते हैं।
अक्सर पूछे जाने वाले प्रश्न
किस मुफ़्त स्टॉक फोटो API का फ्री टियर सबसे बेहतर है?
प्रोडक्शन में Unsplash API इस्तेमाल करने के लिए क्या अनुमोदन ज़रूरी है?
इन APIs का उपयोग करते समय एट्रिब्यूशन देना अनिवार्य है?
सबसे बेहतर Unsplash API विकल्प कौन-सा है?
क्या मैं API के ज़रिए पूरे वाक्य से स्टॉक फोटो खोज सकता हूँ?
क्या कोई AI एजेंट सीधे स्टॉक फोटो खोज सकता है?
mcp.pexafy.com/mcp पर, जो OAuth 2.1 से सुरक्षित है। इसे Claude या अपने एजेंट से जोड़ें और मॉडल स्वयं हर indexed लाइब्रेरी में खोज करता है — टेक्स्ट से या इमेज से — और क्रेडिट सहित फोटो लौटाता है। Unsplash, Pexels, Pixabay और Openverse का कोई आधिकारिक MCP सर्वर नहीं है; केवल कम्युनिटी द्वारा बनाए गए wrappers हैं जिन्हें आपको स्वयं होस्ट करना पड़ता है।

