Ilustrahan ang 10,000 Pahina Kada Buwan Gamit ang Tunay na Larawan — sa 500 API Calls
Maghanap nang isang beses kada topic cluster sa halip na isang beses kada larawan, at ang 40,000 API calls ay nagiging 500. Ang pool-and-assign pattern, ang worker na kayang lumaban sa rate limits, at isang tapat na seksyon tungkol sa hindi kayang ayusin ng mga larawan.
 Marouane Tijani
12 min na pagbabasa

May bersyon ng problema sa pag-iilustra ng content na hindi kayang solusyunan ng anumang halaga ng magandang panlasa: hindi ka pumipili ng isang larawan, pinupunan mo ang 40,000 image slot kada buwan sa 800 topic cluster, 9 locale at 14 client site, at kailangang lisensyado, may credit, may sukat, at magkaiba ang bawat isa sa nasa tabi nito. Sa antas na iyon, ang tanong ay hindi na “alin bang larawan?” kundi “ano ang arkitektura?”
Ang artikulong ito ang sagot sa antas ng API: ang request pattern na pinapababa ang bilang ng calls sa dalawang orden ng magnitude, ang worker na nakakaligtas sa rate limits, ang deduplication na pumipigil sa isang 10,000-page na site na magmukhang isang pader ng parehong stock photo — at isang matapat na seksyon tungkol sa hindi kayang gawin ng mga larawan.
Ang tunay na bottleneck sa 10,000 na artikulo
Ang mga team na naglalathala nang malaki ang volume — programmatic SEO estates, marketplace category pages, aggregators, affiliate networks, agencies na nagpapatakbo ng content para sa isang portfolio ng mga kliyente, localisation pipelines na ginagawang 20 versions ang isang artikulo — lahat ay tumatama sa parehong tatlong pader, sa parehong pagkakasunod-sunod:
- Bilang ng calls. Ang isang search kada image slot ay nangangahulugan ng 40,000 API calls para sa 10,000 na artikulo na may apat na larawan bawat isa. Ang bawat provider ay nagpapresyo, nagta-throttle at nagre-review sa iyo batay sa bilang na iyon.
- Pag-uulit. Sa paligid ng pahina tatlumpu, muling lumalabas ang parehong larawan. Sa pahina tatlong libo, ang site mo ay may visual signature na: ginawa nang maramihan.
- Koordinasyon. Ang isandaang artikulo sa isang cluster ay dapat magmukhang isang serye, hindi isandaang hindi magkaugnay na Pinterest board — at ang susunod na locale ng parehong artikulo ay dapat muling gumamit ng parehong larawan, hindi maghanap ulit sa ibang wika.
Pansinin kung ano ang wala sa listahang iyon: ang paghahanap ng magandang larawan. Ang isang semantic engine ay nagbabalik ng isang pahina ng magagamit na kandidato sa loob ng humigit-kumulang 130 milliseconds. Nalutas na ang retrieval; hindi nalutas ang distribution. Ang lahat sa ibaba ay tungkol sa distribution.
Bakit tunay na mga larawan, lalo na sa antas na ito
Ang argumento para sa photography kaysa sa generation ay lumalakas habang tumataas ang volume, sa mga dahilan na karamihan ay operational kaysa aesthetic.
| Sa 40,000 larawan/buwan | Paggawa (generation) ng mga ito | Paghahanap sa mga ito |
|---|---|---|
| Oras kada larawan | Segundo hanggang minuto, dagdag pa ang mga rejected na attempt | Isang request lamang (~130 ms) ang sumasaklaw sa isang buong cluster |
| Pinagmumulan ng gastos | Kada larawan, magpakailanman | Kada request — at isang request ay nagsisilbi sa ~25 na artikulo |
| Metadata na makukuha mo | Wala. Ikaw mismo ang susulat ng alt text at mga sukat | Mga sukat, dominant na kulay, blur hash, draft ng caption, credit line |
| Provenance | Machine-marked bilang synthetic sa ilalim ng EU AI Act simula noong 2 Agosto 20261 | Isang photographer na may pangalan, isang petsa, isang source URL na mabubuksan ng mambabasa |
| Pattern ng kabiguan | Kapani-paniwala ngunit maling mga detalye, uniform na house style | Walang tumugma sa brief — makakakuha ka ng zero results, na kaya mong hawakan |
Ang row ng metadata ang nagpapasya sa mga pipeline. Bawat search result ay taglay na ang
width, height, blur_hash, color_hex,
alt_description at isang handa nang attribution.html string — na
siya ring eksaktong payload na kailangan ng isang templating engine para maglabas ng layout-shift-free
na <img> na may placeholder at credit. Ang mga generated na larawan ay nagbibigay lang sa iyo ng isang file at
iniiwan sa iyo ang ibang anim na field para imbentuhin.
Kung saan nananatiling nananalo ang generation sa malaking scale. Category-level na illustration para sa abstract na taxonomies (“cloud migration”, “index funds”), mga diagram, at isang house style na gusto mong ulitin sa buong estate para sa mga dahilang brand-related. Ang paghahati na kinapupuntahan ng karamihan sa malalaking publisher: mga larawan para sa anumang umiiral sa mundo, generated na art para sa anumang umiiral lamang sa isang argumento. Ginawa namin ang buong argumento para sa paghahating iyon sa paano i-ilustra ang bawat artikulong inilalathala mo.
Isang request, isang daang larawan
Ito ang nag-iisang pagbabago na muling humuhubog sa aritmetika. Ang search endpoint ay tumatanggap ng
per_page na hanggang 100, at pinapayagan ng cursor pagination na patuloy mong lakarin ang
parehong ranked result set. Kaya ang unit of work ay hindi isang larawan, kundi isang pool.
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a woman signing paperwork with an insurance agent at a kitchen table in her home" \
  --data-urlencode "per_page=100" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "score_threshold=0.5" \
  --data-urlencode "fields=photo_id,urls,width,height,blur_hash,alt_description,attribution"

# → { "success": true, "data": [ …hanggang 100 na larawan… ],
#     "pagination": { "per_page": 100, "has_more": true, "next_cursor": "eyJyc…" },
#     "meta": { "took_ms": 122.33, "request_id": "7ff1fb9b-…" } }
Tatlong parameter dito ang tahimik na gumagawa ng trabaho sa malaking scale:
fields— isang sparse fieldset. Hilingin ang pitong field na irerender ng template mo at hihinto ang response sa pagpapadala ng mahabang AI description ng bawat larawan. Sa 40,000 na larawan, iyan ang pagkakaiba sa pagitan ng isang build na streaming at isa na nag-swap.score_threshold— ang buntot ng isang 100-result na pahina ay, sa depinisyon, hindi kasing-relevant ng ulo nito. Ang pagtakda ng isang floor ay nangangahulugan na ang isang manipis na cluster ay magbabalik ng 34 na larawan sa halip na 100 na katamtaman lang, at ang pipeline mo ay makakareact dito sa halip na ilathala ito.next_cursor— kapag talagang kailangan ng isang cluster ng 300 larawan, mag-paginate sa parehong ranked set sa halip na magpaputok ng tatlong magkaibang query na nagtatagpo.
At narito ang aritmetika, para sa isang site na naglalathala ng 10,000 pahina kada buwan na may apat na larawan bawat isa:
| Estratehiya | Requests / buwan | Isang pass sa rate limit ng free plan20 req/min | Kasya ba sa free monthly quota? |
|---|---|---|---|
| Isang search kada image slot | 40,000 | 33 hours | Hindi — kailangan ng bayad na plan |
| Isang search kada artikulo | 10,000 | 8 hours | Hindi — kailangan ng bayad na plan |
| Isang search kada cluster ng ~20 artikuloang pattern sa artikulong ito | 500 | 25 minutes | Oo |
Parehong 40,000 na inilathalang larawan sa lahat ng tatlong row. Ang tanging nagbago ay kung saan nakadikit ang loop.
Pool at assign: ang pattern na sumusukat
Ang buong arkitektura ay dalawang phase na tumatakbo sa magkaibang dalas, na may isang table sa pagitan nila:
                     ┌─────────── tumatakbo linggu-linggo, ~500 requests ───────────┐
  topic clusters ──▶ POOL   mag-search minsan kada cluster, per_page=100
                     │       └─▶ i-store ang 100 photo row kada cluster
                     └──────────────────┬───────────────────────────────┘
                                        ▼
                              image_pool table
                        (cluster, photo_id, urls, blur_hash,
                         alt, credit, used_by_page, used_at)
                                        │
                     ┌──────────────────┴──── tumatakbo kada publish, 0 requests ───┐
  artikulo ─────────▶ ASSIGN  piliin ang pinakamahusay na hindi pa nagamit na row para sa
                     │        cluster na ito, markahan itong ginamit, i-render
                     └────────────────────────────────────────────────────────┘
Ito ang benepisyo na makukuha mo, ayon sa kahalagahan sa malaking volume:
- Hindi kailanman naka-block sa isang API ang paglalathala. Ang assignment ay isang database read. Ang save hook ng CMS mo, ang static build mo at ang bulk import mo bandang alas-3 ng umaga ay lahat tumatakbo sa bilis ng local, offline, na walang anumang rate limit kahit saan sa landas.
- Libre at eksakto ang deduplication.
used_by_page IS NULLang buong feature. Hindi maaaring kumuha ng parehong larawan ang dalawang pahina, dahil ang assignment ay isang transaction, hindi isang ranking heuristic. - Mura at idempotent ang mga re-run. I-refresh ang pool ng isang cluster kapag paubos na ito
o kapag gusto mo ng mas bagong photography (
after_date, osort_by=newest) — isang request lang, at walang anumang nailathala na gagalaw. - Libre na dumarating ang mga locale. Ang 20 translation ng isang artikulo ay isang pahina sa
modelo mo na may 20 rendering; sinasalo nila ang naka-assign na
photo_idat hindi ka na kailanman mag-search nang dalawang beses. Kapag gusto mo talaga ng tunay na locally-shot na hitsura, patakbuhin ang pool query para sa cluster na iyon sa target na wika — tumatanggap ang engine ng isang pangungusap sa mahigit 100 wika.
Ang worker, sa code
Humigit-kumulang animnapung linya. Ang pool filler ang tanging bahaging nakikipag-usap sa network, kaya ito ang
tanging bahaging kailangang pag-ingatan — may limitasyon ang concurrency, iginagalang ang 429, ang mga resulta ay
isinusulat sa isang transaction.
import asyncio, os, time, httpx

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
KEY    = os.environ["PEXAFY_API_KEY"]
FIELDS = "photo_id,urls,width,height,blur_hash,alt_description,attribution"

# Free = 20 req/min. Manatili isang mas mababa. Ang pacer ay GLOBAL: ang per-task na sleep
# sa loob ng concurrency gate ay hahayaan ang N workers na magpaputok ng N× na rate.
PER_MIN = 19
gate    = asyncio.Semaphore(4)         # mga koneksyong in-flight
_lock   = asyncio.Lock()
_slot   = 0.0                          # susunod na libreng sandali sa shared timeline

async def pace():
    """Magbigay ng isang request slot kada 60/PER_MIN segundo, fleet-wide."""
    global _slot
    async with _lock:
        now  = time.monotonic()
        _slot = max(now, _slot) + 60 / PER_MIN
        wait  = _slot - now
    if wait > 0:
        await asyncio.sleep(wait)

class QuotaExhausted(Exception): ...   # buwanan: hindi makakatulong ang pag-retry

async def fill_pool(client, cluster) -> list[dict]:
    """Isang request → hanggang 100 credited na larawan para sa isang topic cluster."""
    for attempt in range(4):
        await pace()
        async with gate:
            r = await client.get(
                SEARCH,
                headers={"X-Api-Key": KEY},
                params={
                    "q": cluster["camera_brief"],   # isang eksena, hindi ang keyword
                    "per_page": 100,
                    "orientation": "landscape",
                    "score_threshold": 0.5,
                    "fields": FIELDS,
                },
                timeout=15,
            )
        if r.status_code == 429:
            retry_after = r.headers.get("Retry-After")
            if retry_after is None:            # walang Retry-After ⇒ buwanang quota,
                raise QuotaExhausted(cluster["id"])   # ihinto ang buong run
            await asyncio.sleep(int(retry_after))   # per-minute: nawawala ito
            continue
        r.raise_for_status()
        return r.json()["data"]
    return []                                  # i-log ito; pinapanatili ng pool ang lumang mga row nito

async def refill(clusters):
    async with httpx.AsyncClient(http2=True) as client:
        pools = await asyncio.gather(*(fill_pool(client, c) for c in clusters))
    for cluster, photos in zip(clusters, pools):
        db.upsert_pool(cluster["id"], photos)     # ON CONFLICT DO NOTHING sa photo_id
Dalawang detalye rito ang pagkakaiba sa pagitan ng isang worker na tumatakbo nang walang bantay at isa na
gigising sa iyo. Ang pacer ay global, hindi per-task: ang paglalagay ng sleep sa loob ng
concurrency gate ang klasikong pagkakamali — apat na worker, bawat isa ay huminto ng 3 segundo pagkatapos ng kani-kanilang
request, ay gumagawa ng apat na request bawat 3 segundo, humigit-kumulang 75 kada minuto, at ang free plan
ay agad na magsisimulang magbalik ng 429. At ang dalawang 429 ay hindi magkatulad na hayop: ang per-minute ay may dalang
Retry-After at nawawala ito, ang isang monthly-quota ay hindi ito dala at hindi kailanman
mawawala — ang pag-retry dito ay isang loop laban sa isang pader.
Ang assignment, ang bahaging tumatakbo sa bawat publish, ay hindi kailanman humihipo sa network:
# Ang uniqueness ay ipinapatupad ng schema, hindi ng pag-iingat ng query.
# Ang isang larawan ay maaaring naroon sa ilang cluster pool; maaari lang itong
# PUBLISHED nang isang beses.
# CREATE UNIQUE INDEX one_use_per_photo ON image_pool (photo_id)
#        WHERE used_by_page IS NOT NULL;

def assign_hero(page_id: str, cluster_id: str) -> dict | None:
    for _ in range(5):                # ang natalong race ay kukuha na lang ng susunod na larawan
        try:
            return db.query_one("""
                UPDATE image_pool p SET used_by_page = %s, used_at = NOW()
                WHERE p.id = (
                    SELECT c.id FROM image_pool c
                    WHERE c.cluster_id = %s AND c.used_by_page IS NULL
                      AND NOT EXISTS (              -- ginamit ba ng IBA pang cluster?
                          SELECT 1 FROM image_pool u
                          WHERE u.photo_id = c.photo_id
                            AND u.used_by_page IS NOT NULL
                      )
                    ORDER BY c.rank ASC
                    LIMIT 1 FOR UPDATE SKIP LOCKED  -- ligtas kasabay ng parallel workers
                )
                RETURNING photo_id, urls, width, height, blur_hash, alt, credit
            """, [page_id, cluster_id])
        except UniqueViolation:      # dalawang cluster ang nag-claim nito sa parehong milisegundo
            continue
    return None                     # tuyo na ang pool → palawakin ang brief, i-refill

# Rendering: bawat attribute ay galing sa row — walang layout shift, walang pagbubulaga.
# <img src="{urls[regular]}" width="{width}" height="{height}"
#      alt="{alt}" loading="lazy" style="background:{blur_placeholder}">
# <figcaption>{credit}</figcaption>
Dalawang failure mode, dalawang mekanismo, at parehong kailangan. Ang FOR UPDATE SKIP LOCKED
ay humahawak sa concurrency sa loob ng isang cluster: ginagawa ang mga pahina nang parallel — at sa antas na ito
gagawin mo ito — at may dalawang worker na kukuha ng parehong top-ranked na larawan sa parehong milisegundo.
Ang partial unique index ay humahawak sa bahaging madalas kinakalimutan ng lahat: ang parehong larawan ay lehitimong
lumalabas sa mga pool ng ilang cluster, dahil ang mga kalapit na cluster (“home insurance para sa nangungupahan”,
“…para sa may-ari ng bahay”) ay nagbabalik ng magkatabing resulta. Ang isang per-cluster na
used_by_page IS NULL na pagsusuri ay bulag doon — bawat cluster ay naniniwalang libre ang larawan.
Ang NOT EXISTS ang nagpapanatiling totoo ng query, at ang index ang gumagawa ng imposibleng magkamali sa ilalim ng
concurrency: ang natalo sa race ay makakakuha ng violation, mag-re-retry, at kukuha ng susunod na
larawan. Kung wala ito, ang “walang dalawang pahina ang magkakaroon ng parehong hero” ay isang claim lamang, hindi isang garantiya.
Kapag naubos ang isang pool sa gitna ng build, ang fallback na pinakamahusay ang kilos ay ang lumawak sa halip na umulit: alisin ang huling sugnay ng camera brief, patakbuhin muli ang pool query nang isang beses, at pagkatapos lang ay muling gamitin ang pinakamatandang na-assign na larawan — na may mahigpit na patakaran na hindi ito kailanman mapupunta sa isang pahina sa parehong cluster.
Isang cluster, isang pool: isang tunay na query
Kunin natin ang isang comparison na estate: home insurance, dalawampung pahina — “home insurance para sa nangungupahan”, “…para sa may-ari ng bahay”, “ano talaga ang saklaw ng isang policy”, labindalawang city page, tatlong claim guide. Isang camera brief para sa cluster, isang request, at ito ang ulo ng pool, na ibinalik sa loob ng 122 ms:
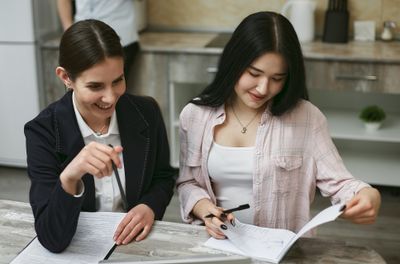
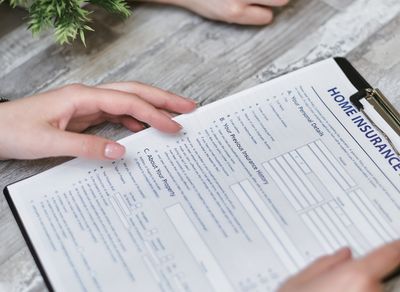
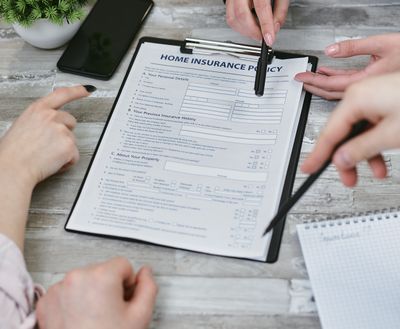
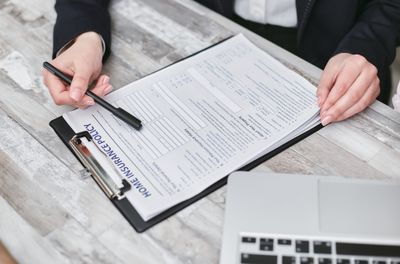
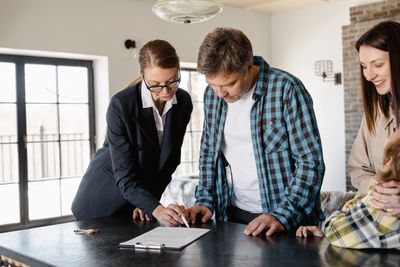
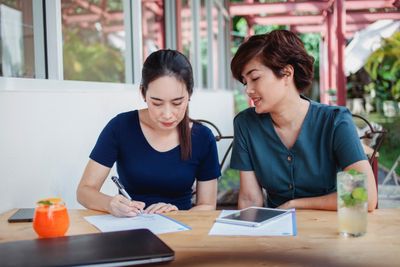
per_page=100 at pinananatili ang natitira.
Patakbuhin ang eksaktong search na ito →
Ang mga brief ang mas mahalaga kaysa sa code. Dalawang patakaran ang nananatili sa aktwal na paggamit sa isang tunay na estate ng mga cluster:
isulat ang brief para sa cluster, hindi para sa pahina (ang mga pamagat ng pahina ay halos magkatulad
sa mga programmatic na set, kaya ang mga per-page na brief ay nagbabalik ng halos magkatulad na mga larawan), at ilarawan ang isang eksena
na maaaring kunan ng isang kamera sa halip na ang paksa — ang home insurance ay nagbabalik ng malapitang larawan ng mga dokumento at wala nang iba pa. Inilathala namin ang copy-pasteable na prompt na gumagawa ng mga brief na ito sa
artikulo tungkol sa pag-iilustra ng bawat post.
Pagpapanatili ng visual coherence ng isang 200-pahinang serye
Ang kabaligtaran na kabiguan ng pag-uulit ay ang kawalan ng pagkakaugnay: dalawampung pahina sa isang cluster, bawat isa ay may
teknikal na tamang larawan, sa dalawampung magkaibang visual register. Ang solusyon ay isang endpoint —
GET /photos/{id}/similar — na patakbuhin nang isang beses sa larawan na inaprubahan mo para sa pillar page:
Dalawa pang lever na sulit iugnay sa pool query kapag isang kinakailangan ang brand consistency:
ang color_hex na may color_tolerance ay nagpapanatili sa buong estate sa loob ng isang
palette, at ang photographer ay nagpipin sa isang cluster sa gawa ng isang photographer. Pareho itong
ordinaryong query parameter — walang plan gating sa mga search filter.
Rate limits, quotas at ang totoong halaga nito
Piliin ang plan batay sa burst, hindi batay sa volume. Kapag nag-pool ka na, huminto na ang monthly quota bilang constraint para sa halos lahat; ang nagpapasya sa plan mo ay kung gaano kabilis dapat matapos ang isang buong refresh.
| Plan | Requests / buwan= mga cluster na na-refresh | Rate limit | API keys | Refresh 1,000 na clusterwall-clock, isang pass |
|---|---|---|---|---|
| Free — $0 | 5,000 | 20 / min | 1 | 50 min |
| Starter — $5 | 25,000 | 30 / min | 3 | 34 min |
| Pro — $19 | 100,000 | 60 / min | 5 | 17 min |
| Team — $99mga agency: isang key kada kliyente | 500,000 | 200 / min | 25 | 5 min |
| Business — $249 | 1,000,000 | 300 / min | unlimited | 4 min |
| Enterprise — $599 | 2,000,000 | 500 / min | unlimited | 2 min |
Basahin ang unang column bilang mga cluster: isang pooling request ang nagpupuno ng isang cluster, kaya ang monthly quota ay ang bilang ng mga cluster na kaya mong i-refresh, at ang huling column ay kung gaano katagal ang isang buong pass sa isang 1,000-cluster na estate sa rate limit ng plan na iyon. Parehong live na value ito mula sa pricing catalogue — sinasabi ng pricing page ang parehong rate limits kada oras sa halip na kada minuto.
Kaya ang isang 10,000-pahina-kada-buwan na estate sa pooled na pattern ay gumagastos ng ~500 na request at nagbabayad ng wala. Ang nagtutulak sa mga team pataas sa table ay bihirang volume — isa ito sa tatlong bagay: isang buong muling-pag-iilustra ng isang umiiral na estate sa loob ng isang gabi, per-client key isolation (gusto ng isang agency ng isang key kada kliyente upang ang paggamit ay attributable nang walang shared-secret na abala), o isang build window na sinusukat sa minuto sa halip na oras.
Dalawang operational na detalye na nagliligtas ng isang gabi ng debugging. Bawat response ay taglay ang
X-RateLimit-Limit at X-RateLimit-Remaining, kaya ang isang worker ay maaaring
pumagitna sa sarili sa halip na manghula. At ang isang 429 na isang tunay na per-minute na rate limit ay taglay ang
Retry-After, habang ang isang monthly-quota na block ay sadyang hindi ito taglay — hindi ito
malulutas ng pag-retry, at ang isang worker na naghihiwalay sa dalawa ay hihinto sa pagbomba sa isang endpoint
na wala nang maibibigay.
Kapag ang agent ang naglalathala
Kung ang content mo ay ginagawa ng isang agent — at sa antas na ito, lalo itong nangyayari — ang pooling
layer ay hindi nawawala, lumilipat lamang ito. Bigyan ang agent ng mga search tools at pupunuin nito ang pool habang
hawak pa niya ang cluster brief sa context, gamit ang
Model Context Protocol server sa mcp.pexafy.com/mcp: tatlong tool,
search_photos (isang pangungusap), search_photos_by_image (isang reference na larawan,
opsyonal na may kasamang pangungusap) at get_similar_photos (ang tool para sa series-coherence mula sa itaas).
# Claude Code / CI runner
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# o i-commit ang .mcp.json upang mamana ito ng bawat worker sa fleet
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
Ang instruction na gumagana sa malaking scale ay isang batch instruction, hindi isang per-artikulo — at ito ay tumutugma ng isa-sa-isa sa dalawang phase sa itaas:
Ikaw  Narito ang 12 topic cluster mula sa content calendar. Para sa bawat isa,
     sumulat ng isang camera brief, kumuha ng 100 landscape na larawan, at isulat
     ang pool sa Postgres. I-flag ang anumang cluster na nagbalik ng mas mababa sa 40
     resulta na nasa itaas ng 0.5 — kailangang isulat muli ang mga brief na iyon.

Agent  → search_photos(q="a woman signing paperwork with an insurance
           agent at a kitchen table in her home", orientation="landscape")
      ← 100 larawan · 122 ms · 87 nasa itaas ng threshold
      … 11 pang cluster …

      ✓ 11 pool ang naisulat (1,043 na larawan, lahat may credit)
      ⚠ "index fund rebalancing" → 12 resulta. Abstract ang brief;
        mungkahi: "isang tao sa lamesa ng kusina na sinusuri ang mga numero sa isang
        laptop na may notebook at kape sa tabi nila"
Ang huling linyang iyon ang dahilan kung bakit ilalagay ang agent sa loop na ito sa halip na isang script: ang failure mode ng programmatic na illustration ay isang masamang brief, at ang masamang brief ay eksaktong bagay na mapapansin at maisusulat muli ng isang language model. Ang mga script ang mananatiling namamahala sa assignment, kung saan mahalaga ang determinism at hindi ang pagkamalikhain.
Ang hindi kayang ayusin ng mga larawan
Isang matapat na seksyon, dahil mahal ang kabiguang inilalarawan nito. Ang tunay, credited na photography ay nagpapabuti sa isang pahina. Hindi nito ginagawang mabuting content ang manipis na content, at walang image pipeline ang nagbabago kung paano tinatrato ng mga search engine ang mass-produced na mga pahina na umiiral para mag-rank sa halip na tumulong. Direktang binabanggit ito ng spam policies ng Google: ang scaled content abuse ay sumasaklaw sa paggawa ng maraming pahina na may kaunting halaga gamit man o hindi ang automation, at ang mga ilustrasyon sa mga pahinang iyon ay walang kaugnayan sa paghatol na iyon.2
Kaya ang kapaki-pakinabang na framing ay makitid at totoo: ang photography ay isang quality signal na kontrolado mo sa mga pahinang karapat-dapat nang umiiral. Kung saan ito napatunayang may benepisyo:
- Provenance na maaaring i-verify ng isang mambabasa. Ang isang credit line na may pangalan ng photographer at isang source URL ay isang claim na maaaring suriin — ang kabaligtaran ng isang walang attribution na larawan sa isang pahina na may walang attribution na may-akda.
- Accessibility at Core Web Vitals. Ang
width/heightmula sa response ay pumapatay sa layout shift, angblur_hashay nagbibigay ng tunay na placeholder, at angalt_descriptionay isang draft ng alt text na maaaring pagbutihin ng template mo sa halip na imbentuhin. I-multiply ito sa 40,000 na slot at ito na ang buong kwento ng image-quality ng site. - Hindi magmukhang mass-produced. Ang deduplication at series coherence ang pumipigil sa isang estate na magkaroon ng visual signature. Iyan ay isang tunay na gastos sa perception na may tunay na kahihinatnan, at ito ay ganap na nasa ilalim ng kontrol mo.
At ang lisensya pa rin ang namamahala sa larawan. Hindi kinakailangan ang attribution ng mga tuntunin ng Pexafy API —
bawat resulta ay dala na ang attribution.html at attribution.plain handa nang irender —
ngunit ang lisensyang nakalakip ng orihinal na library ay nalalapat sa paggamit mo sa larawang iyon, at
sa 40,000 na larawan kada buwan, mas mura ang awtomatikong pagre-render ng credit kaysa sa pag-audit sa hinaharap.
Saan magsisimula sa Lunes
- Grupohin ang backlog mo sa mga cluster na 15–30 pahina na makatwirang maaaring magsalo ng isang photo shoot. Ito ang tanging tunay na manual na hakbang, at ito ay isang spreadsheet, hindi isang proyekto.
- Sumulat ng isang camera brief kada cluster — isang eksena, 12 hanggang 25 salita. Gawin ito gamit ang isang modelo, pagkatapos ay basahin ito; ang mga brief na nagbabanggit ng isang paksa sa halip na isang eksena ay agad na makikita.
- Punuin ang isang pool gamit ang isang solong
per_page=100na request at siyasatin ang ulo nito. Kung ang unang sampu ay hindi magamit, mali ang brief — hindi ang engine. - Idagdag ang column na
used_by_pagebago ka maglathala ng anuman. Limang minuto ito ngayon at isang migration sa 3,000 live na pahina sa hinaharap. - Patakbuhin ang buong bagay sa free plan hanggang sa pilitin ka ng isang build window na umakyat. Sa 500 na request kada buwan, magtatagal ito.
Mga sanggunian & talababa
1 EU AI Act, Artikulo 50 — mga obligasyon sa transparency na naaangkop simula sa 2 Agosto 2026: ang mga tagapagbigay ng mga sistemang gumagawa ng synthetic na larawan, audio, video o teksto ay dapat markahan ang mga output sa isang machine-readable na format at gawin itong nakikilala bilang artipisyal na ginawa. Sinasaklaw nito ang mga AI provider at deployer; hindi ito isang patakaran tungkol sa kung aling mga larawan ang maaaring ilathala ng isang website.
2 Mga spam policy ng Google Search — scaled content abuse: ang paggawa ng maraming pahina na pangunahing layunin ay manipulahin ang mga ranking at maghandog ng kaunting halaga sa mga user, gawa man ito sa pamamagitan ng automation, pagsisikap ng tao, o kombinasyon ng dalawa. Ang kalidad ng ilustrasyon ay hindi isang salik sa pagsusuring iyon, na eksaktong dahilan kung bakit hinihiwalay ng artikulong ito ang dalawa.
Mga pinagmulang sinuri noong 17 Agosto 2026: Mga spam policy ng Google Search · AI Act Artikulo 50 · Dokumentasyon ng Pexafy API & MCP. Ang mga limitasyon ng plan ay ang live na value mula sa pricing table ng Pexafy; ang mga oras ng search (122 ms, 48 ms) at bawat larawang ipinakita ay tunay na mga tugon ng API na kinunan sa parehong araw.
Mga madalas na tanong
Paano ako makakakuha ng mga larawan para sa libo-libong programmatic SEO pages?
GET /api/v1/search/photos request na may per_page=100 ay nagbabalik ng hanggang 100 kredibadong larawan para sa isang cluster; ise-store mo ang mga ito sa isang pool table at mag-a-assign ng isa kada pahina kapag naglathala. Ang isang estate na 10,000 pahina kada buwan na may apat na larawan bawat pahina ay nangangailangan lamang ng humigit-kumulang 500 requests sa halip na 40,000, na sapat na sa loob ng free plan (5,000 requests/buwan).Ano ang pinakamahusay na stock photo API para sa mataas na volume na produksyon ng content?
Paano ko maiiwasang lumabas ang parehong stock photo sa maraming pahina?
photo_id ng bawat larawang inilathala mo at kunin ang mga larawan mula sa pool nang transactional — sa SQL, isang UPDATE … WHERE used_by_page IS NULL … FOR UPDATE SKIP LOCKED. Ang deduplication ay nagiging eksakto sa halip na probabilistiko, at hindi na makakaagawan ang parallel build workers para sa iisang top-ranked na larawan. Isang column lamang ito, at mas mahal ang pagdaragdag nito sa libo-libong live na pahina kaysa idagdag ito mula sa simula.Ilang larawan ang kayang ibalik ng isang API request?
per_page=100, at ang cursor pagination ay nagbibigay-daan sa iyong magpatuloy sa parehong ranked result set para sa mas malalim na pools. Isama ito sa score_threshold para ang isang manipis na cluster ay magbalik ng 40 malakas na tugma sa halip na 100 mahinang tugma, at sa fields para magbalik lamang ng mga attribute na ginagamit ng iyong template, na nagpapanatili ng maliit na response sa malaking volume.Nakakatulong ba ang tunay na larawan para mas mag-rank nang mahusay ang mga pahinang ginawa sa malaking sukat?
Kaya bang punan ng AI agent ang isang image pool nang awtomatiko?
mcp.pexafy.com/mcp, na nag-e-expose ng search_photos, search_photos_by_image at photo_similar. Bigyan mo ang agent ng listahan ng mga cluster at gagawa ito ng isang camera brief kada isa, kukunin ang mga pool at ipapaalam ang mga brief na kulang sa malakas na tugma — na siya namang tunay na paraan ng pagkabigo ng programmatic illustration. Ang assignment ay nananatili sa iyong mga script, kung saan mas mahalaga ang determinism kaysa creativity.

