تصویرسازی ۱۰,۰۰۰ صفحه در ماه با عکسهای واقعی — تنها با ۵۰۰ فراخوانی API
بهجای جستوجو برای هر تصویر، یکبار برای هر خوشه موضوعی جستوجو کنید و ۴۰,۰۰۰ فراخوانی API به ۵۰۰ تا کاهش مییابد. الگوی استخرسازی و تخصیص، ورکری که در برابر محدودیت نرخ دوام میآورد، و بخشی صادقانه دربارهی آنچه عکسها نمیتوانند اصلاح کنند.
 Marouane Tijani
12 دقیقه مطالعه

نسخهای از مسئلهٔ تصویرگذاری محتوا وجود دارد که هیچقدر سلیقهٔ خوب آن را حل نمیکند: شما در حال انتخاب یک عکس نیستید، بلکه در حال پر کردن ۴۰٬۰۰۰ جایگاه تصویر در ماه در ۸۰۰ خوشهٔ موضوعی، ۹ زبان محلی و ۱۴ سایت مشتری هستید، و هر یک از آنها باید دارای مجوز، اعتبار، اندازهٔ درست و متفاوت از تصویر مجاورش باشد. در این حجم، پرسش دیگر «کدام عکس؟» نیست و به «معماری چیست؟» تبدیل میشود.
این مقاله پاسخ سطح API است: الگوی درخواستی که تعداد فراخوانیها را دو مرتبهٔ بزرگی کاهش میدهد، وُرکری که در برابر محدودیتهای نرخ دوام میآورد، حذف تکراری که مانع میشود سایت ۱۰٬۰۰۰صفحهای شبیه دیواری از یک عکس استوک تکراری به نظر برسد — و بخشی صادقانه دربارهٔ کارهایی که تصاویر نمیتوانند برای شما انجام دهند.
گلوگاه واقعی در ۱۰٬۰۰۰ مقاله
تیمهایی که با حجم بالا منتشر میکنند — املاک SEO برنامهای، صفحات دستهبندی بازارها، تجمیعکنندهها، شبکههای همکاری در فروش، آژانسهایی که برای مجموعهای از مشتریان محتوا تولید میکنند، خطوط بومیسازی که یک مقاله را به ۲۰ نسخه تبدیل میکنند — همگی به همان سه دیوار برمیخورند، به همان ترتیب:
- تعداد فراخوانی. یک جستوجو بهازای هر جایگاه تصویر یعنی ۴۰٬۰۰۰ فراخوانی API برای ۱۰٬۰۰۰ مقالهٔ چهارتصویری. هر ارائهدهنده شما را بر اساس همین عدد قیمتگذاری، محدود و بررسی میکند.
- تکرار. حدود صفحهٔ سیام، همان عکس دوباره ظاهر میشود. در صفحهٔ سههزارم، سایت شما امضای تصویری دارد: تولیدشده بهصورت انبوه.
- هماهنگی. صد مقاله در یک خوشه باید شبیه یک مجموعه به نظر برسند، نه صد بورد پینترست بیربط به هم — و زبان محلی بعدیِ همان مقاله باید همان تصویر را دوباره استفاده کند، نه دوباره در زبانی دیگر جستوجو کند.
توجه کنید چه چیزی در این فهرست نیست: پیدا کردن یک عکس خوب. یک موتور معنایی صفحهای از گزینههای قابلاستفاده را در حدود ۱۳۰ میلیثانیه برمیگرداند. بازیابی حل شده بود؛ توزیع نبود. همهٔ آنچه در ادامه میآید دربارهٔ توزیع است.
چرا عکس واقعی، مشخصاً در این حجم
استدلال عکاسی در برابر تولید تصویر، با افزایش حجم قویتر میشود، به دلایلی که بیشتر عملیاتی است تا زیباییشناختی.
| در ۴۰٬۰۰۰ تصویر در ماه | تولید آنها | جستوجوی آنها |
|---|---|---|
| زمان بهازای هر تصویر | چند ثانیه تا چند دقیقه، بهعلاوهٔ تلاشهای رد شده | یک درخواست (~۱۳۰ میلیثانیه) کل یک خوشه را پوشش میدهد |
| عامل هزینه | بهازای هر تصویر، برای همیشه | بهازای هر درخواست — و یک درخواست به حدود ۲۵ مقاله خدمت میکند |
| فرادادهای که دریافت میکنید | هیچ. متن alt و ابعاد را خودتان مینویسید | ابعاد، رنگ غالب، بلر هش، پیشنویس عنوان، سطر اعتبار |
| منشأ | از ۲ اوت ۲۰۲۶ طبق قانون هوش مصنوعی اتحادیهٔ اروپا بهصورت ماشینی بهعنوان مصنوعی نشانهگذاری میشود1 | یک عکاس نامبرده، یک تاریخ، یک نشانی منبع که خواننده میتواند باز کند |
| حالت شکست | جزئیات باورپذیر اما نادرست، سبک یکسانِ خانگی | هیچچیز با درخواست مطابقت نداشت — نتیجهٔ صفر میگیرید، که میتوانید مدیریتش کنید |
ردیف فراداده همان چیزی است که خطوط تولید را تعیین میکند. هر نتیجهٔ جستوجو از پیش شامل width، height، blur_hash، color_hex، alt_description و یک رشتهٔ attribution.html آماده است — که دقیقاً همان بار دادهای است که یک موتور قالب برای تولید یک <img> بدون جابهجایی چیدمان، همراه با جانگهدار و اعتبار، نیاز دارد. تصاویر تولیدشده فقط یک فایل به شما میدهند و شش فیلد دیگر را برای اختراع کردن به عهدهٔ شما میگذارند.
جایی که تولید تصویر همچنان در مقیاس برنده است. تصویرگذاری در سطح دستهبندی برای طبقهبندیهای انتزاعی («مهاجرت به فضای ابری»، «صندوقهای شاخص»)، نمودارها، و سبک خانگیای که میخواهید به دلایل برندسازی در کل یک مجموعه تکرار شود. تقسیمی که بیشتر ناشران بزرگ به آن میرسند: عکس برای هر چیزی که در جهان واقعی وجود دارد، هنر تولیدشده برای هر چیزی که فقط در یک استدلال وجود دارد. ما کل این استدلال را در چگونگی تصویرگذاری هر مقالهای که منتشر میکنید مطرح کردیم.
یک درخواست، صد عکس
این همان تغییر منفرد است که محاسبات را بازتعریف میکند. نقطهٔ پایانی جستوجو per_page تا ۱۰۰ میپذیرد، و صفحهبندی مبتنی بر مکاننما (cursor) اجازه میدهد در همان مجموعهٔ رتبهبندیشدهٔ نتایج پیش بروید. پس واحد کار یک تصویر نیست، یک استخر است.
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
-H "X-Api-Key: $PEXAFY_API_KEY" \
--data-urlencode "q=a woman signing paperwork with an insurance agent at a kitchen table in her home" \
--data-urlencode "per_page=100" \
--data-urlencode "orientation=landscape" \
--data-urlencode "score_threshold=0.5" \
--data-urlencode "fields=photo_id,urls,width,height,blur_hash,alt_description,attribution"
# → { "success": true, "data": [ …تا ۱۰۰ عکس… ],
# "pagination": { "per_page": 100, "has_more": true, "next_cursor": "eyJyc…" },
# "meta": { "took_ms": 122.33, "request_id": "7ff1fb9b-…" } }
سه پارامتر در آنجا کار مهمی را در مقیاس بزرگ بهآرامی انجام میدهند:
fields— یک مجموعهٔ فیلد پراکنده (sparse fieldset). فقط هفت فیلدی را که قالب شما رندر میکند بخواهید و پاسخ دیگر توضیح بلند هوش مصنوعی هر عکس را ارسال نمیکند. در ۴۰٬۰۰۰ عکس، این تفاوت بین ساختی که جریان مییابد (stream) و ساختی که با تأخیر جابهجا میشود (swap) است.score_threshold— دنبالهٔ یک صفحهٔ ۱۰۰نتیجهای، بنا به تعریف، کمربطتر از سرِ آن است. تنظیم یک کف یعنی یک خوشهٔ کممحتوا ۳۴ عکس برمیگرداند بهجای ۱۰۰ عکس متوسط، و خط تولید شما میتواند بهجای انتشار آنها، واکنش نشان دهد.next_cursor— وقتی یک خوشه واقعاً به ۳۰۰ عکس نیاز دارد، در همان مجموعهٔ رتبهبندیشده صفحهبندی کنید نه اینکه سه پرسوجوی متفاوت بفرستید که با هم همپوشانی دارند.
و این هم محاسبات، برای سایتی که ۱۰٬۰۰۰ صفحه در ماه با چهار تصویر در هرکدام منتشر میکند:
| راهبرد | درخواست / ماه | یک دور در محدودیت نرخ پلن رایگان20 درخواست/دقیقه | در سهمیهٔ ماهانهٔ رایگان جا میشود؟ |
|---|---|---|---|
| یک جستوجو بهازای هر جایگاه تصویر | ۴۰٬۰۰۰ | 33 hours | خیر — یک پلن پولی |
| یک جستوجو بهازای هر مقاله | ۱۰٬۰۰۰ | 8 hours | خیر — یک پلن پولی |
| یک جستوجو بهازای هر خوشهٔ حدود ۲۰ مقالهالگوی این مقاله | ۵۰۰ | 25 minutes | بله |
در هر سه ردیف همان ۴۰٬۰۰۰ تصویر منتشرشده. تنها چیزی که تغییر کرده جایی است که حلقه در آن قرار دارد.
استخر و تخصیص: الگویی که مقیاسپذیر است
کل معماری دو فاز است که با فرکانسهای مختلف اجرا میشوند، با یک جدول در میان آنها:
┌─────────── هفتگی اجرا میشود، حدود ۵۰۰ درخواست ──┐
خوشههای موضوعی ──▶ POOL یکبار جستوجو بهازای هر خوشه، per_page=100
│ └─▶ ذخیرهٔ ۱۰۰ ردیف عکس بهازای هر خوشه
└──────────────────┬───────────────────────────────┘
▼
جدول image_pool
(cluster, photo_id, urls, blur_hash,
alt, credit, used_by_page, used_at)
│
┌──────────────────┴──── بهازای هر انتشار اجرا میشود، ۰ درخواست ─┐
مقاله ─────────▶ ASSIGN بهترین ردیف استفادهنشده را برای این
│ خوشه انتخاب میکند، آن را استفادهشده علامت میزند، رندر میکند
└────────────────────────────────────────────────────────┘
آنچه این معماری به شما میدهد، بهترتیب اهمیت در حجم بالا:
- انتشار هرگز پشت یک API مسدود نمیشود. تخصیص یک خواندن از پایگاهداده است. قلاب ذخیرهٔ CMS شما، ساخت استاتیک شما و وارد کردن انبوهی ساعت سه صبح شما، همگی با سرعت محلی، آفلاین و بدون هیچ محدودیت نرخی در مسیر اجرا میشوند.
- حذف تکرار رایگان و دقیق است.
used_by_page IS NULLکل قابلیت است. دو صفحه نمیتوانند همان عکس را بگیرند، چون تخصیص یک تراکنش است، نه یک اکتشاف رتبهبندی. - اجراهای مجدد ارزان و ایدهمقتدر (idempotent) هستند. استخر یک خوشه را وقتی کم میآید یا وقتی عکاسی جدیدتر میخواهید (
after_date، یاsort_by=newest) تازه کنید — یک درخواست، و هیچچیز از موارد قبلاً منتشرشده جابهجا نمیشود. - زبانهای محلی رایگان به دست میآیند. ۲۰ ترجمهٔ یک مقاله یک صفحه در مدل شما با ۲۰ رندر است؛ آنها همان
photo_idتخصیصیافته را به اشتراک میگذارند و شما هرگز دوبار جستوجو نمیکنید. وقتی واقعاً نمای عکاسیشده بهصورت محلی میخواهید، پرسوجوی استخر را برای آن خوشه در زبان مقصد اجرا کنید — موتور یک جمله را در بیش از ۱۰۰ زبان میپذیرد.
وُرکر، در قالب کد
تقریباً شصت خط. پرکنندهٔ استخر تنها بخشی است که با شبکه صحبت میکند، پس تنها بخشی است که باید مراقب باشد — همزمانی محدود، رعایت 429، نتایج نوشتهشده در یک تراکنش.
import asyncio, os, time, httpx
SEARCH = "https://api.pexafy.com/api/v1/search/photos"
KEY = os.environ["PEXAFY_API_KEY"]
FIELDS = "photo_id,urls,width,height,blur_hash,alt_description,attribution"
# پلن رایگان = 20 درخواست/دقیقه. یک واحد کمتر بمانید. ضربانساز سراسری است: یک sleep بهازای هر تسک
# داخل دروازهٔ همزمانی اجازه میدهد N وُرکر با نرخ N برابر شلیک کنند.
PER_MIN = 19
gate = asyncio.Semaphore(4) # اتصالهای در حال پرواز
_lock = asyncio.Lock()
_slot = 0.0 # لحظهٔ آزاد بعدی روی خط زمانی مشترک
async def pace():
"""یک اسلات درخواست هر 60/PER_MIN ثانیه، برای کل ناوگان اختصاص میدهد."""
global _slot
async with _lock:
now = time.monotonic()
_slot = max(now, _slot) + 60 / PER_MIN
wait = _slot - now
if wait > 0:
await asyncio.sleep(wait)
class QuotaExhausted(Exception): ... # ماهانه: تلاش مجدد کمکی نمیکند
async def fill_pool(client, cluster) -> list[dict]:
"""یک درخواست ← تا ۱۰۰ عکس دارای اعتبار برای یک خوشهٔ موضوعی."""
for attempt in range(4):
await pace()
async with gate:
r = await client.get(
SEARCH,
headers={"X-Api-Key": KEY},
params={
"q": cluster["camera_brief"], # یک صحنه، نه کلیدواژه
"per_page": 100,
"orientation": "landscape",
"score_threshold": 0.5,
"fields": FIELDS,
},
timeout=15,
)
if r.status_code == 429:
retry_after = r.headers.get("Retry-After")
if retry_after is None: # بدون Retry-After ⇒ سهمیهٔ ماهانه،
raise QuotaExhausted(cluster["id"]) # کل اجرا را متوقف کن
await asyncio.sleep(int(retry_after)) # در دقیقه: پاک میشود
continue
r.raise_for_status()
return r.json()["data"]
return [] # لاگش کن؛ استخر ردیفهای قدیمیاش را نگه میدارد
async def refill(clusters):
async with httpx.AsyncClient(http2=True) as client:
pools = await asyncio.gather(*(fill_pool(client, c) for c in clusters))
for cluster, photos in zip(clusters, pools):
db.upsert_pool(cluster["id"], photos) # ON CONFLICT DO NOTHING بر photo_id
دو جزئیات در آنجا تفاوت بین وُرکری هستند که بدون نظارت اجرا میشود و وُرکری که شما را نیمهشب بیدار میکند. ضربانساز سراسری است، نه بهازای هر تسک: قرار دادن sleep داخل دروازهٔ همزمانی همان اشتباه کلاسیک است — چهار وُرکر که هرکدام ۳ ثانیه بعد از درخواست خودش مکث میکند، هر ۳ ثانیه چهار درخواست تولید میکند، تقریباً ۷۵ درخواست در دقیقه، و پلن رایگان بلافاصله 429 برمیگرداند. و این دو 429 یک جانور نیستند: آنکه در دقیقه است Retry-After دارد و خودبهخود پاک میشود، آنکه سهمیهٔ ماهانه است این را ندارد و هرگز هم نخواهد داشت — تلاش مجدد برای آن حلقهزدن در برابر یک دیوار است.
تخصیص، بخشی که در هر انتشار اجرا میشود، هرگز با شبکه تماس نمیگیرد:
# یکتایی توسط طرحواره اجرا میشود، نه با دقتورزی در پرسوجو.
# یک عکس میتواند در چند استخر خوشه بنشیند؛ فقط یکبار مجاز است PUBLISHED شود.
# CREATE UNIQUE INDEX one_use_per_photo ON image_pool (photo_id)
# WHERE used_by_page IS NOT NULL;
def assign_hero(page_id: str, cluster_id: str) -> dict | None:
for _ in range(5): # یک رقابت باخته فقط عکس بعدی را میگیرد
try:
return db.query_one("""
UPDATE image_pool p SET used_by_page = %s, used_at = NOW()
WHERE p.id = (
SELECT c.id FROM image_pool c
WHERE c.cluster_id = %s AND c.used_by_page IS NULL
AND NOT EXISTS ( -- توسط خوشهٔ دیگری استفاده شده؟
SELECT 1 FROM image_pool u
WHERE u.photo_id = c.photo_id
AND u.used_by_page IS NOT NULL
)
ORDER BY c.rank ASC
LIMIT 1 FOR UPDATE SKIP LOCKED -- امن با وُرکرهای موازی
)
RETURNING photo_id, urls, width, height, blur_hash, alt, credit
""", [page_id, cluster_id])
except UniqueViolation: # دو خوشه در همان میلیثانیه آن را ادعا کردند
continue
return None # استخر خالی ← بریف را گستردهتر کن، پرش کن
# رندر: هر ویژگی از خود ردیف میآید — بدون جابهجایی چیدمان، بدون حدس زدن.
# <img src="{urls[regular]}" width="{width}" height="{height}"
# alt="{alt}" loading="lazy" style="background:{blur_placeholder}">
# <figcaption>{credit}</figcaption>
دو حالت شکست، دو مکانیزم، و هر دو لازماند. FOR UPDATE SKIP LOCKED همزمانی درون یک خوشه را مدیریت میکند: صفحات را بهصورت موازی تولید کنید — و در این حجم قطعاً این کار را میکنید — و دو وُرکر در همان میلیثانیه به همان عکس با بالاترین رتبه دست میبرند.
ایندکس یکتای جزئی چیزی را مدیریت میکند که همه فراموش میکنند: همان عکس بهطور مشروع در استخرهای چند خوشه ظاهر میشود، چون خوشههای همسایه («بیمهٔ خانه برای مستأجران»، «…برای موجران») نتایج همپوشان برمیگردانند. یک بررسی used_by_page IS NULL بهازای هر خوشه نسبت به این کور است — هر خوشه فکر میکند عکس آزاد است. NOT EXISTS پرسوجو را صادق نگه میدارد، و ایندکس نادرست بودن آن را زیر بار همزمانی غیرممکن میکند: بازندهٔ رقابت با یک نقض مواجه میشود، دوباره تلاش میکند، و عکس بعدی را میگیرد. بدون آن، «هیچ دو صفحه یک تصویر شاخص را به اشتراک نمیگذارند» یک ادعا است، نه یک تضمین.
وقتی استخری در میانهٔ ساخت خالی میشود، بهترین راه بازگشتی گسترده کردن است نه تکرار: آخرین بند بریف دوربین را حذف کنید، یکبار پرسوجوی استخر را دوباره اجرا کنید، و تنها آنگاه از قدیمیترین عکس تخصیصیافته دوباره استفاده کنید — با قانونی سخت که هرگز روی صفحهای در همان خوشه فرود نیاید.
یک خوشه، یک استخر: یک پرسوجوی واقعی
یک مجموعهٔ مقایسه را در نظر بگیرید: بیمهٔ خانه، بیست صفحه — «بیمهٔ خانه برای مستأجران»، «…برای موجران»، «یک بیمهنامه واقعاً چه چیزی را پوشش میدهد»، دوازده صفحهٔ شهری، سه راهنمای ادعای خسارت. یک بریف دوربین برای کل خوشه، یک درخواست، و این سرِ استخر است که در ۱۲۲ میلیثانیه برگردانده شده:
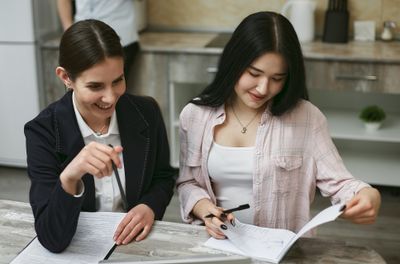
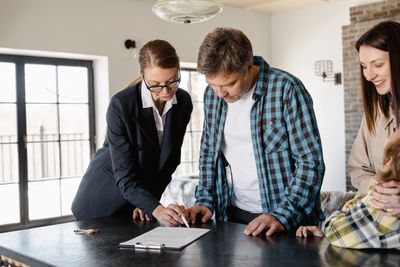
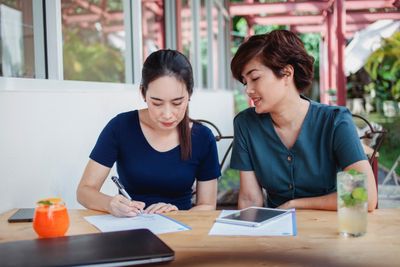
per_page=100 میخواهد و بقیه را نگه میدارد.
این جستوجوی دقیق را اجرا کنید ←
بریفها بیش از کد اهمیت دارند. دو قاعده در برخورد با یک مجموعهٔ واقعی از خوشهها زنده میمانند: بریف را برای خوشه بنویسید، نه برای صفحه (عناوین صفحات در مجموعههای برنامهای تقریباً یکساناند، پس بریفهای بهازای هر صفحه عکسهای تقریباً یکسان برمیگردانند)، و یک صحنه را توصیف کنید که یک دوربین میتوانست بگیرد نه موضوع را — بیمهٔ خانه فقط نمای نزدیک اسناد و هیچچیز دیگر برمیگرداند. ما دستور کپیپیستشدنی که این بریفها را تولید میکند را در
مقالهٔ تصویرگذاری هر پستی که منتشر میکنید منتشر کردیم.
حفظ انسجام تصویری یک مجموعهٔ ۲۰۰صفحهای
شکست معکوس تکرار، ناهماهنگی است: بیست صفحه در یک خوشه، هرکدام با عکسی از نظر فنی درست، اما در بیست سبک تصویری متفاوت. راهحل یک نقطهٔ پایانی است —
GET /photos/{id}/similar — یکبار روی عکسی اجرا شود که برای صفحهٔ اصلی تأیید کردهاید:
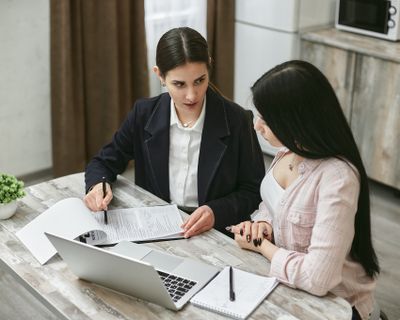
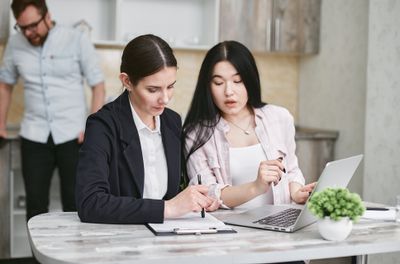
دو اهرم دیگر که ارزش سیمکشی داخل پرسوجوی استخر را دارند وقتی ثبات برند یک الزام است:
color_hex با یک color_tolerance کل یک مجموعه را در یک پالت نگه میدارد، و photographer یک خوشه را به مجموعهکار یک عکاس متصل میکند. هر دو پارامترهای پرسوجوی معمولی هستند — بدون محدودیت پلن روی فیلترهای جستوجو.
محدودیتهای نرخ، سهمیهها و هزینهٔ واقعی
پلن را بر اساس حجم انفجاری (burst) انتخاب کنید، نه حجم کلی. وقتی تجمیع کنید، سهمیهٔ ماهانه برای تقریباً همه دیگر محدودیت نیست؛ آنچه پلن شما را تعیین میکند این است که یک تازهسازی کامل با چه سرعتی باید تمام شود.
| پلن | درخواست / ماه= خوشههای قابلتازهسازی | محدودیت نرخ | کلیدهای API | تازهسازی ۱٬۰۰۰ خوشهزمان واقعی، یک دور |
|---|---|---|---|---|
| Free — $0 | 5,000 | 20 / دقیقه | 1 | 50 min |
| Starter — $5 | 25,000 | 30 / دقیقه | 3 | 34 min |
| Pro — $19 | 100,000 | 60 / دقیقه | 5 | 17 min |
| Team — $99آژانسها: یک کلید بهازای هر مشتری | 500,000 | 200 / دقیقه | 25 | 5 min |
| Business — $249 | 1,000,000 | 300 / دقیقه | unlimited | 4 min |
| Enterprise — $599 | 2,000,000 | 500 / دقیقه | unlimited | 2 min |
ستون اول را خوشه بخوانید: یک درخواست تجمیعکننده یک خوشه را پر میکند، پس سهمیهٔ ماهانه تعداد خوشههایی است که میتوانید تازه کنید، و ستون آخر مدتزمانی است که یک دور کامل روی یک مجموعهٔ ۱٬۰۰۰خوشهای در محدودیت نرخ آن پلن طول میکشد. هر دو مقادیر زنده از فهرست قیمتگذاری هستند — صفحهٔ قیمتگذاری همان محدودیتهای نرخ را بهصورت ساعتی بیان میکند نه دقیقهای.
پس یک مجموعهٔ ۱۰٬۰۰۰صفحهدرماه با الگوی تجمیعی، حدود ۵۰۰ درخواست مصرف میکند و هیچ پرداختی ندارد. آنچه تیمها را در جدول به بالا میبرد بهندرت حجم است — بلکه یکی از این سه چیز است: بازتصویرگذاری کامل یک مجموعهٔ موجود در یک شب، جداسازی کلید بهازای هر مشتری (یک آژانس میخواهد یک کلید بهازای هر مشتری داشته باشد تا استفاده بدون بندبازیهای راز مشترک قابل انتساب باشد)، یا یک پنجرهٔ ساخت که در دقیقهها اندازهگیری میشود نه ساعتها.
دو جزئیات عملیاتی که یک شب رفعاشکال را نجات میدهند. هر پاسخ شامل X-RateLimit-Limit و X-RateLimit-Remaining است، پس یک وُرکر میتواند بهجای حدس زدن، خودش را تنظیم کند. و یک 429 که واقعاً یک محدودیت نرخ در دقیقه است Retry-After دارد، در حالیکه یک مسدودسازی سهمیهٔ ماهانه عمداً آن را ندارد — تلاش مجدد آن را پاک نمیکند، و وُرکری که این دو را از هم تشخیص میدهد دیگر روی نقطهٔ پایانیای که چیزی برای دادن ندارد، تکرار نمیکند.
وقتی عامل هوش مصنوعی خود انتشار را انجام میدهد
اگر محتوای شما توسط یک عامل تولید میشود — و در این حجمها این روند رو به افزایش است — لایهٔ تجمیع ناپدید نمیشود، جابهجا میشود. ابزارهای جستوجو را به عامل بدهید و او در حالیکه هنوز بریف خوشه را در حافظهٔ زمینهای خود دارد، استخر را پر میکند، با استفاده از سرور
Model Context Protocol در mcp.pexafy.com/mcp: سه ابزار،
search_photos (یک جمله)، search_photos_by_image (یک تصویر مرجع، اختیاری بههمراه یک جمله) و get_similar_photos (همان ابزار انسجام مجموعهای که در بالا اشاره شد).
# Claude Code / اجراکنندهٔ CI
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# یا .mcp.json را کامیت کنید تا هر وُرکر در ناوگان آن را به ارث ببرد
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
دستورالعملی که در مقیاس بزرگ کار میکند یک دستورالعمل دستهای است، نه بهازای هر مقاله — و یکبهیک روی دو فاز بالا نگاشت میشود:
You این ۱۲ خوشهٔ موضوعی از تقویم محتوایی هستند. برای هرکدام،
یک بریف دوربین بنویس، ۱۰۰ عکس افقی بکش، و
استخر را در Postgres بنویس. هر خوشهای که زیر ۴۰
نتیجهٔ بالای ۰٫۵ برمیگرداند را علامت بزن — آن بریفها
نیاز به بازنویسی دارند.
Agent → search_photos(q="a woman signing paperwork with an insurance
agent at a kitchen table in her home", orientation="landscape")
← ۱۰۰ عکس · ۱۲۲ میلیثانیه · ۸۷ بالای آستانه
… ۱۱ خوشهٔ دیگر …
✓ ۱۱ استخر نوشته شد (۱٬۰۴۳ عکس، همه دارای اعتبار)
⚠ «تعادل مجدد صندوق شاخص» ← ۱۲ نتیجه. بریف انتزاعی است؛
پیشنهاد: «فردی پشت میز آشپزخانه که ارقام را روی
یک لپتاپ همراه با یک دفترچه یادداشت و قهوهٔ کنارش بررسی میکند»
همان سطر آخر دلیل قرار دادن عامل در این حلقه بهجای یک اسکریپت است: حالت شکست تصویرگذاری برنامهای یک بریف بد است، و بریف بد دقیقاً همان چیزی است که یک مدل زبانی میتواند متوجه شده و بازنویسی کند. اسکریپتها مسئول تخصیص میمانند، جایی که قطعیت اهمیت دارد و خلاقیت اهمیتی ندارد.
آنچه عکسها نمیتوانند رفع کنند
یک بخش صادقانه، چون شکستی که توصیف میکند پرهزینه است. عکاسی واقعی و دارای اعتبار، یک صفحه را بهبود میبخشد. محتوای کمارزش را به محتوای خوب تبدیل نمیکند، و هیچ خط تولید تصویر تغییری در نحوهٔ برخورد موتورهای جستوجو با صفحات انبوهتولیدشده که برای رتبه گرفتن وجود دارند نه برای کمک، ایجاد نمیکند. سیاستهای اسپم گوگل این را مستقیماً نام میبرند: سوءاستفادهٔ محتوای مقیاسبزرگشده، تولید بسیاری از صفحات با ارزش کم را پوشش میدهد خواه اتوماسیون در کار باشد یا نه، و تصویرگذاری در آن صفحات به آن قضاوت بیربط است.2
پس چارچوببندی مفید، محدود و درست است: عکاسی یک سیگنال کیفیتی است که شما کنترلش میکنید در صفحاتی که از قبل شایسته وجود داشتن هستند. جایی که بهطور قابلاثبات مؤثر است:
- منشأیی که خواننده میتواند تأیید کند. یک سطر اعتبار با نام عکاس و یک نشانی منبع، ادعایی است که میتوان بررسی کرد — نقطهٔ مقابل یک تصویر بدون اعتبار در صفحهای با نویسندهای بینام.
- دسترسپذیری و Core Web Vitals.
width/heightاز پاسخ، جابهجایی چیدمان را از بین میبرد،blur_hashیک جانگهدار واقعی میدهد، وalt_descriptionیک پیشنویس از متن alt است که قالب شما میتواند بهبود دهد نه اینکه اختراع کند. این را در ۴۰٬۰۰۰ جایگاه ضرب کنید و این کل داستان کیفیت تصویر سایت است. - ظاهر انبوهتولیدنشده. حذف تکرار و انسجام مجموعهای همان چیزهایی هستند که مانع میشوند یک مجموعه امضای تصویری داشته باشد. این یک هزینهٔ ادراکی واقعی با پیامدهای واقعی است، و کاملاً تحت کنترل شماست.
و مجوز همچنان بر تصویر حاکم است. الزام اعتباردهی توسط شرایط API پکسافای اجباری نیست —
هر نتیجه attribution.html و attribution.plain آمادهٔ رندر ارسال میکند — اما مجوزی که کتابخانهٔ اصلی به آن پیوست کرده روی استفادهٔ شما از آن عکس اعمال میشود، و در ۴۰٬۰۰۰ تصویر در ماه، رندر خودکار اعتبار ارزانتر از حسابرسی بعدی است.
از دوشنبه از کجا شروع کنیم
- لیست باقیماندهتان را در خوشهها گروهبندی کنید، ۱۵ تا ۳۰ صفحه که بهطور معقول میتوانند یک نشست عکاسی مشترک داشته باشند. این تنها گام واقعاً دستی است، و یک صفحهگسترده است، نه یک پروژه.
- یک بریف دوربین بهازای هر خوشه بنویسید — یک صحنه، ۱۲ تا ۲۵ کلمه. آنها را با یک مدل تولید کنید، سپس بخوانیدشان؛ بریفهایی که یک موضوع را بهجای یک صحنه نام میبرند، در یک نگاه قابلتشخیصاند.
- یک استخر را پر کنید با یک درخواست تکی
per_page=100و سرِ آن را چشمی بررسی کنید. اگر ده مورد برتر قابلاستفاده نیستند، بریف اشتباه است — نه موتور. - ستون
used_by_pageرا اضافه کنید پیش از اینکه هرچیزی را منتشر کنید. الان پنج دقیقه است و بعداً یک مهاجرت روی ۳٬۰۰۰ صفحهٔ زنده. - کل این کار را روی پلن رایگان اجرا کنید تا وقتی یک پنجرهٔ ساخت شما را بالا ببرد. با ۵۰۰ درخواست در ماه، این کمی طول میکشد.
منابع و پانویسها
1 قانون هوش مصنوعی اتحادیهٔ اروپا، مادهٔ ۵۰ — الزامات شفافیت قابلاجرا از ۲ اوت ۲۰۲۶: ارائهدهندگان سیستمهایی که تصویر، صدا، ویدیو یا متن مصنوعی تولید میکنند باید خروجیها را در قالبی قابلخواندن توسط ماشین نشانهگذاری کنند و آنها را قابلشناسایی بهعنوان مصنوعیتولیدشده کنند. این قانون ارائهدهندگان و استقراردهندگان هوش مصنوعی را ملزم میکند؛ قاعدهای دربارهٔ اینکه یک وبسایت چه تصاویری میتواند منتشر کند، نیست.
2 سیاستهای اسپم جستوجوی گوگل — سوءاستفادهٔ محتوای مقیاسبزرگشده: تولید بسیاری از صفحات که اساساً برای دستکاری رتبهبندیها هستند و ارزش کمی برای کاربران دارند، خواه از طریق اتوماسیون، تلاش انسانی یا ترکیبی از آنها ایجاد شده باشند. کیفیت تصویرگذاری عاملی در آن ارزیابی نیست، که دقیقاً به همین دلیل این مقاله این دو را جدا میکند.
منابع بررسیشده در تاریخ ۱۷ اوت ۲۰۲۶: سیاستهای اسپم جستوجوی گوگل · مادهٔ ۵۰ قانون هوش مصنوعی · اسناد API و MCP پکسافای. محدودیتهای پلن مقادیر زنده از جدول قیمتگذاری پکسافای هستند؛ زمانبندیهای جستوجو (۱۲۲ میلیثانیه، ۴۸ میلیثانیه) و هر عکس نمایشدادهشده، پاسخهای واقعی API هستند که همان روز ثبت شدهاند.
پرسشهای پرتکرار
چگونه برای هزاران صفحهی SEO برنامهمحور تصویر تهیه کنم؟
GET /api/v1/search/photos با per_page=100 تا ۱۰۰ عکس دارای اعتبار برای یک خوشه برمیگرداند؛ شما آنها را در یک جدول استخر ذخیره میکنید و در زمان انتشار، یکی را به هر صفحه اختصاص میدهید. یک مجموعهی ۱۰,۰۰۰ صفحه در ماه با چهار تصویر در هر صفحه، بهجای ۴۰,۰۰۰ درخواست تنها به حدود ۵۰۰ درخواست نیاز دارد که در پلن رایگان (۵,۰۰۰ درخواست در ماه) جای میگیرد.بهترین API عکس استوک برای تولید محتوا در حجم بالا کدام است؟
چگونه از تکرار یک عکس استوک در چند صفحه جلوگیری کنم؟
photo_id هر عکسی که منتشر میکنید را ذخیره کنید و عکسها را بهصورت تراکنشی از استخر بردارید — در SQL، دستور UPDATE … WHERE used_by_page IS NULL … FOR UPDATE SKIP LOCKED. در این صورت حذف تکرار بهجای احتمالی، دقیق میشود و ورکرهای موازی نمیتوانند برای گرفتن یک عکس رتبهبرتر با هم رقابت کنند. این تنها یک ستون است، و اضافه کردن آن پس از انتشار هزاران صفحهی فعال، بسیار پرهزینهتر از افزودن آن از روز اول است.یک درخواست API چند عکس میتواند برگرداند؟
per_page=100، و صفحهبندی مبتنی بر cursor این امکان را میدهد که برای استخرهای عمیقتر همچنان در همان مجموعهی نتایج رتبهبندیشده پیش بروید. این را با score_threshold ترکیب کنید تا خوشهای کممحتوا بهجای ۱۰۰ نتیجهی سست، ۴۰ تطابق قوی برگرداند، و با fields تا فقط ویژگیهایی که قالب شما نمایش میدهد بازگردانده شود که پاسخها را در حجم بالا کوچک نگه میدارد.آیا عکسهای واقعی به رتبه بهتر صفحات تولیدشده در مقیاس کمک میکنند؟
آیا یک ایجنت هوش مصنوعی میتواند بهصورت خودکار یک استخر تصویر را پر کند؟
mcp.pexafy.com/mcp که ابزارهای search_photos، search_photos_by_image و photo_similar را در معرض دید قرار میدهد. فهرستی از خوشهها را در اختیار ایجنت بگذارید تا برای هر یک یک بریف دوربین بنویسد، استخرها را بکشد و بریفهایی را که تطابق قوی کافی نداشتهاند علامتگذاری کند — که این همان حالت واقعی شکست در تصویرسازی برنامهمحور است. تخصیص باید در اسکریپتهای شما باقی بماند، جایی که قطعیت مهمتر از خلاقیت است.

