Ilustra 10.000 páginas al mes con fotos reales — en 500 llamadas a la API
Busca una vez por clúster temático en lugar de una vez por imagen, y 40.000 llamadas a la API se convierten en 500. El patrón de pool y asignación, el worker que sobrevive a los límites de tasa y una sección honesta sobre lo que las fotografías no pueden arreglar.
 Marouane Tijani
12 min de lectura

Existe una versión del problema de ilustrar contenido que ninguna cantidad de buen gusto resuelve: no estás eligiendo una foto, estás rellenando 40.000 huecos de imagen al mes en 800 clústeres temáticos, 9 idiomas y 14 sitios de clientes, y cada uno de ellos necesita estar licenciado, acreditado, dimensionado y ser distinto del de al lado. A ese volumen la pregunta deja de ser «¿qué foto?» y pasa a ser «¿cuál es la arquitectura?»
Este artículo es la respuesta de la API: el patrón de peticiones que reduce el número de llamadas en dos órdenes de magnitud, el worker que sobrevive a los límites de tasa, la deduplicación que evita que un sitio de 10.000 páginas parezca un muro con la misma foto de stock — y una sección honesta sobre lo que las imágenes no pueden hacer por ti.
El verdadero cuello de botella con 10.000 artículos
Los equipos que publican a volumen — entramados de SEO programático, páginas de categoría de marketplaces, agregadores, redes de afiliación, agencias que gestionan contenido para una cartera de clientes, pipelines de localización que convierten un artículo en 20 — chocan todos contra los mismos tres muros, en el mismo orden:
- Número de llamadas. Una búsqueda por hueco de imagen significa 40.000 llamadas a la API para 10.000 artículos de cuatro imágenes. Todos los proveedores te tarifan, limitan y revisan según ese número.
- Repetición. Hacia la página treinta, la misma foto empieza a reaparecer. En la página tres mil, tu sitio tiene una firma visual: generado en masa.
- Coordinación. Cien artículos de un mismo clúster deberían parecer una serie, no cien tableros de Pinterest inconexos — y la siguiente versión localizada del mismo artículo debería reutilizar la misma imagen, no buscar otra vez en otro idioma.
Fíjate en lo que no está en esa lista: encontrar una buena foto. Un motor semántico devuelve una página de candidatas utilizables en unos 130 milisegundos. La recuperación ya estaba resuelta; la distribución no. Todo lo que viene a continuación trata de distribución.
Por qué fotos reales, precisamente a este volumen
El argumento a favor de la fotografía frente a la generación se vuelve más fuerte a medida que sube el volumen, por razones que son sobre todo operativas más que estéticas.
| Con 40.000 imágenes/mes | Generarlas | Buscarlas |
|---|---|---|
| Tiempo por imagen | De segundos a minutos, más los intentos descartados | Una petición (~130 ms) cubre un clúster entero |
| Motor del coste | Por imagen, para siempre | Por petición — y una petición sirve a ~25 artículos |
| Metadatos que obtienes | Ninguno. El texto alt y las dimensiones los escribes tú | Dimensiones, color dominante, blur hash, borrador de pie de foto, línea de crédito |
| Procedencia | Marcadas como sintéticas de forma legible por máquina bajo el Reglamento de IA de la UE desde el 2 de agosto de 20261 | Un fotógrafo con nombre, una fecha, una URL de origen que un lector puede abrir |
| Modo de fallo | Detalles plausibles pero erróneos, estilo de casa uniforme | Nada encajó con el brief — obtienes cero resultados, algo que puedes gestionar |
La fila de metadatos es la que decide los pipelines. Cada resultado de búsqueda ya trae
width, height, blur_hash, color_hex,
alt_description y una cadena attribution.html lista para usar — que es
exactamente el payload que un motor de plantillas necesita para emitir un
<img> sin desplazamiento de layout, con placeholder y crédito. Las imágenes generadas te dan un archivo y
te dejan los otros seis campos para que te los inventes.
Dónde la generación sigue ganando a escala. Ilustración a nivel de categoría para taxonomías abstractas («migración a la nube», «fondos indexados»), diagramas y un estilo de casa que quieres repetir en todo un entramado por motivos de marca. La división en la que aterrizan la mayoría de grandes editores: fotografías para todo lo que existe en el mundo, arte generado para todo lo que solo existe en un argumento. Desarrollamos el argumento completo de esa división en cómo ilustrar cada artículo que publicas.
Una petición, cien fotos
Este es el único cambio que reconfigura la aritmética. El endpoint de búsqueda acepta
per_page hasta 100, y la paginación por cursor te permite seguir recorriendo el
mismo conjunto de resultados ordenado. Así que la unidad de trabajo no es una imagen, es un conjunto.
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a woman signing paperwork with an insurance agent at a kitchen table in her home" \
  --data-urlencode "per_page=100" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "score_threshold=0.5" \
  --data-urlencode "fields=photo_id,urls,width,height,blur_hash,alt_description,attribution"

# → { "success": true, "data": [ …hasta 100 fotos… ],
#     "pagination": { "per_page": 100, "has_more": true, "next_cursor": "eyJyc…" },
#     "meta": { "took_ms": 122.33, "request_id": "7ff1fb9b-…" } }
Tres parámetros de ahí hacen un trabajo silencioso a escala:
fields— un conjunto de campos reducido. Pide los siete campos que tu plantilla renderiza y la respuesta deja de enviar la larga descripción por IA de cada foto. A lo largo de 40.000 fotos esa es la diferencia entre un build que fluye y uno que hace swap.score_threshold— la cola de una página de 100 resultados es, por definición, menos relevante que la cabeza. Poner un suelo significa que un clúster pobre devuelve 34 fotos en lugar de 100 mediocres, y tu pipeline puede reaccionar a eso en lugar de publicarlo.next_cursor— cuando un clúster realmente necesita 300 fotos, pagina el mismo conjunto ordenado en vez de lanzar tres consultas distintas que se solapan.
Y aquí está la aritmética, para un sitio que publica 10.000 páginas al mes con cuatro imágenes cada una:
| Estrategia | Peticiones / mes | Una pasada al límite de tasa del plan gratuito20 req/min | ¿Cabe en la cuota mensual gratuita? |
|---|---|---|---|
| Una búsqueda por hueco de imagen | 40.000 | 33 hours | No — un plan de pago |
| Una búsqueda por artículo | 10.000 | 8 hours | No — un plan de pago |
| Una búsqueda por clúster de ~20 artículosel patrón de este artículo | 500 | 25 minutes | Sí |
Las mismas 40.000 imágenes publicadas en las tres filas. Lo único que cambió es dónde está el bucle.
Agrupar y asignar: el patrón que escala
Toda la arquitectura son dos fases que se ejecutan a frecuencias distintas, con una tabla entre ellas:
                     ┌────── se ejecuta semanalmente, ~500 peticiones ──────┐
  clústeres temáticos ──▶ POOL   una búsqueda por clúster, per_page=100
                     │       └─▶ guarda 100 filas de fotos por clúster
                     └──────────────────┬───────────────────────────────┘
                                        ▼
                              tabla image_pool
                        (cluster, photo_id, urls, blur_hash,
                         alt, credit, used_by_page, used_at)
                                        │
                     ┌──────────────────┴──── por publicación, 0 peticiones ───┐
  artículo ─────────▶ ASSIGN  elige la mejor fila sin usar de este
                     │        clúster, márcala como usada, renderiza
                     └────────────────────────────────────────────────────────┘
Lo que esto te aporta, en orden de cuánto importa a volumen:
- La publicación nunca se bloquea por una API. La asignación es una lectura de base de datos. El hook de guardado de tu CMS, tu build estático y tu importación masiva de las 3 de la mañana corren todos a velocidad local, sin conexión, sin ningún límite de tasa en el camino.
- La deduplicación es gratis y exacta.
used_by_page IS NULLes toda la funcionalidad. Dos páginas no pueden tomar la misma foto, porque la asignación es una transacción, no una heurística de ranking. - Reejecutar es barato e idempotente. Refresca el conjunto de un clúster cuando se quede corto
o cuando quieras fotografía más reciente (
after_date, osort_by=newest) — una petición, y nada de lo ya publicado se mueve. - Los idiomas salen gratis. Las 20 traducciones de un artículo son una página en
tu modelo con 20 renderizados; comparten el
photo_idasignado y nunca buscas dos veces. Cuando sí quieras un aspecto rodado localmente, ejecuta la consulta del conjunto para ese clúster en el idioma de destino — el motor acepta una frase en más de 100 de ellos.
El worker, en código
Unas sesenta líneas. El llenador del conjunto es la única parte que habla con la red, así que es la
única parte que necesita ser cuidadosa — concurrencia limitada, 429 respetado, resultados
escritos en una sola transacción.
import asyncio, os, time, httpx

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
KEY    = os.environ["PEXAFY_API_KEY"]
FIELDS = "photo_id,urls,width,height,blur_hash,alt_description,attribution"

# Free = 20 req/min. Quédate uno por debajo. El pacer es GLOBAL: un sleep por tarea
# dentro de la barrera de concurrencia dejaría a N workers disparar N× la tasa.
PER_MIN = 19
gate    = asyncio.Semaphore(4)         # conexiones en vuelo
_lock   = asyncio.Lock()
_slot   = 0.0                          # próximo momento libre en la línea compartida

async def pace():
    """Reparte un slot de petición cada 60/PER_MIN segundos, para toda la flota."""
    global _slot
    async with _lock:
        now  = time.monotonic()
        _slot = max(now, _slot) + 60 / PER_MIN
        wait  = _slot - now
    if wait > 0:
        await asyncio.sleep(wait)

class QuotaExhausted(Exception): ...   # mensual: reintentar no sirve

async def fill_pool(client, cluster) -> list[dict]:
    """Una petición → hasta 100 fotos acreditadas para un clúster temático."""
    for attempt in range(4):
        await pace()
        async with gate:
            r = await client.get(
                SEARCH,
                headers={"X-Api-Key": KEY},
                params={
                    "q": cluster["camera_brief"],   # una escena, no la keyword
                    "per_page": 100,
                    "orientation": "landscape",
                    "score_threshold": 0.5,
                    "fields": FIELDS,
                },
                timeout=15,
            )
        if r.status_code == 429:
            retry_after = r.headers.get("Retry-After")
            if retry_after is None:            # sin Retry-After ⇒ cuota mensual,
                raise QuotaExhausted(cluster["id"])   # detén toda la ejecución
            await asyncio.sleep(int(retry_after))   # por minuto: se libera
            continue
        r.raise_for_status()
        return r.json()["data"]
    return []                                  # regístralo; el pool mantiene sus filas

async def refill(clusters):
    async with httpx.AsyncClient(http2=True) as client:
        pools = await asyncio.gather(*(fill_pool(client, c) for c in clusters))
    for cluster, photos in zip(clusters, pools):
        db.upsert_pool(cluster["id"], photos)     # ON CONFLICT DO NOTHING en photo_id
Dos detalles de ahí son la diferencia entre un worker que corre sin supervisión y uno que
te despierta de noche. El pacer es global, no por tarea: meter el sleep dentro de la
barrera de concurrencia es el error clásico — cuatro workers pausando 3 segundos cada uno tras su
propia petición producen cuatro peticiones cada 3 segundos, unas 75 por minuto, y el plan gratuito
empieza a devolver 429 de inmediato. Y los dos 429 no son el mismo
animal: el de por minuto lleva Retry-After y se resuelve solo, el de cuota mensual
no lo lleva y nunca lo llevará — reintentar eso es un bucle contra un muro.
La asignación, la parte que se ejecuta en cada publicación, nunca toca la red:
# La unicidad la impone el esquema, no que la consulta sea cuidadosa.
# Una foto puede estar en varios pools de clúster; solo puede PUBLICARSE una vez.
# CREATE UNIQUE INDEX one_use_per_photo ON image_pool (photo_id)
#        WHERE used_by_page IS NOT NULL;

def assign_hero(page_id: str, cluster_id: str) -> dict | None:
    for _ in range(5):                # perder la carrera solo toma la siguiente foto
        try:
            return db.query_one("""
                UPDATE image_pool p SET used_by_page = %s, used_at = NOW()
                WHERE p.id = (
                    SELECT c.id FROM image_pool c
                    WHERE c.cluster_id = %s AND c.used_by_page IS NULL
                      AND NOT EXISTS (              -- ¿usada por CUALQUIER otro clúster?
                          SELECT 1 FROM image_pool u
                          WHERE u.photo_id = c.photo_id
                            AND u.used_by_page IS NOT NULL
                      )
                    ORDER BY c.rank ASC
                    LIMIT 1 FOR UPDATE SKIP LOCKED  -- seguro con workers en paralelo
                )
                RETURNING photo_id, urls, width, height, blur_hash, alt, credit
            """, [page_id, cluster_id])
        except UniqueViolation:      # dos clústeres la reclamaron en el mismo ms
            continue
    return None                     # pool agotado → amplía el brief, rellena

# Renderizado: cada atributo viene de la fila — sin layout shift, sin adivinar.
# <img src="{urls[regular]}" width="{width}" height="{height}"
#      alt="{alt}" loading="lazy" style="background:{blur_placeholder}">
# <figcaption>{credit}</figcaption>
Dos modos de fallo, dos mecanismos, y ambos son necesarios. FOR UPDATE SKIP LOCKED
gestiona la concurrencia dentro de un clúster: genera páginas en paralelo — y a este volumen
lo harás — y dos workers alcanzan la misma foto mejor posicionada en el mismo milisegundo.
El índice único parcial gestiona el caso que todo el mundo olvida: la misma foto aparece legítimamente
en los pools de varios clústeres, porque clústeres vecinos («seguro de hogar para
inquilinos», «…para propietarios») devuelven resultados solapados. Una comprobación por clúster de
used_by_page IS NULL es ciega a eso — cada clúster cree que la foto está
libre. El NOT EXISTS mantiene honesta a la consulta, y el índice hace imposible
equivocarse bajo concurrencia: el perdedor de la carrera recibe una violación, reintenta y toma la siguiente
foto. Sin él, «dos páginas nunca comparten portada» es una afirmación, no una garantía.
Cuando un pool se agota a mitad de build, el fallback que mejor se comporta es ampliar en vez de repetir: elimina la última cláusula del camera brief, vuelve a ejecutar la consulta del pool una vez, y solo entonces reutiliza la foto asignada hace más tiempo — con una regla dura: que nunca acabe en una página del mismo clúster.
Un clúster, un pool: una consulta real
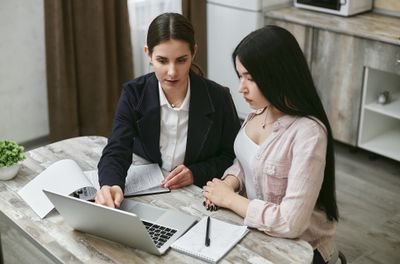
Toma un entramado de comparativas: seguro de hogar, veinte páginas — «seguro de hogar para inquilinos», «…para propietarios», «qué cubre realmente una póliza», doce páginas de ciudad, tres guías de siniestros. Un camera brief para el clúster, una petición, y esta es la cabeza del pool, devuelta en 122 ms:
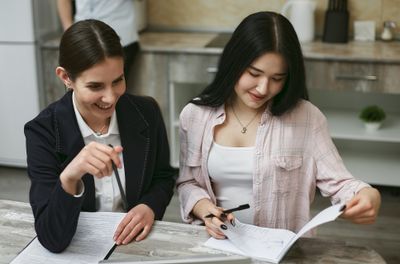
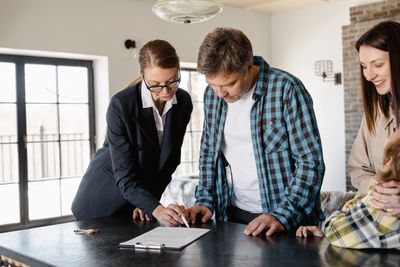
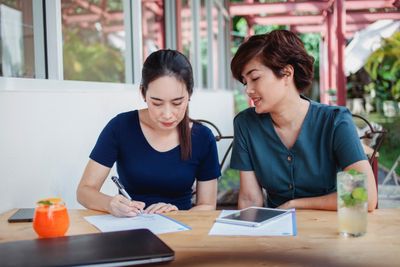
per_page=100 y guarda el resto.
Ejecuta esta búsqueda exacta →
Los briefs importan más que el código. Dos reglas sobreviven al contacto con un entramado real de clústeres:
escribe el brief para el clúster, no para la página (los títulos de página son casi idénticos
en conjuntos programáticos, así que los briefs por página devuelven fotos casi idénticas), y describe una escena
que una cámara podría haber captado en lugar del tema — home insurance devuelve primeros planos de
documentos y nada más. Publicamos el prompt copiable que produce estos briefs en
el artículo sobre ilustrar cada publicación.
Mantener visualmente coherente una serie de 200 páginas
El fallo opuesto a la repetición es la incoherencia: veinte páginas en un clúster, cada una con una
foto técnicamente correcta, en veinte registros visuales distintos. La solución es un endpoint —
GET /photos/{id}/similar — ejecutado una vez sobre la foto que aprobaste para la página pilar:
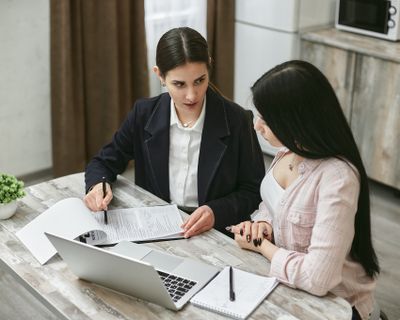
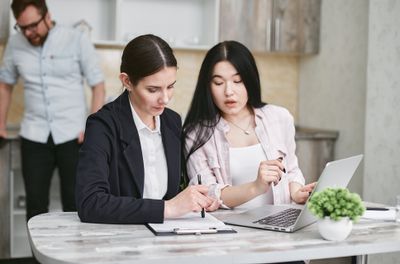
Dos palancas más que conviene conectar a la consulta del pool cuando la consistencia de marca es un requisito:
color_hex con un color_tolerance mantiene todo un entramado dentro de una
paleta, y photographer fija un clúster al cuerpo de trabajo de un solo fotógrafo. Ambos
son parámetros de consulta ordinarios — sin restricciones de plan en los filtros de búsqueda.
Límites de tasa, cuotas y lo que cuesta realmente
Elige el plan por la ráfaga, no por el volumen. Una vez que agrupas, la cuota mensual deja de ser la restricción para casi todo el mundo; lo que decide tu plan es con qué rapidez debe terminar un refresco completo.
| Plan | Peticiones / mes= clústeres refrescables | Límite de tasa | Claves API | Refrescar 1.000 clústerestiempo real, una pasada |
|---|---|---|---|---|
| Free — $0 | 5,000 | 20 / min | 1 | 50 min |
| Starter — $5 | 25,000 | 30 / min | 3 | 34 min |
| Pro — $19 | 100,000 | 60 / min | 5 | 17 min |
| Team — $99agencias: una clave por cliente | 500,000 | 200 / min | 25 | 5 min |
| Business — $249 | 1,000,000 | 300 / min | unlimited | 4 min |
| Enterprise — $599 | 2,000,000 | 500 / min | unlimited | 2 min |
Lee la primera columna como clústeres: una petición de pooling llena un clúster, así que la cuota mensual es el número de clústeres que puedes refrescar, y la última columna es cuánto tarda una pasada completa sobre un entramado de 1.000 clústeres al límite de tasa de ese plan. Ambos son valores en vivo del catálogo de precios — la página de precios indica los mismos límites de tasa por hora en lugar de por minuto.
Así que un entramado de 10.000 páginas al mes con el patrón agrupado gasta ~500 peticiones y paga nada. Lo que empuja a los equipos hacia arriba en la tabla rara vez es el volumen — es una de tres cosas: una reilustración completa de un entramado existente en una noche, aislamiento de claves por cliente (una agencia quiere una clave por cliente para que el uso sea atribuible sin gimnasia de secretos compartidos), o una ventana de build medida en minutos y no en horas.
Dos detalles operativos que ahorran una noche de depuración. Cada respuesta trae
X-RateLimit-Limit y X-RateLimit-Remaining, así que un worker puede regular su
propio ritmo en lugar de adivinar. Y un 429 que es un verdadero límite por minuto lleva
Retry-After, mientras que un bloqueo de cuota mensual deliberadamente no lo lleva — reintentar
no resolverá ese, y un worker que distingue ambos deja de machacar un endpoint
que ya no tiene nada que dar.
Cuando el agente hace la publicación
Si tu contenido lo produce un agente — y a estos volúmenes cada vez más lo hace — la capa de pooling
no desaparece, se mueve. Dale al agente las herramientas de búsqueda y llenará el pool mientras
todavía tiene el brief del clúster en contexto, usando el servidor de
Model Context Protocol en mcp.pexafy.com/mcp: tres herramientas,
search_photos (una frase), search_photos_by_image (una imagen de referencia,
opcionalmente junto a una frase) y get_similar_photos (la de coherencia de serie de más arriba).
# Claude Code / runner de CI
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# o commitea .mcp.json para que cada worker de la flota lo herede
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
La instrucción que funciona a escala es una instrucción por lotes, no por artículo — y se corresponde uno a uno con las dos fases anteriores:
You  Aquí tienes 12 clústeres temáticos del calendario de contenidos. Para cada uno,
     escribe un camera brief, trae 100 fotos apaisadas y escribe
     el pool en Postgres. Marca cualquier clúster que devuelva menos de 40
     resultados por encima de 0.5 — esos briefs necesitan reescritura.

Agent  → search_photos(q="a woman signing paperwork with an insurance
           agent at a kitchen table in her home", orientation="landscape")
      ← 100 fotos · 122 ms · 87 por encima del umbral
      … 11 clústeres más …

      ✓ 11 pools escritos (1.043 fotos, todas acreditadas)
      ⚠ "index fund rebalancing" → 12 resultados. El brief es abstracto;
        sugerencia: "a person at a kitchen table checking figures on a
        laptop with a notebook and coffee beside them"
Esa última línea es la razón de poner al agente en este bucle en lugar de un script: el modo de fallo de la ilustración programática es un mal brief, y un mal brief es exactamente lo que un modelo de lenguaje puede detectar y reescribir. Los scripts siguen a cargo de la asignación, donde importa el determinismo y no la creatividad.
Lo que las fotografías no pueden arreglar
Una sección honesta, porque el fallo que describe es caro. La fotografía real y acreditada mejora una página. No convierte contenido pobre en buen contenido, y ningún pipeline de imágenes cambia cómo tratan los motores de búsqueda a las páginas producidas en masa que existen para posicionar y no para ayudar. Las políticas de spam de Google lo nombran directamente: el abuso de contenido a escala cubre la generación de muchas páginas de poco valor con independencia de si hay automatización de por medio, y las ilustraciones de esas páginas son irrelevantes para ese juicio.2
Así que el marco útil es estrecho y cierto: la fotografía es una señal de calidad que controlas en páginas que ya merecen existir. Donde compensa de forma demostrable:
- Procedencia que un lector puede verificar. Una línea de crédito con el nombre de un fotógrafo y una URL de origen es una afirmación comprobable — lo contrario de una imagen sin atribución en una página con un autor sin atribución.
- Accesibilidad y Core Web Vitals.
width/heightde la respuesta eliminan el desplazamiento de layout,blur_hashda un placeholder real, yalt_descriptiones un borrador del texto alt que tu plantilla puede mejorar en vez de inventar. Multiplícalo por 40.000 huecos y ahí está toda la historia de calidad de imagen del sitio. - No parecer producido en masa. La deduplicación y la coherencia de serie son lo que evita que un entramado tenga una firma visual. Ese es un coste de percepción real con consecuencias reales, y está enteramente bajo tu control.
Y la licencia sigue gobernando la imagen. La atribución no es obligatoria según los términos de la API de Pexafy —
cada resultado incluye attribution.html y attribution.plain listos para
renderizar — pero la licencia que adjunta la biblioteca original se aplica a tu uso de esa foto, y
con 40.000 imágenes al mes, renderizar el crédito automáticamente es más barato que auditar después.
Por dónde empezar el lunes
- Agrupa tu backlog en clústeres de 15–30 páginas que plausiblemente podrían compartir una sesión de fotos. Este es el único paso genuinamente manual, y es una hoja de cálculo, no un proyecto.
- Escribe un camera brief por clúster — una escena, de 12 a 25 palabras. Genéralos con un modelo, y luego léelos; los briefs que nombran un tema en lugar de una escena se ven de un vistazo.
- Llena un pool con una única petición
per_page=100y examina su cabeza. Si las diez primeras no son utilizables, el brief está mal — no el motor. - Añade la columna
used_by_pageantes de publicar nada. Son cinco minutos ahora y una migración sobre 3.000 páginas en producción después. - Ejecuta todo en el plan gratuito hasta que una ventana de build te obligue a subir. A 500 peticiones al mes, tardará un buen rato.
Referencias y notas
1 Reglamento de IA de la UE, artículo 50 — obligaciones de transparencia aplicables desde el 2 de agosto de 2026: los proveedores de sistemas que generan imagen, audio, vídeo o texto sintéticos deben marcar las salidas en un formato legible por máquina y hacerlas detectables como generadas artificialmente. Vincula a proveedores y responsables del despliegue de IA; no es una norma sobre qué imágenes puede publicar un sitio web.
2 Políticas de spam de Google Search — abuso de contenido a escala: generar muchas páginas principalmente para manipular el posicionamiento y ofreciendo poco valor a los usuarios, ya sea creado mediante automatización, esfuerzo humano o una combinación. La calidad de la ilustración no es un factor en esa valoración, que es precisamente por lo que este artículo separa ambas cosas.
Fuentes consultadas el 17 de agosto de 2026: Políticas de spam de Google Search · Artículo 50 del Reglamento de IA · Documentación de la API y el MCP de Pexafy. Los límites de los planes son los valores en vivo de la tabla de precios de Pexafy; los tiempos de búsqueda (122 ms, 48 ms) y cada foto mostrada son respuestas reales de la API capturadas el mismo día.
Preguntas frecuentes
¿Cómo consigo imágenes para miles de páginas de SEO programático?
GET /api/v1/search/photos con per_page=100 devuelve hasta 100 fotos acreditadas para un clúster; las guardas en una tabla de pool y asignas una por página en el momento de publicar. Un sitio de 10.000 páginas al mes con cuatro imágenes por página necesita unas 500 peticiones en lugar de 40.000, lo que cabe dentro del plan gratuito (5.000 peticiones/mes).¿Cuál es la mejor API de fotos de stock para producción de contenido a gran volumen?
¿Cómo evito que la misma foto de stock aparezca en varias páginas?
photo_id de cada imagen que publiques y reclama las fotos del pool de forma transaccional — en SQL, un UPDATE … WHERE used_by_page IS NULL … FOR UPDATE SKIP LOCKED. La deduplicación pasa entonces a ser exacta en lugar de probabilística, y los workers de build paralelos no pueden competir por la misma foto mejor posicionada. Es una sola columna, y añadirla a posteriori en miles de páginas en producción es mucho más caro que incluirla desde el primer día.¿Cuántas fotos puede devolver una sola petición a la API?
per_page=100, y la paginación por cursor te permite seguir recorriendo el mismo conjunto de resultados ordenado para crear pools más profundos. Combínalo con score_threshold para que un clúster escaso devuelva 40 coincidencias sólidas en lugar de 100 flojas, y con fields para devolver solo los atributos que renderiza tu plantilla, lo que mantiene las respuestas ligeras a gran volumen.¿Las fotos reales ayudan a posicionar mejor las páginas producidas a escala?
¿Puede un agente de IA llenar un pool de imágenes automáticamente?
mcp.pexafy.com/mcp, que expone search_photos, search_photos_by_image y photo_similar. Dale al agente una lista de clústeres y escribirá un brief fotográfico para cada uno, recuperará los pools y marcará los briefs que devolvieron demasiadas pocas coincidencias sólidas — que es el auténtico modo de fallo de la ilustración programática. La asignación se queda en tus scripts, donde el determinismo importa más que la creatividad.

