10.000 Seiten im Monat mit echten Fotos illustrieren — in 500 API-Aufrufen
Suche einmal pro Themencluster statt einmal pro Bild, und aus 40.000 API-Aufrufen werden 500. Das Pool-and-Assign-Muster, der Worker, der Ratenlimits übersteht, und ein ehrlicher Abschnitt darüber, was Fotos nicht reparieren können.
 Marouane Tijani
12 Min. Lesezeit

Es gibt eine Variante des Content-Illustrationsproblems, die kein noch so guter Geschmack löst: Ihr wählt nicht ein Foto aus, sondern befüllt 40.000 Bildplätze im Monat über 800 Themen-Cluster, 9 Sprachversionen und 14 Kunden-Sites hinweg, und jedes einzelne muss lizenziert, kreditiert, in der Größe angepasst und vom Nachbarn unterscheidbar sein. Bei diesem Volumen lautet die Frage nicht mehr „welches Foto?“, sondern „welche Architektur?“
Dieser Artikel liefert die API-Antwort: das Anfragemuster, das die Zahl der Aufrufe um zwei Größenordnungen reduziert, den Worker, der Rate-Limits übersteht, die Deduplizierung, die verhindert, dass eine 10.000-Seiten-Site wie eine Wand aus demselben Stockfoto aussieht — und einen ehrlichen Abschnitt darüber, was Bilder nicht für euch leisten können.
Der eigentliche Engpass bei 10.000 Artikeln
Teams, die im großen Volumen veröffentlichen — programmatische SEO-Portfolios, Marketplace-Kategorieseiten, Aggregatoren, Affiliate-Netzwerke, Agenturen, die Content für ein Kundenportfolio produzieren, Lokalisierungs-Pipelines, die aus einem Artikel 20 machen — stoßen alle in derselben Reihenfolge auf dieselben drei Wände:
- Anzahl der Aufrufe. Eine Suche pro Bildplatz bedeutet 40.000 API-Aufrufe für 10.000 Artikel mit je vier Bildern. Jeder Anbieter bepreist, drosselt und prüft euch anhand dieser Zahl.
- Wiederholung. Etwa ab Seite dreißig taucht dasselbe Foto wieder auf. Bei Seite dreitausend hat eure Site eine visuelle Signatur: massenhaft generiert.
- Koordination. Hundert Artikel in einem Cluster sollten wie eine Serie aussehen, nicht wie hundert unzusammenhängende Pinterest-Boards — und die nächste Sprachversion desselben Artikels sollte dasselbe Bild wiederverwenden, statt erneut in einer anderen Sprache zu suchen.
Bemerkenswert ist, was nicht auf dieser Liste steht: ein gutes Foto zu finden. Eine semantische Engine liefert eine Seite brauchbarer Kandidaten in rund 130 Millisekunden. Retrieval ist gelöst; Distribution nicht. Alles, was folgt, dreht sich um Distribution.
Warum echte Fotos, gerade bei diesem Volumen
Das Argument für Fotografie gegenüber Generierung wird mit steigendem Volumen stärker — aus Gründen, die überwiegend betrieblicher, nicht ästhetischer Natur sind.
| Bei 40.000 Bildern/Monat | Generieren | Suchen |
|---|---|---|
| Zeit pro Bild | Sekunden bis Minuten, plus die verworfenen Versuche | Eine Anfrage (~130 ms) deckt einen ganzen Cluster ab |
| Kostentreiber | Pro Bild, dauerhaft | Pro Anfrage — und eine Anfrage bedient ~25 Artikel |
| Metadaten, die ihr erhaltet | Keine. Alt-Text und Abmessungen schreibt ihr selbst | Abmessungen, dominante Farbe, Blur-Hash, Caption-Entwurf, Credit-Zeile |
| Provenienz | Maschinell als synthetisch gekennzeichnet gemäß EU-KI-Verordnung seit 2. August 20261 | Ein namentlich genannter Fotograf, ein Datum, eine Quell-URL, die eine Leserin öffnen kann |
| Fehlerbild | Plausible, aber falsche Details, einheitlicher Hausstil | Nichts passt zum Briefing — ihr erhaltet null Ergebnisse, damit lässt sich umgehen |
Die Metadaten-Zeile ist diejenige, die über Pipelines entscheidet. Jedes Suchergebnis liefert bereits
width, height, blur_hash, color_hex,
alt_description und eine fertige attribution.html-Zeichenkette — genau
die Nutzlast, die eine Templating-Engine braucht, um ein layoutverschiebungsfreies
<img> mit Platzhalter und Credit auszugeben. Generierte Bilder liefern eine Datei und
überlassen euch die Erfindung der übrigen sechs Felder.
Wo Generierung im großen Maßstab weiterhin punktet. Illustration auf Kategorieebene für abstrakte Taxonomien („Cloud-Migration“, „Indexfonds“), Diagramme und ein Hausstil, den ihr aus Markengründen über ein ganzes Portfolio hinweg wiederholen wollt. Die Aufteilung, bei der die meisten großen Publisher landen: Fotografien für alles, was in der realen Welt existiert, generierte Kunst für alles, was nur in einem Argument existiert. Diese Aufteilung haben wir ausführlich begründet in wie ihr jeden veröffentlichten Artikel illustriert.
Eine Anfrage, hundert Fotos
Das ist die eine Änderung, die die Arithmetik neu ordnet. Der Such-Endpunkt akzeptiert
per_page bis zu 100, und Cursor-Pagination erlaubt es euch, dasselbe gerankte
Ergebnis-Set weiter zu durchlaufen. Die Arbeitseinheit ist also nicht ein Bild, sondern ein Pool.
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a woman signing paperwork with an insurance agent at a kitchen table in her home" \
  --data-urlencode "per_page=100" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "score_threshold=0.5" \
  --data-urlencode "fields=photo_id,urls,width,height,blur_hash,alt_description,attribution"

# → { "success": true, "data": [ …bis zu 100 Fotos… ],
#     "pagination": { "per_page": 100, "has_more": true, "next_cursor": "eyJyc…" },
#     "meta": { "took_ms": 122.33, "request_id": "7ff1fb9b-…" } }
Drei Parameter darin leisten im großen Maßstab stille Arbeit:
fields— ein Sparse Fieldset. Fragt nur die sieben Felder ab, die euer Template rendert, und die Antwort verzichtet auf die lange KI-Beschreibung jedes Fotos. Bei 40.000 Fotos ist das der Unterschied zwischen einem Build, der streamt, und einem, der swapt.score_threshold— das Ende einer 100-Ergebnis-Seite ist per Definition weniger relevant als der Anfang. Eine Untergrenze zu setzen bedeutet, dass ein dünner Cluster 34 statt 100 mittelmäßiger Fotos liefert, und eure Pipeline kann darauf reagieren, statt sie zu veröffentlichen.next_cursor— wenn ein Cluster tatsächlich 300 Fotos benötigt, paginiert dasselbe gerankte Set, statt drei verschiedene, sich überschneidende Queries abzusetzen.
Und hier die Arithmetik für eine Site, die 10.000 Seiten pro Monat mit je vier Bildern veröffentlicht:
| Strategie | Anfragen / Monat | Ein Durchlauf beim Rate-Limit des Free-Plans20 Anfragen/min | Passt ins monatliche Free-Kontingent? |
|---|---|---|---|
| Eine Suche pro Bildplatz | 40.000 | 33 hours | Nein — kostenpflichtiger Plan nötig |
| Eine Suche pro Artikel | 10.000 | 8 hours | Nein — kostenpflichtiger Plan nötig |
| Eine Suche pro Cluster von ~20 Artikelndas Muster in diesem Artikel | 500 | 25 minutes | Ja |
Dieselben 40.000 veröffentlichten Bilder in allen drei Zeilen. Verändert hat sich nur, wo die Schleife ansetzt.
Pool und Zuweisung: das skalierende Muster
Die gesamte Architektur besteht aus zwei Phasen, die mit unterschiedlicher Frequenz laufen, mit einer Tabelle dazwischen:
                     ┌─────────── läuft wöchentlich, ~500 Anfragen ───────────┐
  Themen-Cluster ──▶ POOL   einmal pro Cluster suchen, per_page=100
                     │       └─▶ 100 Foto-Zeilen pro Cluster speichern
                     └──────────────────┬───────────────────────────────┘
                                        ▼
                              image_pool-Tabelle
                        (cluster, photo_id, urls, blur_hash,
                         alt, credit, used_by_page, used_at)
                                        │
                     ┌──────────────────┴──── läuft pro Veröffentlichung, 0 Anfragen ───┐
  Artikel ─────────▶ ASSIGN  beste ungenutzte Zeile für diesen
                     │        Cluster wählen, als genutzt markieren, rendern
                     └────────────────────────────────────────────────────────┘
Was euch das bringt, geordnet nach Bedeutung im großen Maßstab:
- Publishing blockiert nie an einer API. Zuweisung ist ein Datenbank-Read. Euer CMS-Save-Hook, euer statischer Build und euer 3-Uhr-nachts-Massenimport laufen alle mit lokaler Geschwindigkeit, offline, ohne Rate-Limit irgendwo im Pfad.
- Deduplizierung ist kostenlos und exakt.
used_by_page IS NULList das ganze Feature. Zwei Seiten können nicht dasselbe Foto ziehen, weil die Zuweisung eine Transaktion ist, keine heuristische Rangfolge. - Neuläufe sind billig und idempotent. Aktualisiert den Pool eines Clusters, wenn er zur Neige geht
oder wenn ihr neuere Fotografie wollt (
after_dateodersort_by=newest) — eine Anfrage, und nichts bereits Veröffentlichtes ändert sich. - Sprachversionen gibt es gratis dazu. Die 20 Übersetzungen eines Artikels sind in eurem Modell eine
Seite mit 20 Renderings; sie teilen sich die zugewiesene
photo_id, und ihr sucht nie zweimal. Wenn ihr doch einen lokal aufgenommenen Look wollt, führt die Pool-Query für diesen Cluster in der Zielsprache aus — die Engine akzeptiert einen Satz in über 100 Sprachen.
Der Worker, im Code
Rund sechzig Zeilen. Der Pool-Füller ist der einzige Teil, der mit dem Netzwerk spricht, also
der einzige Teil, der Sorgfalt braucht — Nebenläufigkeit begrenzt, 429 beachtet, Ergebnisse
in einer Transaktion geschrieben.
import asyncio, os, time, httpx

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
KEY    = os.environ["PEXAFY_API_KEY"]
FIELDS = "photo_id,urls,width,height,blur_hash,alt_description,attribution"

# Free = 20 Anfragen/min. Bleibt eine darunter. Der Pacer ist GLOBAL: ein Sleep pro Task
# innerhalb des Concurrency-Gates würde N Workern das N-Fache der Rate erlauben.
PER_MIN = 19
gate    = asyncio.Semaphore(4)         # laufende Verbindungen
_lock   = asyncio.Lock()
_slot   = 0.0                          # nächster freier Moment auf der gemeinsamen Zeitachse

async def pace():
    """Vergibt flottenweit alle 60/PER_MIN Sekunden einen Anfrageslot."""
    global _slot
    async with _lock:
        now  = time.monotonic()
        _slot = max(now, _slot) + 60 / PER_MIN
        wait  = _slot - now
    if wait > 0:
        await asyncio.sleep(wait)

class QuotaExhausted(Exception): ...   # monatlich: Retry hilft nicht

async def fill_pool(client, cluster) -> list[dict]:
    """Eine Anfrage → bis zu 100 lizenzierte Fotos für einen Themen-Cluster."""
    for attempt in range(4):
        await pace()
        async with gate:
            r = await client.get(
                SEARCH,
                headers={"X-Api-Key": KEY},
                params={
                    "q": cluster["camera_brief"],   # eine Szene, kein Schlagwort
                    "per_page": 100,
                    "orientation": "landscape",
                    "score_threshold": 0.5,
                    "fields": FIELDS,
                },
                timeout=15,
            )
        if r.status_code == 429:
            retry_after = r.headers.get("Retry-After")
            if retry_after is None:            # kein Retry-After ⇒ Monatskontingent,
                raise QuotaExhausted(cluster["id"])   # gesamten Lauf abbrechen
            await asyncio.sleep(int(retry_after))   # pro Minute: löst sich auf
            continue
        r.raise_for_status()
        return r.json()["data"]
    return []                                  # loggen; der Pool behält seine alten Zeilen

async def refill(clusters):
    async with httpx.AsyncClient(http2=True) as client:
        pools = await asyncio.gather(*(fill_pool(client, c) for c in clusters))
    for cluster, photos in zip(clusters, pools):
        db.upsert_pool(cluster["id"], photos)     # ON CONFLICT DO NOTHING auf photo_id
Zwei Details darin machen den Unterschied zwischen einem Worker, der unbeaufsichtigt läuft, und einem, der euch
weckt. Der Pacer ist global, nicht pro Task: den Sleep innerhalb des
Concurrency-Gates zu platzieren, ist der klassische Fehler — vier Worker, die jeweils 3 Sekunden nach ihrer
eigenen Anfrage pausieren, erzeugen vier Anfragen alle 3 Sekunden, rund 75 pro Minute, und der Free-Plan
liefert sofort 429. Und die zwei 429-Fehler sind nicht dasselbe
Tier: der pro Minute trägt Retry-After und löst sich von selbst auf, der Monatskontingent-Fehler
trägt es nicht und wird es nie tun — ein Retry darauf ist eine Schleife gegen eine Wand.
Die Zuweisung, der Teil, der bei jeder Veröffentlichung läuft, berührt niemals das Netzwerk:
# Eindeutigkeit wird durch das Schema erzwungen, nicht durch eine vorsichtige Query.
# Ein Foto kann in mehreren Cluster-Pools stehen; VERÖFFENTLICHT werden darf es nur einmal.
# CREATE UNIQUE INDEX one_use_per_photo ON image_pool (photo_id)
#        WHERE used_by_page IS NOT NULL;

def assign_hero(page_id: str, cluster_id: str) -> dict | None:
    for _ in range(5):                # ein verlorenes Rennen nimmt einfach das nächste Foto
        try:
            return db.query_one("""
                UPDATE image_pool p SET used_by_page = %s, used_at = NOW()
                WHERE p.id = (
                    SELECT c.id FROM image_pool c
                    WHERE c.cluster_id = %s AND c.used_by_page IS NULL
                      AND NOT EXISTS (              -- von IRGENDEINEM anderen Cluster genutzt?
                          SELECT 1 FROM image_pool u
                          WHERE u.photo_id = c.photo_id
                            AND u.used_by_page IS NOT NULL
                      )
                    ORDER BY c.rank ASC
                    LIMIT 1 FOR UPDATE SKIP LOCKED  -- sicher bei parallelen Workern
                )
                RETURNING photo_id, urls, width, height, blur_hash, alt, credit
            """, [page_id, cluster_id])
        except UniqueViolation:      # zwei Cluster beanspruchten es in derselben Millisekunde
            continue
    return None                     # Pool leer → Briefing erweitern, neu befüllen

# Rendering: jedes Attribut stammt aus der Zeile — keine Layoutverschiebung, kein Raten.
# <img src="{urls[regular]}" width="{width}" height="{height}"
#      alt="{alt}" loading="lazy" style="background:{blur_placeholder}">
# <figcaption>{credit}</figcaption>
Zwei Fehlerbilder, zwei Mechanismen, und beide werden gebraucht. FOR UPDATE SKIP LOCKED
behandelt Nebenläufigkeit innerhalb eines Clusters: Seiten parallel generieren — und bei diesem Volumen
werdet ihr das tun — und zwei Worker greifen in derselben Millisekunde nach demselben top-gerankten Foto.
Der partielle Unique-Index behandelt das, was jeder vergisst: Dasselbe Foto taucht legitim
in den Pools mehrerer Cluster auf, weil benachbarte Cluster („Hausratversicherung für
Mieter“, „…für Vermieter“) überlappende Ergebnisse liefern. Ein pro-Cluster-Check auf
used_by_page IS NULL ist dafür blind — jeder Cluster glaubt, das Foto sei
frei. Das NOT EXISTS hält die Query ehrlich, und der Index macht es unter Nebenläufigkeit
unmöglich, dass es schiefgeht: Der Verlierer des Rennens erhält eine Verletzung, versucht es erneut und nimmt das nächste
Foto. Ohne ihn ist „keine zwei Seiten teilen sich ein Hero-Bild“ eine Behauptung, keine Garantie.
Wenn ein Pool mitten im Build leerläuft, verhält sich der Fallback am besten, wenn er erweitert statt wiederholt: die letzte Klausel des Kamera-Briefings streichen, die Pool-Query einmal neu ausführen und erst dann das am längsten zugewiesene Foto wiederverwenden — mit der festen Regel, dass es niemals auf einer Seite desselben Clusters landet.
Ein Cluster, ein Pool: eine echte Query
Nehmen wir ein Vergleichsportfolio: Hausratversicherung, zwanzig Seiten — „Hausratversicherung für Mieter“, „…für Vermieter“, „was eine Police tatsächlich abdeckt“, zwölf Stadtseiten, drei Schadensratgeber. Ein Kamera-Briefing für den Cluster, eine Anfrage, und das ist der Kopf des Pools, geliefert in 122 ms:
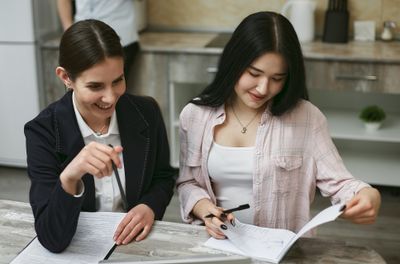
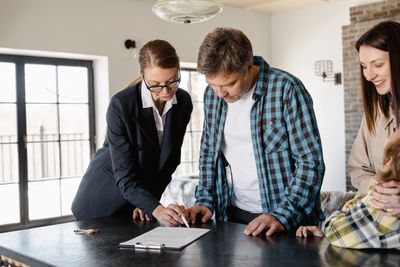
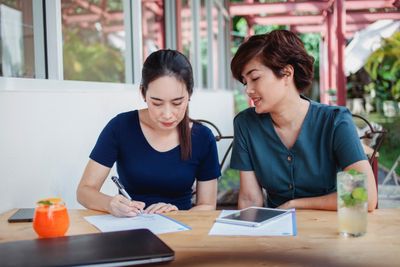
per_page=100 an und behält den Rest.
Genau diese Suche ausführen →
Die Briefings zählen mehr als der Code. Zwei Regeln überleben den Kontakt mit einem echten Portfolio von Clustern:
Schreibt das Briefing für den Cluster, nicht für die Seite (Seitentitel sind bei programmatischen Sets
fast identisch, daher liefern seitenweise Briefings fast identische Fotos), und beschreibt eine Szene,
die eine Kamera hätte aufnehmen können, statt das Thema — Hausratversicherung liefert Dokumenten-
Nahaufnahmen und sonst nichts. Wir haben den kopierfertigen Prompt, der diese Briefings erzeugt, in
dem Artikel zum Illustrieren jedes Beitrags veröffentlicht.
Eine 200-seitige Serie visuell kohärent halten
Der gegenteilige Fehler zur Wiederholung ist Inkohärenz: zwanzig Seiten in einem Cluster, jede mit einem
technisch korrekten Foto, aber in zwanzig verschiedenen visuellen Registern. Die Lösung ist ein Endpunkt —
GET /photos/{id}/similar — einmal ausgeführt auf dem Foto, das ihr für die Pillar-Page freigegeben habt:
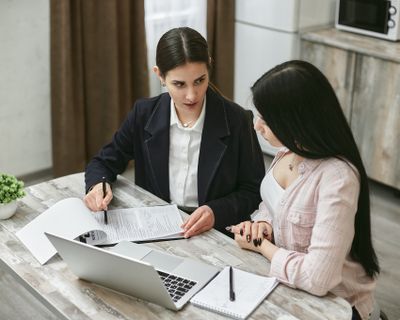
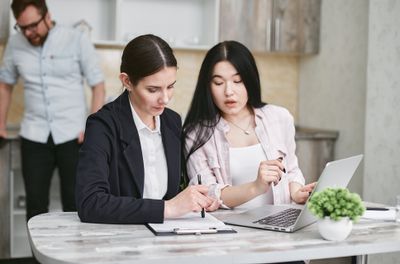
Zwei weitere Hebel, die sich lohnen, in die Pool-Query einzubauen, wenn Markenkonsistenz eine Anforderung ist:
color_hex mit einer color_tolerance hält ein ganzes Portfolio innerhalb einer
Palette, und photographer bindet einen Cluster an das Werk eines einzelnen Fotografen. Beide
sind gewöhnliche Query-Parameter — kein Plan-Gating auf Suchfilter.
Rate-Limits, Kontingente und was es tatsächlich kostet
Wählt den Plan nach Burst, nicht nach Volumen. Sobald ihr pooling einsetzt, ist das monatliche Kontingent für fast niemanden mehr die Einschränkung; ausschlaggebend für euren Plan ist, wie schnell eine vollständige Aktualisierung abgeschlossen sein muss.
| Plan | Anfragen / Monat= aktualisierbare Cluster | Rate-Limit | API-Schlüssel | 1.000 Cluster aktualisierenEchtzeit, ein Durchlauf |
|---|---|---|---|---|
| Free — $0 | 5,000 | 20 / min | 1 | 50 min |
| Starter — $5 | 25,000 | 30 / min | 3 | 34 min |
| Pro — $19 | 100,000 | 60 / min | 5 | 17 min |
| Team — $99Agenturen: ein Schlüssel pro Kunde | 500,000 | 200 / min | 25 | 5 min |
| Business — $249 | 1,000,000 | 300 / min | unlimited | 4 min |
| Enterprise — $599 | 2,000,000 | 500 / min | unlimited | 2 min |
Lest die erste Spalte als Cluster: eine Pooling-Anfrage befüllt einen Cluster, das monatliche Kontingent ist also die Anzahl der Cluster, die ihr aktualisieren könnt, und die letzte Spalte gibt an, wie lange ein vollständiger Durchlauf über ein Portfolio von 1.000 Clustern beim Rate-Limit dieses Plans dauert. Beide sind Live-Werte aus dem Preiskatalog — die Preisseite nennt dieselben Rate-Limits pro Stunde statt pro Minute.
Ein Portfolio mit 10.000 Seiten im Monat kommt beim gepoolten Muster also mit ~500 Anfragen aus und zahlt nichts. Was Teams in der Tabelle nach oben treibt, ist selten das Volumen — es ist eines von drei Dingen: eine vollständige Neu-Illustration eines bestehenden Portfolios über Nacht, kundenweise Schlüssel-Isolation (eine Agentur will pro Kunde einen Schlüssel, damit Nutzung ohne Shared-Secret-Akrobatik zuordenbar ist), oder ein Build-Fenster, das in Minuten statt Stunden gemessen wird.
Zwei betriebliche Details, die euch eine durchgearbeitete Nacht ersparen. Jede Antwort trägt
X-RateLimit-Limit und X-RateLimit-Remaining, sodass sich ein Worker
selbst takten kann, statt zu raten. Und ein 429, der ein echtes Pro-Minute-Rate-Limit ist, trägt
Retry-After, während eine Sperre wegen des Monatskontingents dies bewusst nicht tut — ein
Retry löst diese nicht auf, und ein Worker, der beide unterscheidet, hört auf, gegen einen Endpunkt anzurennen,
der nichts mehr zu geben hat.
Wenn der Agent die Veröffentlichung übernimmt
Wenn euer Content von einem Agenten erzeugt wird — und bei diesen Volumina wird das zunehmend der Fall sein —,
verschwindet die Pooling-Schicht nicht, sie verschiebt sich. Gebt dem Agenten die Suchwerkzeuge, und er befüllt den Pool,
solange er das Cluster-Briefing noch im Kontext hat, über den
Model Context Protocol-Server unter mcp.pexafy.com/mcp: drei Werkzeuge,
search_photos (ein Satz), search_photos_by_image (ein Referenzbild,
optional plus ein Satz) und get_similar_photos (das oben beschriebene für Serienkohärenz).
# Claude Code / CI-Runner
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# oder .mcp.json committen, damit jeder Worker der Flotte es übernimmt
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
Die Anweisung, die im großen Maßstab funktioniert, ist eine Batch-Anweisung, keine pro Artikel — und sie bildet eins zu eins die beiden oben beschriebenen Phasen ab:
You  Hier sind 12 Themen-Cluster aus dem Redaktionskalender. Schreibe für
     jeden ein Kamera-Briefing, ziehe 100 Landschaftsfotos und schreibe
     den Pool nach Postgres. Markiere jeden Cluster, der unter 40
     Ergebnisse über 0,5 liefert — diese Briefings müssen überarbeitet werden.

Agent  → search_photos(q="a woman signing paperwork with an insurance
           agent at a kitchen table in her home", orientation="landscape")
      ← 100 Fotos · 122 ms · 87 über dem Schwellenwert
      … 11 weitere Cluster …

      ✓ 11 Pools geschrieben (1.043 Fotos, alle kreditiert)
      ⚠ „index fund rebalancing“ → 12 Ergebnisse. Das Briefing ist abstrakt;
        Vorschlag: „a person at a kitchen table checking figures on a
        laptop with a notebook and coffee beside them“
Diese letzte Zeile ist der Grund, den Agenten in diese Schleife einzubinden statt ein Skript: Das Fehlerbild programmatischer Illustration ist ein schlechtes Briefing, und ein schlechtes Briefing ist genau das, was ein Sprachmodell bemerken und umschreiben kann. Die Zuweisung bleibt Sache der Skripte, wo Determinismus zählt und Kreativität nicht.
Was Fotografien nicht reparieren können
Ein ehrlicher Abschnitt, denn das Fehlerbild, das er beschreibt, ist teuer. Echte, kreditierte Fotografie verbessert eine Seite. Sie macht dünnen Content nicht zu gutem Content, und keine Bild-Pipeline ändert, wie Suchmaschinen massenproduzierte Seiten behandeln, die existieren, um zu ranken, statt zu helfen. Googles Spam-Richtlinien benennen das direkt: Scaled Content Abuse umfasst das Erzeugen vieler Seiten mit wenig Mehrwert, unabhängig davon, ob Automatisierung im Spiel ist, und die Illustrationen auf diesen Seiten sind für diese Bewertung irrelevant.2
Die nützliche Einordnung ist also eng und zutreffend: Fotografie ist ein von euch kontrolliertes Qualitätssignal auf Seiten, die bereits verdienen zu existieren. Wo sie sich nachweislich auszahlt:
- Provenienz, die eine Leserin prüfen kann. Eine Credit-Zeile mit dem Namen eines Fotografen und einer Quell-URL ist eine überprüfbare Angabe — das Gegenteil eines nicht zugeschriebenen Bildes auf einer Seite mit nicht genanntem Autor.
- Barrierefreiheit und Core Web Vitals.
width/heightaus der Antwort verhindern Layoutverschiebungen,blur_hashliefert einen echten Platzhalter, undalt_descriptionist ein Entwurf des Alt-Texts, den euer Template verbessern kann, statt ihn zu erfinden. Multipliziert mit 40.000 Plätzen ist das die ganze Bildqualitätsgeschichte der Site. - Nicht massenproduziert aussehen. Deduplizierung und Serienkohärenz sind es, die verhindern, dass ein Portfolio eine visuelle Signatur bekommt. Das ist ein realer Wahrnehmungskosten-Faktor mit realen Konsequenzen, und er liegt vollständig in eurer Hand.
Und die Lizenz bestimmt weiterhin das Bild. Attribution wird von den Pexafy-API-Bedingungen nicht verlangt —
jedes Ergebnis liefert attribution.html und attribution.plain renderbereit —
aber die von der ursprünglichen Bibliothek beigefügte Lizenz gilt für eure Nutzung dieses Fotos, und
bei 40.000 Bildern im Monat ist es günstiger, den Credit automatisch zu rendern, als später zu auditieren.
Wo ihr am Montag anfangt
- Gruppiert euren Rückstand in Cluster von 15–30 Seiten, die sich plausibel ein Fotoshooting teilen könnten. Das ist der einzige wirklich manuelle Schritt, und er ist eine Tabellenkalkulation, kein Projekt.
- Schreibt ein Kamera-Briefing pro Cluster — eine Szene, 12 bis 25 Wörter. Erzeugt sie mit einem Modell, lest sie dann; Briefings, die ein Thema statt einer Szene benennen, fallen auf den ersten Blick auf.
- Befüllt einen Pool mit einer einzigen
per_page=100-Anfrage und schaut euch den Kopf davon an. Wenn die Top Ten nicht brauchbar sind, ist das Briefing falsch — nicht die Engine. - Fügt die Spalte
used_by_pagehinzu, bevor ihr etwas veröffentlicht. Das dauert jetzt fünf Minuten und später eine Migration über 3.000 Live-Seiten. - Lasst das Ganze auf dem Free-Plan laufen, bis euch ein Build-Fenster zum Wechsel zwingt. Bei 500 Anfragen im Monat dauert das eine Weile.
Quellen & Fußnoten
1 EU-KI-Verordnung, Artikel 50 — Transparenzpflichten, anwendbar ab 2. August 2026: Anbieter von Systemen, die synthetische Bilder, Audio, Video oder Text erzeugen, müssen Ausgaben in einem maschinenlesbaren Format kennzeichnen und als künstlich erzeugt erkennbar machen. Sie bindet KI-Anbieter und -Einsetzer; sie ist keine Regel darüber, welche Bilder eine Website veröffentlichen darf.
2 Google-Search-Spam-Richtlinien — Scaled Content Abuse: das Erzeugen vieler Seiten primär zur Manipulation von Rankings, die Nutzern wenig Mehrwert bieten, unabhängig davon, ob sie durch Automatisierung, menschlichen Aufwand oder eine Kombination entstanden sind. Illustrationsqualität ist bei dieser Bewertung kein Faktor — genau deshalb trennt dieser Artikel die beiden Themen.
Quellen geprüft am 17. August 2026: Google-Search-Spam-Richtlinien · AI-Act Artikel 50 · Pexafy-API- & MCP-Dokumentation. Plan-Limits sind die Live-Werte aus der Pexafy-Preistabelle; die Suchzeiten (122 ms, 48 ms) und jedes gezeigte Foto sind reale API-Antworten, die am selben Tag erfasst wurden.
Häufig gestellte Fragen
Wie bekomme ich Bilder für Tausende programmatische SEO-Seiten?
GET /api/v1/search/photos-Anfrage mit per_page=100 liefert bis zu 100 kreditierte Fotos für einen Cluster; du speicherst sie in einer Pool-Tabelle und weist beim Veröffentlichen eines pro Seite zu. Ein Bestand von 10.000 Seiten pro Monat mit vier Bildern pro Seite benötigt ungefähr 500 Anfragen statt 40.000, was in den kostenlosen Plan passt (5.000 Anfragen/Monat).Was ist die beste Stockfoto-API für hochvolumige Content-Produktion?
Wie verhindere ich, dass dasselbe Stockfoto auf mehreren Seiten erscheint?
photo_id jedes veröffentlichten Bildes und beanspruche Fotos transaktional aus dem Pool — in SQL etwa mit UPDATE … WHERE used_by_page IS NULL … FOR UPDATE SKIP LOCKED. Deduplizierung wird dadurch exakt statt probabilistisch, und parallele Build-Worker können nicht um dasselbe bestplatzierte Foto konkurrieren. Es ist nur eine Spalte, und sie nachträglich über Tausende live geschaltete Seiten einzuführen, ist weit teurer, als sie gleich von Anfang an anzulegen.Wie viele Fotos kann eine API-Anfrage zurückgeben?
per_page=100, und Cursor-Paginierung erlaubt es, dieselbe gerankte Ergebnismenge für tiefere Pools weiter zu durchlaufen. Kombiniere das mit score_threshold, damit ein dünner Cluster 40 starke Treffer statt 100 lose Treffer liefert, und mit fields, um nur die Attribute zurückzugeben, die dein Template rendert, was Antworten bei hohem Volumen klein hält.Helfen echte Fotos Seiten, die in großem Umfang produziert werden, besser zu ranken?
Kann ein KI-Agent einen Bildpool automatisch füllen?
mcp.pexafy.com/mcp, der search_photos, search_photos_by_image und photo_similar bereitstellt. Gib dem Agenten eine Liste von Clustern, und er schreibt jeweils ein Kamera-Briefing, zieht die Pools und markiert die Briefings, die zu wenige starke Treffer geliefert haben — was der eigentliche Fehlerfall programmatischer Illustration ist. Die Zuweisung bleibt in deinen Skripten, wo Determinismus wichtiger ist als Kreativität.

