每月为 10,000 个页面配上真实照片——只需 500 次 API 调用
按主题簇搜索一次,而不是每张图搜索一次,40,000 次 API 调用就变成了 500 次。池化与分配模式、能扛住速率限制的 worker,以及一节关于照片解决不了什么问题的坦诚讨论。
 Marouane Tijani
12 分钟阅读

内容配图问题有一种版本,是再好的品味也解决不了的:你不是在挑一张照片,而是在为 800 个主题集群、9 种语言和 14 个客户站点每月填满 40,000 个图片位,而且每一张都必须有授权、有署名、有尺寸,并且和旁边那张不同。到了这个量级,问题不再是“选哪张照片?”,而是“架构是什么?”
本文给出 API 层面的答案:把调用次数压低两个数量级的请求模式、能扛住速率限制的 worker、让一个 10,000 页的站点不至于看起来像同一张图库照片堆成的墙的去重方案——以及一节诚实地讲照片帮不了你什么的内容。
10,000 篇文章时真正的瓶颈
规模化发布的团队——程序化 SEO 站群、市场类目页、聚合站、联盟网络、为一批客户做内容的代理商、把一篇文章变成 20 篇的本地化流水线——都会按同样的顺序撞上同样的三堵墙:
- 调用次数。每个图片位搜一次,意味着 10,000 篇四图文章要 40,000 次 API 调用。每家服务商都按这个数字计价、限流并审核你。
- 重复。大约到第三十页,同一张照片就开始反复出现。到第三千页,你的站点有了一种视觉签名:批量生成。
- 协调。同一集群里的一百篇文章应该看起来像一个系列,而不是一百个互不相关的 Pinterest 画板——同一篇文章的下一种语言版本应该复用同一张图片,而不是换个语言再搜一遍。
注意这份清单上没有什么:找到一张好照片。语义引擎大约 130 毫秒就能返回一整页可用的候选。检索已经被解决了;分发没有。下面的一切都关于分发。
为什么在这个量级上尤其要用真实照片
随着量级上升,选摄影而非生成的理由更强了,原因大多是运营层面的,而非审美层面的。
| 每月 40,000 张图片时 | 生成它们 | 搜索它们 |
|---|---|---|
| 单张耗时 | 几秒到几分钟,还要算上被废弃的尝试 | 一次请求(约 130 ms)覆盖整个集群 |
| 成本驱动因素 | 按张计费,永远如此 | 按请求计费——而一次请求服务约 25 篇文章 |
| 你拿到的元数据 | 没有。alt 文本和尺寸都得你自己写 | 尺寸、主色、blur hash、说明文字草稿、署名行 |
| 出处 | 自 2026 年 8 月 2 日起,依据欧盟《人工智能法案》被机器标记为合成内容1 | 一位具名摄影师、一个日期、一个读者可以打开的来源 URL |
| 失败模式 | 细节看似可信但错误,风格千篇一律 | 没有匹配简报的结果——你得到零结果,而这是可以处理的 |
元数据那一行才是决定流水线的关键。每个搜索结果已经自带
width、height、blur_hash、color_hex、
alt_description 以及一段现成的 attribution.html 字符串——这正是模板引擎输出一个带占位图和署名、且无布局偏移的
<img> 所需要的载荷。生成图片只给你一个文件,其余六个字段留给你自己编。
生成在规模化场景中仍然占优的地方。抽象分类法的类目级配图(“云迁移”“指数基金”)、示意图,以及出于品牌原因希望在整个站群中重复的统一风格。大多数大型出版方最终采用的划分是:世界上存在的东西用照片,只存在于论述中的东西用生成图。我们在 如何为你发布的每一篇文章配图 中完整论证了这一划分。
一次请求,一百张照片
这是重塑算术的那一个改动。搜索端点的 per_page 最大可到 100,游标分页让你能继续遍历同一个排序结果集。所以工作单元不是一张图片,而是一个池。
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
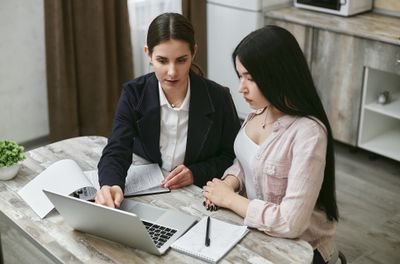
  --data-urlencode "q=a woman signing paperwork with an insurance agent at a kitchen table in her home" \
  --data-urlencode "per_page=100" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "score_threshold=0.5" \
  --data-urlencode "fields=photo_id,urls,width,height,blur_hash,alt_description,attribution"

# → { "success": true, "data": [ …最多 100 张照片… ],
#     "pagination": { "per_page": 100, "has_more": true, "next_cursor": "eyJyc…" },
#     "meta": { "took_ms": 122.33, "request_id": "7ff1fb9b-…" } }
其中有三个参数在规模化场景里默默发挥作用:
fields——稀疏字段集。只请求模板要渲染的那七个字段,响应就不会再携带每张照片冗长的 AI 描述。跨 40,000 张照片,这就是构建流畅与卡顿交换内存之间的差别。score_threshold——一页 100 条结果的尾部,按定义就是不如头部相关。设一个下限意味着一个薄弱集群返回 34 张照片而不是 100 张平庸的,你的流水线可以对此作出反应,而不是直接发布。next_cursor——当一个集群确实需要 300 张照片时,对同一个排序结果集分页,而不是发三个互相重叠的不同查询。
下面是算术,针对一个每月发布 10,000 页、每页四张图片的站点:
| 策略 | 请求数 / 月 | 在免费套餐速率限制下跑一遍20 req/min | 能装进免费月度配额吗? |
|---|---|---|---|
| 每个图片位搜一次 | 40,000 | 33 hours | 不能——需付费套餐 |
| 每篇文章搜一次 | 10,000 | 8 hours | 不能——需付费套餐 |
| 每约 20 篇文章的集群搜一次本文所述模式 | 500 | 25 minutes | 可以 |
三行都是同样发布 40,000 张图片。唯一变化的是循环放在哪里。
池化与分配:可扩展的模式
整个架构就是两个以不同频率运行的阶段,中间夹着一张表:
                     ┌─────────── 每周运行,约 500 次请求 ───────────┐
  主题集群       ──▶ POOL   每个集群搜一次,per_page=100
                     │       └─▶ 每个集群存 100 行照片
                     └──────────────────┬───────────────────────────────┘
                                        ▼
                              image_pool 表
                        (cluster, photo_id, urls, blur_hash,
                         alt, credit, used_by_page, used_at)
                                        │
                     ┌──────────────────┴──── 每次发布运行,0 次请求 ───┐
  文章       ─────────▶ ASSIGN  为该集群挑出最佳未使用行,
                     │        标记为已用,渲染
                     └────────────────────────────────────────────────────────┘
这带来的好处,按在规模化场景中的重要性排序:
- 发布永远不会被 API 阻塞。分配就是一次数据库读取。你的 CMS 保存钩子、静态构建和凌晨三点的批量导入都以本地速度离线运行,路径上任何位置都没有速率限制。
- 去重免费且精确。
used_by_page IS NULL就是整个功能。两个页面不可能取到同一张照片,因为分配是一个事务,而不是一种排序启发式。 - 重跑代价低且幂等。当某个集群的池快用完,或者你想要更新的摄影作品时刷新它(
after_date,或sort_by=newest)——一次请求,已发布的内容一动不动。 - 多语言不额外花钱。一篇文章的 20 个译文在你的模型里是一个页面的 20 种渲染;它们共享分配到的
photo_id,你从不搜两次。当你确实想要本地拍摄的观感时,用目标语言为该集群跑一次池化查询——引擎支持 100 多种语言的句子输入。
worker 的代码实现
大约六十行。填池那部分是唯一与网络通信的部分,所以也是唯一需要小心的部分——并发受限、尊重 429、结果在一个事务里写入。
import asyncio, os, time, httpx

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
KEY    = os.environ["PEXAFY_API_KEY"]
FIELDS = "photo_id,urls,width,height,blur_hash,alt_description,attribution"

# Free = 20 req/min,保持低一档。节流器是全局的:把 sleep 放在
# 并发闸门内部会让 N 个 worker 以 N 倍速率发请求。
PER_MIN = 19
gate    = asyncio.Semaphore(4)         # 在途连接数
_lock   = asyncio.Lock()
_slot   = 0.0                          # 共享时间轴上下一个空闲时刻

async def pace():
    """全局范围内,每 60/PER_MIN 秒发放一个请求名额。"""
    global _slot
    async with _lock:
        now  = time.monotonic()
        _slot = max(now, _slot) + 60 / PER_MIN
        wait  = _slot - now
    if wait > 0:
        await asyncio.sleep(wait)

class QuotaExhausted(Exception): ...   # 月度配额:重试无济于事

async def fill_pool(client, cluster) -> list[dict]:
    """一次请求 → 为一个主题集群取回最多 100 张带署名照片。"""
    for attempt in range(4):
        await pace()
        async with gate:
            r = await client.get(
                SEARCH,
                headers={"X-Api-Key": KEY},
                params={
                    "q": cluster["camera_brief"],   # 一个场景,不是关键词
                    "per_page": 100,
                    "orientation": "landscape",
                    "score_threshold": 0.5,
                    "fields": FIELDS,
                },
                timeout=15,
            )
        if r.status_code == 429:
            retry_after = r.headers.get("Retry-After")
            if retry_after is None:            # 无 Retry-After ⇒ 月度配额,
                raise QuotaExhausted(cluster["id"])   # 停止整轮运行
            await asyncio.sleep(int(retry_after))   # 每分钟限流:会恢复
            continue
        r.raise_for_status()
        return r.json()["data"]
    return []                                  # 记录日志;池保留旧数据行

async def refill(clusters):
    async with httpx.AsyncClient(http2=True) as client:
        pools = await asyncio.gather(*(fill_pool(client, c) for c in clusters))
    for cluster, photos in zip(clusters, pools):
        db.upsert_pool(cluster["id"], photos)     # photo_id 上 ON CONFLICT DO NOTHING
其中两个细节,决定了这个 worker 是能无人值守运行,还是半夜把你叫醒。节流器是全局的,不是按任务的:把 sleep 放在并发闸门内部是经典错误——四个 worker 各自在自己的请求后暂停 3 秒,就会每 3 秒产生四次请求,大约每分钟 75 次,免费套餐会立刻开始返回 429。而且两种 429 不是一回事:每分钟那种带 Retry-After 且会自行恢复,月度配额那种不带、也永远不会带——对它重试就是撞墙循环。
分配,也就是每次发布都会运行的那部分,从不接触网络:
# 唯一性由表结构强制,而不是靠查询写得小心。
# 一张照片可以出现在多个集群池中;但只能被发布一次。
# CREATE UNIQUE INDEX one_use_per_photo ON image_pool (photo_id)
#        WHERE used_by_page IS NOT NULL;

def assign_hero(page_id: str, cluster_id: str) -> dict | None:
    for _ in range(5):                # 竞争失败就取下一张照片
        try:
            return db.query_one("""
                UPDATE image_pool p SET used_by_page = %s, used_at = NOW()
                WHERE p.id = (
                    SELECT c.id FROM image_pool c
                    WHERE c.cluster_id = %s AND c.used_by_page IS NULL
                      AND NOT EXISTS (              -- 被任何其他集群用过?
                          SELECT 1 FROM image_pool u
                          WHERE u.photo_id = c.photo_id
                            AND u.used_by_page IS NOT NULL
                      )
                    ORDER BY c.rank ASC
                    LIMIT 1 FOR UPDATE SKIP LOCKED  -- 并行 worker 下安全
                )
                RETURNING photo_id, urls, width, height, blur_hash, alt, credit
            """, [page_id, cluster_id])
        except UniqueViolation:      # 两个集群在同一毫秒内争抢
            continue
    return None                     # 池已空 → 放宽简报,重新填充

# 渲染:每个属性都来自数据行——没有布局偏移,不用猜。
# <img src="{urls[regular]}" width="{width}" height="{height}"
#      alt="{alt}" loading="lazy" style="background:{blur_placeholder}">
# <figcaption>{credit}</figcaption>
两种失败模式,两种机制,两者都必要。FOR UPDATE SKIP LOCKED 处理集群内部的并发:并行生成页面——在这个量级你一定会——两个 worker 会在同一毫秒去抢排名最高的同一张照片。
部分唯一索引处理的是人人都会忘的那种情况:同一张照片理所当然地出现在多个集群的池里,因为相邻集群(“租客的房屋保险”“……房东的”)返回的结果彼此重叠。按集群做的
used_by_page IS NULL 检查对此视而不见——每个集群都以为这张照片是空闲的。NOT EXISTS 让查询保持诚实,而索引让它在并发下不可能出错:竞争失败者会收到冲突、重试、取下一张照片。没有它,“没有两个页面共用主图”只是一种说法,不是保证。
当池在构建中途用尽时,表现最好的兜底策略是放宽而不是重复:去掉相机简报的最后一个从句,重新跑一次池化查询,然后才复用分配时间最早的那张照片——并且硬性规定它绝不落在同一集群的页面上。
一个集群,一个池:一次真实查询
以一个比价站群为例:房屋保险,二十个页面——“租客的房屋保险”“……房东的”“保单实际保什么”、十二个城市页、三份理赔指南。集群一份相机简报,一次请求,下面是池的头部,返回耗时 122 ms:
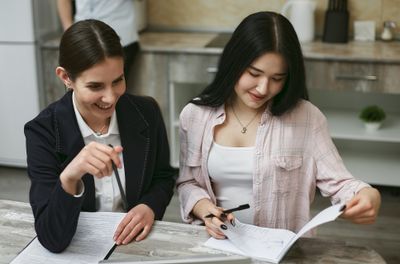
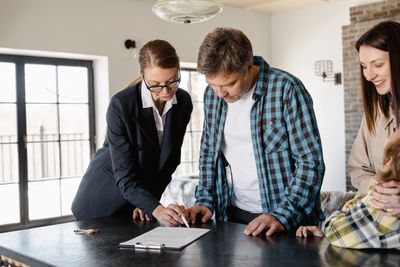
per_page=100,其余的都留着。
运行这次搜索 →
简报比代码更重要。有两条规则能经受真实站群的检验:为集群写简报,而不是为页面写(程序化页面集里标题几乎相同,所以按页写简报会返回几乎相同的照片),以及描述一个相机可能拍到的场景,而不是主题——home insurance 只会返回文件特写,别无其他。我们在
关于为每篇文章配图的那篇文章 中发布了可直接复制粘贴、用来生成这些简报的提示词。
让一个 200 页的系列保持视觉一致
重复的反面是不连贯:一个集群里的二十个页面,每张照片技术上都正确,却分属二十种不同的视觉风格。解决办法是一个端点——
GET /photos/{id}/similar——在你为支柱页面确认的那张照片上跑一次:
当品牌一致性是硬性要求时,还有两个值得接入池化查询的杠杆:
color_hex 配合 color_tolerance 能让整个站群保持在同一个色板内,而
photographer 能把一个集群锁定到某位摄影师的作品上。两者都是普通查询参数——搜索过滤器没有套餐限制。
速率限制、配额和实际成本
按峰值选套餐,而不是按用量。一旦池化,月度配额对几乎所有人都不再是约束;决定你套餐的是一次完整刷新必须多快跑完。
| 套餐 | 请求数 / 月= 可刷新的集群数 | 速率限制 | API 密钥 | 刷新 1,000 个集群实际耗时,跑一遍 |
|---|---|---|---|---|
| Free — $0 | 5,000 | 20 / min | 1 | 50 min |
| Starter — $5 | 25,000 | 30 / min | 3 | 34 min |
| Pro — $19 | 100,000 | 60 / min | 5 | 17 min |
| Team — $99代理商:每客户一个密钥 | 500,000 | 200 / min | 25 | 5 min |
| Business — $249 | 1,000,000 | 300 / min | unlimited | 4 min |
| Enterprise — $599 | 2,000,000 | 500 / min | unlimited | 2 min |
把第一列读作集群数:一次池化请求填满一个集群,所以月度配额就是你能刷新的集群数量,最后一列则是在该套餐速率限制下,对一个 1,000 集群的站群完整跑一遍需要多久。两者都是价格目录中的实时数值——定价页给出的是相同的速率限制,只是按小时而非按分钟表述。
所以一个每月 10,000 页的站群,采用池化模式只花约 500 次请求,付费为零。让团队往表格上方走的很少是用量——通常是三件事之一:在一夜之间把现有站群整体重新配图、按客户隔离密钥(代理商希望每个客户一个密钥,这样用量可归属,而不必玩共享密钥的把戏),或者构建窗口以分钟而非小时计。
还有两个能省下一整晚调试的运维细节。每个响应都带
X-RateLimit-Limit 和 X-RateLimit-Remaining,所以 worker 可以自行节流而不是靠猜。而真正属于每分钟速率限制的 429 会带
Retry-After,月度配额封禁则刻意不带——重试并不会解除后者,能区分两者的 worker 会停止敲打一个已经无货可给的端点。
当发布由 agent 完成时
如果你的内容由 agent 生产——在这些量级上越来越如此——池化层不会消失,它只是挪了位置。把搜索工具交给 agent,它就会在还持有集群简报上下文时把池填好,使用位于 mcp.pexafy.com/mcp 的
Model Context Protocol 服务器:三个工具,
search_photos(一个句子)、search_photos_by_image(一张参考图,可选再加一个句子)和 get_similar_photos(上文提到的系列一致性工具)。
# Claude Code / CI runner
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# 或者提交 .mcp.json,让机群里的每个 worker 都继承它
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
在规模化场景中奏效的指令是批量指令,而不是按篇的指令——而且它与上面两个阶段一一对应:
You  这是内容日历里的 12 个主题集群。为每个集群写一份相机简报,
     拉取 100 张横构图照片,并把池写入 Postgres。标记出任何在
     0.5 以上结果少于 40 条的集群——那些简报需要重写。

Agent  → search_photos(q="a woman signing paperwork with an insurance
           agent at a kitchen table in her home", orientation="landscape")
      ← 100 张照片 · 122 ms · 87 张高于阈值
      … 还有 11 个集群 …

      ✓ 已写入 11 个池(1,043 张照片,全部带署名)
      ⚠ “index fund rebalancing” → 12 条结果。简报过于抽象;
        建议改为:"a person at a kitchen table checking figures on a
        laptop with a notebook and coffee beside them"
最后那行正是把 agent 而不是脚本放进这个环节的理由:程序化配图的失败模式是糟糕的简报,而糟糕的简报恰恰是语言模型能够察觉并重写的东西。脚本继续负责分配,那里确定性重要,创造力不重要。
照片解决不了什么
一节诚实的内容,因为它描述的失败代价高昂。真实、带署名的摄影能提升一个页面。它不会把内容单薄的页面变成好内容,也没有任何图片流水线能改变搜索引擎对那些为了排名而非为了帮助读者而批量生产的页面的处理方式。Google 的垃圾内容政策直接点名了这一点:规模化内容滥用涵盖生成大量低价值页面,无论是否涉及自动化,而这些页面上的配图与该判断无关。2
所以有用的定位是狭窄而真实的:摄影是你能掌控的质量信号,作用在那些本来就应该存在的页面上。它明显有回报的地方:
- 读者可以核实的出处。带有摄影师姓名和来源 URL 的署名行是一个可被核查的声明——与一个作者匿名的页面上放一张无署名图片正好相反。
- 可访问性与 Core Web Vitals。响应中的
width/height消除布局偏移,blur_hash提供真正的占位图,而alt_description是一份 alt 文本草稿,你的模板可以在其基础上改进而不必凭空编写。乘以 40,000 个图片位,这就是整个站点的图片质量故事。 - 看起来不像批量生产。去重和系列一致性正是让站群不带上视觉签名的东西。这是有真实后果的真实感知成本,而且完全由你掌控。
另外,许可仍然约束着图片本身。Pexafy API 条款不要求署名——每条结果都附带可直接渲染的
attribution.html 和 attribution.plain——但原始图库附加的许可适用于你对该照片的使用,而在每月 40,000 张图片的量级上,自动渲染署名比事后审计便宜。
周一从哪里开始
- 把待处理内容分组成集群,每组 15–30 个页面,且合理地可以共用一次拍摄。这是唯一真正需要手工的步骤,而且它是一张电子表格,不是一个项目。
- 每个集群写一份相机简报——一个场景,12 到 25 个词。用模型生成,然后自己读一遍;用主题而非场景写的简报一眼就能看出来。
- 用一次
per_page=100请求填一个池,并粗看一下它的头部。如果前十条不可用,那是简报有问题——不是引擎。 - 在发布任何内容之前加上
used_by_page列。现在是五分钟的事,以后就是对 3,000 个线上页面做迁移。 - 整套方案先跑在免费套餐上,直到构建窗口逼你升级。按每月 500 次请求算,那还得跑一阵子。
参考资料与脚注
1 欧盟《人工智能法案》第 50 条——自 2026 年 8 月 2 日起适用的透明度义务:生成合成图像、音频、视频或文本的系统提供者必须以机器可读格式标记输出,并使其可被检测为人工生成。它约束的是 AI 提供者和部署者;它不是一条关于网站可以发布哪些图片的规则。
2 Google 搜索垃圾内容政策——规模化内容滥用:主要为操纵排名而生成大量页面、对用户价值很低,无论是通过自动化、人工还是两者结合创建。配图质量不是该评估中的因素,这也正是本文把两者分开讨论的原因。
资料核对于 2026 年 8 月 17 日: Google Search spam policies · AI Act Article 50 · Pexafy API & MCP docs。 套餐限额是 Pexafy 定价表中的实时数值;搜索耗时 (122 ms、48 ms)以及展示的每张照片都是当天捕获的真实 API 响应。
常见问题
如何为成千上万个程序化 SEO 页面获取图片?
per_page=100 的 GET /api/v1/search/photos 请求可为一个主题簇返回多达 100 张带署名的照片;你把它们存进图片池表,在发布时为每个页面分配一张。一个每月 10,000 个页面、每页四张图的站点大约只需 500 次请求,而不是 40,000 次,完全在免费套餐(每月 5,000 次请求)范围内。大批量内容生产最适合用哪个图库 API?
如何避免同一张图库照片出现在多个页面上?
photo_id,并以事务方式从池中领取照片——在 SQL 中即 UPDATE … WHERE used_by_page IS NULL … FOR UPDATE SKIP LOCKED。这样去重就是精确的而非概率性的,并行构建的 worker 也不会争抢同一张排名最高的照片。这只是一个字段,而在成千上万个已上线页面上事后补加,代价远高于第一天就加上。一次 API 请求最多能返回多少张照片?
per_page=100 实现;游标分页让你能继续遍历同一个排序结果集,构建更深的图片池。可结合 score_threshold,让内容较少的主题簇返回 40 张高匹配度的照片,而不是 100 张勉强相关的;再配合 fields 只返回模板真正渲染的字段,在大批量场景下保持响应体积小巧。真实照片能让规模化生产的页面排名更好吗?
AI 智能体能自动填充图片池吗?
mcp.pexafy.com/mcp,它提供 search_photos、search_photos_by_image 和 photo_similar。给智能体一份主题簇清单,它会为每个簇写一份拍摄需求说明,拉取图片池,并标记出高匹配结果过少的说明——这正是程序化配图真正的失败模式。分配逻辑仍留在你的脚本中,因为在那里确定性比创意更重要。

