Minh Họa 10.000 Trang Mỗi Tháng Bằng Ảnh Thật — Chỉ Với 500 Lượt Gọi API
Tìm kiếm một lần cho mỗi cụm chủ đề thay vì mỗi ảnh, và 40.000 lượt gọi API trở thành 500. Mô hình gộp-và-gán, worker sống sót qua giới hạn tốc độ, và một phần thẳng thắn về những gì ảnh chụp không thể khắc phục.
 Marouane Tijani
12 phút đọc

Có một phiên bản của bài toán minh họa nội dung mà không lượng gu thẩm mỹ nào giải quyết được: bạn không chọn một tấm ảnh, bạn đang lấp đầy 40.000 vị trí ảnh mỗi tháng trên 800 cụm chủ đề, 9 ngôn ngữ và 14 site khách hàng, và mỗi vị trí đều cần được cấp phép, ghi công, chỉnh kích thước và khác với vị trí bên cạnh. Ở quy mô đó câu hỏi không còn là “ảnh nào?” nữa, mà là “kiến trúc là gì?”
Bài viết này là câu trả lời ở tầng API: mẫu request giúp giảm số lượng gọi API đi hai bậc độ lớn, worker sống sót qua giới hạn tốc độ, cơ chế loại bỏ trùng lặp giúp một site 10.000 trang không trông giống như một bức tường toàn cùng một ảnh stock — và một phần trung thực về những gì hình ảnh không thể làm được cho bạn.
Nút thắt cổ chai thật sự ở quy mô 10.000 bài viết
Các đội xuất bản ở quy mô lớn — hệ sinh thái SEO lập trình, trang danh mục marketplace, các trang tổng hợp, mạng lưới affiliate, agency vận hành nội dung cho một danh mục khách hàng, pipeline bản địa hóa biến một bài viết thành 20 phiên bản — tất cả đều va phải cùng ba bức tường, theo cùng một thứ tự:
- Số lượng lệnh gọi. Tìm kiếm một lần cho mỗi vị trí ảnh nghĩa là 40.000 lệnh gọi API cho 10.000 bài viết bốn ảnh. Mọi nhà cung cấp đều tính giá, giới hạn và xét duyệt bạn dựa trên con số đó.
- Sự lặp lại. Đến khoảng trang thứ ba mươi, cùng một tấm ảnh bắt đầu xuất hiện lại. Đến trang thứ ba nghìn, site của bạn có một dấu ấn thị giác: được tạo hàng loạt.
- Sự phối hợp. Một trăm bài viết trong một cụm chủ đề nên trông như một chuỗi, không phải một trăm bảng Pinterest không liên quan — và bản dịch ngôn ngữ tiếp theo của cùng bài viết đó nên tái sử dụng cùng một tấm ảnh, chứ không tìm kiếm lại bằng một ngôn ngữ khác.
Hãy để ý điều không có trong danh sách đó: tìm một tấm ảnh đẹp. Một công cụ ngữ nghĩa trả về một trang các ứng viên khả dụng trong khoảng 130 mili giây. Việc truy xuất đã được giải quyết; việc phân phối thì chưa. Mọi thứ dưới đây nói về phân phối.
Vì sao dùng ảnh thật, đặc biệt ở quy mô này
Lý lẽ ủng hộ ảnh chụp so với ảnh tạo sinh mạnh hơn khi quy mô tăng lên, vì những lý do chủ yếu mang tính vận hành hơn là thẩm mỹ.
| Ở mức 40.000 ảnh/tháng | Tạo sinh chúng | Tìm kiếm chúng |
|---|---|---|
| Thời gian mỗi ảnh | Vài giây đến vài phút, cộng thêm các lần thử bị loại bỏ | Một request (~130 ms) bao phủ cả một cụm chủ đề |
| Yếu tố chi phí | Theo từng ảnh, mãi mãi | Theo từng request — và một request phục vụ ~25 bài viết |
| Metadata bạn nhận được | Không có gì. Bạn tự viết alt text và kích thước | Kích thước, màu chủ đạo, blur hash, bản nháp caption, dòng ghi công |
| Nguồn gốc | Được đánh dấu bởi máy là tổng hợp theo Đạo luật AI của EU kể từ ngày 2 tháng 8 năm 20261 | Một nhiếp ảnh gia có tên, một ngày tháng, một URL nguồn mà độc giả có thể mở |
| Kiểu thất bại | Chi tiết nghe hợp lý nhưng sai, phong cách đồng nhất | Không có gì khớp với yêu cầu — bạn nhận về không kết quả, và có thể xử lý điều đó |
Dòng metadata là dòng quyết định pipeline. Mọi kết quả tìm kiếm đã sẵn mang theo
width, height, blur_hash, color_hex,
alt_description và một chuỗi attribution.html dựng sẵn — đó chính là
payload mà một templating engine cần để tạo ra một <img> không gây layout shift,
có placeholder và có ghi công. Ảnh tạo sinh chỉ cho bạn một tệp và
để lại sáu trường còn lại cho bạn tự phát minh.
Nơi ảnh tạo sinh vẫn thắng ở quy mô lớn. Minh họa cấp danh mục cho các nhóm phân loại trừu tượng (“chuyển đổi lên cloud”, “quỹ chỉ số”), sơ đồ, và một phong cách thương hiệu bạn muốn lặp lại xuyên suốt cả hệ sinh thái vì lý do thương hiệu. Ranh giới mà hầu hết các nhà xuất bản lớn chọn: ảnh chụp cho bất cứ thứ gì tồn tại trong thế giới thực, nghệ thuật tạo sinh cho bất cứ thứ gì chỉ tồn tại trong một lập luận. Chúng tôi đã trình bày đầy đủ lý lẽ cho ranh giới đó trong cách minh họa mọi bài viết bạn xuất bản.
Một request, một trăm ảnh
Đây là thay đổi duy nhất định hình lại phép tính. Endpoint tìm kiếm nhận per_page
lên đến 100, và phân trang bằng cursor cho phép bạn tiếp tục duyệt qua
cùng một tập kết quả đã xếp hạng. Vậy nên đơn vị công việc không phải là một tấm ảnh, mà là một pool.
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a woman signing paperwork with an insurance agent at a kitchen table in her home" \
  --data-urlencode "per_page=100" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "score_threshold=0.5" \
  --data-urlencode "fields=photo_id,urls,width,height,blur_hash,alt_description,attribution"

# → { "success": true, "data": [ …tối đa 100 ảnh… ],
#     "pagination": { "per_page": 100, "has_more": true, "next_cursor": "eyJyc…" },
#     "meta": { "took_ms": 122.33, "request_id": "7ff1fb9b-…" } }
Ba tham số ở đó đang âm thầm làm việc ở quy mô lớn:
fields— một sparse fieldset. Chỉ yêu cầu bảy trường mà template của bạn render và phản hồi sẽ không còn gửi kèm phần mô tả AI dài dòng cho mỗi ảnh. Trên 40.000 ảnh đó là sự khác biệt giữa một bản build chạy trôi chảy và một bản build bị chậm nghẽn.score_threshold— phần đuôi của một trang 100 kết quả, theo định nghĩa, kém liên quan hơn phần đầu. Đặt một ngưỡng sàn nghĩa là một cụm chủ đề mỏng trả về 34 ảnh thay vì 100 ảnh tầm thường, và pipeline của bạn có thể phản ứng với điều đó thay vì xuất bản nó.next_cursor— khi một cụm chủ đề thực sự cần 300 ảnh, hãy phân trang trên cùng một tập đã xếp hạng thay vì gửi ba truy vấn khác nhau chồng lấn lên nhau.
Và đây là phép tính, cho một site xuất bản 10.000 trang mỗi tháng với bốn ảnh mỗi trang:
| Chiến lược | Request / tháng | Một lượt chạy ở giới hạn tốc độ gói free20 req/phút | Có vừa hạn mức tháng của gói free không? |
|---|---|---|---|
| Tìm kiếm một lần cho mỗi vị trí ảnh | 40.000 | 33 hours | Không — cần gói trả phí |
| Tìm kiếm một lần cho mỗi bài viết | 10.000 | 8 hours | Không — cần gói trả phí |
| Tìm kiếm một lần cho mỗi cụm ~20 bài viếtmẫu hình trong bài viết này | 500 | 25 minutes | Có |
Vẫn là 40.000 ảnh xuất bản trong cả ba dòng. Thứ duy nhất thay đổi là vòng lặp nằm ở đâu.
Pool và assign: mẫu hình mở rộng được
Toàn bộ kiến trúc là hai giai đoạn chạy ở các tần suất khác nhau, với một bảng ở giữa chúng:
                     ┌─────────── chạy hàng tuần, ~500 request ─────────┐
  cụm chủ đề ──▶ POOL   tìm kiếm một lần cho mỗi cụm, per_page=100
                     │       └─▶ lưu 100 dòng ảnh cho mỗi cụm
                     └──────────────────┬───────────────────────────────┘
                                        ▼
                              bảng image_pool
                        (cluster, photo_id, urls, blur_hash,
                         alt, credit, used_by_page, used_at)
                                        │
                     ┌──────────────────┴──── chạy mỗi lần xuất bản, 0 request ───┐
  bài viết ─────────▶ ASSIGN  chọn dòng chưa dùng tốt nhất cho
                     │        cụm này, đánh dấu đã dùng, render
                     └────────────────────────────────────────────────────────┘
Những gì cách làm này mang lại, theo thứ tự mức độ quan trọng ở quy mô lớn:
- Việc xuất bản không bao giờ bị chặn bởi API. Việc phân bổ là một lượt đọc cơ sở dữ liệu. Hook lưu của CMS, bản build tĩnh và tác vụ import hàng loạt lúc 3 giờ sáng của bạn đều chạy ở tốc độ cục bộ, ngoại tuyến, không có giới hạn tốc độ nào trên đường đi.
- Loại bỏ trùng lặp là miễn phí và chính xác.
used_by_page IS NULLlà toàn bộ tính năng. Hai trang không thể lấy cùng một tấm ảnh, vì việc phân bổ là một transaction, không phải một heuristic xếp hạng. - Chạy lại thì rẻ và mang tính idempotent. Làm mới pool của một cụm khi pool sắp cạn
hoặc khi bạn muốn ảnh mới hơn (
after_date, hoặcsort_by=newest) — một request, và không có gì đã xuất bản bị dịch chuyển. - Ngôn ngữ đi kèm miễn phí. 20 bản dịch của một bài viết là một trang trong
mô hình của bạn với 20 lần render; chúng dùng chung
photo_idđã gán và bạn không bao giờ tìm kiếm hai lần. Khi bạn thực sự muốn một phong cách ảnh chụp bản địa, hãy chạy truy vấn pool cho cụm đó bằng ngôn ngữ đích — công cụ nhận một câu bằng hơn 100 ngôn ngữ.
Worker, dưới dạng code
Khoảng sáu mươi dòng. Phần điền pool là phần duy nhất giao tiếp với mạng, nên đó là
phần duy nhất cần cẩn thận — giới hạn số lượng đồng thời, tôn trọng 429, kết quả
được ghi trong một transaction.
import asyncio, os, time, httpx

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
KEY    = os.environ["PEXAFY_API_KEY"]
FIELDS = "photo_id,urls,width,height,blur_hash,alt_description,attribution"

# Free = 20 req/phút. Giữ dưới một chút. Bộ điều tốc là TOÀN CỤC: một sleep theo từng task
# bên trong cổng đồng thời sẽ cho phép N worker bắn ra N× tốc độ.
PER_MIN = 19
gate    = asyncio.Semaphore(4)         # số kết nối đang chạy
_lock   = asyncio.Lock()
_slot   = 0.0                          # thời điểm rảnh tiếp theo trên trục thời gian chung

async def pace():
    """Cấp một slot request mỗi 60/PER_MIN giây, cho toàn bộ fleet."""
    global _slot
    async with _lock:
        now  = time.monotonic()
        _slot = max(now, _slot) + 60 / PER_MIN
        wait  = _slot - now
    if wait > 0:
        await asyncio.sleep(wait)

class QuotaExhausted(Exception): ...   # theo tháng: thử lại không giúp được gì

async def fill_pool(client, cluster) -> list[dict]:
    """Một request → tối đa 100 ảnh có bản quyền cho một cụm chủ đề."""
    for attempt in range(4):
        await pace()
        async with gate:
            r = await client.get(
                SEARCH,
                headers={"X-Api-Key": KEY},
                params={
                    "q": cluster["camera_brief"],   # một cảnh, không phải từ khóa
                    "per_page": 100,
                    "orientation": "landscape",
                    "score_threshold": 0.5,
                    "fields": FIELDS,
                },
                timeout=15,
            )
        if r.status_code == 429:
            retry_after = r.headers.get("Retry-After")
            if retry_after is None:            # không có Retry-After ⇒ hết hạn mức tháng,
                raise QuotaExhausted(cluster["id"])   # dừng toàn bộ lượt chạy
            await asyncio.sleep(int(retry_after))   # theo phút: sẽ tự hết
            continue
        r.raise_for_status()
        return r.json()["data"]
    return []                                  # ghi log; pool giữ nguyên dữ liệu cũ

async def refill(clusters):
    async with httpx.AsyncClient(http2=True) as client:
        pools = await asyncio.gather(*(fill_pool(client, c) for c in clusters))
    for cluster, photos in zip(clusters, pools):
        db.upsert_pool(cluster["id"], photos)     # ON CONFLICT DO NOTHING trên photo_id
Hai chi tiết ở đó là sự khác biệt giữa một worker chạy không cần giám sát và một worker
làm bạn phải thức dậy giữa đêm. Bộ điều tốc là toàn cục, không phải theo từng task:
đặt sleep bên trong cổng đồng thời là sai lầm kinh điển — bốn worker mỗi cái tạm dừng 3 giây sau
request riêng của nó tạo ra bốn request mỗi 3 giây, khoảng 75 lần mỗi phút, và gói free
bắt đầu trả về 429 ngay lập tức. Và hai loại 429 không phải cùng một
con thú: loại theo phút mang theo Retry-After và tự hết, loại hết-hạn-mức-tháng
thì không mang theo và sẽ không bao giờ có — thử lại loại đó là một vòng lặp đâm vào tường.
Phần assign, phần chạy ở mỗi lần xuất bản, không bao giờ chạm vào mạng:
# Tính duy nhất được thực thi bởi schema, không phải bởi truy vấn cẩn thận.
# Một tấm ảnh có thể nằm trong nhiều pool của các cụm khác nhau; nó chỉ được XUẤT BẢN một lần.
# CREATE UNIQUE INDEX one_use_per_photo ON image_pool (photo_id)
#        WHERE used_by_page IS NOT NULL;

def assign_hero(page_id: str, cluster_id: str) -> dict | None:
    for _ in range(5):                # thua trong một race chỉ đơn giản là lấy ảnh tiếp theo
        try:
            return db.query_one("""
                UPDATE image_pool p SET used_by_page = %s, used_at = NOW()
                WHERE p.id = (
                    SELECT c.id FROM image_pool c
                    WHERE c.cluster_id = %s AND c.used_by_page IS NULL
                      AND NOT EXISTS (              -- được cụm khác dùng chưa?
                          SELECT 1 FROM image_pool u
                          WHERE u.photo_id = c.photo_id
                            AND u.used_by_page IS NOT NULL
                      )
                    ORDER BY c.rank ASC
                    LIMIT 1 FOR UPDATE SKIP LOCKED  -- an toàn với worker chạy song song
                )
                RETURNING photo_id, urls, width, height, blur_hash, alt, credit
            """, [page_id, cluster_id])
        except UniqueViolation:      # hai cụm giành nó trong cùng một mili giây
            continue
    return None                     # pool cạn → mở rộng brief, làm mới lại

# Render: mọi thuộc tính đến từ dòng dữ liệu — không layout shift, không đoán mò.
# <img src="{urls[regular]}" width="{width}" height="{height}"
#      alt="{alt}" loading="lazy" style="background:{blur_placeholder}">
# <figcaption>{credit}</figcaption>
Hai kiểu thất bại, hai cơ chế, và cả hai đều cần thiết. FOR UPDATE SKIP LOCKED
xử lý tính đồng thời bên trong một cụm: tạo trang song song — và ở quy mô này
bạn sẽ làm vậy — và hai worker cùng vươn tới cùng một ảnh xếp hạng cao nhất trong cùng mili giây.
Partial unique index xử lý điều mà mọi người luôn quên: cùng một tấm ảnh xuất hiện hợp lệ
trong pool của nhiều cụm, vì các cụm lân cận (“bảo hiểm nhà cho người thuê”, “…cho chủ nhà cho thuê”)
trả về các kết quả chồng lấn. Một kiểm tra used_by_page IS NULL theo từng cụm
không nhìn thấy điều đó — mỗi cụm tin rằng tấm ảnh vẫn còn trống. NOT EXISTS
giữ cho truy vấn trung thực, và index khiến việc bị sai không thể xảy ra dưới điều kiện đồng thời: kẻ thua trong
race sẽ gặp violation, thử lại, và lấy ảnh tiếp theo. Không có nó, “không có hai trang nào chia sẻ ảnh chính”
chỉ là một lời tuyên bố, không phải một sự đảm bảo.
Khi một pool cạn giữa lúc build, cơ chế dự phòng hoạt động tốt nhất là mở rộng thay vì lặp lại: bỏ mệnh đề cuối của camera brief, chạy lại truy vấn pool một lần, và chỉ khi đó mới tái sử dụng ảnh đã gán lâu nhất — với một quy tắc cứng rằng nó không bao giờ xuất hiện trên một trang trong cùng cụm.
Một cụm, một pool: một truy vấn thực tế
Hãy lấy một hệ sinh thái so sánh: bảo hiểm nhà, hai mươi trang — “bảo hiểm nhà cho người thuê”, “…cho chủ nhà cho thuê”, “một hợp đồng bảo hiểm thực sự bao gồm những gì”, mười hai trang theo thành phố, ba hướng dẫn bồi thường. Một camera brief cho cả cụm, một request, và đây là phần đầu của pool, trả về trong 122 ms:
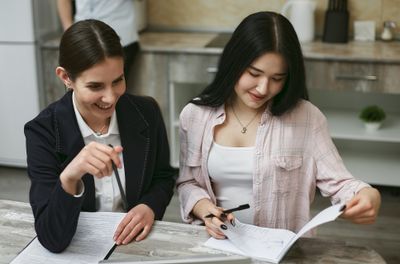
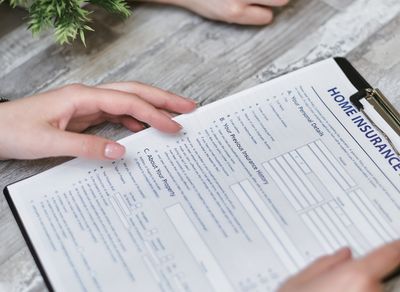
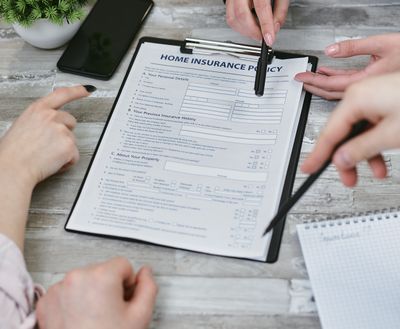
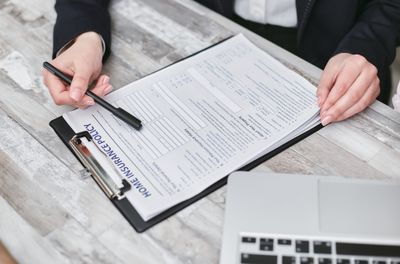
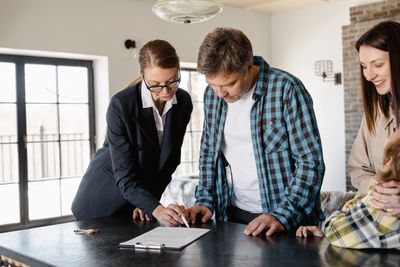
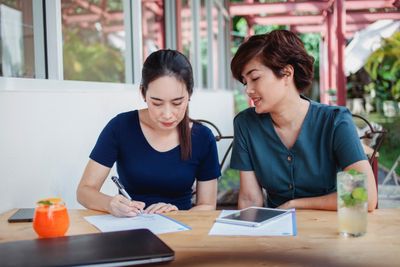
per_page=100 và giữ lại phần còn lại.
Chạy chính xác truy vấn này →
Các brief quan trọng hơn code. Hai quy tắc còn tồn tại sau khi va chạm với một hệ sinh thái cụm chủ đề thực tế:
viết brief cho cụm chủ đề, không phải cho từng trang (tiêu đề trang gần như giống hệt nhau
trong các tập lập trình, nên brief theo từng trang trả về ảnh gần như giống hệt nhau), và mô tả một cảnh
mà một máy ảnh có thể chụp được thay vì mô tả chủ đề — bảo hiểm nhà trả về ảnh cận cảnh
văn bản và không gì khác. Chúng tôi đã công bố prompt có thể copy-paste tạo ra các brief này trong
bài viết về minh họa mọi bài đăng.
Giữ tính nhất quán thị giác cho một chuỗi 200 trang
Thất bại đối lập với sự lặp lại là sự thiếu nhất quán: hai mươi trang trong một cụm, mỗi trang có một tấm
ảnh đúng về mặt kỹ thuật, nhưng ở hai mươi phong cách thị giác khác nhau. Cách khắc phục là một endpoint —
GET /photos/{id}/similar — chạy một lần trên tấm ảnh bạn đã duyệt cho trang trụ cột:
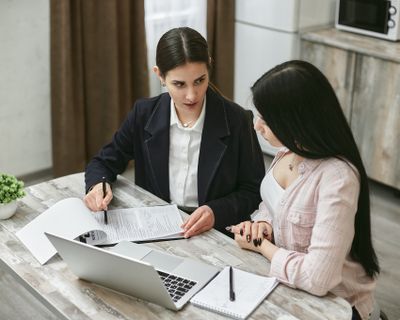
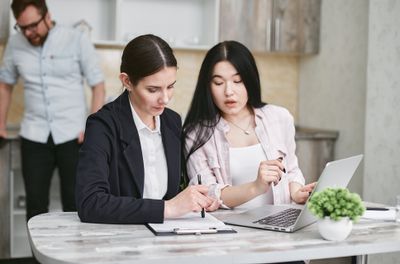
Còn hai đòn bẩy nữa đáng để tích hợp vào truy vấn pool khi tính nhất quán thương hiệu là một yêu cầu:
color_hex kèm một color_tolerance giữ cả một hệ sinh thái trong một
bảng màu, và photographer gắn một cụm với toàn bộ tác phẩm của một nhiếp ảnh gia. Cả hai
đều là các tham số truy vấn thông thường — không giới hạn theo gói với các bộ lọc tìm kiếm.
Giới hạn tốc độ, hạn mức và chi phí thực tế
Chọn gói dựa trên tốc độ burst, không dựa trên khối lượng. Một khi bạn đã gộp pool, hạn mức hàng tháng gần như không còn là ràng buộc với hầu hết mọi người nữa; điều quyết định gói của bạn là một lần làm mới toàn bộ cần hoàn thành nhanh đến mức nào.
| Gói | Request / tháng= số cụm có thể làm mới | Giới hạn tốc độ | Số API key | Làm mới 1.000 cụmthời gian thực tế, một lượt |
|---|---|---|---|---|
| Free — $0 | 5,000 | 20 / phút | 1 | 50 min |
| Starter — $5 | 25,000 | 30 / phút | 3 | 34 min |
| Pro — $19 | 100,000 | 60 / phút | 5 | 17 min |
| Team — $99agency: một key mỗi khách hàng | 500,000 | 200 / phút | 25 | 5 min |
| Business — $249 | 1,000,000 | 300 / phút | unlimited | 4 min |
| Enterprise — $599 | 2,000,000 | 500 / phút | unlimited | 2 min |
Hãy đọc cột đầu tiên như số cụm chủ đề: một request gộp nhóm điền đầy một cụm, nên hạn mức hàng tháng chính là số cụm bạn có thể làm mới, và cột cuối cùng là một lượt chạy toàn bộ trên một hệ sinh thái 1.000 cụm mất bao lâu ở giới hạn tốc độ của gói đó. Cả hai đều là giá trị thực tế từ bảng giá — trang giá công bố cùng các giới hạn tốc độ theo giờ thay vì theo phút.
Vậy nên một hệ sinh thái 10.000 trang/tháng theo mẫu hình gộp pool tiêu tốn ~500 request và trả không đồng nào. Điều đẩy các đội lên các gói cao hơn hiếm khi là khối lượng — đó thường là một trong ba điều: minh họa lại toàn bộ một hệ sinh thái có sẵn trong một đêm, cô lập key theo từng khách hàng (một agency muốn mỗi khách hàng một key để việc sử dụng có thể quy trách nhiệm mà không cần chia sẻ bí mật phức tạp), hoặc một cửa sổ build được đo bằng phút thay vì giờ.
Hai chi tiết vận hành giúp bạn tiết kiệm một đêm gỡ lỗi. Mọi phản hồi đều mang theo
X-RateLimit-Limit và X-RateLimit-Remaining, để một worker có thể tự
điều tiết thay vì phải đoán. Và một 429 thực sự là giới hạn tốc độ theo phút thì mang theo
Retry-After, trong khi một chặn do hạn mức tháng thì cố tình không — thử lại
sẽ không giải quyết được điều đó, và một worker phân biệt được hai loại này sẽ ngừng đập liên tục vào một endpoint
đã không còn gì để cho.
Khi agent thực hiện việc xuất bản
Nếu nội dung của bạn được tạo ra bởi một agent — và ở những quy mô này ngày càng phổ biến — lớp
gộp pool không biến mất, nó chỉ dịch chuyển vị trí. Hãy trao cho agent các công cụ tìm kiếm và nó sẽ điền đầy pool
trong khi vẫn giữ camera brief của cụm trong ngữ cảnh, sử dụng máy chủ
Model Context Protocol tại mcp.pexafy.com/mcp: ba công cụ,
search_photos (một câu), search_photos_by_image (một ảnh tham chiếu,
tùy chọn kèm một câu) và get_similar_photos (công cụ tạo tính nhất quán chuỗi ảnh nêu ở trên).
# Claude Code / CI runner
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# hoặc commit .mcp.json để mọi worker trong fleet đều kế thừa nó
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
Hướng dẫn hoạt động tốt ở quy mô lớn là một hướng dẫn theo lô, không phải theo từng bài viết — và nó ánh xạ một-một vào hai giai đoạn ở trên:
You  Đây là 12 cụm chủ đề từ lịch nội dung. Với mỗi cụm,
     hãy viết một camera brief, lấy về 100 ảnh landscape, và ghi
     pool xuống Postgres. Đánh dấu bất kỳ cụm nào trả về dưới 40
     kết quả trên ngưỡng 0.5 — các brief đó cần viết lại.

Agent  → search_photos(q="a woman signing paperwork with an insurance
           agent at a kitchen table in her home", orientation="landscape")
      ← 100 ảnh · 122 ms · 87 vượt ngưỡng
      … 11 cụm khác …

      ✓ 11 pool đã ghi (1.043 ảnh, tất cả đều có ghi công)
      ⚠ "cân bằng lại quỹ chỉ số" → 12 kết quả. Brief quá trừu tượng;
        đề xuất: "một người tại bàn bếp kiểm tra các con số trên một
        laptop với một cuốn sổ tay và cà phê bên cạnh"
Dòng cuối cùng đó là lý do để đưa agent vào vòng lặp này thay vì một script: kiểu thất bại của việc minh họa theo chương trình là một brief tồi, và một brief tồi chính xác là thứ mà một mô hình ngôn ngữ có thể nhận ra và viết lại. Các script vẫn phụ trách phần assign, nơi tính xác định quan trọng còn tính sáng tạo thì không.
Điều mà ảnh chụp không thể khắc phục
Một phần trung thực, vì kiểu thất bại nó mô tả tốn kém. Ảnh chụp thật, có ghi công cải thiện một trang. Nó không biến nội dung sơ sài thành nội dung tốt, và không pipeline hình ảnh nào thay đổi cách các công cụ tìm kiếm đối xử với các trang được sản xuất hàng loạt tồn tại để xếp hạng chứ không phải để giúp ích. Chính sách chống spam của Google nêu rõ điều này: lạm dụng nội dung quy mô lớn (scaled content abuse) bao gồm việc tạo ra nhiều trang với giá trị ít ỏi bất kể có sử dụng tự động hóa hay không, và các hình ảnh minh họa trên những trang đó không liên quan gì đến phán quyết đó.2
Vậy nên cách nhìn nhận hữu ích là hẹp và đúng: ảnh chụp là một tín hiệu chất lượng bạn kiểm soát trên những trang vốn đã xứng đáng tồn tại. Nơi nó thực sự đem lại lợi ích rõ ràng:
- Nguồn gốc mà độc giả có thể kiểm chứng. Một dòng ghi công với tên nhiếp ảnh gia và một URL nguồn là một tuyên bố có thể kiểm tra được — đối lập với một ảnh không rõ nguồn trên một trang có tác giả không rõ danh tính.
- Khả năng tiếp cận và Core Web Vitals.
width/heighttừ phản hồi loại bỏ layout shift,blur_hashtạo ra một placeholder thực sự, vàalt_descriptionlà một bản nháp alt text mà template của bạn có thể cải thiện thay vì tự bịa ra. Nhân với 40.000 vị trí và đây chính là toàn bộ câu chuyện chất lượng hình ảnh của cả site. - Không trông giống được sản xuất hàng loạt. Loại bỏ trùng lặp và tính nhất quán chuỗi ảnh chính là thứ ngăn một hệ sinh thái có một dấu ấn thị giác. Đó là một cái giá về mặt nhận thức có thật với hậu quả có thật, và nó hoàn toàn nằm trong tầm kiểm soát của bạn.
Và giấy phép vẫn chi phối tấm ảnh. Việc ghi công không bắt buộc theo điều khoản API của Pexafy —
mọi kết quả đều đi kèm attribution.html và attribution.plain sẵn sàng để
render — nhưng giấy phép gắn liền với thư viện gốc áp dụng cho việc sử dụng tấm ảnh đó của bạn, và
ở mức 40.000 ảnh mỗi tháng, việc tự động render dòng ghi công thì rẻ hơn nhiều so với việc kiểm tra lại về sau.
Nên bắt đầu từ đâu vào thứ Hai
- Nhóm backlog của bạn thành các cụm gồm 15–30 trang có thể hợp lý dùng chung một buổi chụp ảnh. Đây là bước duy nhất thực sự thủ công, và nó là một bảng tính, không phải một dự án.
- Viết một camera brief cho mỗi cụm — một cảnh, 12 đến 25 từ. Tạo chúng bằng một mô hình, sau đó đọc lại; các brief nêu tên chủ đề thay vì mô tả cảnh sẽ lộ ra ngay trong nháy mắt.
- Điền một pool bằng một request duy nhất
per_page=100và xem qua phần đầu của nó. Nếu mười ảnh đầu tiên không dùng được, brief sai — không phải công cụ. - Thêm cột
used_by_pagetrước khi bạn xuất bản bất cứ điều gì. Nó tốn năm phút bây giờ và một cuộc di trú qua 3.000 trang đang chạy sau này. - Chạy toàn bộ trên gói free cho đến khi một cửa sổ build buộc bạn phải nâng cấp. Ở 500 request mỗi tháng, sẽ mất một thời gian đấy.
Tài liệu tham khảo & chú thích
1 Đạo luật AI của EU, Điều 50 — nghĩa vụ minh bạch áp dụng kể từ ngày 2 tháng 8 năm 2026: các nhà cung cấp hệ thống tạo ra hình ảnh, âm thanh, video hoặc văn bản tổng hợp phải đánh dấu đầu ra ở định dạng có thể đọc bằng máy và khiến chúng có thể phát hiện được là được tạo ra một cách nhân tạo. Điều này ràng buộc các nhà cung cấp và triển khai AI; nó không phải một quy tắc về việc một website được phép xuất bản những hình ảnh nào.
2 Chính sách chống spam của Google Search — lạm dụng nội dung quy mô lớn: tạo ra nhiều trang chủ yếu để thao túng thứ hạng và mang lại ít giá trị cho người dùng, bất kể được tạo ra thông qua tự động hóa, công sức con người hay sự kết hợp của cả hai. Chất lượng minh họa không phải một yếu tố trong đánh giá đó, đó chính xác là lý do bài viết này tách biệt hai vấn đề đó.
Các nguồn được kiểm tra vào ngày 17 tháng 8 năm 2026: Chính sách chống spam của Google Search · Đạo luật AI, Điều 50 · Tài liệu API & MCP của Pexafy. Giới hạn của các gói là giá trị thực tế từ bảng giá của Pexafy; thời gian tìm kiếm (122 ms, 48 ms) và mọi tấm ảnh hiển thị đều là các phản hồi API thực tế được ghi lại trong cùng ngày.
Câu hỏi thường gặp
Làm sao để lấy ảnh cho hàng nghìn trang SEO lập trình?
GET /api/v1/search/photos duy nhất với per_page=100 trả về tối đa 100 ảnh có ghi công cho một cụm; bạn lưu chúng vào bảng pool và gán mỗi ảnh cho một trang tại thời điểm xuất bản. Một hệ thống 10.000 trang/tháng với bốn ảnh mỗi trang chỉ cần khoảng 500 yêu cầu thay vì 40.000, vừa đủ nằm trong gói miễn phí (5.000 yêu cầu/tháng).API ảnh stock nào tốt nhất cho sản xuất nội dung khối lượng lớn?
Làm sao để tránh cùng một ảnh stock xuất hiện trên nhiều trang?
photo_id của mọi ảnh bạn xuất bản và lấy ảnh từ pool theo giao dịch (transaction) — trong SQL, một câu lệnh UPDATE … WHERE used_by_page IS NULL … FOR UPDATE SKIP LOCKED. Việc khử trùng lặp khi đó trở nên chính xác thay vì mang tính xác suất, và các worker build song song không thể tranh giành cùng một ảnh xếp hạng cao nhất. Đây chỉ là một cột dữ liệu, và việc bổ sung sau này trên hàng nghìn trang đang hoạt động sẽ tốn kém hơn nhiều so với thêm ngay từ đầu.Một yêu cầu API có thể trả về bao nhiêu ảnh?
per_page=100, và phân trang kiểu con trỏ (cursor pagination) cho phép bạn tiếp tục duyệt cùng một tập kết quả đã xếp hạng để có pool sâu hơn. Kết hợp với score_threshold để một cụm ít dữ liệu trả về 40 kết quả khớp mạnh thay vì 100 kết quả khớp lỏng lẻo, và với fields để chỉ trả về các thuộc tính mà template của bạn hiển thị, giúp giữ phản hồi nhỏ gọn ở quy mô lớn.Ảnh thật có giúp các trang được sản xuất ở quy mô lớn xếp hạng tốt hơn không?
Một AI agent có thể tự động điền đầy pool ảnh không?
mcp.pexafy.com/mcp, cung cấp search_photos, search_photos_by_image và photo_similar. Đưa cho agent một danh sách các cụm chủ đề và nó sẽ viết một bản mô tả máy ảnh (camera brief) cho mỗi cụm, lấy các pool và đánh dấu những bản brief trả về quá ít kết quả khớp mạnh — đây chính là kiểu lỗi thực sự của minh họa lập trình. Việc gán ảnh vẫn nằm trong script của bạn, nơi tính xác định (determinism) quan trọng hơn sự sáng tạo.

