Иллюстрируем 10 000 страниц в месяц реальными фото — за 500 запросов к API
Ищите один раз на кластер тем, а не один раз на изображение — и 40 000 запросов к API превращаются в 500. Паттерн «пул и назначение», воркер, переживающий rate limit, и честный раздел о том, что фотографии исправить не могут.
 Marouane Tijani
12 мин чтения

Есть версия проблемы иллюстрирования контента, которую никакой хороший вкус не решит: вы не выбираете фотографию, вы заполняете 40 000 слотов изображений в месяц по 800 тематическим кластерам, 9 локалям и 14 сайтам клиентов, и каждое изображение должно быть лицензировано, подписано, масштабировано и отличаться от соседнего. При таком объёме вопрос перестаёт звучать как «какое фото?» и становится «какая архитектура?»
Эта статья — ответ на уровне API: паттерн запросов, который сокращает количество вызовов на два порядка, воркер, который переживает ограничения по частоте запросов, дедупликация, которая не даёт сайту из 10 000 страниц выглядеть стеной из одной и той же стоковой фотографии, — и честный раздел о том, чего изображения сделать не могут.
Настоящее узкое место при 10 000 статей
Команды, публикующие контент в больших объёмах — программные SEO-парки, страницы категорий маркетплейсов, агрегаторы, партнёрские сети, агентства, ведущие контент для портфеля клиентов, конвейеры локализации, превращающие одну статью в 20, — все упираются в одни и те же три стены, в одном и том же порядке:
- Количество вызовов. Один поиск на один слот изображения означает 40 000 вызовов API для 10 000 статей с четырьмя изображениями каждая. Любой провайдер оценивает, ограничивает и проверяет вас именно по этой цифре.
- Повторение. Примерно на тридцатой странице одна и та же фотография начинает повторяться. На трёхтысячной странице у вашего сайта появляется визуальная подпись: сгенерировано массово.
- Согласованность. Сотня статей в одном кластере должна выглядеть как серия, а не как сотня несвязанных досок Pinterest — а следующая локаль той же статьи должна переиспользовать ту же картинку, а не искать заново на другом языке.
Обратите внимание, чего нет в этом списке: поиск хорошей фотографии. Семантический движок возвращает страницу пригодных кандидатов примерно за 130 мс. Поиск решён; распределение — нет. Всё, что дальше, — про распределение.
Почему настоящие фотографии, именно при таком объёме
Аргументы в пользу фотографии, а не генерации, становятся сильнее с ростом объёма — по причинам, скорее операционным, чем эстетическим.
| При 40 000 изображений/месяц | Генерация | Поиск |
|---|---|---|
| Время на изображение | От секунд до минут, плюс отклонённые попытки | Один запрос (~130 мс) покрывает целый кластер |
| Драйвер стоимости | За изображение, навсегда | За запрос — а один запрос обслуживает ~25 статей |
| Получаемые метаданные | Никаких. Alt-текст и размеры пишете сами | Размеры, доминирующий цвет, blur hash, черновик подписи, строка авторства |
| Происхождение | Помечается машинно как синтетическое согласно AI Act ЕС с 2 августа 20261 | Названный фотограф, дата, исходный URL, который может открыть читатель |
| Режим сбоя | Правдоподобные, но неверные детали, единообразный фирменный стиль | Ничего не подошло под бриф — вы получаете ноль результатов, с чем можно работать |
Строка с метаданными — та, что определяет конвейер. Каждый результат поиска уже несёт
width, height, blur_hash, color_hex,
alt_description и готовую строку attribution.html — это ровно тот
набор данных, который нужен шаблонизатору, чтобы выдать <img> без сдвига
макета, с плейсхолдером и указанием авторства. Сгенерированные изображения дают вам файл, а
остальные шесть полей приходится придумывать самостоятельно.
Где генерация всё ещё выигрывает при масштабировании. Иллюстрации на уровне категорий для абстрактных таксономий («миграция в облако», «индексные фонды»), диаграммы и фирменный стиль, который вы хотите повторять по всему парку сайтов по брендовым причинам. Разделение, к которому приходит большинство крупных издателей: фотографии для всего, что существует в реальном мире, сгенерированное искусство для всего, что существует только в рассуждении. Мы подробно разобрали это разделение в статье как иллюстрировать каждую публикуемую статью.
Один запрос, сто фотографий
Это единственное изменение, которое перекраивает всю арифметику. Эндпоинт поиска принимает
per_page до 100, а курсорная пагинация позволяет продолжать
проходить по тому же ранжированному набору результатов. Так что единицей работы становится
не изображение, а пул.
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a woman signing paperwork with an insurance agent at a kitchen table in her home" \
  --data-urlencode "per_page=100" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "score_threshold=0.5" \
  --data-urlencode "fields=photo_id,urls,width,height,blur_hash,alt_description,attribution"

# → { "success": true, "data": [ …до 100 фотографий… ],
#     "pagination": { "per_page": 100, "has_more": true, "next_cursor": "eyJyc…" },
#     "meta": { "took_ms": 122.33, "request_id": "7ff1fb9b-…" } }
Три параметра здесь незаметно выполняют важную работу при масштабировании:
fields— разреженный набор полей. Запросите семь полей, которые рендерит ваш шаблон, и ответ перестанет включать длинное AI-описание каждой фотографии. На 40 000 фотографий это разница между сборкой, которая работает потоково, и той, что свопится.score_threshold— хвост страницы из 100 результатов, по определению, менее релевантен, чем её начало. Установка нижней границы означает, что тонкий кластер вернёт 34 фотографии вместо 100 посредственных, и ваш конвейер сможет отреагировать на это, а не публиковать их.next_cursor— когда кластеру действительно нужно 300 фотографий, пролистывайте тот же ранжированный набор, а не запускайте три разных запроса, которые пересекаются.
А вот арифметика для сайта, публикующего 10 000 страниц в месяц по четыре изображения на каждую:
| Стратегия | Запросов / месяц | Один проход при лимите запросов бесплатного плана20 запросов/мин | Укладывается в бесплатную месячную квоту? |
|---|---|---|---|
| Один поиск на слот изображения | 40 000 | 33 hours | Нет — нужен платный план |
| Один поиск на статью | 10 000 | 8 hours | Нет — нужен платный план |
| Один поиск на кластер из ~20 статейпаттерн из этой статьи | 500 | 25 minutes | Да |
Одни и те же 40 000 опубликованных изображений во всех трёх строках. Изменилось только место, где находится цикл.
Пул и распределение: паттерн, который масштабируется
Вся архитектура — это две фазы, работающие с разной частотой, и таблица между ними:
                     ┌─────────── запускается еженедельно, ~500 запросов ───┐
  тематические  ──▶ ПУЛ   поиск один раз на кластер, per_page=100
  кластеры             │       └─▶ сохраняем 100 строк-фотографий на кластер
                     └──────────────────┬───────────────────────────────┘
                                        ▼
                              таблица image_pool
                        (cluster, photo_id, urls, blur_hash,
                         alt, credit, used_by_page, used_at)
                                        │
                     ┌──────────────────┴──── запускается при публикации, 0 запросов ─┐
  статья ──────────▶ РАСПРЕДЕЛЕНИЕ  выбрать лучшую свободную строку для
                     │        этого кластера, пометить как использованную, отрендерить
                     └────────────────────────────────────────────────────────┘
Что это вам даёт, в порядке значимости при масштабировании:
- Публикация никогда не блокируется на API. Распределение — это чтение из базы данных. Хук сохранения вашей CMS, статическая сборка и массовый импорт в 3 часа ночи — всё это работает с локальной скоростью, офлайн, без единого ограничения по частоте запросов на всём пути.
- Дедупликация бесплатна и точна.
used_by_page IS NULL— это вся функция целиком. Две страницы не могут получить одну и ту же фотографию, потому что распределение — это транзакция, а не эвристика ранжирования. - Повторные запуски дёшевы и идемпотентны. Обновите пул кластера, когда он
исчерпывается или когда нужна более свежая фотография (
after_dateилиsort_by=newest) — один запрос, и ничего уже опубликованного не сдвигается. - Локали достаются бесплатно. 20 переводов одной статьи — это одна страница
в вашей модели с 20 рендерами; они разделяют один назначенный
photo_id, и вы никогда не ищете дважды. Когда вам действительно нужен локально снятый вид, запустите запрос пула для этого кластера на целевом языке — движок принимает предложение более чем на 100 языках.
Воркер в коде
Примерно шестьдесят строк. Наполнитель пула — единственная часть, которая обращается к сети,
поэтому именно она требует аккуратности — ограниченный параллелизм, соблюдение 429,
запись результатов в одной транзакции.
import asyncio, os, time, httpx

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
KEY    = os.environ["PEXAFY_API_KEY"]
FIELDS = "photo_id,urls,width,height,blur_hash,alt_description,attribution"

# Free = 20 запросов/мин. Держим на единицу меньше. Пейсер ГЛОБАЛЬНЫЙ: сон
# внутри шлюза параллелизма позволил бы N воркерам стрелять с N-кратной скоростью.
PER_MIN = 19
gate    = asyncio.Semaphore(4)         # одновременных соединений
_lock   = asyncio.Lock()
_slot   = 0.0                          # следующий свободный момент на общей шкале времени

async def pace():
    """Выдаёт по одному слоту запроса каждые 60/PER_MIN секунд, на весь флот."""
    global _slot
    async with _lock:
        now  = time.monotonic()
        _slot = max(now, _slot) + 60 / PER_MIN
        wait  = _slot - now
    if wait > 0:
        await asyncio.sleep(wait)

class QuotaExhausted(Exception): ...   # месячная: повтор не поможет

async def fill_pool(client, cluster) -> list[dict]:
    """Один запрос → до 100 лицензированных фотографий для одного тематического кластера."""
    for attempt in range(4):
        await pace()
        async with gate:
            r = await client.get(
                SEARCH,
                headers={"X-Api-Key": KEY},
                params={
                    "q": cluster["camera_brief"],   # сцена, а не ключевое слово
                    "per_page": 100,
                    "orientation": "landscape",
                    "score_threshold": 0.5,
                    "fields": FIELDS,
                },
                timeout=15,
            )
        if r.status_code == 429:
            retry_after = r.headers.get("Retry-After")
            if retry_after is None:            # нет Retry-After ⇒ месячная квота,
                raise QuotaExhausted(cluster["id"])   # останавливаем весь прогон
            await asyncio.sleep(int(retry_after))   # по минуте: это проходит
            continue
        r.raise_for_status()
        return r.json()["data"]
    return []                                  # логируем; пул сохраняет старые строки

async def refill(clusters):
    async with httpx.AsyncClient(http2=True) as client:
        pools = await asyncio.gather(*(fill_pool(client, c) for c in clusters))
    for cluster, photos in zip(clusters, pools):
        db.upsert_pool(cluster["id"], photos)     # ON CONFLICT DO NOTHING по photo_id
Две детали здесь — разница между воркером, который работает без присмотра, и тем, который будит
вас по ночам. Пейсер глобальный, а не за задачу: помещение сна внутрь шлюза
параллелизма — классическая ошибка: четыре воркера, каждый из которых засыпает на 3 секунды
после своего запроса, производят четыре запроса каждые 3 секунды, примерно 75 в минуту, и
бесплатный план сразу начинает возвращать 429. И два разных 429 — это
не одно и то же: тот, что за минуту, несёт Retry-After и сам проходит, тот, что за
месячную квоту, его не несёт и никогда не будет — повторять его бессмысленно, это цикл в стену.
Распределение — часть, которая выполняется при каждой публикации, — никогда не обращается к сети:
# Уникальность обеспечивается схемой, а не аккуратностью запроса.
# Одна фотография может находиться в нескольких пулах кластеров; опубликована
# она может быть только один раз.
# CREATE UNIQUE INDEX one_use_per_photo ON image_pool (photo_id)
#        WHERE used_by_page IS NOT NULL;

def assign_hero(page_id: str, cluster_id: str) -> dict | None:
    for _ in range(5):                # проигранная гонка просто берёт следующую фотографию
        try:
            return db.query_one("""
                UPDATE image_pool p SET used_by_page = %s, used_at = NOW()
                WHERE p.id = (
                    SELECT c.id FROM image_pool c
                    WHERE c.cluster_id = %s AND c.used_by_page IS NULL
                      AND NOT EXISTS (              -- используется ЛЮБЫМ другим кластером?
                          SELECT 1 FROM image_pool u
                          WHERE u.photo_id = c.photo_id
                            AND u.used_by_page IS NOT NULL
                      )
                    ORDER BY c.rank ASC
                    LIMIT 1 FOR UPDATE SKIP LOCKED  -- безопасно с параллельными воркерами
                )
                RETURNING photo_id, urls, width, height, blur_hash, alt, credit
            """, [page_id, cluster_id])
        except UniqueViolation:      # два кластера претендовали на неё в одну и ту же мс
            continue
    return None                     # пул пуст → расширить бриф, пополнить

# Рендеринг: каждый атрибут берётся из строки — без сдвига макета, без угадывания.
# <img src="{urls[regular]}" width="{width}" height="{height}"
#      alt="{alt}" loading="lazy" style="background:{blur_placeholder}">
# <figcaption>{credit}</figcaption>
Два режима сбоя, два механизма, и оба нужны. FOR UPDATE SKIP LOCKED обрабатывает
параллелизм внутри кластера: генерируйте страницы параллельно — а при таком объёме вы
так и будете делать — и два воркера потянутся за одной и той же наиболее релевантной фотографией
в одну и ту же миллисекунду.
Частичный уникальный индекс обрабатывает то, о чём все забывают: одна и та же фотография
законно оказывается в пулах нескольких кластеров, потому что соседние кластеры
(«страхование жилья для арендаторов», «…для арендодателей») возвращают пересекающиеся
результаты. Проверка used_by_page IS NULL в рамках одного кластера этого не
видит — каждый кластер считает фотографию свободной. NOT EXISTS удерживает запрос
честным, а индекс делает невозможным получить неверный результат при параллелизме: проигравший
гонку получает нарушение, повторяет попытку и берёт следующую фотографию. Без него утверждение
«ни одна из двух страниц не делит главное изображение» — это заявление, а не гарантия.
Когда пул исчерпывается посреди сборки, лучший фолбэк — расширить бриф, а не повторяться: уберите последнее уточнение из брифа для камеры, перезапустите запрос пула один раз, и только потом переиспользуйте фотографию с самым старым назначением — с жёстким правилом, что она никогда не попадёт на страницу того же кластера.
Один кластер, один пул: реальный запрос
Возьмём сравнительный парк страниц: страхование жилья, двадцать страниц — «страхование жилья для арендаторов», «…для арендодателей», «что на самом деле покрывает полис», двенадцать страниц по городам, три руководства по подаче претензий. Один бриф для камеры на весь кластер, один запрос, и вот начало пула, возвращённое за 122 мс:
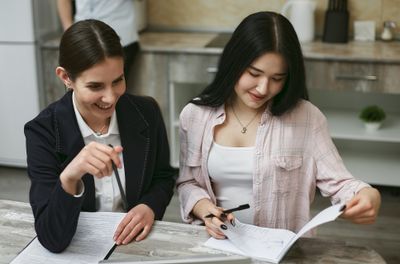
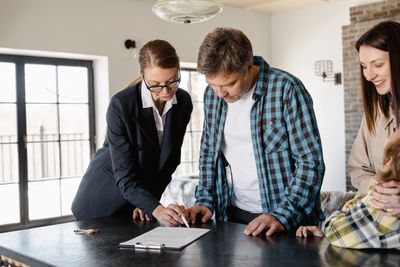
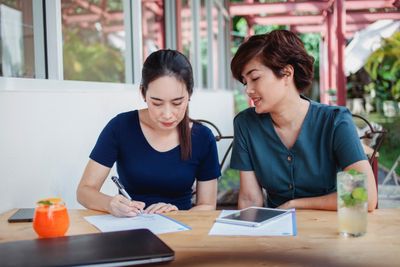
per_page=100 и сохраняет остальное.
Запустить именно этот поиск →
Брифы важнее кода. Два правила выживают при столкновении с реальным парком кластеров:
пишите бриф для кластера, а не для страницы (заголовки страниц почти идентичны
в программных наборах, поэтому брифы для отдельных страниц возвращают почти одинаковые
фотографии), и описывайте сцену, которую могла бы снять камера, а не тему —
страхование жилья вернёт только крупные планы документов и ничего больше. Мы
опубликовали готовый к копированию промпт, создающий такие брифы, в
статье об иллюстрировании каждой публикации.
Сохранение визуальной согласованности серии из 200 страниц
Противоположная неудача повторению — несогласованность: двадцать страниц в одном кластере,
каждая с технически корректной фотографией, но в двадцати разных визуальных регистрах.
Решение — один эндпоинт, GET /photos/{id}/similar, вызванный один раз на
фотографии, утверждённой для основной страницы:
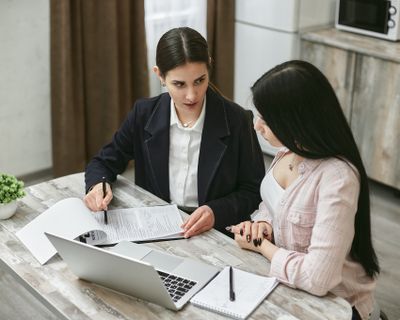
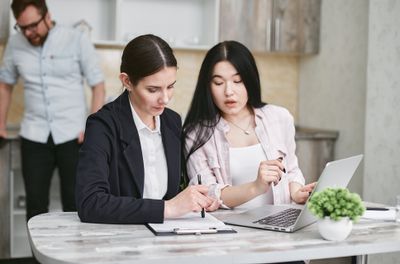
Ещё два рычага стоит встроить в запрос пула, когда важна консистентность бренда:
color_hex с color_tolerance удерживает весь парк сайтов в рамках
палитры, а photographer закрепляет кластер за творчеством одного фотографа.
Оба — обычные параметры запроса, никаких ограничений по плану на фильтры поиска.
Ограничения по частоте, квоты и реальная стоимость
Выбирайте план по пиковой нагрузке, а не по объёму. Как только вы начинаете использовать пулинг, месячная квота перестаёт быть ограничением почти для всех; ваш план определяет то, насколько быстро должно завершаться полное обновление.
| План | Запросов / месяц= обновляемых кластеров | Ограничение частоты | API-ключи | Обновление 1000 кластеровреальное время, один проход |
|---|---|---|---|---|
| Free — $0 | 5,000 | 20 / мин | 1 | 50 min |
| Starter — $5 | 25,000 | 30 / мин | 3 | 34 min |
| Pro — $19 | 100,000 | 60 / мин | 5 | 17 min |
| Team — $99для агентств: ключ на клиента | 500,000 | 200 / мин | 25 | 5 min |
| Business — $249 | 1,000,000 | 300 / мин | unlimited | 4 min |
| Enterprise — $599 | 2,000,000 | 500 / мин | unlimited | 2 min |
Читайте первый столбец как кластеры: один пулинговый запрос заполняет один кластер, так что месячная квота — это количество кластеров, которые вы можете обновить, а последний столбец — сколько времени займёт полный проход по парку из 1000 кластеров при ограничении частоты запросов этого плана. Оба значения — актуальные данные из каталога тарифов; страница тарифов указывает те же ограничения частоты запросов за час, а не за минуту.
Так что парк из 10 000 страниц в месяц по паттерну с пулингом тратит ~500 запросов и платит ничего. То, что подталкивает команды выше по таблице, редко бывает объёмом — это одна из трёх вещей: полное переиллюстрирование существующего парка за одну ночь, изоляция ключей по клиентам (агентству нужен один ключ на клиента, чтобы использование было отслеживаемым без гимнастики с общими секретами) или окно сборки, измеряемое минутами, а не часами.
Две операционные детали, которые спасают ночь отладки. Каждый ответ несёт
X-RateLimit-Limit и X-RateLimit-Remaining, так что воркер может
сам регулировать темп, а не гадать. И 429, который является настоящим
ограничением по минуте, несёт Retry-After, а блокировка по месячной квоте
намеренно не несёт его — повторная попытка её не снимет, и воркер, различающий эти
два случая, перестаёт бомбардировать эндпоинт, у которого больше нечего дать.
Когда публикацией занимается агент
Если ваш контент производит агент — а при таких объёмах это происходит всё чаще — слой пулинга
никуда не исчезает, он просто перемещается. Дайте агенту инструменты поиска, и он заполнит
пул, пока всё ещё держит бриф кластера в контексте, используя сервер
Model Context Protocol по адресу mcp.pexafy.com/mcp: три
инструмента, search_photos (по фразе), search_photos_by_image
(по референсному изображению, опционально плюс фраза) и get_similar_photos
(тот, что для согласованности серии, описанный выше).
# Claude Code / CI-раннер
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# или закоммитьте .mcp.json, чтобы каждый воркер во флоте унаследовал конфигурацию
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
Инструкция, которая работает при масштабировании, — пакетная, а не по одной статье, и она однозначно ложится на две описанные выше фазы:
Вы  Вот 12 тематических кластеров из контент-плана. Для каждого
     напиши один бриф для камеры, вытяни 100 горизонтальных фотографий
     и запиши пул в Postgres. Отметь любой кластер, вернувший меньше 40
     результатов выше 0.5 — такие брифы нужно переписать.

Агент  → search_photos(q="a woman signing paperwork with an insurance
           agent at a kitchen table in her home", orientation="landscape")
      ← 100 фотографий · 122 мс · 87 выше порога
      … ещё 11 кластеров …

      ✓ Записано 11 пулов (1043 фотографии, все с указанием авторства)
      ⚠ «ребалансировка индексного фонда» → 12 результатов. Бриф абстрактный;
        предлагаю: «человек за кухонным столом проверяет цифры на
        ноутбуке, рядом блокнот и кофе»
Эта последняя строка — причина, по которой в этот цикл стоит включить агента, а не скрипт: режим сбоя программного иллюстрирования — это неудачный бриф, а неудачный бриф — это ровно то, что языковая модель может заметить и переписать. Скрипты остаются ответственными за распределение, где важен детерминизм, а не творчество.
Чего фотографии исправить не могут
Честный раздел, потому что описываемая в нём ошибка дорого стоит. Настоящая, лицензированная фотография улучшает страницу. Она не превращает тонкий контент в качественный, и никакой конвейер изображений не меняет то, как поисковые системы относятся к массово производимым страницам, которые существуют, чтобы ранжироваться, а не чтобы приносить пользу. Правила Google в отношении спама прямо называют это: злоупотребление масштабируемым контентом охватывает генерацию множества страниц с малой ценностью независимо от того, задействована ли автоматизация, и качество иллюстраций к этому суждению не относится.2
Так что полезная формулировка узка и правдива: фотография — это подконтрольный вам сигнал качества на страницах, которые уже заслуживают существования. Где она доказуемо окупается:
- Происхождение, которое читатель может проверить. Строка авторства с именем фотографа и исходным URL — это утверждение, которое можно проверить, — противоположность неатрибутированного изображения на странице с неатрибутированным автором.
- Доступность и Core Web Vitals.
width/heightиз ответа устраняют сдвиг макета,blur_hashдаёт настоящий плейсхолдер, аalt_description— черновик alt-текста, который ваш шаблон может улучшить, а не выдумывать с нуля. Умножьте на 40 000 слотов, и это вся история качества изображений на сайте. - Отсутствие вида массового производства. Дедупликация и согласованность серии — вот что не даёт парку сайтов приобрести визуальную подпись. Это реальная стоимость восприятия с реальными последствиями, и она полностью под вашим контролем.
И лицензия всё ещё регулирует использование изображения. Указание авторства не требуется
условиями API Pexafy — каждый результат поставляется с готовыми к рендерингу
attribution.html и attribution.plain, — но лицензия, прикреплённая
исходной библиотекой, применяется к вашему использованию этой фотографии, и при 40 000
изображений в месяц автоматический рендеринг авторства обходится дешевле, чем последующий
аудит.
С чего начать в понедельник
- Сгруппируйте свой бэклог в кластеры по 15–30 страниц, которые правдоподобно могли бы использовать одну фотосессию. Это единственный по-настоящему ручной шаг, и это таблица, а не проект.
- Напишите один бриф для камеры на кластер — сцену, от 12 до 25 слов. Генерируйте их с помощью модели, а затем читайте; брифы, называющие тему вместо сцены, видны сразу.
- Заполните один пул одним запросом с
per_page=100и просмотрите его начало. Если первые десять не подходят, значит, неверен бриф — а не движок. - Добавьте столбец
used_by_page, прежде чем что-либо публиковать. Это пять минут сейчас — и миграция по 3000 живых страниц позже. - Запускайте всё это на бесплатном плане, пока окно сборки не заставит вас подняться выше. При 500 запросах в месяц это займёт время.
Источники и примечания
1 AI Act ЕС, статья 50 — обязательства по прозрачности, применимые с 2 августа 2026: провайдеры систем, генерирующих синтетическое изображение, аудио, видео или текст, обязаны маркировать выходные данные в машиночитаемом формате и делать их обнаружимыми как созданные искусственным интеллектом. Это касается провайдеров и операторов ИИ; это не правило о том, какие изображения может публиковать сайт.
2 Правила Google в отношении спама в поиске — злоупотребление масштабируемым контентом: генерация множества страниц в основном для манипуляции ранжированием и с малой пользой для пользователей, независимо от того, созданы ли они с помощью автоматизации, человеческих усилий или их сочетания. Качество иллюстраций не является фактором в этой оценке, и именно поэтому эта статья разделяет эти два вопроса.
Источники проверены 17 августа 2026: Правила Google в отношении спама в поиске · AI Act, статья 50 · Документация API и MCP Pexafy. Лимиты планов — актуальные значения из тарифной таблицы Pexafy; тайминги поиска (122 мс, 48 мс) и каждая показанная фотография — реальные ответы API, зафиксированные в тот же день.
Часто задаваемые вопросы
Как получить изображения для тысяч программных SEO-страниц?
GET /api/v1/search/photos с параметром per_page=100 возвращает до 100 фото с указанием авторства для одного кластера; вы сохраняете их в таблицу пула и назначаете по одному на страницу при публикации. Для проекта с 10 000 страниц в месяц и четырьмя изображениями на страницу требуется примерно 500 запросов вместо 40 000, что укладывается в бесплатный план (5000 запросов в месяц).Какой лучший API стоковых фото для производства контента в больших объёмах?
Как избежать повторения одного и того же стокового фото на разных страницах?
photo_id каждого опубликованного изображения и забирайте фото из пула транзакционно — в SQL это UPDATE … WHERE used_by_page IS NULL … FOR UPDATE SKIP LOCKED. Тогда дедупликация становится точной, а не вероятностной, и параллельные build-воркеры не конкурируют за одно и то же топовое фото. Это всего одна колонка, и добавлять её задним числом на тысячах уже опубликованных страниц гораздо дороже, чем сразу заложить с первого дня.Сколько фото может вернуть один запрос к API?
per_page=100, а курсорная пагинация позволяет продолжать проход по тому же ранжированному набору результатов для более глубоких пулов. Комбинируйте это с score_threshold, чтобы небольшой кластер возвращал 40 сильных совпадений, а не 100 слабых, и с fields, чтобы возвращать только те атрибуты, которые рендерит ваш шаблон — это снижает размер ответов при больших объёмах.Помогают ли реальные фото страницам, созданным в масштабе, лучше ранжироваться?
Может ли ИИ-агент автоматически заполнять пул изображений?
mcp.pexafy.com/mcp, который предоставляет search_photos, search_photos_by_image и photo_similar. Дайте агенту список кластеров — и он составит по одному техническому заданию для съёмки на каждый, соберёт пулы и отметит задания, для которых нашлось слишком мало сильных совпадений — а это и есть реальный сценарий сбоя при программном иллюстрировании. Назначение остаётся в ваших скриптах, где детерминизм важнее креативности.

