月間1万ページを実写真でイラスト化 ― APIコール500回で
画像1枚ごとではなく、トピッククラスターごとに1回検索すれば、4万回のAPIコールが500回になります。プールして割り当てるパターン、レート制限を乗り越えるワーカー、そして写真では解決できないことについての正直なセクション。
 Marouane Tijani
12 分で読めます

センスの良し悪しでは解決できないタイプのコンテンツ画像問題がある。あなたが選んでいるのは「1枚の写真」ではなく、800のトピッククラスター、9つのロケール、14のクライアントサイトにまたがる月4万件の画像枠の穴埋めであり、そのすべてがライセンス済みで、クレジット表記があり、サイズが合っていて、隣のページとは違う写真でなければならない。この規模になると、問いは「どの写真か」ではなく「どういうアーキテクチャにするか」に変わる。
この記事はそのAPI視点での回答である——呼び出し回数を2桁少なくするリクエストパターン、レート制限を乗り越えて動き続けるワーカー、1万ページのサイトが同じストック写真の壁に見えないようにする重複排除、そして写真では解決できないことについての正直なセクションだ。
1万記事規模で本当のボトルネックになるもの
大量publishを行うチーム——プログラマティックSEOの大規模サイト、マーケットプレイスのカテゴリページ、アグリゲーター、アフィリエイトネットワーク、複数クライアントのコンテンツを運用する代理店、1本の記事を20言語に展開するローカライズパイプライン——は、すべて同じ順序で同じ3つの壁にぶつかる。
- 呼び出し回数。 画像枠ごとに1回検索すると、4画像×1万記事で4万回のAPI呼び出しになる。どのプロバイダーも、この数に基づいて課金・スロットリング・レビューを行う。
- 反復。 だいたい30ページ目あたりから同じ写真が再登場し始める。3千ページ目になると、サイトには視覚的な特徴が生まれる——「大量生成された感じ」だ。
- 整合性。 1つのクラスター内の100記事は、無関係な100個のPinterestボードではなく、シリーズのように見えるべきだ。そして同じ記事の次のロケールは、別の言語で再検索するのではなく、同じ写真を再利用すべきだ。
ここで注目すべきは、リストに含まれていないもの——良い写真を見つけること、である。セマンティックエンジンなら、約130 ミリ秒で使える候補の1ページを返す。検索自体はすでに解決済みの問題であり、配分の問題が未解決なのだ。以下はすべて配分についての話である。
なぜこの規模でこそ本物の写真なのか
写真vs生成の議論は、規模が大きくなるほど写真側に有利に傾く。その理由は美的なものというより、運用上の理由がほとんどだ。
| 月4万枚の画像の場合 | 生成する場合 | 検索する場合 |
|---|---|---|
| 1枚あたりの時間 | 数秒〜数分、加えて却下された試行分も | 1リクエスト(約130 ms)でクラスター全体をカバー |
| コストの発生要因 | 画像1枚ごと、永続的に発生 | リクエストごと——しかも1リクエストで約25記事分をカバー |
| 付随するメタデータ | なし。altテキストや寸法は自分で書く | 寸法、支配的な色、ブラッシュハッシュ、キャプション草案、クレジット表記 |
| 来歴 | 2026年8月2日以降、EU AI Actにより合成物として機械的にマークされる1 | 実名の撮影者、日付、読者が開けるソースURL |
| 失敗のパターン | もっともらしいが誤った細部、画一的なハウススタイル | ブリーフに合致するものがなければ結果ゼロ——対応可能 |
パイプラインの設計を左右するのは、メタデータの行だ。すべての検索結果にはすでにwidth、height、blur_hash、color_hex、alt_description、そして出来合いのattribution.html文字列が含まれている——これは、テンプレートエンジンがレイアウトシフトのない<img>をプレースホルダー付き・クレジット付きで出力するのに必要なペイロードそのものだ。生成画像が与えてくれるのはファイル1つだけで、残り6つのフィールドは自分で作らねばならない。
それでも規模において生成が優位な場面。 抽象的なタクソノミー(「クラウド移行」「インデックスファンド」)のカテゴリレベルの図解、ダイアグラム、ブランド上の理由で全サイトに統一したいハウススタイル。多くの大規模パブリッシャーが行き着く区分は次の通り——この世に実在するものには写真、議論の中にしか存在しないものには生成アートだ。この区分については 公開するすべての記事をどう図解するかで詳しく論じている。
1リクエスト、100枚の写真
計算を根本から作り変えるのが、この1つの変更だ。検索エンドポイントはper_pageを最大100まで受け付け、カーソルページネーションによって同じランク付き結果セットをたどり続けられる。つまり作業の単位は1枚の画像ではなく、1つのプールである。
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a woman signing paperwork with an insurance agent at a kitchen table in her home" \
  --data-urlencode "per_page=100" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "score_threshold=0.5" \
  --data-urlencode "fields=photo_id,urls,width,height,blur_hash,alt_description,attribution"

# → { "success": true, "data": [ …最大100枚の写真… ],
#     "pagination": { "per_page": 100, "has_more": true, "next_cursor": "eyJyc…" },
#     "meta": { "took_ms": 122.33, "request_id": "7ff1fb9b-…" } }
ここに含まれる3つのパラメータは、規模が大きくなるほど静かに効いてくる。
fields— スパースフィールドセットである。テンプレートが描画する7つのフィールドだけを要求すれば、各写真の長いAI説明文がレスポンスに含まれなくなる。4万枚の写真規模では、これがストリーミングできるビルドとスワップが発生するビルドの分かれ目になる。score_threshold— 100件の結果ページの末尾は、定義上、先頭より関連性が低い。下限を設定すれば、薄いクラスターは平凡な100枚ではなく34枚を返すようになり、パイプラインはそれを検知して対処できる(そのまま公開してしまうのではなく)。next_cursor— あるクラスターが本当に300枚必要な場合、重複する3つの別クエリを発行するのではなく、同じランク付き結果セットをページネーションする。
そして、以下が実際の計算だ。1記事あたり画像4枚、月1万ページを公開するサイトの場合:
| 戦略 | 月間リクエスト数 | 無料プランのレート制限で1周20リクエスト/分 | 無料の月間クォータに収まるか? |
|---|---|---|---|
| 画像枠ごとに1回検索 | 40,000 | 33 hours | 収まらない——有料プランが必要 |
| 記事ごとに1回検索 | 10,000 | 8 hours | 収まらない——有料プランが必要 |
| 約20記事のクラスターごとに1回検索この記事のパターン | 500 | 25 minutes | 収まる |
3行とも、公開される画像は同じ4万枚だ。変わったのはループの位置だけである。
プールと割り当て:スケールするパターン
アーキテクチャ全体は、異なる頻度で動く2つのフェーズと、その間に置かれるテーブルからなる。
                     ┌─────────── 週次実行、約500リクエスト ───────────┐
  トピッククラスター ──▶ POOL   クラスターごとに1回検索、per_page=100
                     │       └─▶ クラスターごとに100件の写真行を保存
                     └──────────────────┬───────────────────────────────┘
                                        ▼
                              image_pool テーブル
                        (cluster, photo_id, urls, blur_hash,
                         alt, credit, used_by_page, used_at)
                                        │
                     ┌──────────────────┴──── 公開ごとに実行、リクエスト0件 ───┐
  記事 ─────────▶ ASSIGN  このクラスター向けの未使用行から
                     │        最適なものを選び、使用済みにマークし、描画する
                     └────────────────────────────────────────────────────────┘
これによって得られるものを、規模において重要な順に並べると:
- 公開処理がAPIによってブロックされることは一切ない。 割り当てはデータベースの読み取りにすぎない。CMSの保存フック、静的ビルド、深夜3時の一括インポートも、すべてローカル速度でオフラインに実行でき、経路上にレート制限は一切存在しない。
- 重複排除は無料かつ正確だ。
used_by_page IS NULL——機能はこれだけである。割り当てはランキングのヒューリスティックではなくトランザクションなので、2ページが同じ写真を引き当てることはあり得ない。 - 再実行は低コストかつ冪等だ。 クラスターのプールが尽きたとき、あるいはより新しい写真が欲しいとき(
after_date、もしくはsort_by=newest)に再実行できる——1リクエストで済み、すでに公開済みのものは何も動かない。 - ロケールは追加コストなしで対応できる。 ある記事の20言語翻訳は、モデル上は20回のレンダリングを伴う1ページにすぎない。それらは割り当てられた同じ
photo_idを共有し、二度検索することはない。ローカルで撮影されたような雰囲気が欲しい場合は、対象言語でそのクラスターのプールクエリを実行すればよい——このエンジンは100以上の言語で文章を受け付ける。
ワーカーの実装
おおよそ60行程度。プールを埋める処理だけがネットワークと通信するため、注意が必要なのもここだけだ——並行数を上限で抑え、429を尊重し、結果は1トランザクションで書き込む。
import asyncio, os, time, httpx

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
KEY    = os.environ["PEXAFY_API_KEY"]
FIELDS = "photo_id,urls,width,height,blur_hash,alt_description,attribution"

# Free = 20 リクエスト/分。1つ余裕を持たせる。ペーサーはGLOBAL:タスクごとのsleepを
# 並行ゲートの内側に置くと、N個のワーカーがN倍のレートで発行してしまう。
PER_MIN = 19
gate    = asyncio.Semaphore(4)         # 同時接続数
_lock   = asyncio.Lock()
_slot   = 0.0                          # 共有タイムライン上の次に空くタイミング

async def pace():
    """60/PER_MIN秒ごとに1リクエスト分の枠を、フリート全体で払い出す。"""
    global _slot
    async with _lock:
        now  = time.monotonic()
        _slot = max(now, _slot) + 60 / PER_MIN
        wait  = _slot - now
    if wait > 0:
        await asyncio.sleep(wait)

class QuotaExhausted(Exception): ...   # 月次クォータ:リトライしても無意味

async def fill_pool(client, cluster) -> list[dict]:
    """1リクエスト → 1トピッククラスター分、最大100枚のクレジット付き写真。"""
    for attempt in range(4):
        await pace()
        async with gate:
            r = await client.get(
                SEARCH,
                headers={"X-Api-Key": KEY},
                params={
                    "q": cluster["camera_brief"],   # キーワードではなく情景
                    "per_page": 100,
                    "orientation": "landscape",
                    "score_threshold": 0.5,
                    "fields": FIELDS,
                },
                timeout=15,
            )
        if r.status_code == 429:
            retry_after = r.headers.get("Retry-After")
            if retry_after is None:            # Retry-Afterなし ⇒ 月次クォータ、
                raise QuotaExhausted(cluster["id"])   # 実行全体を停止
            await asyncio.sleep(int(retry_after))   # 分単位制限:やがて解除される
            continue
        r.raise_for_status()
        return r.json()["data"]
    return []                                  # ログに記録。プールは既存の行を保持

async def refill(clusters):
    async with httpx.AsyncClient(http2=True) as client:
        pools = await asyncio.gather(*(fill_pool(client, c) for c in clusters))
    for cluster, photos in zip(clusters, pools):
        db.upsert_pool(cluster["id"], photos)     # photo_id にON CONFLICT DO NOTHING
ここにある2つの細部が、無人で回り続けるワーカーと、あなたを夜中に叩き起こすワーカーの分かれ目になる。ペーサーはタスク単位ではなくグローバルである点に注意——sleepを並行ゲートの内側に置くのは典型的な失敗であり、4つのワーカーがそれぞれ自分のリクエスト後に3秒待つと、実際には3秒ごとに4リクエスト、つまり毎分およそ75リクエストが発生し、無料プランは即座に429を返し始める。また、2種類の429は同じ性質のものではない——分単位の制限はRetry-Afterを伴い、自然に解除されるが、月次クォータによるものはそれを伴わず、二度と解除されない——それをリトライするのは壁に向かってループするようなものだ。
一方、公開のたびに実行される割り当て処理は、ネットワークに一切触れない。
# 一意性はクエリの慎重さではなく、スキーマによって強制される。
# 1枚の写真は複数のクラスターのプールに存在しうるが、公開できるのは1回だけ。
# CREATE UNIQUE INDEX one_use_per_photo ON image_pool (photo_id)
#        WHERE used_by_page IS NOT NULL;

def assign_hero(page_id: str, cluster_id: str) -> dict | None:
    for _ in range(5):                # 競合に負けたら次の写真を取るだけ
        try:
            return db.query_one("""
                UPDATE image_pool p SET used_by_page = %s, used_at = NOW()
                WHERE p.id = (
                    SELECT c.id FROM image_pool c
                    WHERE c.cluster_id = %s AND c.used_by_page IS NULL
                      AND NOT EXISTS (              -- 他のクラスターで使用済みか?
                          SELECT 1 FROM image_pool u
                          WHERE u.photo_id = c.photo_id
                            AND u.used_by_page IS NOT NULL
                      )
                    ORDER BY c.rank ASC
                    LIMIT 1 FOR UPDATE SKIP LOCKED  -- 並行ワーカーでも安全
                )
                RETURNING photo_id, urls, width, height, blur_hash, alt, credit
            """, [page_id, cluster_id])
        except UniqueViolation:      # 同じミリ秒に2つのクラスターが取り合った
            continue
    return None                     # プール枯渇 → ブリーフを広げる、再実行

# 描画:すべての属性は行から取得される——レイアウトシフトなし、推測なし。
# <img src="{urls[regular]}" width="{width}" height="{height}"
#      alt="{alt}" loading="lazy" style="background:{blur_placeholder}">
# <figcaption>{credit}</figcaption>
2つの失敗モードに、2つの機構が対応しており、どちらも必要だ。FOR UPDATE SKIP LOCKEDは、1つのクラスター内部の並行性を処理する——ページを並行生成すれば(この規模なら必ずそうなる)、2つのワーカーが同じミリ秒に同じトップランクの写真に手を伸ばすことになる。
部分ユニークインデックスは、みんなが忘れがちなケースを処理する——同じ写真が、正当に複数のクラスターのプールに現れることがある。近隣のクラスター(「賃貸人向け住宅保険」「大家向け住宅保険」)は、重複する結果を返すからだ。クラスターごとのused_by_page IS NULLチェックはこれを見抜けない——各クラスターは、その写真が空いていると誤って信じてしまう。NOT EXISTSはクエリを正しく保ち、インデックスは並行実行下でもそれが間違うことを不可能にする——競合に負けた側は違反を受けてリトライし、次の写真を取る。これがなければ、「2ページが同じヒーロー画像を共有しない」は保証ではなく単なる主張にすぎない。
ビルド途中でプールが枯渇したとき、最も挙動が良いフォールバックは、繰り返すのではなく広げることだ——カメラブリーフの最後の節を削って再度プールクエリを1回実行し、それでもだめな場合に限り最も古く割り当てられた写真を再利用する——ただし同じクラスター内のページには絶対に使わないという固いルールをつけて。
1クラスター、1プール:実例クエリ
比較サイトを例に取ろう——住宅保険、20ページ構成——「賃貸人向け住宅保険」「大家向け住宅保険」「保険が実際にカバーするもの」、12の都市ページ、3つの請求ガイド。クラスターに対して1つのカメラブリーフ、1回のリクエスト、そして122 msで返ってきたプールの先頭がこれだ。
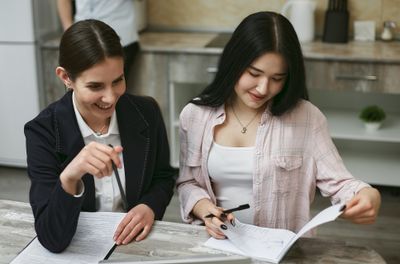
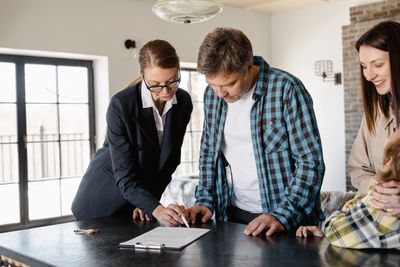
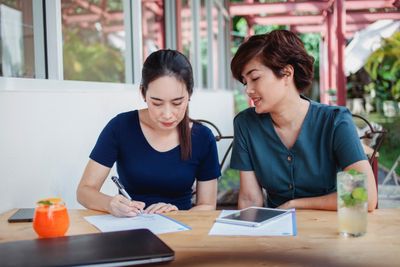
per_page=100を指定し、残りも保持している。
この検索をそのまま実行 →
実際にはコードよりブリーフの方が重要だ。実際の大規模クラスター群と向き合うと、2つのルールが生き残る——ブリーフはページではなくクラスター単位で書くこと(プログラマティックなセット内ではページタイトルがほぼ同一になるため、ページ単位のブリーフはほぼ同一の写真を返してしまう)、そしてトピックではなくカメラが実際に撮れる情景を記述すること——home insuranceではただ書類のクローズアップしか返ってこない。こうしたブリーフを生成するそのままコピペできるプロンプトは、すべての投稿を図解する記事で公開している。
200ページのシリーズを視覚的に一貫させる
反復の逆の失敗は不整合だ——あるクラスター内の20ページが、それぞれ技術的には正しい写真を使っているのに、20通りの異なる視覚的トーンになってしまう。この解決策は1つのエンドポイント——GET /photos/{id}/similar——であり、ピラー記事用に承認した写真に対して1回実行するだけでよい。
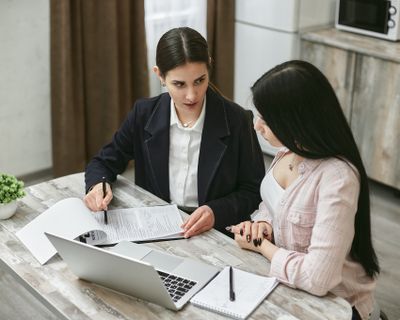
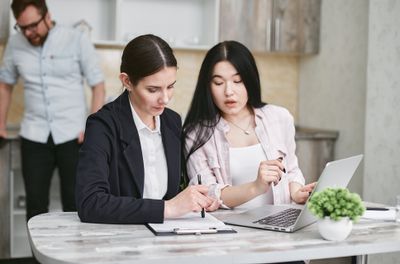
ブランドの一貫性が求められる場合、プールクエリに組み込む価値のあるもう2つのレバーがある——color_hexとcolor_toleranceの組み合わせは、サイト全体を1つのパレット内に収め、photographerはクラスターを特定の撮影者の作品群に固定する。どちらも通常のクエリパラメータであり、検索フィルターにプラン制限はない。
レート制限、クォータ、実際にかかるコスト
プランはバースト(瞬間的な負荷)で選ぶべきで、ボリュームで選ぶべきではない。プールを使えば、月間クォータはほとんど誰にとっても制約でなくなる。プランを決めるのは、フルリフレッシュがどれだけ速く完了する必要があるか、である。
| プラン | 月間リクエスト数=リフレッシュ可能なクラスター数 | レート制限 | APIキー | 1,000クラスターのリフレッシュ実時間、1周分 |
|---|---|---|---|---|
| Free — $0 | 5,000 | 20 / 分 | 1 | 50 min |
| Starter — $5 | 25,000 | 30 / 分 | 3 | 34 min |
| Pro — $19 | 100,000 | 60 / 分 | 5 | 17 min |
| Team — $99代理店向け:クライアントごとに1キー | 500,000 | 200 / 分 | 25 | 5 min |
| Business — $249 | 1,000,000 | 300 / 分 | unlimited | 4 min |
| Enterprise — $599 | 2,000,000 | 500 / 分 | unlimited | 2 min |
1列目はクラスター数として読んでほしい——プール用リクエスト1回で1クラスター分が満たされるため、月間クォータはリフレッシュできるクラスター数を意味する。最後の列は、そのプランのレート制限のもとで1,000クラスター規模のサイトを1周リフレッシュするのにかかる時間だ。どちらも料金カタログの実際の値である——料金ページでは同じレート制限を分単位ではなく時間単位で記載している。
したがって、月1万ページ規模のサイトがプール方式を採用した場合、消費するのは約500リクエストで、料金はゼロである。チームが上位プランに移行する理由はほとんどの場合ボリュームではなく、次の3つのいずれかだ——既存サイト全体の図解を一晩で刷新すること、クライアントごとのキー分離(代理店が使用状況を共有シークレットの曲芸なしに帰属させるため、クライアントごとに1キーを持ちたい場合)、あるいはビルドウィンドウが時間単位ではなく分単位で測られる場合である。
夜通しのデバッグを1回省ける運用上の細部が2つある。すべてのレスポンスにはX-RateLimit-LimitとX-RateLimit-Remainingが含まれるため、ワーカーは推測ではなくペースを調整できる。そして、真の分単位レート制限による429にはRetry-Afterが付くが、月間クォータによるブロックには意図的に付かない——後者をリトライしても解除されず、両者を見分けるワーカーは、もう何も残っていないエンドポイントを叩き続けることをやめられる。
エージェントがpublishを担う場合
コンテンツがエージェントによって生成されている場合——この規模ではますますそうなりつつある——プーリング層は消えるのではなく、移動するだけだ。検索ツールをエージェントに与えれば、クラスターブリーフをまだコンテキストに保持したままプールを埋めることができる。使うのはmcp.pexafy.com/mcpにあるModel Context Protocolサーバーで、3つのツール——search_photos(文章による検索)、search_photos_by_image(参照画像、任意で文章も併用)、get_similar_photos(上述したシリーズの一貫性を保つためのもの)を提供する。
# Claude Code / CIランナー
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# もしくは .mcp.json をコミットし、フリート内の全ワーカーに継承させる
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
この規模で機能する指示は、記事単位ではなくバッチ単位の指示であり、上述した2つのフェーズにそのまま1対1で対応する。
You  コンテンツカレンダーから12個のトピッククラスターを渡します。それぞれについて
     カメラブリーフを1本書き、横長写真を100枚取得し、
     プールをPostgresに書き込んでください。0.5を超える結果が40件未満の
     クラスターにはフラグを立ててください——それらのブリーフは書き直しが必要です。

Agent  → search_photos(q="a woman signing paperwork with an insurance
           agent at a kitchen table in her home", orientation="landscape")
      ← 100枚の写真 · 122 ms · しきい値超えが87件
      … 残り11クラスター …

      ✓ 11プール書き込み完了(1,043枚、すべてクレジット付き)
      ⚠ 「インデックスファンドのリバランス」 → 結果12件。ブリーフが抽象的すぎます。
        提案:「ノートに手を伸ばしながら、キッチンテーブルでノートパソコンの
        数字を確認する人物、コーヒーカップも一緒に」
この最後の1行こそ、このループにスクリプトではなくエージェントを組み込む理由だ——プログラマティックな図解の失敗モードは悪いブリーフであり、悪いブリーフはまさに言語モデルが気づいて書き直せるものだからだ。決定論性が重要で創造性が不要な割り当ての部分は、引き続きスクリプトが担当する。
写真では解決できないこと
正直に述べるセクションだ。ここで説明する失敗は、コストが高くつくものだからだ。本物のクレジット付き写真はページを改善する。だが、薄いコンテンツを良いコンテンツに変えることはできないし、画像パイプラインが何であれ、検索エンジンが「役に立つためではなく上位表示のために存在する大量生産ページ」をどう扱うかは変わらない。Googleのスパムポリシーはこれを直接名指ししている——大規模コンテンツの悪用(scaled content abuse)は、自動化の有無に関わらず、価値の乏しいページを大量生成することを対象としており、そうしたページの図解の品質はその判断とは無関係である。2
したがって、有用な捉え方は狭く、かつ正しい——写真は、すでに存在する価値のあるページにおいてあなたがコントロールできる品質シグナルである。写真が明確に効果を発揮する場面は次の通りだ。
- 読者が検証できる来歴。 撮影者名とソースURLの付いたクレジット表記は、確認可能な主張である——著者不明のページに載った出典不明の画像とは正反対だ。
- アクセシビリティとCore Web Vitals。 レスポンスから得られる
width/heightはレイアウトシフトをなくし、blur_hashは本物のプレースホルダーを与え、alt_descriptionはテンプレートが改善できる(一から作らずに済む)altテキストの下書きになる。4万枠に掛け合わせれば、これはサイト全体の画像品質の話そのものになる。 - 大量生産に見えないこと。 重複排除とシリーズの一貫性が、サイトから視覚的な特徴が生まれるのを防ぐ。これは現実の知覚コストであり、現実の結果を伴うが、完全にあなたのコントロール下にある。
そしてライセンスは、あくまでその写真を支配する。Pexafy APIの利用規約ではクレジット表記は必須ではない——すべての結果には描画可能なattribution.htmlとattribution.plainが同梱されているが——元のライブラリに付随するライセンスは、その写真の使用に対して適用される。月4万枚規模では、後から監査するより、クレジットを自動的に描画しておく方が安上がりだ。
月曜日から始めるべきこと
- バックログを15〜30ページ単位のクラスターにまとめる。同じ撮影セッションを共有できそうなページのグループだ。これが唯一の純粋に手作業のステップであり、プロジェクトではなくスプレッドシートで済む。
- クラスターごとに1つのカメラブリーフを書く——情景を12〜25語で。モデルで生成し、それを読むこと。トピックを名指ししているだけで情景を描写していないブリーフは、一目で見分けられる。
- 1回の
per_page=100リクエストで1つのプールを埋め、先頭を目視確認する。トップ10が使えないなら、悪いのはエンジンではなくブリーフだ。 - 何かを公開する前に
used_by_pageカラムを追加する。今なら5分で済むが、後で3,000ページの本番サイトにマイグレーションを当てるのは大仕事になる。 - ビルドウィンドウの制約で押し上げられるまで、すべて無料プランで運用する。月500リクエストなら、しばらくは十分持つ。
参考文献・脚注
1 EU AI Act 第50条——2026年8月2日から適用される透明性義務:合成画像・音声・動画・テキストを生成するシステムの提供者は、出力を機械可読な形式でマークし、人工的に生成されたものとして検出可能にしなければならない。これはAIの提供者・展開者を拘束するものであり、ウェブサイトがどの画像を公開してよいかについての規則ではない。
2 Google検索のスパムポリシー——大規模コンテンツの悪用(scaled content abuse):自動化、人手、あるいはその組み合わせのいずれによって作られたかに関わらず、主に検索順位を操作するために大量のページを生成し、ユーザーにほとんど価値を提供しないこと。図解の品質はこの評価の要素ではなく、まさにそれゆえに本記事はこの2つを分けて論じている。
出典確認日:2026年8月17日: Google検索のスパムポリシー · AI Act 第50条 · Pexafy API & MCP ドキュメント。 プランの上限はPexafyの料金表の実際の値であり、検索タイミング(122 ms、48 ms)と表示されているすべての写真は、同日に取得された実際のAPIレスポンスである。
よくある質問
数千ページ規模のプログラマティックSEOページに画像を用意するにはどうすればよいですか?
per_page=100を指定した1回のGET /api/v1/search/photosリクエストで、1つのクラスターにつき最大100枚のクレジット表記付き写真が取得できます。これをプールテーブルに保存し、公開時に1ページにつき1枚ずつ割り当てます。1ページあたり画像4枚、月間1万ページ規模のサイトでも、必要なリクエスト数は4万回ではなくおよそ500回で済み、無料プラン(月5,000リクエスト)の範囲内に収まります。大量コンテンツ制作に最適なストックフォトAPIはどれですか?
同じストック写真が複数のページに表示されるのを防ぐにはどうすればよいですか?
photo_idを保存し、プールからの写真取得はトランザクション処理にします。SQLで言えばUPDATE … WHERE used_by_page IS NULL … FOR UPDATE SKIP LOCKEDのような形です。こうすることで重複排除は確率的なものではなく厳密なものになり、並列稼働するビルドワーカー同士が同じ上位ランクの写真を奪い合うことがなくなります。これはたった1つのカラムですが、後から数千のライブラリページに追加するよりも、初日から組み込んでおくほうがはるかにコストが低く済みます。1回のAPIリクエストで写真を何枚取得できますか?
per_page=100を使えば最大100枚まで取得でき、カーソルページネーションを使えば同じランク付けされた検索結果を辿り続けてさらに深いプールを作れます。score_thresholdと組み合わせれば、規模の小さいクラスターでも100枚の緩い一致ではなく40枚の強い一致を返せます。またfieldsを使えば、テンプレートが実際に描画する属性のみを返すようにでき、大量処理時のレスポンスを軽量に保てます。実写真を使うことで、大量生産されたページの検索順位は上がりますか?
AIエージェントが自動で画像プールを埋めることはできますか?
mcp.pexafy.com/mcpのMCP(Model Context Protocol)サーバーを通じて可能です。このサーバーはsearch_photos、search_photos_by_image、photo_similarを公開しています。クラスターのリストをエージェントに渡せば、それぞれについて1つずつカメラブリーフを作成し、プールを取得し、十分な強い一致が返ってこなかったブリーフにフラグを立てます――これはプログラマティックなイラスト化における実際の失敗パターンです。割り当て自体はスクリプト側に残しておくべきで、そこでは創造性よりも決定性の方が重要だからです。

