Ilustrasikan 10.000 Halaman per Bulan Dengan Foto Asli — dalam 500 Panggilan API
Cari sekali per klaster topik alih-alih sekali per gambar, dan 40.000 panggilan API menjadi 500. Pola pool-and-assign, worker yang tetap bertahan saat kena rate limit, dan bagian jujur tentang apa yang tidak bisa diperbaiki oleh foto.
 Marouane Tijani
12 menit baca

Ada satu versi dari masalah ilustrasi konten yang tidak bisa diselesaikan dengan selera yang baik sebanyak apa pun: Anda tidak sedang memilih satu foto, Anda sedang mengisi 40.000 slot gambar per bulan di 800 klaster topik, 9 locale dan 14 situs klien, dan setiap gambar harus berlisensi, diberi kredit, disesuaikan ukurannya dan berbeda dari yang di sebelahnya. Pada volume seperti itu pertanyaannya bukan lagi “foto yang mana?” melainkan “bagaimana arsitekturnya?”
Artikel ini adalah jawaban dari sisi API: pola permintaan yang menekan jumlah panggilan hingga dua orde besaran, worker yang tahan terhadap batas laju, deduplikasi yang mencegah situs 10.000 halaman terlihat seperti tembok foto stok yang sama — dan bagian yang jujur tentang apa yang tidak bisa dilakukan oleh gambar untuk Anda.
Titik hambat sesungguhnya pada 10.000 artikel
Tim yang melakukan publikasi dalam volume besar — properti SEO programatik, halaman kategori marketplace, agregator, jaringan afiliasi, agensi yang menjalankan konten untuk portofolio klien, pipeline lokalisasi yang mengubah satu artikel menjadi 20 — semuanya menabrak tiga tembok yang sama, dalam urutan yang sama:
- Jumlah panggilan. Satu pencarian per slot gambar berarti 40.000 panggilan API untuk 10.000 artikel berisi empat gambar. Setiap penyedia menetapkan harga, membatasi, dan meninjau Anda berdasarkan angka itu.
- Pengulangan. Sekitar halaman ketiga puluh, foto yang sama mulai muncul kembali. Pada halaman ke tiga ribu, situs Anda punya tanda tangan visual: dibuat secara massal.
- Koordinasi. Seratus artikel dalam satu klaster seharusnya terlihat seperti sebuah seri, bukan seratus board Pinterest yang tak berkaitan — dan locale berikutnya dari artikel yang sama seharusnya menggunakan kembali foto yang sama, bukan mencari lagi dalam bahasa lain.
Perhatikan apa yang tidak ada dalam daftar itu: menemukan foto yang bagus. Mesin semantik mengembalikan satu halaman kandidat yang bisa digunakan dalam sekitar 130 milidetik. Pengambilan (retrieval) sudah terpecahkan; distribusi belum. Semua yang di bawah ini membahas soal distribusi.
Mengapa foto asli, khususnya pada volume ini
Argumen untuk fotografi dibandingkan pembuatan gambar buatan menjadi lebih kuat seiring naiknya volume, karena alasan yang kebanyakan bersifat operasional, bukan estetika.
| Pada 40.000 gambar/bulan | Membuatnya (generating) | Mencarinya (searching) |
|---|---|---|
| Waktu per gambar | Detik hingga menit, ditambah percobaan yang ditolak | Satu permintaan (~130 md) mencakup satu klaster penuh |
| Pemicu biaya | Per gambar, selamanya | Per permintaan — dan satu permintaan melayani ~25 artikel |
| Metadata yang Anda dapat | Tidak ada. Anda menulis sendiri teks alt dan dimensinya | Dimensi, warna dominan, blur hash, draf keterangan, baris kredit |
| Provenans | Ditandai mesin sebagai sintetis di bawah EU AI Act sejak 2 Agustus 20261 | Seorang fotografer bernama, sebuah tanggal, sebuah URL sumber yang bisa dibuka pembaca |
| Mode kegagalan | Detail yang masuk akal tapi salah, gaya seragam yang khas | Tidak ada yang cocok dengan brief — Anda mendapat nol hasil, yang bisa Anda tangani |
Baris metadata adalah yang menentukan pipeline. Setiap hasil pencarian sudah membawa
width, height, blur_hash, color_hex,
alt_description dan string attribution.html yang sudah siap pakai — yang
persis merupakan payload yang dibutuhkan mesin templating untuk menghasilkan
<img> bebas layout-shift dengan placeholder dan kredit. Gambar hasil generate memberi Anda satu berkas dan
meninggalkan enam bidang lainnya untuk Anda ciptakan sendiri.
Di mana pembuatan gambar buatan masih unggul dalam skala besar. Ilustrasi tingkat kategori untuk taksonomi abstrak (“migrasi cloud”, “reksa dana indeks”), diagram, dan gaya khas yang ingin Anda ulangi di seluruh properti karena alasan brand. Pembagian yang diambil sebagian besar penerbit besar: fotografi untuk apa pun yang ada di dunia nyata, seni hasil generate untuk apa pun yang hanya ada dalam sebuah argumen. Kami membahas argumen lengkap untuk pembagian itu di cara mengilustrasikan setiap artikel yang Anda publikasikan.
Satu permintaan, seratus foto
Ini adalah perubahan tunggal yang membentuk ulang aritmatikanya. Endpoint pencarian menerima
per_page hingga 100, dan paginasi kursor memungkinkan Anda terus menelusuri
set hasil yang sama yang sudah diperingkat. Jadi unit kerjanya bukan sebuah gambar, melainkan sebuah pool.
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
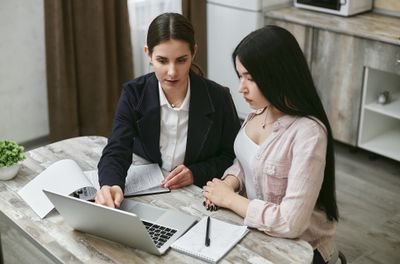
  --data-urlencode "q=a woman signing paperwork with an insurance agent at a kitchen table in her home" \
  --data-urlencode "per_page=100" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "score_threshold=0.5" \
  --data-urlencode "fields=photo_id,urls,width,height,blur_hash,alt_description,attribution"

# → { "success": true, "data": [ …hingga 100 foto… ],
#     "pagination": { "per_page": 100, "has_more": true, "next_cursor": "eyJyc…" },
#     "meta": { "took_ms": 122.33, "request_id": "7ff1fb9b-…" } }
Ada tiga parameter di situ yang diam-diam melakukan pekerjaan penting pada skala besar:
fields— sebuah sparse fieldset. Minta tujuh bidang yang dirender template Anda dan respons berhenti mengirimkan deskripsi AI yang panjang dari setiap foto. Untuk 40.000 foto itu bedanya antara build yang mengalir (streams) dan yang macet (swaps).score_threshold— ekor dari satu halaman berisi 100 hasil, menurut definisi, kurang relevan dibanding bagian atasnya. Menetapkan ambang batas berarti klaster yang tipis mengembalikan 34 foto alih-alih 100 foto biasa-biasa saja, dan pipeline Anda bisa bereaksi terhadap itu alih-alih mempublikasikannya.next_cursor— ketika sebuah klaster benar-benar membutuhkan 300 foto, lakukan paginasi pada set yang sama yang sudah diperingkat alih-alih menembakkan tiga kueri berbeda yang tumpang tindih.
Dan inilah aritmatikanya, untuk sebuah situs yang mempublikasikan 10.000 halaman per bulan dengan empat gambar masing-masing:
| Strategi | Permintaan / bulan | Satu putaran pada batas laju paket free20 req/menit | Muat dalam kuota bulanan free? |
|---|---|---|---|
| Satu pencarian per slot gambar | 40.000 | 33 hours | Tidak — perlu paket berbayar |
| Satu pencarian per artikel | 10.000 | 8 hours | Tidak — perlu paket berbayar |
| Satu pencarian per klaster berisi ~20 artikelpola dalam artikel ini | 500 | 25 minutes | Ya |
Ketiga baris tersebut sama-sama mempublikasikan 40.000 gambar. Satu-satunya yang berubah adalah di mana loop-nya berada.
Pool dan assign: pola yang bisa berskala
Seluruh arsitekturnya adalah dua fase yang berjalan pada frekuensi berbeda, dengan sebuah tabel di antaranya:
                     ┌─────────── berjalan mingguan, ~500 permintaan ────┐
  klaster topik ──▶  POOL   cari sekali per klaster, per_page=100
                     │       └─▶ simpan 100 baris foto per klaster
                     └──────────────────┬───────────────────────────────┘
                                        ▼
                              tabel image_pool
                        (cluster, photo_id, urls, blur_hash,
                         alt, credit, used_by_page, used_at)
                                        │
                     ┌──────────────────┴──── berjalan tiap publikasi, 0 permintaan ──┐
  artikel ─────────▶ ASSIGN  pilih baris belum terpakai terbaik untuk
                     │        klaster ini, tandai terpakai, render
                     └────────────────────────────────────────────────────────┘
Apa yang Anda dapatkan dari ini, diurutkan dari yang paling penting pada volume besar:
- Publikasi tidak pernah tersendat oleh API. Penetapan (assignment) adalah sebuah pembacaan database. Hook simpan CMS Anda, build statis Anda dan impor massal jam 3 pagi Anda semuanya berjalan pada kecepatan lokal, offline, tanpa batas laju di mana pun dalam alurnya.
- Deduplikasi gratis dan pasti (exact).
used_by_page IS NULLadalah seluruh fiturnya. Dua halaman tidak bisa mengambil foto yang sama, karena penetapan adalah sebuah transaksi, bukan sebuah heuristik peringkat. - Menjalankan ulang murah dan idempoten. Perbarui pool sebuah klaster ketika stoknya menipis
atau ketika Anda menginginkan fotografi yang lebih baru (
after_date, atausort_by=newest) — satu permintaan, dan tidak ada yang sudah dipublikasikan yang berubah. - Locale didapat secara gratis. 20 terjemahan dari sebuah artikel adalah satu halaman dalam
model Anda dengan 20 rendering; mereka berbagi
photo_idyang sama yang sudah ditetapkan dan Anda tidak perlu mencari dua kali. Ketika Anda memang menginginkan tampilan yang difoto secara lokal, jalankan kueri pool untuk klaster itu dalam bahasa targetnya — mesinnya menerima kalimat dalam lebih dari 100 bahasa.
Worker-nya, dalam kode
Kira-kira enam puluh baris. Pengisi pool (pool filler) adalah satu-satunya bagian yang berbicara ke jaringan, jadi ia
satu-satunya bagian yang perlu berhati-hati — konkurensi dibatasi, 429 dihormati, hasil
ditulis dalam satu transaksi.
import asyncio, os, time, httpx

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
KEY    = os.environ["PEXAFY_API_KEY"]
FIELDS = "photo_id,urls,width,height,blur_hash,alt_description,attribution"

# Free = 20 req/menit. Sisakan satu di bawahnya. Pacer bersifat GLOBAL: sleep per-task
# di dalam gate konkurensi akan membiarkan N worker menembak N× batas laju.
PER_MIN = 19
gate    = asyncio.Semaphore(4)         # koneksi yang sedang berjalan
_lock   = asyncio.Lock()
_slot   = 0.0                          # momen bebas berikutnya pada garis waktu bersama

async def pace():
    """Bagikan satu slot permintaan setiap 60/PER_MIN detik, untuk seluruh armada."""
    global _slot
    async with _lock:
        now  = time.monotonic()
        _slot = max(now, _slot) + 60 / PER_MIN
        wait  = _slot - now
    if wait > 0:
        await asyncio.sleep(wait)

class QuotaExhausted(Exception): ...   # bulanan: mengulang tidak akan membantu

async def fill_pool(client, cluster) -> list[dict]:
    """Satu permintaan → hingga 100 foto berkredit untuk satu klaster topik."""
    for attempt in range(4):
        await pace()
        async with gate:
            r = await client.get(
                SEARCH,
                headers={"X-Api-Key": KEY},
                params={
                    "q": cluster["camera_brief"],   # sebuah adegan, bukan kata kunci
                    "per_page": 100,
                    "orientation": "landscape",
                    "score_threshold": 0.5,
                    "fields": FIELDS,
                },
                timeout=15,
            )
        if r.status_code == 429:
            retry_after = r.headers.get("Retry-After")
            if retry_after is None:            # tanpa Retry-After ⇒ kuota bulanan,
                raise QuotaExhausted(cluster["id"])   # hentikan seluruh run
            await asyncio.sleep(int(retry_after))   # per menit: akan pulih
            continue
        r.raise_for_status()
        return r.json()["data"]
    return []                                  # catat ini; pool tetap pakai baris lamanya

async def refill(clusters):
    async with httpx.AsyncClient(http2=True) as client:
        pools = await asyncio.gather(*(fill_pool(client, c) for c in clusters))
    for cluster, photos in zip(clusters, pools):
        db.upsert_pool(cluster["id"], photos)     # ON CONFLICT DO NOTHING pada photo_id
Dua detail di situ adalah bedanya antara worker yang berjalan tanpa pengawasan dan worker yang
membangunkan Anda tengah malam. Pacer-nya bersifat global, bukan per-task: menaruh sleep di dalam
gate konkurensi adalah kesalahan klasik — empat worker yang masing-masing berhenti 3 detik setelah permintaan
mereka sendiri menghasilkan empat permintaan setiap 3 detik, kira-kira 75 per menit, dan paket free
langsung mulai mengembalikan 429. Dan kedua jenis 429 itu bukan hewan yang sama:
yang per-menit membawa Retry-After dan pulih sendiri, yang kuota-bulanan
tidak membawanya dan tidak akan pernah — mengulanginya adalah loop yang menabrak tembok.
Penetapan (assignment), bagian yang berjalan setiap kali publikasi, tidak pernah menyentuh jaringan:
# Keunikan ditegakkan oleh skema, bukan oleh kueri yang berhati-hati.
# Satu foto bisa berada di beberapa pool klaster; ia hanya boleh DIPUBLIKASIKAN sekali.
# CREATE UNIQUE INDEX one_use_per_photo ON image_pool (photo_id)
#        WHERE used_by_page IS NOT NULL;

def assign_hero(page_id: str, cluster_id: str) -> dict | None:
    for _ in range(5):                # kalah dalam race hanya mengambil foto berikutnya
        try:
            return db.query_one("""
                UPDATE image_pool p SET used_by_page = %s, used_at = NOW()
                WHERE p.id = (
                    SELECT c.id FROM image_pool c
                    WHERE c.cluster_id = %s AND c.used_by_page IS NULL
                      AND NOT EXISTS (              -- dipakai klaster LAIN mana pun?
                          SELECT 1 FROM image_pool u
                          WHERE u.photo_id = c.photo_id
                            AND u.used_by_page IS NOT NULL
                      )
                    ORDER BY c.rank ASC
                    LIMIT 1 FOR UPDATE SKIP LOCKED  -- aman dengan worker paralel
                )
                RETURNING photo_id, urls, width, height, blur_hash, alt, credit
            """, [page_id, cluster_id])
        except UniqueViolation:      # dua klaster mengklaimnya di milidetik yang sama
            continue
    return None                     # pool habis → perluas brief, isi ulang

# Rendering: setiap atribut berasal dari baris tersebut — tanpa layout shift, tanpa menebak.
# <img src="{urls[regular]}" width="{width}" height="{height}"
#      alt="{alt}" loading="lazy" style="background:{blur_placeholder}">
# <figcaption>{credit}</figcaption>
Dua mode kegagalan, dua mekanisme, dan keduanya dibutuhkan. FOR UPDATE SKIP LOCKED
menangani konkurensi di dalam satu klaster: hasilkan halaman secara paralel — dan pada volume ini
Anda akan melakukannya — dan dua worker meraih foto berperingkat teratas yang sama pada milidetik yang sama.
Indeks unik parsial menangani kasus yang biasa dilupakan semua orang: foto yang sama secara sah muncul
di pool beberapa klaster, karena klaster yang bertetangga (“asuransi rumah untuk
penyewa”, “…untuk pemilik yang menyewakan”) mengembalikan hasil yang tumpang tindih. Sebuah pemeriksaan per-klaster
used_by_page IS NULL buta terhadap hal itu — setiap klaster meyakini foto itu masih
bebas. NOT EXISTS menjaga kejujuran kueri, dan indeksnya membuat mustahil untuk
keliru di bawah konkurensi: pihak yang kalah dalam race mendapat pelanggaran (violation), mengulang, dan mengambil foto
berikutnya. Tanpanya, "tidak ada dua halaman yang berbagi hero" hanyalah klaim, bukan jaminan.
Ketika sebuah pool habis di tengah build, fallback yang berperilaku paling baik adalah memperluas alih-alih mengulang: buang klausa terakhir dari camera brief, jalankan ulang kueri pool sekali, dan baru gunakan kembali foto yang ditetapkan paling lama — dengan aturan tegas bahwa foto itu tidak pernah muncul di halaman dalam klaster yang sama.
Satu klaster, satu pool: sebuah kueri nyata
Ambil contoh properti perbandingan: asuransi rumah, dua puluh halaman — "asuransi rumah untuk penyewa", "…untuk pemilik yang menyewakan", "apa yang sebenarnya dicakup polis", dua belas halaman kota, tiga panduan klaim. Satu camera brief untuk klaster tersebut, satu permintaan, dan inilah bagian atas pool-nya, dikembalikan dalam 122 md:
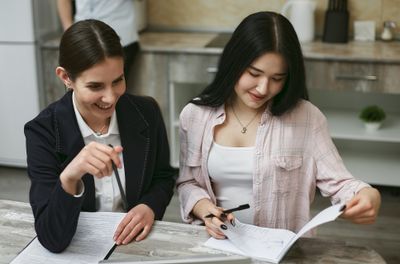
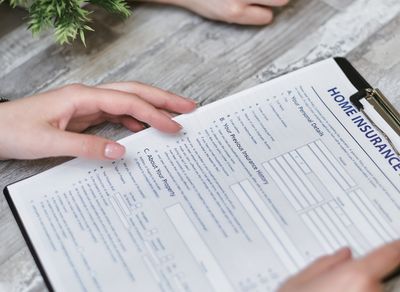
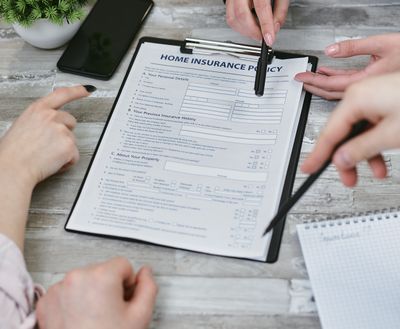
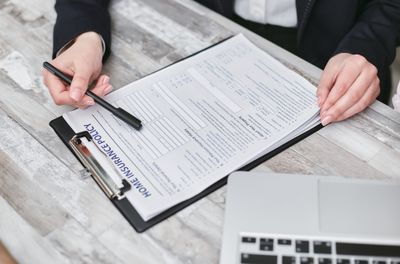
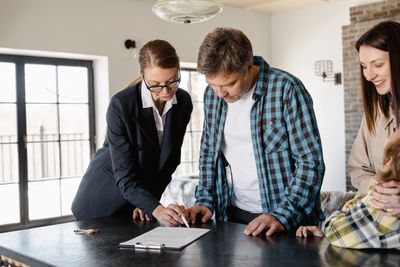
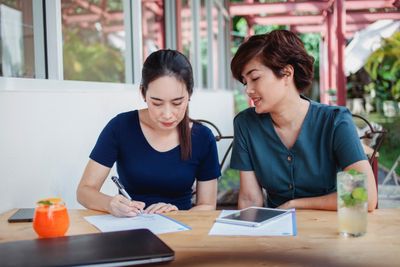
per_page=100 dan menyimpan sisanya.
Jalankan pencarian persis ini →
Brief-nya lebih penting daripada kodenya. Dua aturan yang bertahan ketika berhadapan dengan properti klaster yang nyata:
tulis brief untuk klaster, bukan untuk halaman (judul halaman hampir identik
di seluruh set programatik, jadi brief per-halaman mengembalikan foto yang hampir identik), dan gambarkan sebuah adegan
yang bisa diambil oleh kamera, bukan topiknya — asuransi rumah mengembalikan close-up
dokumen dan tidak ada yang lain. Kami mempublikasikan prompt yang siap salin-tempel yang menghasilkan brief semacam ini di
artikel tentang mengilustrasikan setiap post.
Menjaga konsistensi visual pada seri berisi 200 halaman
Kegagalan sebaliknya dari pengulangan adalah ketidaksesuaian: dua puluh halaman dalam satu klaster, masing-masing dengan
foto yang secara teknis benar, dalam dua puluh register visual yang berbeda. Perbaikannya adalah satu endpoint —
GET /photos/{id}/similar — dijalankan sekali pada foto yang Anda setujui untuk halaman pilar (pillar page):
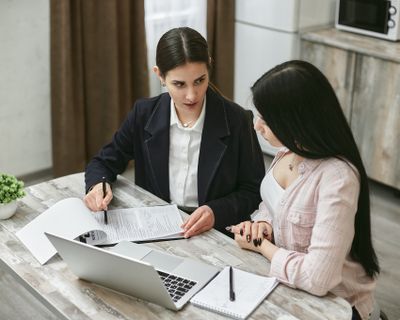
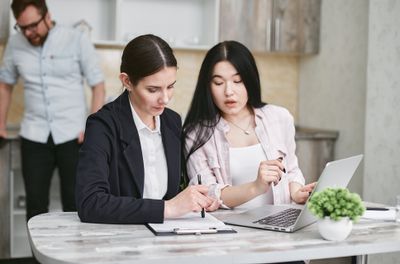
Dua tuas lagi yang layak disambungkan ke kueri pool ketika konsistensi brand menjadi syarat:
color_hex dengan color_tolerance menjaga seluruh properti tetap dalam
satu palet, dan photographer mengunci sebuah klaster pada karya satu fotografer tertentu. Keduanya
adalah parameter kueri biasa — tidak ada pembatasan paket pada filter pencarian.
Batas laju, kuota, dan biaya sesungguhnya
Pilih paket berdasarkan burst, bukan berdasarkan volume. Setelah Anda melakukan pooling, kuota bulanan berhenti menjadi batasan bagi hampir semua orang; yang menentukan paket Anda adalah seberapa cepat sebuah pembaruan penuh harus selesai.
| Paket | Permintaan / bulan= klaster yang bisa disegarkan | Batas laju | Kunci API | Segarkan 1.000 klasterwaktu nyata, satu putaran |
|---|---|---|---|---|
| Free — $0 | 5,000 | 20 / menit | 1 | 50 min |
| Starter — $5 | 25,000 | 30 / menit | 3 | 34 min |
| Pro — $19 | 100,000 | 60 / menit | 5 | 17 min |
| Team — $99agensi: satu kunci per klien | 500,000 | 200 / menit | 25 | 5 min |
| Business — $249 | 1,000,000 | 300 / menit | unlimited | 4 min |
| Enterprise — $599 | 2,000,000 | 500 / menit | unlimited | 2 min |
Baca kolom pertama sebagai klaster: satu permintaan pooling mengisi satu klaster, jadi kuota bulanan adalah jumlah klaster yang bisa Anda segarkan, dan kolom terakhir adalah berapa lama satu putaran penuh atas properti berisi 1.000 klaster akan berjalan pada batas laju paket tersebut. Keduanya adalah nilai langsung dari katalog harga — halaman harga menyatakan batas laju yang sama per jam, bukan per menit.
Jadi properti dengan 10.000 halaman per bulan yang memakai pola pooled hanya menghabiskan ~500 permintaan dan membayar nol rupiah. Yang mendorong tim naik ke paket lebih tinggi dalam tabel jarang sekali soal volume — biasanya salah satu dari tiga hal: pengilustrasian ulang penuh atas properti yang sudah ada dalam satu malam, isolasi kunci per-klien (sebuah agensi ingin satu kunci per klien agar penggunaan bisa diatribusikan tanpa akrobat rahasia bersama), atau jendela build yang diukur dalam menit alih-alih jam.
Dua detail operasional yang menyelamatkan Anda dari semalaman debugging. Setiap respons membawa
X-RateLimit-Limit dan X-RateLimit-Remaining, jadi sebuah worker bisa mengatur temponya sendiri
alih-alih menebak-nebak. Dan sebuah 429 yang benar-benar batas laju per-menit membawa
Retry-After, sementara blok kuota bulanan sengaja tidak membawanya — mengulanginya
tidak akan menghapus blok itu, dan sebuah worker yang membedakan keduanya berhenti menghantam terus endpoint
yang sudah tidak punya apa-apa lagi untuk diberikan.
Ketika agent yang melakukan publikasi
Jika konten Anda dihasilkan oleh sebuah agent — dan pada volume seperti ini semakin sering demikian — lapisan
pooling tidak menghilang, ia berpindah. Berikan agent tersebut tools pencarian dan ia akan mengisi pool sementara
ia masih memegang brief klaster dalam konteksnya, menggunakan server
Model Context Protocol di mcp.pexafy.com/mcp: tiga tools,
search_photos (sebuah kalimat), search_photos_by_image (sebuah gambar referensi,
opsional ditambah sebuah kalimat) dan get_similar_photos (yang untuk konsistensi seri, dari bagian di atas).
# Claude Code / CI runner
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# atau commit .mcp.json agar setiap worker di seluruh armada mewarisinya
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
Instruksi yang berhasil pada skala besar adalah instruksi batch, bukan per-artikel — dan itu memetakan satu-lawan-satu ke dua fase di atas:
You  Ini ada 12 klaster topik dari kalender konten. Untuk masing-masing,
     tulis satu camera brief, tarik 100 foto landscape, dan tulis
     pool-nya ke Postgres. Tandai klaster mana pun yang mengembalikan kurang
     dari 40 hasil di atas 0.5 — brief itu perlu ditulis ulang.

Agent  → search_photos(q="a woman signing paperwork with an insurance
           agent at a kitchen table in her home", orientation="landscape")
      ← 100 foto · 122 md · 87 di atas ambang batas
      … 11 klaster lainnya …

      ✓ 11 pool ditulis (1.043 foto, semuanya berkredit)
      ⚠ "rebalancing reksa dana indeks" → 12 hasil. Brief-nya abstrak;
        saran: "seseorang di meja dapur memeriksa angka-angka di
        laptop dengan buku catatan dan kopi di sampingnya"
Baris terakhir itulah alasan untuk menempatkan agent pada loop ini alih-alih skrip: mode kegagalan dari ilustrasi programatik adalah brief yang buruk, dan brief yang buruk adalah persis hal yang bisa diperhatikan dan ditulis ulang oleh sebuah language model. Skrip tetap mengendalikan penetapan (assignment), di mana determinisme penting dan kreativitas tidak.
Apa yang tidak bisa diperbaiki oleh foto
Bagian yang jujur, karena kegagalan yang digambarkannya mahal harganya. Fotografi asli yang berkredit memperbaiki sebuah halaman. Ia tidak mengubah konten tipis menjadi konten bagus, dan tidak ada pipeline gambar yang mengubah cara mesin pencari memperlakukan halaman yang diproduksi massal yang ada untuk mendapat peringkat, bukan untuk membantu. Kebijakan spam Google menyebut ini secara langsung: penyalahgunaan konten berskala (scaled content abuse) mencakup pembuatan banyak halaman dengan sedikit nilai baik otomasi terlibat maupun tidak, dan ilustrasi pada halaman-halaman itu tidak relevan dengan penilaian tersebut.2
Jadi kerangka berpikir yang berguna itu sempit dan benar: fotografi adalah sinyal kualitas yang Anda kendalikan pada halaman yang memang sudah layak untuk ada. Di mana hal ini terbukti membuahkan hasil:
- Provenans yang bisa diverifikasi pembaca. Baris kredit dengan nama fotografer dan URL sumber adalah klaim yang bisa diperiksa — kebalikan dari gambar tanpa atribusi pada halaman dengan penulis tanpa atribusi.
- Aksesibilitas dan Core Web Vitals.
width/heightdari respons menghilangkan layout shift,blur_hashmemberikan placeholder yang nyata, danalt_descriptionadalah draf teks alt yang bisa ditingkatkan oleh template Anda alih-alih diciptakan sendiri. Kalikan dengan 40.000 slot dan inilah seluruh kisah kualitas gambar situs tersebut. - Tidak terlihat diproduksi massal. Deduplikasi dan konsistensi seri adalah yang mencegah sebuah properti memiliki tanda tangan visual. Itu adalah biaya persepsi yang nyata dengan konsekuensi nyata, dan sepenuhnya berada dalam kendali Anda.
Dan lisensi tetap mengatur gambarnya. Atribusi tidak diwajibkan oleh ketentuan API Pexafy —
setiap hasil sudah dilengkapi attribution.html dan attribution.plain yang siap
dirender — tetapi lisensi yang melekat dari pustaka asli tetap berlaku untuk penggunaan Anda atas foto itu, dan
pada 40.000 gambar per bulan, merender kredit secara otomatis lebih murah daripada mengauditnya belakangan.
Di mana harus mulai pada hari Senin
- Kelompokkan backlog Anda menjadi klaster berisi 15–30 halaman yang secara masuk akal bisa berbagi satu sesi pemotretan. Ini satu-satunya langkah yang benar-benar manual, dan bentuknya spreadsheet, bukan proyek.
- Tulis satu camera brief per klaster — sebuah adegan, 12 hingga 25 kata. Hasilkan brief itu dengan sebuah model, lalu bacalah; brief yang menyebut topik alih-alih adegan langsung terlihat sekilas.
- Isi satu pool dengan satu permintaan
per_page=100dan periksa bagian atasnya secara langsung. Jika sepuluh teratas tidak bisa dipakai, brief-nya yang salah — bukan mesinnya. - Tambahkan kolom
used_by_pagesebelum Anda mempublikasikan apa pun. Ini lima menit sekarang dan sebuah migrasi lintas 3.000 halaman aktif nantinya. - Jalankan semuanya pada paket free sampai sebuah jendela build memaksa Anda naik. Pada 500 permintaan per bulan, itu akan memakan waktu cukup lama.
Referensi & catatan kaki
1 EU AI Act, Pasal 50 — kewajiban transparansi yang berlaku sejak 2 Agustus 2026: penyedia sistem yang menghasilkan gambar, audio, video atau teks sintetis harus menandai output-nya dalam format yang dapat dibaca mesin dan membuatnya dapat dideteksi sebagai buatan artifisial. Ini mengikat penyedia dan penyebar AI; ini bukan aturan tentang gambar mana yang boleh dipublikasikan oleh sebuah situs web.
2 Kebijakan spam Google Search — scaled content abuse: membuat banyak halaman terutama untuk memanipulasi peringkat dan menawarkan sedikit nilai bagi pengguna, baik dibuat melalui otomasi, usaha manusia atau kombinasi keduanya. Kualitas ilustrasi bukan faktor dalam penilaian tersebut, dan itulah persisnya alasan artikel ini memisahkan keduanya.
Sumber diperiksa pada 17 Agustus 2026: Kebijakan spam Google Search · AI Act Pasal 50 · Dokumentasi API & MCP Pexafy. Batas paket adalah nilai langsung dari tabel harga Pexafy; waktu pencarian (122 md, 48 md) dan setiap foto yang ditampilkan adalah respons API nyata yang diambil pada hari yang sama.
Pertanyaan yang sering diajukan
Bagaimana cara mendapatkan gambar untuk ribuan halaman SEO programatik?
GET /api/v1/search/photos dengan per_page=100 mengembalikan hingga 100 foto berkredit untuk satu klaster; Anda menyimpannya dalam tabel pool dan menetapkan satu foto per halaman saat dipublikasikan. Estate dengan 10.000 halaman per bulan dan empat gambar per halaman hanya membutuhkan sekitar 500 request, bukan 40.000, yang masih masuk dalam paket gratis (5.000 request/bulan).Apa API foto stok terbaik untuk produksi konten volume tinggi?
Bagaimana cara mencegah foto stok yang sama muncul di beberapa halaman?
photo_id dari setiap gambar yang dipublikasikan dan klaim foto dari pool secara transaksional — dalam SQL, gunakan UPDATE … WHERE used_by_page IS NULL … FOR UPDATE SKIP LOCKED. Deduplikasi kemudian menjadi eksak, bukan probabilistik, dan worker build paralel tidak akan berebut foto berperingkat teratas yang sama. Ini hanya satu kolom, dan menerapkannya ulang pada ribuan halaman yang sudah live jauh lebih mahal ketimbang menambahkannya sejak hari pertama.Berapa banyak foto yang bisa dikembalikan oleh satu request API?
per_page=100, dan cursor pagination memungkinkan Anda terus menjelajahi hasil pencarian berperingkat yang sama untuk pool yang lebih dalam. Kombinasikan dengan score_threshold agar klaster yang tipis mengembalikan 40 kecocokan kuat daripada 100 kecocokan yang longgar, dan dengan fields untuk hanya mengembalikan atribut yang dirender oleh template Anda, sehingga respons tetap kecil dalam volume besar.Apakah foto asli membantu halaman yang diproduksi dalam skala besar meraih ranking lebih baik?
Bisakah agen AI mengisi pool gambar secara otomatis?
mcp.pexafy.com/mcp, yang menyediakan search_photos, search_photos_by_image, dan photo_similar. Berikan agen daftar klaster dan ia akan menulis satu brief kamera untuk masing-masing, menarik pool-nya, dan menandai brief yang mengembalikan terlalu sedikit kecocokan kuat — yang merupakan mode kegagalan sebenarnya dari ilustrasi programatik. Penetapan (assignment) tetap berada di skrip Anda, tempat determinisme lebih penting daripada kreativitas.

