Illustrer 10 000 pages par mois avec de vraies photos — en 500 appels API
Cherchez une fois par cluster thématique plutôt qu'une fois par image, et 40 000 appels API deviennent 500. Le pattern « pool et attribution », le worker qui survit aux limites de débit, et une section honnête sur ce que les photographies ne peuvent pas corriger.
 Marouane Tijani
12 min de lecture

Il existe une version du problème de l'illustration de contenu qu'aucun bon goût ne résout : vous ne choisissez pas une photo, vous remplissez 40 000 emplacements d'images par mois sur 800 clusters thématiques, 9 langues et 14 sites clients, et chacun doit être sous licence, crédité, dimensionné et différent de son voisin. À ce volume, la question n'est plus « quelle photo ? » mais « quelle architecture ? »
Cet article est la réponse côté API : le schéma de requêtes qui divise le nombre d'appels par deux ordres de grandeur, le worker qui survit aux limites de débit, la déduplication qui empêche un site de 10 000 pages de ressembler à un mur de la même photo de banque — et une section honnête sur ce que les images ne peuvent pas faire pour vous.
Le vrai goulot d'étranglement à 10 000 articles
Les équipes qui publient en volume — parcs de SEO programmatique, pages catégories de places de marché, agrégateurs, réseaux d'affiliation, agences gérant le contenu d'un portefeuille de clients, pipelines de localisation transformant un article en 20 — se heurtent toutes aux mêmes trois murs, dans le même ordre :
- Le nombre d'appels. Une recherche par emplacement d'image, c'est 40 000 appels API pour 10 000 articles à quatre images. Chaque fournisseur vous facture, vous limite et vous évalue sur ce chiffre.
- La répétition. Vers la trentième page, la même photo commence à réapparaître. À la trois millième, votre site a une signature visuelle : généré en masse.
- La coordination. Cent articles d'un même cluster doivent ressembler à une série, pas à cent tableaux Pinterest sans rapport — et la version suivante du même article dans une autre langue doit réutiliser la même image, pas relancer une recherche dans une autre langue.
Remarquez ce qui n'est pas dans cette liste : trouver une bonne photo. Un moteur sémantique renvoie une page de candidats exploitables en environ 130 millisecondes. La recherche est résolue ; la distribution ne l'était pas. Tout ce qui suit porte sur la distribution.
Pourquoi de vraies photos, précisément à ce volume
L'argument en faveur de la photographie plutôt que de la génération devient plus fort à mesure que le volume augmente, pour des raisons surtout opérationnelles plutôt qu'esthétiques.
| À 40 000 images/mois | Les générer | Les rechercher |
|---|---|---|
| Temps par image | De quelques secondes à quelques minutes, plus les essais rejetés | Une requête (~130 ms) couvre tout un cluster |
| Facteur de coût | Par image, à perpétuité | Par requête — et une requête sert ~25 articles |
| Métadonnées obtenues | Aucune. Vous écrivez vous-même le texte alternatif et les dimensions | Dimensions, couleur dominante, blur hash, brouillon de légende, ligne de crédit |
| Provenance | Marquées comme synthétiques en lecture machine au titre de l'AI Act européen depuis le 2 août 20261 | Un photographe nommé, une date, une URL source qu'un lecteur peut ouvrir |
| Mode d'échec | Détails plausibles mais faux, style maison uniforme | Rien ne correspondait au brief — vous obtenez zéro résultat, ce que vous pouvez traiter |
La ligne des métadonnées est celle qui tranche pour les pipelines. Chaque résultat de recherche porte déjà
width, height, blur_hash, color_hex,
alt_description et une chaîne attribution.html prête à l'emploi — c'est
exactement la charge utile dont un moteur de templates a besoin pour produire une
<img> sans décalage de mise en page, avec un placeholder et un crédit. Les images générées vous donnent un fichier et
vous laissent inventer les six autres champs.
Là où la génération l'emporte encore à grande échelle. L'illustration au niveau catégorie pour des taxonomies abstraites (« migration vers le cloud », « fonds indiciels »), les schémas, et un style maison que vous voulez répéter sur tout un parc pour des raisons de marque. Le partage sur lequel atterrissent la plupart des grands éditeurs : la photographie pour tout ce qui existe dans le monde, l'illustration générée pour tout ce qui n'existe que dans un raisonnement. Nous avons exposé cet argument en détail dans comment illustrer chaque article que vous publiez.
Une requête, cent photos
C'est le seul changement qui reconfigure l'arithmétique. Le endpoint de recherche accepte
per_page jusqu'à 100, et la pagination par curseur vous laisse parcourir
le même ensemble de résultats classés. L'unité de travail n'est donc pas une image, c'est un pool.
curl -sG "https://api.pexafy.com/api/v1/search/photos" \
  -H "X-Api-Key: $PEXAFY_API_KEY" \
  --data-urlencode "q=a woman signing paperwork with an insurance agent at a kitchen table in her home" \
  --data-urlencode "per_page=100" \
  --data-urlencode "orientation=landscape" \
  --data-urlencode "score_threshold=0.5" \
  --data-urlencode "fields=photo_id,urls,width,height,blur_hash,alt_description,attribution"

# → { "success": true, "data": [ …jusqu'à 100 photos… ],
#     "pagination": { "per_page": 100, "has_more": true, "next_cursor": "eyJyc…" },
#     "meta": { "took_ms": 122.33, "request_id": "7ff1fb9b-…" } }
Trois paramètres y font un travail discret à grande échelle :
fields— un jeu de champs restreint. Demandez les sept champs que votre template affiche et la réponse cesse d'embarquer la longue description IA de chaque photo. Sur 40 000 photos, c'est la différence entre un build qui coule et un build qui swappe.score_threshold— la queue d'une page de 100 résultats est, par définition, moins pertinente que la tête. Poser un plancher signifie qu'un cluster maigre renvoie 34 photos au lieu de 100 médiocres, et votre pipeline peut y réagir au lieu de le publier.next_cursor— quand un cluster a réellement besoin de 300 photos, paginez le même ensemble classé plutôt que de lancer trois requêtes différentes qui se recoupent.
Et voici l'arithmétique, pour un site publiant 10 000 pages par mois avec quatre images chacune :
| Stratégie | Requêtes / mois | Un passage à la limite de débit du plan gratuit20 req/min | Tient dans le quota mensuel gratuit ? |
|---|---|---|---|
| Une recherche par emplacement d'image | 40 000 | 33 hours | Non — un plan payant |
| Une recherche par article | 10 000 | 8 hours | Non — un plan payant |
| Une recherche par cluster d'environ 20 articlesle schéma décrit dans cet article | 500 | 25 minutes | Oui |
Les mêmes 40 000 images publiées dans les trois lignes. La seule chose qui change, c'est l'endroit où se trouve la boucle.
Mutualiser et attribuer : le schéma qui passe à l'échelle
Toute l'architecture tient en deux phases qui s'exécutent à des fréquences différentes, avec une table entre elles :
                     ┌────── s'exécute chaque semaine, ~500 requêtes ────┐
  clusters ────────▶ POOL   une recherche par cluster, per_page=100
                     │       └─▶ stocke 100 lignes photo par cluster
                     └──────────────────┬───────────────────────────────┘
                                        ▼
                              table image_pool
                        (cluster, photo_id, urls, blur_hash,
                         alt, credit, used_by_page, used_at)
                                        │
                     ┌──────────────────┴─ à chaque publication, 0 requête ───┐
  article ─────────▶ ASSIGN  choisit la meilleure ligne libre pour ce
                     │        cluster, la marque utilisée, rend la page
                     └────────────────────────────────────────────────────────┘
Ce que cela vous apporte, par ordre d'importance à grande échelle :
- La publication ne dépend jamais d'une API. L'attribution est une lecture en base. Votre hook de sauvegarde CMS, votre build statique et votre import massif de 3 h du matin tournent tous à la vitesse locale, hors ligne, sans aucune limite de débit sur le chemin.
- La déduplication est gratuite et exacte.
used_by_page IS NULL, c'est toute la fonctionnalité. Deux pages ne peuvent pas tirer la même photo, parce que l'attribution est une transaction, pas une heuristique de classement. - Les relances sont peu coûteuses et idempotentes. Rafraîchissez le pool d'un cluster quand il s'épuise
ou quand vous voulez des photos plus récentes (
after_date, ousort_by=newest) — une requête, et rien de déjà publié ne bouge. - Les langues viennent gratuitement. Les 20 traductions d'un article forment une seule page dans
votre modèle avec 20 rendus ; elles partagent le
photo_idattribué et vous ne cherchez jamais deux fois. Quand vous voulez un rendu tourné localement, lancez la requête de pool pour ce cluster dans la langue cible — le moteur accepte une phrase dans plus de 100 langues.
Le worker, en code
Une soixantaine de lignes. Le remplisseur de pool est la seule partie qui parle au réseau, c'est donc la
seule qui doit être prudente — concurrence plafonnée, 429 respecté, résultats
écrits en une seule transaction.
import asyncio, os, time, httpx

SEARCH = "https://api.pexafy.com/api/v1/search/photos"
KEY    = os.environ["PEXAFY_API_KEY"]
FIELDS = "photo_id,urls,width,height,blur_hash,alt_description,attribution"

# Free = 20 req/min. Restez juste en dessous. Le régulateur est GLOBAL : un sleep par tâche
# dans le verrou de concurrence laisserait N workers tirer N× le débit.
PER_MIN = 19
gate    = asyncio.Semaphore(4)         # connexions en vol
_lock   = asyncio.Lock()
_slot   = 0.0                          # prochain instant libre sur la timeline partagée

async def pace():
    """Distribue un créneau de requête toutes les 60/PER_MIN secondes, pour toute la flotte."""
    global _slot
    async with _lock:
        now  = time.monotonic()
        _slot = max(now, _slot) + 60 / PER_MIN
        wait  = _slot - now
    if wait > 0:
        await asyncio.sleep(wait)

class QuotaExhausted(Exception): ...   # mensuel : réessayer n'aide pas

async def fill_pool(client, cluster) -> list[dict]:
    """Une requête → jusqu'à 100 photos créditées pour un cluster."""
    for attempt in range(4):
        await pace()
        async with gate:
            r = await client.get(
                SEARCH,
                headers={"X-Api-Key": KEY},
                params={
                    "q": cluster["camera_brief"],   # une scène, pas le mot-clé
                    "per_page": 100,
                    "orientation": "landscape",
                    "score_threshold": 0.5,
                    "fields": FIELDS,
                },
                timeout=15,
            )
        if r.status_code == 429:
            retry_after = r.headers.get("Retry-After")
            if retry_after is None:            # pas de Retry-After ⇒ quota mensuel,
                raise QuotaExhausted(cluster["id"])   # arrête tout le run
            await asyncio.sleep(int(retry_after))   # par minute : ça se libère
            continue
        r.raise_for_status()
        return r.json()["data"]
    return []                                  # loggez ; le pool garde ses anciennes lignes

async def refill(clusters):
    async with httpx.AsyncClient(http2=True) as client:
        pools = await asyncio.gather(*(fill_pool(client, c) for c in clusters))
    for cluster, photos in zip(clusters, pools):
        db.upsert_pool(cluster["id"], photos)     # ON CONFLICT DO NOTHING sur photo_id
Deux détails y font la différence entre un worker qui tourne sans surveillance et un worker qui
vous réveille. Le régulateur est global, pas par tâche : placer le sleep à l'intérieur du
verrou de concurrence est l'erreur classique — quatre workers qui font chacun une pause de 3 secondes après leur
propre requête produisent quatre requêtes toutes les 3 secondes, soit environ 75 par minute, et le plan gratuit
se met à renvoyer 429 immédiatement. Et les deux 429 ne sont pas le même
animal : celui de la limite par minute porte Retry-After et se résorbe seul, celui du quota mensuel
ne le porte pas et ne le portera jamais — le réessayer, c'est boucler contre un mur.
L'attribution, la partie qui s'exécute à chaque publication, ne touche jamais au réseau :
# L'unicité est garantie par le schéma, pas par une requête prudente.
# Une photo peut figurer dans plusieurs pools ; elle ne peut être PUBLIÉE qu'une fois.
# CREATE UNIQUE INDEX one_use_per_photo ON image_pool (photo_id)
#        WHERE used_by_page IS NOT NULL;

def assign_hero(page_id: str, cluster_id: str) -> dict | None:
    for _ in range(5):                # une course perdue prend juste la photo suivante
        try:
            return db.query_one("""
                UPDATE image_pool p SET used_by_page = %s, used_at = NOW()
                WHERE p.id = (
                    SELECT c.id FROM image_pool c
                    WHERE c.cluster_id = %s AND c.used_by_page IS NULL
                      AND NOT EXISTS (              -- utilisée par un AUTRE cluster ?
                          SELECT 1 FROM image_pool u
                          WHERE u.photo_id = c.photo_id
                            AND u.used_by_page IS NOT NULL
                      )
                    ORDER BY c.rank ASC
                    LIMIT 1 FOR UPDATE SKIP LOCKED  -- sûr avec des workers parallèles
                )
                RETURNING photo_id, urls, width, height, blur_hash, alt, credit
            """, [page_id, cluster_id])
        except UniqueViolation:      # deux clusters l'ont réclamée à la même ms
            continue
    return None                     # pool à sec → élargir le brief, recharger

# Rendu : chaque attribut vient de la ligne — pas de décalage, pas de devinette.
# <img src="{urls[regular]}" width="{width}" height="{height}"
#      alt="{alt}" loading="lazy" style="background:{blur_placeholder}">
# <figcaption>{credit}</figcaption>
Deux modes d'échec, deux mécanismes, et les deux sont nécessaires. FOR UPDATE SKIP LOCKED
gère la concurrence à l'intérieur d'un cluster : générez des pages en parallèle — et à ce volume
vous le ferez — et deux workers atteignent la même photo la mieux classée à la même milliseconde.
L'index unique partiel gère celui que tout le monde oublie : la même photo apparaît légitimement
dans les pools de plusieurs clusters, parce que des clusters voisins (« assurance habitation pour
locataires », « …pour propriétaires bailleurs ») renvoient des résultats qui se recoupent. Un test
used_by_page IS NULL par cluster est aveugle à cela — chaque cluster croit la photo
libre. Le NOT EXISTS maintient la requête honnête, et l'index rend l'erreur impossible
en concurrence : le perdant de la course reçoit une violation, réessaie et prend la photo
suivante. Sans lui, « aucune paire de pages ne partage la même image d'en-tête » est une affirmation, pas une garantie.
Quand un pool s'assèche en cours de build, le repli le plus sain est d'élargir plutôt que de répéter : supprimez la dernière clause du brief photographique, relancez une fois la requête de pool, et seulement ensuite réutilisez la photo attribuée le plus anciennement — avec une règle stricte : elle ne doit jamais atterrir sur une page du même cluster.
Un cluster, un pool : une vraie requête
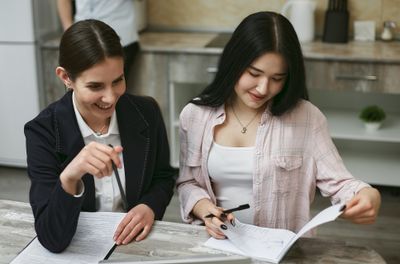
Prenons un parc comparatif : assurance habitation, vingt pages — « assurance habitation pour locataires », « …pour propriétaires bailleurs », « ce que couvre réellement un contrat », douze pages villes, trois guides de sinistre. Un brief photographique pour le cluster, une requête, et voici la tête du pool, renvoyée en 122 ms :
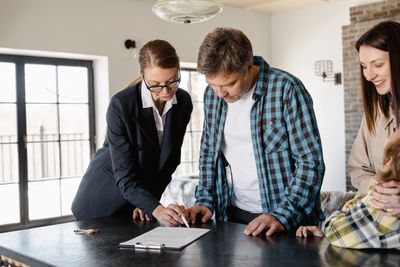
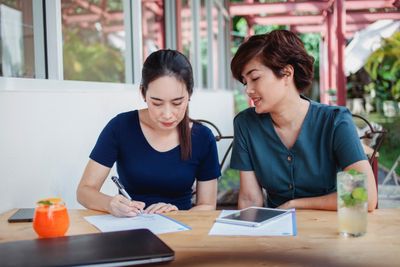
per_page=100 et conserve le reste.
Lancer exactement cette recherche →
Les briefs comptent plus que le code. Deux règles survivent au contact d'un vrai parc de clusters :
écrivez le brief pour le cluster, pas pour la page (les titres de pages sont quasi identiques
dans les ensembles programmatiques, donc des briefs par page renvoient des photos quasi identiques), et décrivez une scène
qu'un appareil photo aurait pu capturer plutôt que le sujet — home insurance renvoie des gros plans de
documents et rien d'autre. Nous avons publié le prompt prêt à copier-coller qui produit ces briefs dans
l'article sur l'illustration de chaque publication.
Garder une série de 200 pages visuellement cohérente
L'échec inverse de la répétition, c'est l'incohérence : vingt pages dans un cluster, chacune avec une
photo techniquement correcte, dans vingt registres visuels différents. La solution tient en un endpoint —
GET /photos/{id}/similar — exécuté une fois sur la photo validée pour la page pilier :
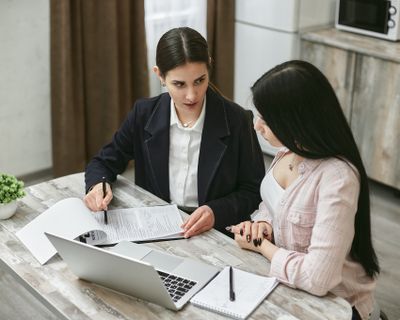
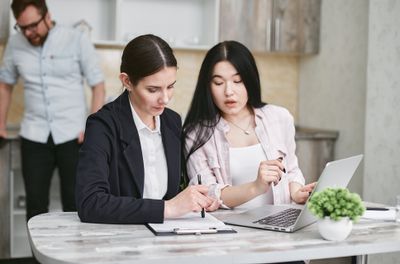
Deux autres leviers à câbler dans la requête de pool quand la cohérence de marque est une exigence :
color_hex avec un color_tolerance maintient tout un parc dans une
palette, et photographer rattache un cluster au travail d'un seul photographe. Les deux
sont des paramètres de requête ordinaires — aucun filtre de recherche n'est réservé à un plan.
Limites de débit, quotas et coût réel
Choisissez le plan sur la rafale, pas sur le volume. Une fois la mutualisation en place, le quota mensuel cesse d'être la contrainte pour presque tout le monde ; ce qui décide de votre plan, c'est la vitesse à laquelle un rafraîchissement complet doit se terminer.
| Plan | Requêtes / mois= clusters rafraîchissables | Limite de débit | Clés API | Rafraîchir 1 000 clusterstemps réel, un passage |
|---|---|---|---|---|
| Free — $0 | 5,000 | 20 / min | 1 | 50 min |
| Starter — $5 | 25,000 | 30 / min | 3 | 34 min |
| Pro — $19 | 100,000 | 60 / min | 5 | 17 min |
| Team — $99agences : une clé par client | 500,000 | 200 / min | 25 | 5 min |
| Business — $249 | 1,000,000 | 300 / min | unlimited | 4 min |
| Enterprise — $599 | 2,000,000 | 500 / min | unlimited | 2 min |
Lisez la première colonne comme des clusters : une requête de mutualisation remplit un cluster, donc le quota mensuel correspond au nombre de clusters que vous pouvez rafraîchir, et la dernière colonne indique la durée d'un passage complet sur un parc de 1 000 clusters à la limite de débit de ce plan. Les deux sont des valeurs en direct issues du catalogue tarifaire — la page de tarifs indique les mêmes limites par heure plutôt que par minute.
Ainsi, un parc de 10 000 pages par mois sur le schéma mutualisé dépense ~500 requêtes et ne paie rien. Ce qui fait monter les équipes dans le tableau, c'est rarement le volume — c'est l'une de trois choses : une réillustration complète d'un parc existant en une nuit, l'isolation des clés par client (une agence veut une clé par client pour que l'usage soit attribuable sans gymnastique de secrets partagés), ou une fenêtre de build mesurée en minutes plutôt qu'en heures.
Deux détails opérationnels qui épargnent une nuit de débogage. Chaque réponse porte
X-RateLimit-Limit et X-RateLimit-Remaining, si bien qu'un worker peut se réguler
au lieu de deviner. Et un 429 qui est une vraie limite par minute porte
Retry-After, tandis qu'un blocage de quota mensuel ne le porte délibérément pas — réessayer
ne débloquera pas celui-là, et un worker qui distingue les deux cesse de marteler un endpoint
qui n'a plus rien à donner.
Quand c'est l'agent qui publie
Si votre contenu est produit par un agent — et à ces volumes, c'est de plus en plus le cas — la couche de mutualisation
ne disparaît pas, elle se déplace. Donnez à l'agent les outils de recherche et il remplit le pool pendant
qu'il a encore le brief du cluster en contexte, via le serveur
Model Context Protocol à l'adresse mcp.pexafy.com/mcp : trois outils,
search_photos (une phrase), search_photos_by_image (une image de référence,
éventuellement accompagnée d'une phrase) et get_similar_photos (celui de la cohérence de série, vu plus haut).
# Claude Code / runner CI
claude mcp add --transport http pexafy https://mcp.pexafy.com/mcp \
  --header "Authorization: Bearer $PEXAFY_API_KEY"

# ou committez .mcp.json pour que chaque worker de la flotte en hérite
{
  "mcpServers": {
    "pexafy": {
      "type": "http",
      "url": "https://mcp.pexafy.com/mcp",
      "headers": { "Authorization": "Bearer YOUR_API_KEY" }
    }
  }
}
L'instruction qui fonctionne à l'échelle est une instruction par lots, pas une instruction par article — et elle correspond exactement aux deux phases ci-dessus :
You  Voici 12 clusters thématiques du calendrier éditorial. Pour chacun,
     écris un brief photographique, récupère 100 photos paysage, et écris
     le pool dans Postgres. Signale tout cluster qui renvoie moins de 40
     résultats au-dessus de 0,5 — ces briefs sont à réécrire.

Agent  → search_photos(q="a woman signing paperwork with an insurance
           agent at a kitchen table in her home", orientation="landscape")
      ← 100 photos · 122 ms · 87 au-dessus du seuil
      … 11 autres clusters …

      ✓ 11 pools écrits (1 043 photos, toutes créditées)
      ⚠ « index fund rebalancing » → 12 résultats. Le brief est abstrait ;
        suggestion : « a person at a kitchen table checking figures on a
        laptop with a notebook and coffee beside them »
Cette dernière ligne est la raison de mettre l'agent dans cette boucle plutôt qu'un script : le mode d'échec de l'illustration programmatique est un mauvais brief, et un mauvais brief est exactement ce qu'un modèle de langage sait repérer et réécrire. Les scripts restent maîtres de l'attribution, où le déterminisme compte et la créativité non.
Ce que les photographies ne peuvent pas corriger
Une section honnête, parce que l'échec qu'elle décrit coûte cher. Une photographie réelle et créditée améliore une page. Elle ne transforme pas un contenu creux en bon contenu, et aucun pipeline d'images ne change la façon dont les moteurs de recherche traitent les pages produites en masse qui existent pour se positionner plutôt que pour aider. Les règles anti-spam de Google le nomment directement : l'abus de contenu à grande échelle couvre la génération de nombreuses pages à faible valeur que l'automatisation soit impliquée ou non, et les illustrations de ces pages sont sans effet sur ce jugement.2
Le cadrage utile est donc étroit et exact : la photographie est un signal de qualité que vous contrôlez sur des pages qui méritent déjà d'exister. Là où cela paie de façon démontrable :
- Une provenance qu'un lecteur peut vérifier. Une ligne de crédit avec le nom d'un photographe et une URL source est une affirmation vérifiable — l'inverse d'une image non attribuée sur une page à l'auteur non attribué.
- Accessibilité et Core Web Vitals.
width/heightissus de la réponse suppriment le décalage de mise en page,blur_hashdonne un vrai placeholder, etalt_descriptionest un brouillon de texte alternatif que votre template peut améliorer plutôt qu' inventer. Multipliez par 40 000 emplacements et c'est toute l'histoire de la qualité d'image du site. - Ne pas avoir l'air produit en masse. La déduplication et la cohérence de série sont ce qui empêche un parc d'avoir une signature visuelle. C'est un coût de perception réel avec des conséquences réelles, et il est entièrement sous votre contrôle.
Et la licence continue de régir l'image. L'attribution n'est pas exigée par les conditions de l'API Pexafy —
chaque résultat livre attribution.html et attribution.plain prêts à
afficher — mais la licence attachée par la bibliothèque d'origine s'applique à votre usage de cette photo, et
à 40 000 images par mois, afficher le crédit automatiquement coûte moins cher qu'un audit plus tard.
Par où commencer lundi
- Regroupez votre backlog en clusters de 15 à 30 pages qui pourraient plausiblement partager une même séance photo. C'est la seule étape réellement manuelle, et c'est un tableur, pas un projet.
- Écrivez un brief photographique par cluster — une scène, de 12 à 25 mots. Générez-les avec un modèle, puis relisez-les ; les briefs qui nomment un sujet au lieu d'une scène se repèrent d'un coup d'œil.
- Remplissez un pool avec une seule requête
per_page=100et inspectez sa tête. Si les dix premiers ne sont pas exploitables, c'est le brief qui est faux — pas le moteur. - Ajoutez la colonne
used_by_pageavant de publier quoi que ce soit. C'est cinq minutes maintenant et une migration sur 3 000 pages en production plus tard. - Faites tourner l'ensemble sur le plan gratuit jusqu'à ce qu'une fenêtre de build vous oblige à monter. À 500 requêtes par mois, cela prendra un certain temps.
Références & notes
1 AI Act européen, article 50 — obligations de transparence applicables à partir du 2 août 2026 : les fournisseurs de systèmes générant des images, sons, vidéos ou textes synthétiques doivent marquer les sorties dans un format lisible par machine et les rendre détectables comme artificiellement générées. Cela lie les fournisseurs et déployeurs d'IA ; ce n'est pas une règle sur les images qu'un site web peut publier.
2 Règles anti-spam de Google Search — abus de contenu à grande échelle : générer de nombreuses pages principalement pour manipuler le classement et offrant peu de valeur aux utilisateurs, qu'elles soient créées par automatisation, par un effort humain ou une combinaison des deux. La qualité de l'illustration n'est pas un facteur dans cette évaluation, ce qui est précisément pourquoi cet article sépare les deux.
Sources vérifiées le 17 août 2026 : Règles anti-spam de Google Search · AI Act article 50 · Documentation API & MCP Pexafy. Les limites des plans sont les valeurs en direct de la table tarifaire Pexafy ; les temps de recherche (122 ms, 48 ms) et toutes les photos montrées sont de vraies réponses API capturées le même jour.
Foire aux questions
Comment obtenir des images pour des milliers de pages SEO programmatiques ?
GET /api/v1/search/photos avec per_page=100 renvoie jusqu'à 100 photos créditées pour un cluster ; vous les stockez dans une table de pool et en attribuez une par page au moment de la publication. Un site de 10 000 pages par mois avec quatre images par page nécessite environ 500 requêtes au lieu de 40 000, ce qui tient dans le plan gratuit (5 000 requêtes/mois).Quelle est la meilleure API de photos stock pour la production de contenu à grand volume ?
Comment éviter que la même photo stock apparaisse sur plusieurs pages ?
photo_id de chaque image publiée et réservez les photos du pool de façon transactionnelle — en SQL, un UPDATE … WHERE used_by_page IS NULL … FOR UPDATE SKIP LOCKED. La déduplication devient alors exacte plutôt que probabiliste, et des workers de build parallèles ne peuvent pas se disputer la même photo la mieux classée. C'est une seule colonne, et l'ajouter après coup sur des milliers de pages en ligne coûte bien plus cher que de la prévoir dès le premier jour.Combien de photos une seule requête API peut-elle renvoyer ?
per_page=100, et la pagination par curseur vous permet de continuer à parcourir le même ensemble de résultats classés pour des pools plus profonds. Combinez-la avec score_threshold pour qu'un cluster mince renvoie 40 correspondances solides plutôt que 100 approximatives, et avec fields pour ne renvoyer que les attributs que votre template affiche, ce qui garde des réponses légères à grande échelle.Les vraies photos aident-elles les pages produites à grande échelle à mieux se classer ?
Un agent IA peut-il remplir un pool d'images automatiquement ?
mcp.pexafy.com/mcp, qui expose search_photos, search_photos_by_image et photo_similar. Donnez à l'agent une liste de clusters et il rédige un brief photo pour chacun, récupère les pools et signale les briefs qui ont renvoyé trop peu de correspondances solides — c'est le véritable mode de défaillance de l'illustration programmatique. L'attribution reste dans vos scripts, là où le déterminisme importe plus que la créativité.

